強化学習 探索vs活用
強化学習の世界では、エージェント(Agent)は未知の環境で学び続け、成長する探検家のような存在です。それは常に付きまとう核心的な矛盾に直面しています:すなわち、探索(Exploration)未知の領域を探索し、より高い報酬をもたらす可能性のある新しい経路を見つけるべきか、それとも活用(Exploitation)既知の最良の戦略を活用し、現在知られている最大の利益を安定のに得るべきか?この「探索と活用のトレードオフ」(Exploration-Exploitation Trade-off)は、強化学習アルゴリズム設計における最も基本的かつ重要な課題の一つです。この矛盾を理解し、うまく扱うことは、エージェントが初心者から達人へと成長するための必須の道です。
探索と活用とは?
まず、生活の中の比喩を通じて、これら2つの核心的な概念を理解しましょう。
想像してみてください。あなたは毎日昼食に食べるレストランを選ばなければならないとします。
- 活用(Exploitation):あなたは、既知の一番好きなレストランへ行きます。そこは料理が自分の好みに合い、価格も手頃で、サービスの質も安定していることを知っています。活用を選択するということは、あなたが現在知られている最善の情報に基づいて意思決定を行い、その目的は目の前の確実な利益を最大化することです。強化学習では、これはエージェントが現在の評価値(例:Q値)が最も高い行動を選択することに対応します。
- 探索(Exploration):あなたは行ったことのない新しいレストランを試します。その新しいレストランは非常にまずくて後悔するかもしれませんが、意外にも美味しくて新たなお気に入りになるかもしれません。探索を選択するということは、あなたが環境についてのより多くの情報を得るために行動を起こすことであり、その目的は長期的な将来の利益を最適化することです。強化学習では、これはエージェントがランダムに行動を選択するか、現在の最善ではない行動を選択して、環境モデルに対する認識を更新することに対応します。
強化学習エージェントの目標は、一度の昼食に勝つことではなく、無数の昼食の選択の中で、最大の長期的満足感(累積報酬)を得ることです。活用のみで探索をしなければ、あなたは永遠にそのより良い新しいレストランを発見できず、長期的な利益を最適にすることはできません。探索のみで活用をしなければ、悪いレストランに時間とお金を大量に浪費し、既知の最善の選択を享受できないかもしれません。
なぜトレードオフが必要なのか?
探索と活用のトレードオフが必要となる根本的な理由は、環境の不確実性とエージェントの知識の不完全性。
- 情報が限られている:エージェントは初期状態では環境について何も知らないため、探索によってデータを収集し、世界(状態、行動、報酬、遷移確率)に関する認知モデルを構築する必要があります。
- 機会費用:未知の行動を探索すると、即時の報酬が低くなる(あるいは罰せられる)可能性があり、これは情報を得るためにコストを払うことに相当します。過度に探索すると、本来得られたはずの多くの短期的利益を犠牲にすることになります。
- 最適解の動的特性:非定常環境では、最適な戦略が時間とともに変化する可能性があります。エージェントが現在の最適な戦略を見つけたとしても、環境の変化に適応し、戦略が時代遅れになるのを防ぐために、ある程度の探索を継続的に行う必要があります。
したがって、優れた強化学習アルゴリズムは、「既存の知識を利用して利益を得ること」と「未知を探索して知識を改善すること」の間で、動的なバランス点を見つけなければなりません。
一般的な探索戦略
探索メカニズムをアルゴリズムにどのように組み込むのでしょうか?以下にいくつかの古典的な方法を示します:
ε-貪欲法 (ε-Greedy)
これは最も簡単で、最もよく使われる探索戦略です。エージェントはほとんどの時間(確率が1-ε)現在最善と思われる行動(活用)を選択しますが、小さな確率ε(例:5%)で完全にランダムに1つの行動を選択します(探索)。
実例
def epsilon_greedy(q_values, epsilon=0.1):
"""
ε-貪欲法の実装
Args:
q_values: 現在の状態における各行動のQ値推定値を表す配列。
epsilon: 探索確率。0と1の間の値。
Returns:
selected_action: 戦略に基づいて選択された行動のインデックス。
"""
n_actions = len(q_values)
# 確率 epsilon で探索(ランダム選択)を行う
if np.random.random() < epsilon:
selected_action = np.random.randint(n_actions)
# 確率 1-epsilon で活用(Q値が最大の行動を選択)を行う
else:
# 複数の行動のQ値が同じ場合、ランダムに1つ選択する
selected_action = np.random.choice(np.where(q_values == np.max(q_values))[0])
return selected_action
# 例:ある状態で、3つの行動のQ値推定値が [1.5, 2.8, 2.3] であるとする
state_q_values = [1.5, 2.8, 2.3]
for i in range(10):
action = epsilon_greedy(state_q_values, epsilon=0.2)
print(f"第{i+1}回目の選択: 行動 {action} (Q値: {state_q_values[action]:.1f})")
長所:シンプルで分かりやすく、実装が容易です。短所:探索時は完全にランダムで、既存の情報を一切利用しません(例えば、ある行動は最善ではないもののQ値が最善に近い場合でも、探索される確率はQ値が非常に低い悪い行動と同じです)。
上信頼限界アルゴリズム (Upper Confidence Bound, UCB)
UCBはより「賢い」探索戦略です。その核となる考え方は、各行動の評価値に「不確実性ボーナス」を加えるというものです。ある行動が試行された回数が少ないほど、その不確実性は大きくなり、このボーナス項は高くなるため、エージェントがその行動を試すことを促進します。
行動選択の公式は通常次の通りです: \[ a_t = \arg\max_a \left[ Q(a) + c \sqrt{\frac{\ln t}{N_t(a)}} \right] \]
ここで:
Q(a)は行動aの現在の平均報酬推定値(活用項)です。N_t(a)は時刻tまでに行動aが選択された回数です。cは探索の強さを制御するバランスパラメータです。ln tは総タイムステップの対数です。- ルート項が「不確実性ボーナス」または「探索ボーナス」です。行動が選択される回数が少ないほど(
N_t(a)小さい)、この項の値は大きくなります。
実例
import math
class UCB:
def __init__(self, n_actions, c=2):
self.n_actions = n_actions
self.c = c # 探索パラメータ
self.Q = np.zeros(n_actions) # 行動価値の推定
self.N = np.zeros(n_actions) # 行動の選択回数
self.total_steps = 0
def select_action(self):
self.total_steps += 1
# 各行動が少なくとも1回は選択されることを保証する
if np.any(self.N == 0):
action = np.random.choice(np.where(self.N == 0)[0])
else:
# 各行動のUCB値を計算: Q(a) + c * sqrt(ln(t) / N(a))
ucb_values = self.Q + self.c * np.sqrt(np.log(self.total_steps) / self.N)
action = np.argmax(ucb_values)
return action
def update(self, action, reward):
# 行動の価値推定を更新する
self.N[action] += 1
# Q値を増分更新: NewEstimate = OldEstimate + (1/N) * (Target - OldEstimate)
self.Q[action] += (reward - self.Q[action]) / self.N[action]
# 各アームの真の報酬確率が異なる多腕バンディット問題をシミュレートする
true_means = [0.1, 0.5, 0.9] # 3本のアームの真の平均報酬
n_actions = len(true_means)
bandit = UCB(n_actions, c=2)
total_reward = 0
for step in range(1000):
action = bandit.select_action()
# スロットマシンのアームを引くことをシミュレートし、一定の確率で報酬1、それ以外は0を得る
reward = 1 if np.random.random() < true_means[action] else 0
bandit.update(action, reward)
total_reward += reward
print(f"UCB戦略が1000ステップ後に得た総報酬: {total_reward}")
print(f"各行動が選択された回数: {bandit.N}")
print(f"各行動のQ値推定: {bandit.Q}")
長所:探索がより目的指向的で、不確実性が高い(試行回数が少ない)行動を優先的に探索するため、最適な行動により速く収束できます。短所:各行動の選択回数を管理する必要があり、行動空間が連続的または巨大な場合には適用できない可能性があります。
トンプソンサンプリング (Thompson Sampling)
これはベイズ的思想に基づく確率的手法です。エージェントは各行動の報酬分布(例えばベルヌーイ分布のパラメータθ_a)に対して事前分布(例:ベータ分布)を保持します。各ステップで、エージェントは各行動の事後分布からサンプリング1つの可能性のある報酬パラメータをθ_aし、そのサンプリング値が最大の行動を選択して実行します。実際の報酬を受け取った後、その結果に基づいてその行動の事後分布を更新します。
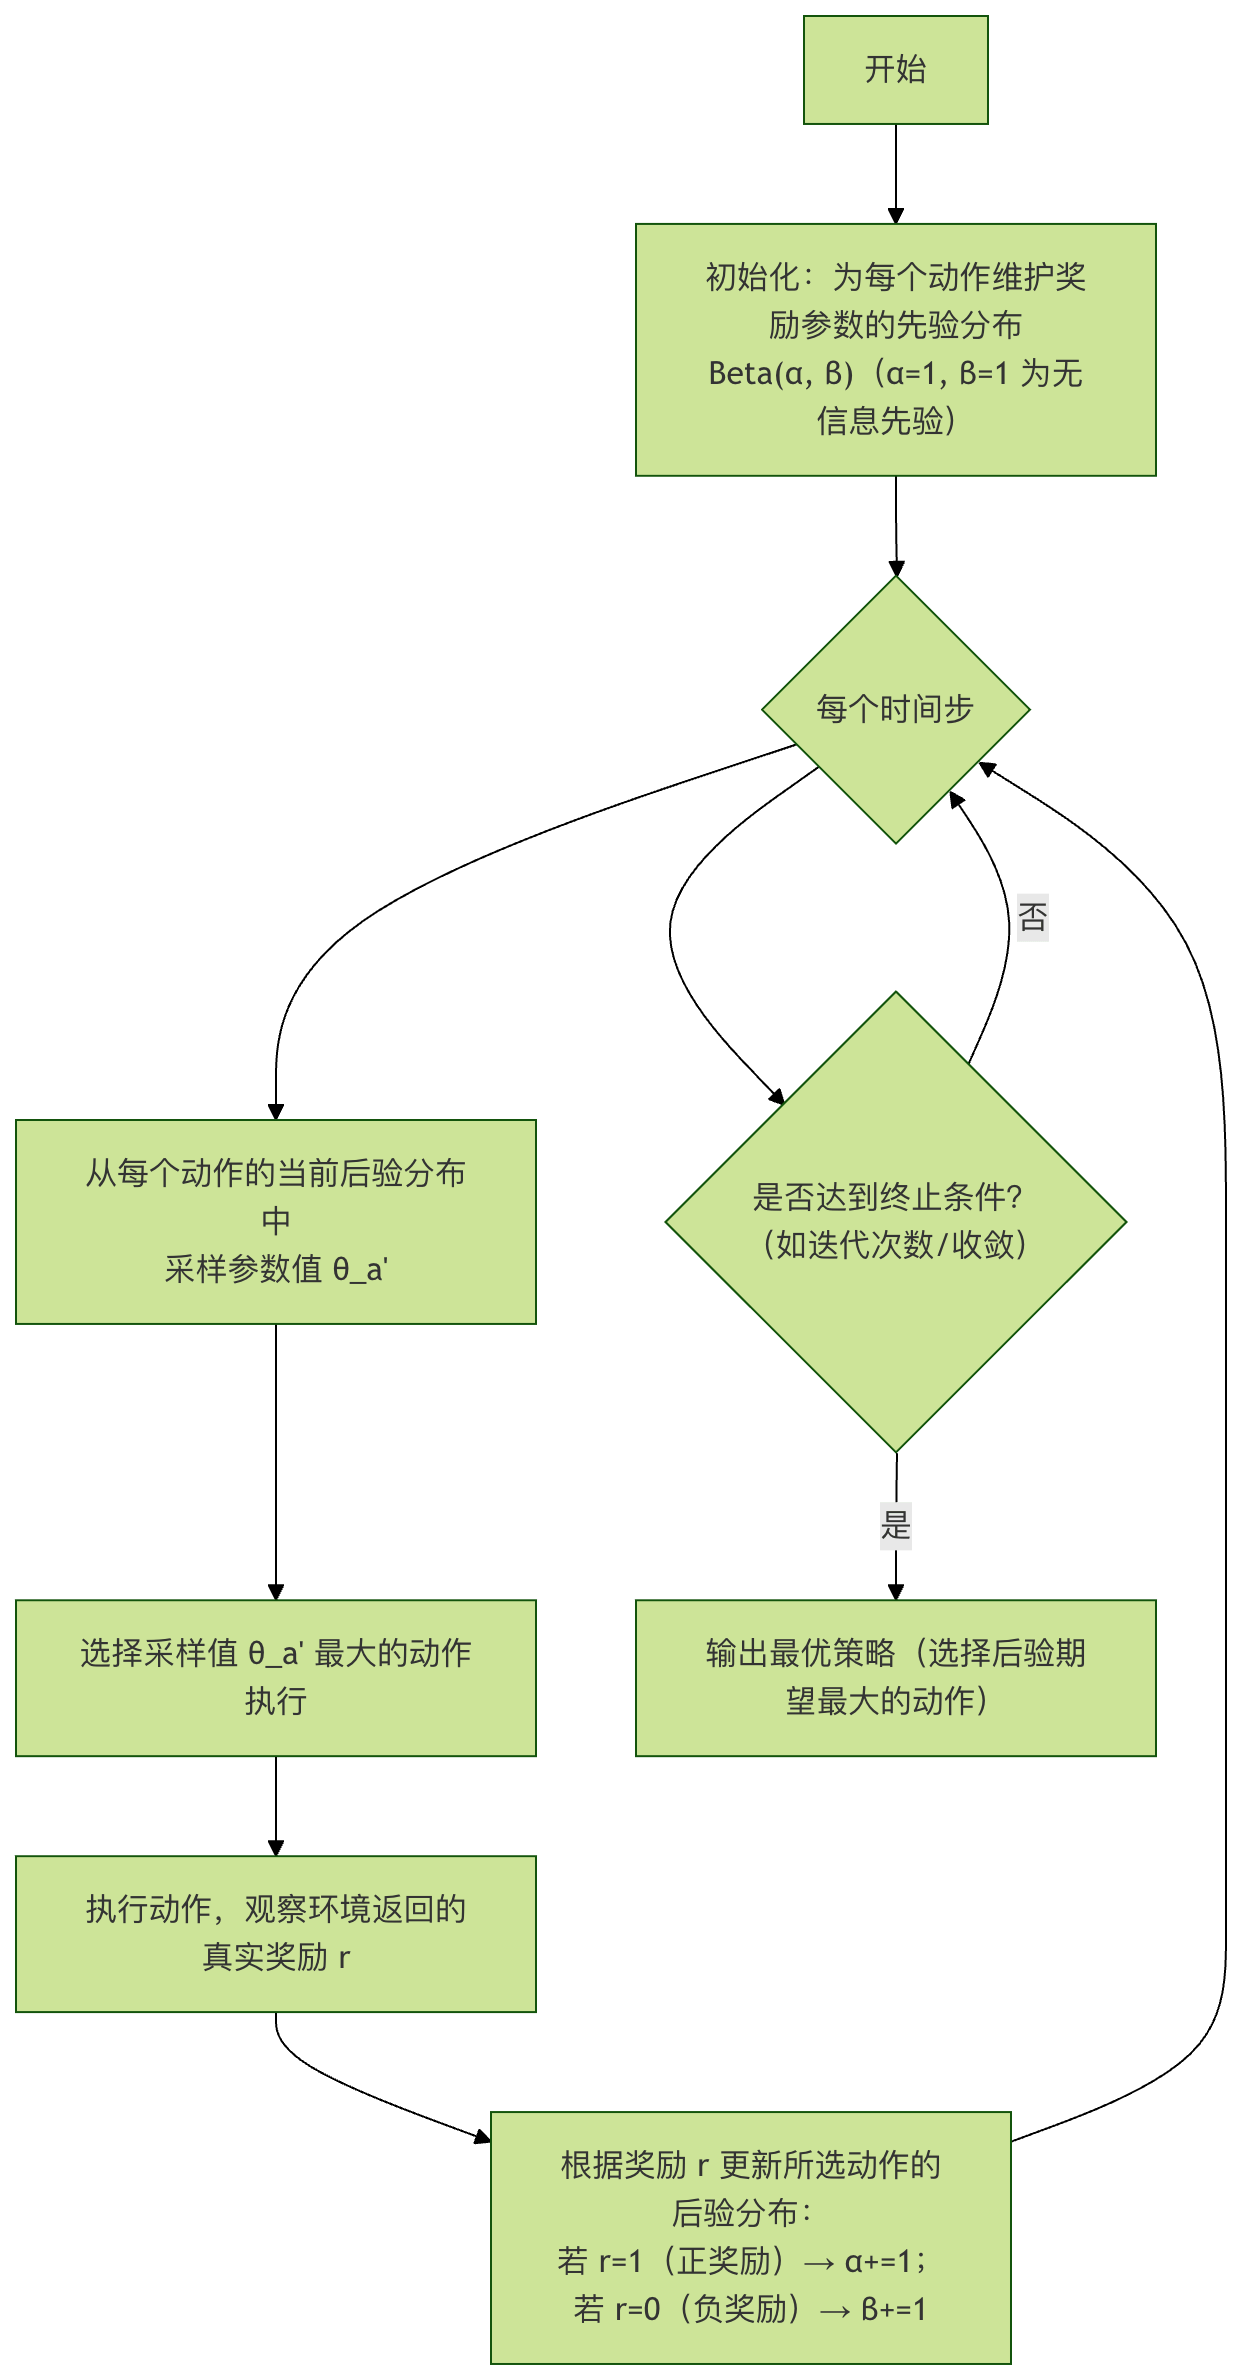
プロセスの説明:
- 初期化:各行動
aについて、報酬を得る確率がθ_aBeta(α=1, β=1) 分布に従うと仮定します。これは一様事前分布です。 - サンプリング:各ステップで、各行動
aの現在の Beta(α_a, β_a) 分布から独立に1つの値をサンプリングしますθ_a'。 - 選択:サンプリング値
θ_a'が最大の行動を実行します。 - 更新:もし報酬を得た場合
r=1、その行動のαを1増やす;もしr=0、その場合はβを1増やす。これは観測データでベイズ事後分布を更新することに相当する。
長所:探索と活用を自然にバランスさせ、理論的性質に優れ、実践ではしばしば非常に優れた性能を発揮する。短所:報酬分布の形式を仮定する必要があり、計算がε-貪欲法より複雑になる可能性がある。
探索と活用の動的バランス
実際の応用では、探索戦略はしばしば静的ではなく、エージェントの学習プロセスに応じて動的に調整される。
- 初期は探索重視:トレーニング開始時、エージェントは環境について何も知らないため、高い探索率(大きな
ε或c)を設定し、広くデータを収集すべきである。 - 後期は活用重視:学習が進むにつれて、エージェントの環境に対する認識はますます正確になるため、探索率を徐々に下げるべきである(例えば
εを時間とともに減衰させる)、学習した優れた戦略の活用に重心を移し、安定して高い報酬を得る。
この動的調整のプロセスは、人間の「広く試すことから精緻な改善へ」という学習プロセスを模倣している。
実践演習:異なる戦略の比較
古典的な「多腕バンディット」問題でε-貪欲法とUCB戦略の性能を比較する簡単な実験を設計しましょう。
タスク:
- 5本の腕を持つバンディットを作成し、各腕の真の報酬確率はそれぞれ
[0.1, 0.2, 0.8, 0.5, 0.3]。 - ε-貪欲法(ε=0.1)とUCB(c=2)戦略をそれぞれ実装する。
- 各戦略を2000ステップ実行し、各ステップの即時報酬と累積報酬を記録する。
- 累積報酬の時間ステップごとの変化を表す曲線を描き、どの戦略がより速く、より安定して高い総報酬を得られるかを観察する。
考察:
- εとcのパラメータを調整して、結果にどのような影響があるか観察してみよう。
- 最適腕(確率0.8)と次善腕(確率0.5)の差が小さくなった場合、戦略の性能はどう変化するだろうか?
- より複雑な強化学習環境(例えば
Gymのゲーム)では、これらの探索戦略をQ-Learning、DQNなどのアルゴリズムとどのように組み合わせるのだろうか?