Aprendizaje por refuerzo: exploración vs explotación
En el mundo del aprendizaje por refuerzo, el agente (Agent) es como un explorador que aprende y crece continuamente en un entorno desconocido. Se enfrenta a una contradicción central que lo atraviesa todo: ¿debeexplorar (Exploration)territorios desconocidos, buscando nuevos caminos que puedan traer mayores recompensas, o deberíaexplotar (Exploitation)la mejor estrategia conocida para obtener de manera estable la mayor ganancia actualmente conocida? Este "equilibrio entre exploración y explotación" (Exploration-Exploitation Trade-off) es uno de los desafíos más básicos y críticos en el diseño de algoritmos de aprendizaje por refuerzo. Comprender y manejar bien esta contradicción es el camino obligatorio para que el agente pase de ser un novato a un maestro.
¿Qué son la exploración y la explotación?
Primero entendamos estos dos conceptos centrales mediante una metáfora de la vida cotidiana.
Imagina que todos los mediodías tienes que elegir un restaurante para comer.
- Explotación (Exploitation): eliges ir al restauranteconocido y favorito. Sabes que la comida allí se adapta a tu gusto, el precio es razonable y la calidad del servicio es estable. Elegir explotar significa que, basándote enla mejor información actualmente conocidatomas la decisión, con el objetivo demaximizar la ganancia inmediata y segura. En el aprendizaje por refuerzo, esto corresponde a que el agente elija la acción con el valor estimado (como el valor Q) más alto.
- Exploración (Exploration): decidesprobar un restaurante nuevo que nunca has visitado. Este restaurante nuevo puede ser muy malo y hacerte arrepentir; pero también puede ser sorprendentemente delicioso y convertirse en tu nuevo favorito. Elegir explorar significa quepara obtener más información sobre el entornoactúas, con el objetivo deoptimizar las recompensas futuras a largo plazo. En el aprendizaje por refuerzo, esto corresponde a que el agente elija acciones al azar, o acciones que no son las óptimas actuales, para actualizar su conocimiento del modelo del entorno.
El objetivo del agente de aprendizaje por refuerzo no es ganar un solo almuerzo, sinoobtener la mayor satisfacción a largo plazo (recompensa acumulada) en innumerables elecciones de almuerzo. Si solo explotas sin explorar, es posible que nunca descubras ese restaurante nuevo y mejor, y la recompensa a largo plazo no alcanzará el óptimo. Si solo exploras sin explotar, puedes desperdiciar mucho tiempo y dinero en restaurantes malos, sin poder disfrutar de la mejor opción conocida.
¿Por qué se necesita un equilibrio?
La razón por la que la exploración y la explotación necesitan un equilibrio radica en laincertidumbredel entorno y en laincompletitud。
- del conocimiento del agente. Información limitada: el agente inicialmente no sabe nada del entorno; debe recopilar datos mediante la exploración para construir un modelo cognitivo del mundo (estados, acciones, recompensas, probabilidades de transición).
- Costo de oportunidad: explorar acciones desconocidas puede generar recompensas inmediatas bajas (incluso castigos), lo que equivale a pagar un costo por obtener información. Si se explora en exceso, se sacrifican muchos beneficios a corto plazo que se podrían haber obtenido.
- Dinamismo de la solución óptima: en entornos no estacionarios, la estrategia óptima puede cambiar con el tiempo. Incluso si el agente encuentra la estrategia óptima actual, necesita continuar explorando en cierta medida para adaptarse a los cambios del entorno y evitar que la estrategia quede obsoleta.
Por lo tanto, un buen algoritmo de aprendizaje por refuerzo debe encontrar un punto de equilibrio dinámico entre "usar el conocimiento existente para obtener beneficios" y "explorar lo desconocido para mejorar el conocimiento".
Estrategias comunes de exploración
¿Cómo incorporar mecanismos de exploración en el algoritmo? Estos son algunos métodos clásicos:
Estrategia ε-avariciosa (ε-Greedy)
Esta es la estrategia de exploración más simple y común. El agente, la mayor parte del tiempo (con probabilidad1-ε) elige la acción que actualmente considera óptima (explotación), pero con una pequeña probabilidadε(por ejemplo, 5%) elige completamente al azar una acción (exploración).
Ejemplo
def epsilon_greedy(q_values, epsilon=0.1):
"""
Implementación de la estrategia ε-avariciosa
Args:
q_values: un array que representa la estimación del valor Q de cada acción en el estado actual.
epsilon: probabilidad de exploración, entre 0 y 1.
Returns:
selected_action: índice de la acción seleccionada según la estrategia.
"""
n_actions = len(q_values)
# Con probabilidad epsilon se explora (selección aleatoria)
if np.random.random() < epsilon:
selected_action = np.random.randint(n_actions)
# Con probabilidad 1-epsilon se explota (se elige la acción con mayor valor Q)
else:
# Si varias acciones tienen el mismo valor Q, se elige una al azar
selected_action = np.random.choice(np.where(q_values == np.max(q_values))[0])
return selected_action
# Ejemplo: supongamos que en un estado, las estimaciones de Q para tres acciones son [1.5, 2.8, 2.3]
state_q_values = [1.5, 2.8, 2.3]
for i in range(10):
action = epsilon_greedy(state_q_values, epsilon=0.2)
print(f"Selección {i+1}: acción {action} (valor Q: {state_q_values[action]:.1f})")
Ventajas: es simple y fácil de implementar.Desventajas: la exploración es completamente aleatoria y no utiliza ninguna información existente (por ejemplo, una acción que no es óptima pero cuyo valor Q está cerca del óptimo tiene la misma probabilidad de ser explorada que una acción mala con valor Q muy bajo).
Algoritmo de límite superior de confianza (Upper Confidence Bound, UCB)
UCB es una estrategia de exploración más "inteligente". Su idea central es añadir una "recompensa por incertidumbre" a la estimación de cada acción. Cuanto menos veces se haya intentado una acción, mayor será su incertidumbre y mayor será este término de recompensa, lo que anima al agente a intentarla.
La fórmula de selección de acción suele ser: \[ a_t = \arg\max_a \left[ Q(a) + c \sqrt{\frac{\ln t}{N_t(a)}} \right] \]
donde:
Q(a)$Q(a)$ es la estimación promedio de recompensa actual de la accióna(término de explotación).N_t(a)$N_t(a)$ es el número de veces que la acciónt$a$ ha sido seleccionada hasta el tiempoa$t$.c$c$ es un parámetro de equilibrio que controla la intensidad de la exploración.ln t$\ln t$ es el logaritmo del número total de pasos de tiempo.- El término de la raíz cuadrada es la "recompensa por incertidumbre" o "recompensa por exploración". Cuanto menos veces se haya seleccionado la acción (
N_t(a)$N_t(a)$ pequeño), mayor será el valor de este término.
Ejemplo
import math
class UCB:
def __init__(self, n_actions, c=2):
self.n_actions = n_actions
self.c = c # Parámetro de exploración
self.Q = np.zeros(n_actions) # Estimación del valor de las acciones
self.N = np.zeros(n_actions) # Número de veces que se ha seleccionado cada acción
self.total_steps = 0
def select_action(self):
self.total_steps += 1
# Asegurar que cada acción se seleccione al menos una vez
if np.any(self.N == 0):
action = np.random.choice(np.where(self.N == 0)[0])
else:
# Calcular el valor UCB de cada acción: Q(a) + c * sqrt(ln(t) / N(a))
ucb_values = self.Q + self.c * np.sqrt(np.log(self.total_steps) / self.N)
action = np.argmax(ucb_values)
return action
def update(self, action, reward):
"""Actualizar la estimación del valor de la acción"""
self.N[action] += 1
# Actualización incremental del valor Q: NewEstimate = OldEstimate + (1/N) * (Target - OldEstimate)
self.Q[action] += (reward - self.Q[action]) / self.N[action]
# Simular un problema de bandido multibrazo, donde la probabilidad de recompensa real de cada brazo es diferente
true_means = [0.1, 0.5, 0.9] # Recompensa promedio real de los tres brazos
n_actions = len(true_means)
bandit = UCB(n_actions, c=2)
total_reward = 0
for step in range(1000):
action = bandit.select_action()
# Simular el tirón del brazo de la máquina tragamonedas, con cierta probabilidad de obtener recompensa 1, de lo contrario 0
reward = 1 if np.random.random() < true_means[action] else 0
bandit.update(action, reward)
total_reward += reward
print(f"Recompensa total obtenida por la estrategia UCB después de 1000 pasos: {total_reward}")
print(f"Número de veces que se seleccionó cada acción: {bandit.N}")
print(f"Estimación del valor Q de cada acción: {bandit.Q}")
Ventajas: la exploración es más orientada; prioriza las acciones con alta incertidumbre (pocas veces probadas), por lo que converge más rápido a la acción óptima.Desventajas: requiere mantener el número de veces que se ha seleccionado cada acción, por lo que puede no ser aplicable cuando el espacio de acciones es continuo o muy grande.
Muestreo de Thompson (Thompson Sampling)
Este es un método probabilístico basado en el pensamiento bayesiano. El agente, para la distribución de recompensa de cada acción (por ejemplo, el parámetro de la distribución de Bernoulliθ_a) mantiene una distribución previa (como la distribución Beta). En cada paso, el agente, desde la distribución posterior de cada acción,muestreaun posible parámetro de recompensaθ_a, y luego ejecuta la acción con el valor muestreado más grande. Tras recibir la recompensa real, actualiza la distribución posterior de esa acción según el resultado.
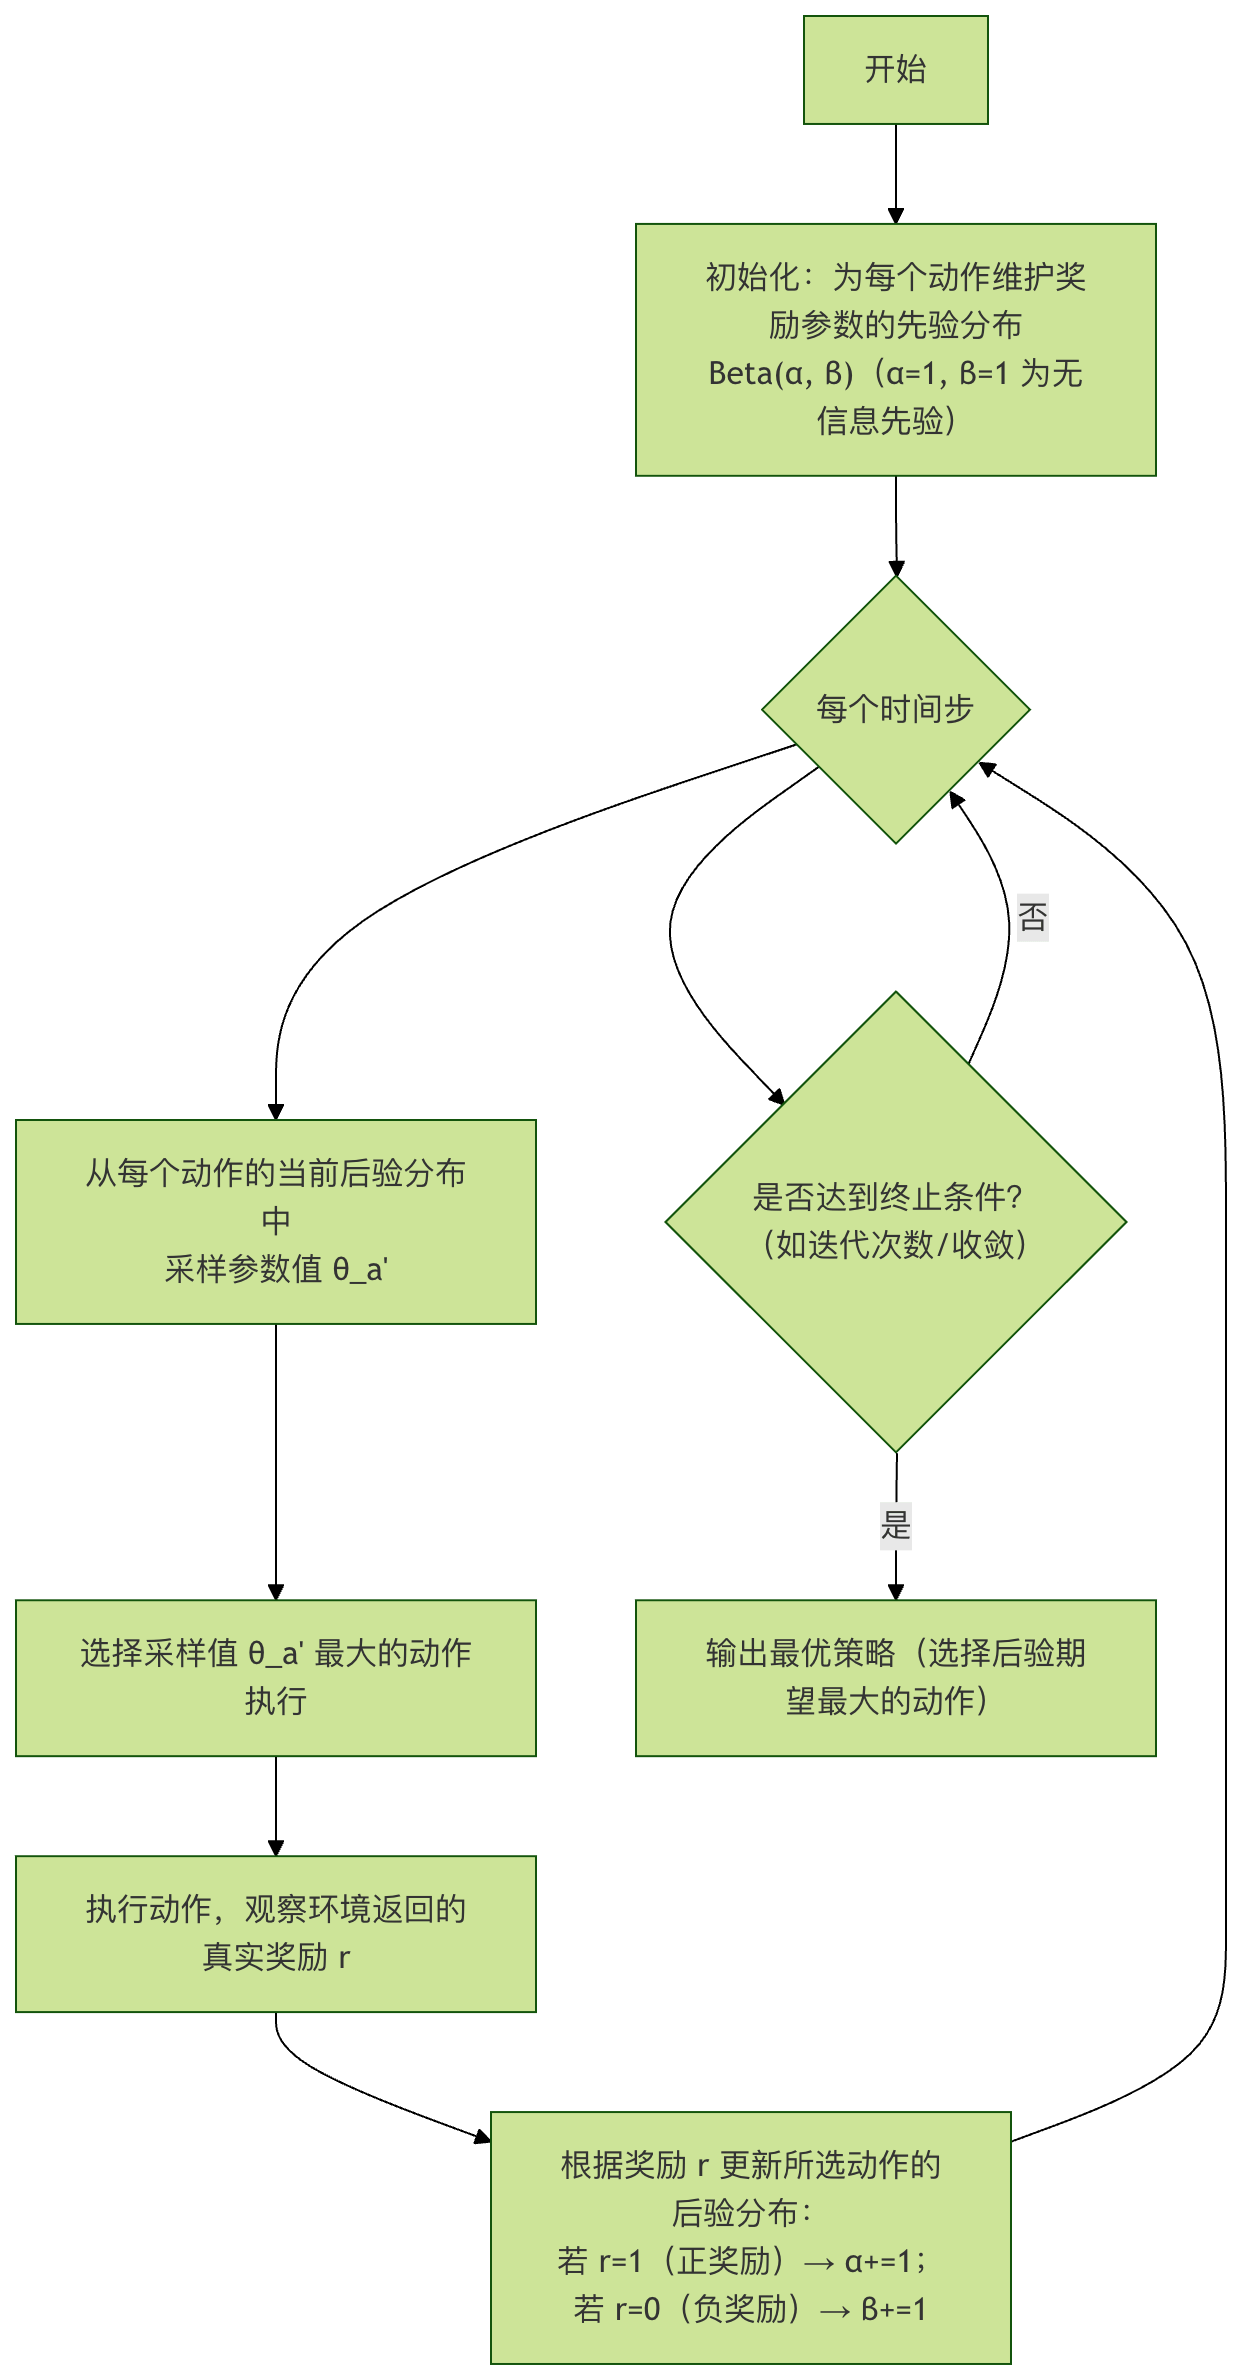
Descripción del proceso:
- Inicialización: para cada acción
ase asume que su probabilidad de obtener recompensaθ_asigue una distribución Beta(α=1, β=1), que es una prior uniforme. - Muestreo: en cada paso, desde cada acción
ade su distribución actual Beta(α_a, β_a) se muestrea independientemente un valorθ_a'。 - Selección: ejecutar la acción con el valor muestreado
θ_a'más grande. - Actualización: si se obtiene una recompensa
r=1, entonces el de esa acciónαse incrementa en 1; sir=0, entonces seβincrementa en 1. Esto equivale a actualizar la distribución posterior bayesiana con los datos observados.
Ventajas: equilibra naturalmente la exploración y la explotación, tiene buenas propiedades teóricas y en la práctica suele funcionar muy bien.Desventajas: requiere asumir la forma de la distribución de recompensas, y el cálculo puede ser más complejo que el de ε-greedy.
Equilibrio dinámico entre exploración y explotación
En aplicaciones prácticas, la estrategia de exploración no suele ser estática, sino que se ajusta dinámicamente con el proceso de aprendizaje del agente.
- Exploración intensiva al inicio: al comienzo del entrenamiento, el agente no conoce el entorno, por lo que se debe establecer una tasa de exploración alta (como un valor grande de
εoc), y recopilar datos ampliamente. - Explotación intensiva al final: a medida que avanza el aprendizaje, la comprensión del entorno por parte del agente es cada vez más precisa, y se debe reducir gradualmente la tasa de exploración (por ejemplo, haciendo que
εdecaiga con el tiempo), trasladando el enfoque a explotar las buenas estrategias aprendidas para obtener de forma estable una recompensa alta.
Este proceso de ajuste dinámico simula el proceso de aprendizaje humano de “la experimentación amplia al refinamiento continuo”.
Práctica: compara diferentes estrategias
Diseñemos un experimento sencillo para comparar el rendimiento de las estrategias ε-greedy y UCB en el clásico problema del “bandido multiarmado”.
Tarea:
- Crea un bandido con 5 brazos, cuyas probabilidades reales de recompensa de cada brazo son respectivamente
[0.1, 0.2, 0.8, 0.5, 0.3]。 - Implementa respectivamente las estrategias ε-greedy (ε=0.1) y UCB (c=2).
- Haz que cada estrategia ejecute 2000 pasos y registra la recompensa inmediata y la recompensa acumulada de cada paso.
- Traza la curva de la recompensa acumulada en función del paso de tiempo y observa qué estrategia puede obtener una recompensa total más alta de forma más rápida y estable.
Reflexión:
- Intenta ajustar los parámetros ε y c y observa qué impacto tienen en los resultados.
- Si la diferencia entre el brazo óptimo (probabilidad 0.8) y el brazo subóptimo (probabilidad 0.5) se reduce, ¿cómo cambia el rendimiento de las estrategias?
- En entornos de aprendizaje por refuerzo más complejos (como
Gymjuegos en [entorno]), ¿cómo se combinan estas estrategias de exploración con algoritmos como Q-Learning y DQN?