Apprentissage par renforcement : Exploration vs Exploitation
Dans le monde de l'apprentissage par renforcement, l'agent est comme un explorateur qui apprend et grandit constamment dans un environnement inconnu. Il fait face à une contradiction fondamentale qui traverse tout : doit-ilexplorer (Exploration)un territoire inconnu et chercher de nouveaux chemins susceptibles d'offrir des récompenses plus élevées, ou doit-ilexploiter (Exploitation)la meilleure stratégie connue pour obtenir de manière stable la récompense maximale actuellement connue ? Ce « compromis exploration-exploitation » est l'un des défis les plus fondamentaux et critiques dans la conception de l'apprentissage par renforcement. Bien comprendre et gérer cette contradiction est le chemin nécessaire pour qu'un agent passe de novice à expert.
Que sont l'exploration et l'exploitation ?
Comprenons d'abord ces deux concepts fondamentaux à travers une analogie de la vie quotidienne.
Imaginez que chaque jour à midi, vous devez choisir un restaurant pour le déjeuner.
- Exploitation: Vous choisissez d'aller aurestaurant connu que vous préférez le plus. Vous savez que la cuisine là-bas correspond à votre goût, les prix sont raisonnables et la qualité du service est stable. Choisir l'exploitation signifie que vous prenez des décisions en fonction deles meilleures informations actuellement connues, dans le but demaximiser les gains immédiats assurés. En apprentissage par renforcement, cela correspond à l'agent choisissant l'action ayant l'estimation actuelle la plus élevée (comme la valeur Q).
- Exploration: Vous décidez d'essayer un nouveau restaurant que vous n'avez jamais visité. Ce nouveau restaurant peut être affreux et vous faire profondément regretter, mais il peut aussi être délicieux de façon inattendue et devenir votre nouveau préféré. Choisir l'exploration signifie que vousagissez afin d'obtenir plus d'informations sur l'environnement, dans le but deoptimiser les récompenses futures à long terme. En apprentissage par renforcement, cela correspond à l'agent sélectionnant des actions de manière aléatoire, ou sélectionnant des actions qui ne sont pas actuellement optimales, afin de mettre à jour sa compréhension du modèle environnemental.
L'objectif d'un agent d'apprentissage par renforcement n'est pas de gagner un seul déjeuner, mais d'obtenir la plus grande satisfaction à long terme (récompense cumulée) à travers d'innombrables choix de déjeuner.Si vous ne faites que de l'exploitation et n'explorez jamais, vous pourriez ne jamais découvrir ce meilleur nouveau restaurant, et les récompenses à long terme ne pourront pas atteindre l'optimum. Si vous ne faites que de l'exploration et n'exploitez jamais, vous risquez de perdre beaucoup de temps et d'argent dans de mauvais restaurants et de ne pas profiter du meilleur choix connu.
Pourquoi un compromis est-il nécessaire ?
La raison pour laquelle l'exploration et l'exploitation nécessitent un compromis est enracinée dans l'incertitudede l'environnement et l'incomplétude des connaissances de l'agent.。
- Informations limitées: L'agent ne connaît initialement rien de l'environnement. Il doit collecter des données par l'exploration pour construire un modèle cognitif du monde (états, actions, récompenses, probabilités de transition).
- Coût d'opportunité: Explorer des actions inconnues peut donner des récompenses immédiates plus faibles (voire une punition), ce qui équivaut à payer un coût pour obtenir de l'information. Une exploration excessive sacrifiera une grande quantité de récompense à court terme qui aurait pu être obtenue autrement.
- Caractère dynamique de la solution optimale: Dans des environnements non stationnaires, la politique optimale peut changer au fil du temps. Même si l'agent a trouvé la politique optimale actuelle, il doit encore continuer à explorer dans une certaine mesure pour s'adapter aux changements de l'environnement et éviter que la politique ne devienne obsolète.
Par conséquent, un excellent algorithme d'apprentissage par renforcement doit trouver un équilibre dynamique entre « utiliser les connaissances existantes pour obtenir des récompenses » et « explorer l'inconnu pour améliorer les connaissances ».
Stratégies d'exploration courantes
Comment les mécanismes d'exploration peuvent-ils être intégrés dans un algorithme ? Voici plusieurs méthodes classiques :
Stratégie ε-Greedy (ε-Greedy)
Il s'agit de la stratégie d'exploration la plus simple et la plus couramment utilisée. L'agent, la plupart du temps (avec une probabilité1-ε) choisit l'action qu'il estime actuellement optimale (exploitation), mais avec une faible probabilitéε(par exemple, 5%) choisit une action de manière totalement aléatoire (exploration).
Exemple
def epsilon_greedy(q_values, epsilon=0.1):
"""
Implémentation de la stratégie ε-Greedy
Arguments :
q_values : un tableau représentant l'estimation de la valeur Q de chaque action dans l'état actuel.
epsilon : la probabilité d'exploration, entre 0 et 1.
Retourne :
selected_action : l'indice de l'action sélectionnée selon la stratégie.
"""
n_actions = len(q_values)
# Explorer avec une probabilité epsilon (sélection aléatoire)
if np.random.random() < epsilon:
selected_action = np.random.randint(n_actions)
# Exploiter avec une probabilité 1-epsilon (choisir l'action avec la plus grande valeur Q)
else:
# Si plusieurs actions ont la même valeur Q, en choisir une au hasard
selected_action = np.random.choice(np.where(q_values == np.max(q_values))[0])
return selected_action
# Exemple : supposons que dans un certain état, les estimations de la valeur Q des trois actions soient [1.5, 2.8, 2.3]
state_q_values = [1.5, 2.8, 2.3]
for i in range(10):
action = epsilon_greedy(state_q_values, epsilon=0.2)
print(f"Sélection {i+1} : Action {action} (Valeur Q : {state_q_values[action]:.1f})")
Avantages: Simple et facile à comprendre, facile à implémenter.Inconvénients: L'exploration est complètement aléatoire et n'utilise aucune information existante (par exemple, bien qu'une action ne soit pas optimale, sa valeur Q est proche de l'optimale ; sa probabilité d'être explorée est la même que celle d'une mauvaise action avec une valeur Q très faible).
Algorithme de la borne supérieure de confiance (Upper Confidence Bound, UCB)
UCB est une stratégie d'exploration "plus intelligente". Son idée centrale est d'ajouter un "bonus d'incertitude" à l'estimation de chaque action. Moins une action a été essayée, plus son incertitude est grande, et plus ce terme de bonus est élevé, ce qui encourage l'agent à l'essayer.
La formule de sélection de l'action est généralement : \[ a_t = \arg\max_a \left[ Q(a) + c \sqrt{\frac{\ln t}{N_t(a)}} \right] \]
où :
Q(a)est celle de l'actionaestimation actuelle de la récompense moyenne (terme d'exploitation).N_t(a)est, jusqu'au tempst, le nombre de fois que l'actionaa été sélectionnée.cest un paramètre d'équilibrage qui contrôle la force de l'exploration.ln test le logarithme du pas de temps total.- Le terme de racine carrée est le « bonus d'incertitude » ou « bonus d'exploration ». Plus le nombre de fois où une action est sélectionnée est faible (
N_t(a)est petit), plus ce terme devient grand.
Exemple
import math
class UCB:
def __init__(self, n_actions, c=2):
self.n_actions = n_actions
self.c = c # Paramètre d'exploration
self.Q = np.zeros(n_actions) # Estimations de la valeur des actions
self.N = np.zeros(n_actions) # Compteurs de sélection d'action
self.total_steps = 0
def select_action(self):
self.total_steps += 1
# S'assurer que chaque action est sélectionnée au moins une fois
if np.any(self.N == 0):
action = np.random.choice(np.where(self.N == 0)[0])
else:
# Calculer la valeur UCB de chaque action : Q(a) + c * sqrt(ln(t) / N(a))
ucb_values = self.Q + self.c * np.sqrt(np.log(self.total_steps) / self.N)
action = np.argmax(ucb_values)
return action
def update(self, action, reward):
"""Mettre à jour l'estimation de la valeur de l'action"""
self.N[action] += 1
# Mettre à jour incrémentalement la valeur Q : NewEstimate = OldEstimate + (1/N) * (Target - OldEstimate)
self.Q[action] += (reward - self.Q[action]) / self.N[action]
# Simuler un problème de bandit à plusieurs bras, où chaque bras a une probabilité de récompense vraie différente
true_means = [0.1, 0.5, 0.9] # Récompenses moyennes vraies des trois bras
n_actions = len(true_means)
bandit = UCB(n_actions, c=2)
total_reward = 0
for step in range(1000):
action = bandit.select_action()
# Simuler le tirage d'un bras de bandit, en obtenant une récompense de 1 avec une certaine probabilité, sinon 0
reward = 1 if np.random.random() < true_means[action] else 0
bandit.update(action, reward)
total_reward += reward
print(f"Récompense totale obtenue par la stratégie UCB après 1000 étapes : {total_reward}")
print(f"Nombre de fois où chaque action a été sélectionnée : {bandit.N}")
print(f"Estimations de la valeur Q de chaque action : {bandit.Q}")
Avantages: L’exploration est plus ciblée ; elle explore de préférence les actions à forte incertitude (peu de tentatives), et peut converger plus rapidement vers l’action optimale.Inconvénients: Il faut maintenir le nombre de fois où chaque action est sélectionnée, et cela peut ne pas être applicable lorsque l’espace d’actions est continu ou très grand.
Échantillonnage de Thompson
Il s’agit d’une méthode probabiliste fondée sur les idées bayésiennes. Pour la distribution des récompenses de chaque action (par exemple, le paramètre d’une distribution de Bernoulliθ_a), l’agent maintient une distribution a priori (telle qu’une distribution Beta). À chaque étape, à partir de la distribution a posteriori de chaque action, iléchantillonneun paramètre de récompense possibleθ_a, puis exécute l’action ayant la plus grande valeur échantillonnée. Après avoir reçu la récompense réelle, il met à jour la distribution a posteriori de cette action en fonction du résultat.
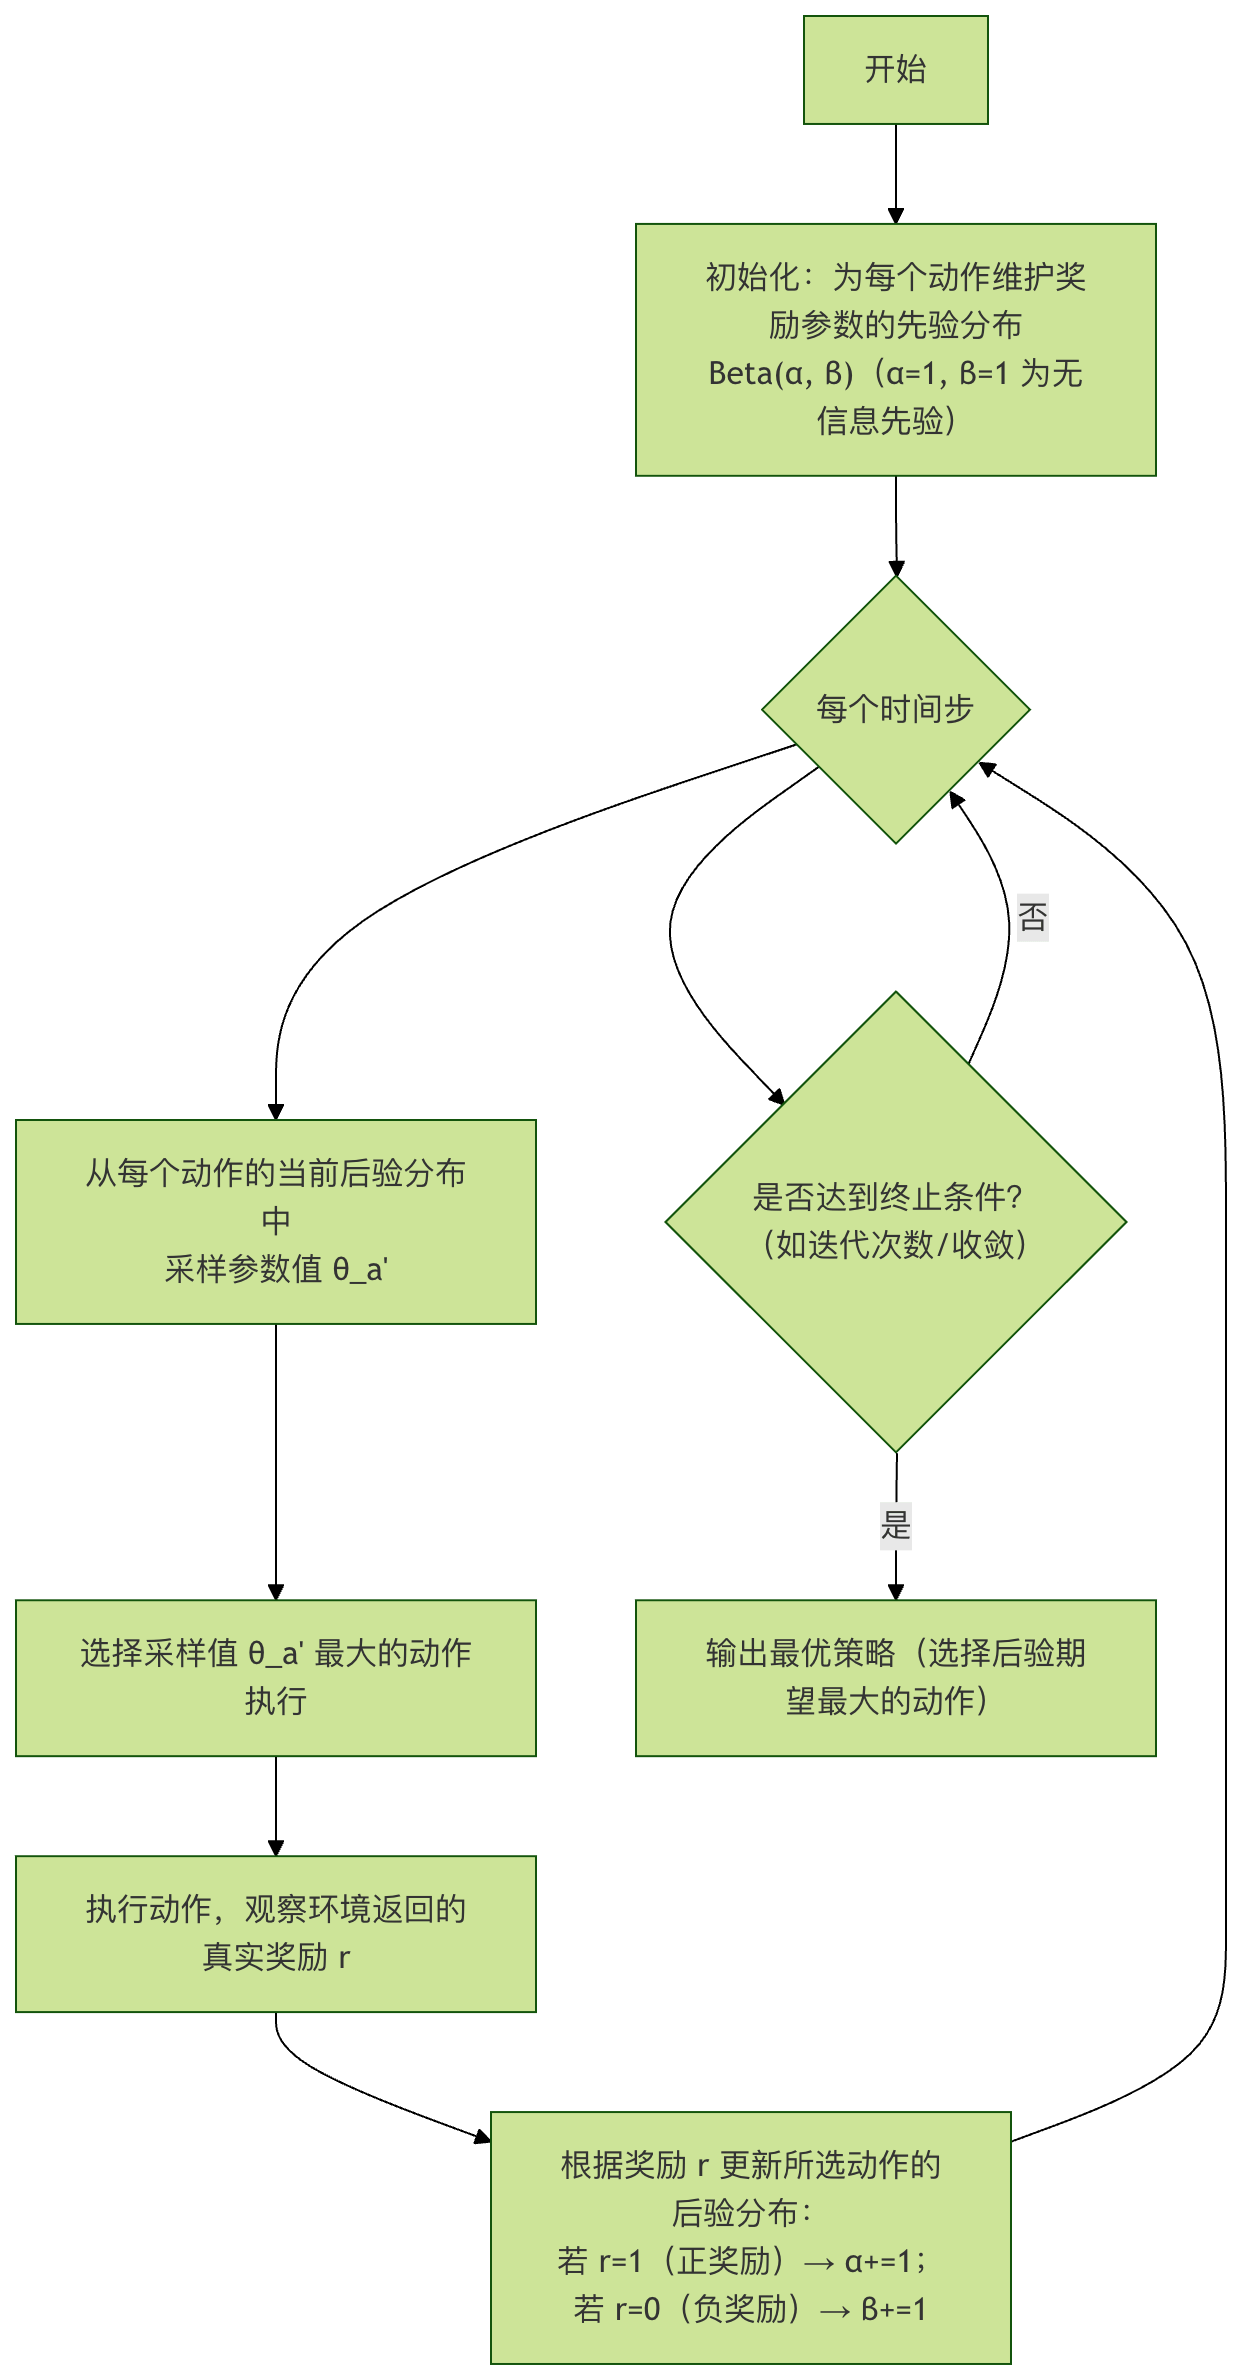
Explication de la procédure:
- Initialisation: Pour chaque action
aon suppose que la probabilité d’obtenir une récompenseθ_asuit une distribution Beta(α=1, β=1), qui est une loi a priori uniforme. - Échantillonnage: À chaque étape, à partir de celle de chaque action
adistribution Beta(α_a, β_a) actuelle, échantillonner indépendamment une valeurθ_a'。 - Sélection: Exécuter l'action avec la valeur échantillonnée
θ_a'qui est la plus grande. - Mise à jour: Si une récompense est obtenue
r=1, alors de l'actionαaugmente de 1 ; sir=0, alors leβaugmente de 1. Cela équivaut à mettre à jour la distribution a posteriori bayésienne avec les données observées.
Avantages: équilibre naturellement l'exploration et l'exploitation, possède de bonnes propriétés théoriques et donne souvent de très bons résultats en pratique.Inconvénients: il nécessite de supposer la forme de la distribution des récompenses, et le calcul peut être plus complexe que ε-greedy.
Équilibre dynamique entre exploration et exploitation
Dans les applications pratiques, les stratégies d'exploration ne sont souvent pas statiques mais sont ajustées dynamiquement au fur et à mesure que le processus d'apprentissage de l'agent progresse.
- Exploration intensive au début: Au début de l'entraînement, l'agent ne sait rien de l'environnement, donc un taux d'exploration plus élevé doit être défini (comme un plus grand
εouc), afin de collecter des données de manière extensive. - Exploitation intensive dans la phase ultérieure: Au fur et à mesure de l'apprentissage, la compréhension de l'environnement par l'agent devient plus précise, et le taux d'exploration doit être progressivement réduit (par exemple, laisser
εdiminuer avec le temps), en déplaçant l'attention vers l'exploitation des excellentes stratégies déjà apprises, afin d'obtenir régulièrement des rendements élevés.
Ce processus d'ajustement dynamique simule le processus d'apprentissage humain consistant à « passer d'essais extensifs à une amélioration continue ».
Exercice pratique : Comparer différentes stratégies
Concevons une expérience simple pour comparer les performances des stratégies ε-greedy et UCB sur le problème classique du « bandit à bras multiples ».
Tâche:
- Créez un bandit à 5 bras, où les véritables probabilités de récompense de chaque bras sont respectivement
[0.1, 0.2, 0.8, 0.5, 0.3]。 - Implémentez respectivement les stratégies ε-greedy (ε=0.1) et UCB (c=2).
- Exécutez chaque stratégie pendant 2000 étapes, en enregistrant la récompense immédiate et la récompense cumulée à chaque étape.
- Tracez la courbe de la récompense cumulée au fil des étapes temporelles, et observez quelle stratégie peut obtenir une récompense totale plus élevée plus rapidement et de manière plus stable.
Réfléchissez:
- Essayez d'ajuster les paramètres ε et c et observez quel impact ils ont sur les résultats ?
- Si l'écart entre le bras optimal (probabilité 0.8) et le bras sous-optimal (probabilité 0.5) diminue, comment les performances des stratégies changeront-elles ?
- Dans des environnements d'apprentissage par renforcement plus complexes (tels que
Gym), comment ces stratégies d'exploration peuvent-elles être combinées avec Q-Learning, DQN et d'autres algorithmes ?