Реальная стоимость моделей
Представьте, что вы только что обучили модель распознавания изображений, которая достигает 99% точности на тестовой выборке, и уверенно развернули её на заводской производственной линии.
Однако через несколько недель вы получаете обратную связь: модель часто ошибается, из-за чего производственная линия несколько раз без причины останавливается, что приводит к огромным экономическим потерям. В чём проблема?
Этот сценарий раскрывает истину, которую часто упускают в области машинного обучения:Отличная производительность модели в лабораторных или тестовых условиях не означает её успеха в реальном мире.
На пути модели от разработки до развертывания существует множество ограничений и скрытых затрат.
Эта статья поможет вам глубоко погрузиться в эти реальные затраты и сформировать более полное и прагматичное представление о машинном обучении.
За пределами точности — понимание общей стоимости моделей
Когда мы говорим о стоимости модели, большинство людей сначала думают о времени GPU и электроэнергии, потребляемых во время обучения. Но это лишь верхушка айсберга.
Стоимость полного проекта машинного обучения включает как минимум следующие четыре аспекта:
1. Затраты на данные: получение и очистка топлива
Модели машинного обучения используют данные как «топливо», и стоимость получения высококачественного топлива чрезвычайно высока.
Затраты на сбор данных:
- Денежные затраты: Расходы на покупку размеченных наборов данных и использование сервисов сбора данных (таких как краудсорсинговая платформа MTurk).
- Временные затраты: От определения спецификаций разметки и обучения разметчиков до завершения первичной разметки цикл может занимать недели или даже месяцы.
- Затраты на соответствие требованиям: Обеспечение соответствия сбора данных законам и нормативным актам, таким как GDPR (Общий регламент по защите данных) и CCPA (Закон Калифорнии о защите конфиденциальности потребителей), может потребовать юридической консультации и проектирования процессов.
Затраты на предварительную обработку и разметку данных:
- Затраты на очистку: Данные из реального мира полны шума, пропущенных значений и выбросов. Очистка обычно занимает 60-80% времени всего проекта.
- Затраты на разметку: Если взять в качестве примера разметку ограничивающих рамок на изображениях, то разметка одного сложного изображения может занять несколько минут. Для набора данных из ста тысяч изображений затраты на труд разметчиков и управление оказываются значительными.
Пример
def estimate_labeling_cost(num_images, time_per_image, cost_per_hour):
"""
Оцените общую стоимость разметки данных
Параметры:
num_images (int): Общее количество изображений для разметки
time_per_image (float): Среднее время разметки одного изображения (в часах)
cost_per_hour (float): Почасовая стоимость разметчика (денежная единица)
Возвращает:
total_hours, total_cost: Общее количество часов и общая стоимость
"""
total_hours = num_images * time_per_image
total_cost = total_hours * cost_per_hour
return total_hours, total_cost
# Предположим, в проекте 100,000 изображений, каждое занимает 0.05 часа (3 минуты) на разметку, а почасовая стоимость — 20 юаней
hours, cost = estimate_labeling_cost(100000, 0.05, 20)
print(f"Всего часов: {hours:.0f} часов")
print(f"Общая стоимость: {cost:.2f} юаней")
# Вывод: Всего часов: 5000 hours
# Вывод: Общая стоимость: 100000.00 yuan
2. Вычислительные затраты: счёт за энергию для обучения и инференса
Вычислительные затраты делятся на разовые затраты на обучение и постоянные затраты на инференс.
Затраты на обучение:
- Используйте GPU-инстансы с почасовой оплатой из облачных сервисов (таких как AWS SageMaker, Google Cloud AI Platform).
- Процесс настройки модели (оптимизация гиперпараметров) может потребовать обучения от десятков до сотен реплик модели, что умножает затраты.
Стоимость инференса:
- После развёртывания модели каждый раз, когда она обрабатывает запрос пользователя (то есть выполняет предсказание), возникают вычислительные затраты.
- Для высоконагруженных сервисов (таких как системы персонализированных рекомендаций), даже если стоимость одного инференса очень низкая, накопленные затраты могут быть огромными.
Пример
def estimate_training_cost(training_hours, instance_hourly_rate, num_trials=1):
"""
Оцените стоимость обучения модели на облачной платформе
Параметры:
training_hours (float): количество часов, необходимое для одного запуска обучения
instance_hourly_rate (float): почасовая стоимость GPU-инстанса (USD)
num_trials (int): количество поисков гиперпараметров или экспериментов
Возвращает:
total_cost: оценочная общая стоимость
"""
total_cost = training_hours * instance_hourly_rate * num_trials
return total_cost
# Предположим, обучение модели занимает 10 часов, используется инстанс P3 по $4 в час и выполняется 20 наборов экспериментов с гиперпараметрами
cost = estimate_training_cost(10, 4, 20)
print(f"Оценочная общая стоимость обучения: {cost} USD")
# Вывод: Оценочная общая стоимость обучения: 800 USD
3. Стоимость развертывания и сопровождения: поддержание работы модели
Развертывание модели в среде эксплуатации и поддержание её стабильной работы — это долгосрочная инвестиция.
Затраты на инфраструктуру:
- Затраты на серверы, управление контейнерами (например, Kubernetes), балансировку нагрузки и сетевой трафик.
- Затраты на инструменты и трудозатраты на разработку конвейеров развертывания (CI/CD для ML).
Затраты на мониторинг и обслуживание:
- Необходимо непрерывно отслеживать качество прогнозов модели, задержку и использование ресурсов.
- Распределение данных может меняться со временем (дрейф концепции), что требует периодического переобучения или дообучения модели на новых данных, а это влечет постоянные затраты на переобучение.
4. Альтернативные издержки и стоимость риска: невидимая цена
Это та часть, которую проще всего недооценить.
Альтернативные издержки:
- Команда, тратящая 3 месяца на разработку решения машинного обучения, может упустить возможность решить проблему за 1 месяц с помощью более простой системы, основанной на правилах.
Стоимость риска:
- Предвзятость модели: Если обучающие данные не отражают всех пользователей, модель может быть несправедлива к определенным группам, что вызывает этические проблемы и кризисы связей с общественностью.
- Ошибки прогнозирования: В таких областях, как здравоохранение, финансы и автономное вождение, одно неверное предсказание может привести к травмам или значительному имущественному ущербу, что влечёт юридические риски.
Потолок технологий — внутренние ограничения машинного обучения
Даже без учёта стоимости сама технология машинного обучения имеет присущие ей ограничения.
1. Зависимость от данных и «мусор на входе — мусор на выходе»
Модели машинного обучения полностью зависят от своих обучающих данных. Если данные низкого качества, имеют малый объём или предвзяты, качество работы модели будет ограничено.
- Проблема малых данных: В некоторых узкоспециализированных областях (например, диагностика редких заболеваний) может быть невозможно получить достаточно высококачественных данных для обучения надёжной модели.
- Предвзятость данных: Если исторические данные содержат социальные предубеждения (например, гендерную дискриминацию при найме), модель усвоит и усилит эти предубеждения.
2. Дилемма интерпретируемости: цена чёрного ящика
Многие высокопроизводительные модели (например, глубокие нейронные сети) представляют собой сложные «чёрные ящики», из-за чего нам трудно понять их внутреннюю логику принятия решений.
- В областях, требующих высокой надёжности и возможности аудита (например, одобрение кредитов и судебная помощь), использование моделей типа «чёрный ящик» может быть недопустимо.
- Когда модель ошибается, трудно диагностировать первопричину, что повышает сложность отладки и исправления.
3. Границы способности к обобщению
То, что модель хорошо показывает себя на обучающем и тестовом наборах, не означает, что она способна справиться со всеми ситуациями в реальном мире.
- Данные вне распределения: Модель может быть не способна обрабатывать входные данные, которые слишком сильно отличаются от распределения обучающих данных. Например, система автономного вождения, обученная только на солнечных изображениях, может полностью не справиться в туманную погоду.
- Состязательные примеры: Крошечные возмущения входных данных, незаметные для человека, могут заставить модель делать полностью неверные предсказания, что представляет серьёзную угрозу для систем с высокими требованиями к безопасности.
Пример
import numpy as np
# Предположим, простой «классификатор кошек и собак» во время обучения видел только четкие изображения
def trained_classifier_confidence(image):
"""Имитация модели, обученной на четких изображениях"""
# Упрощенно здесь: если дисперсия значений пикселей изображения велика (указывает на большую детализацию, более четкое изображение), уверенность высока
clarity = np.var(image)
if clarity > 1000: # Предполагаемый порог для четких изображений
return 0.95 # Высокая уверенность
else:
return 0.55 # Низкая уверенность, указывающая на то, что модель не уверена
# Симуляция четкого изображения (высокая дисперсия) и размытого изображения (низкая дисперсия)
clear_image = np.random.randn(100, 100) * 255 # Высокая дисперсия, имитация четкого изображения
blurry_image = np.random.randn(100, 100) * 50 + 128 # Низкая дисперсия, имитация размытого изображения
print(f"Уверенность в предсказании для четкого изображения: {trained_classifier_confidence(clear_image):.2f}")
print(f"Уверенность в предсказании для размытого изображения: {trained_classifier_confidence(blurry_image):.2f}")
# Возможный вывод: Уверенность в предсказании для четкого изображения: 0.95
# Возможный вывод: Уверенность в предсказании для размытого изображения: 0.55
# Указывает на недостаточную уверенность модели в не встречавшихся ранее размытых изображениях
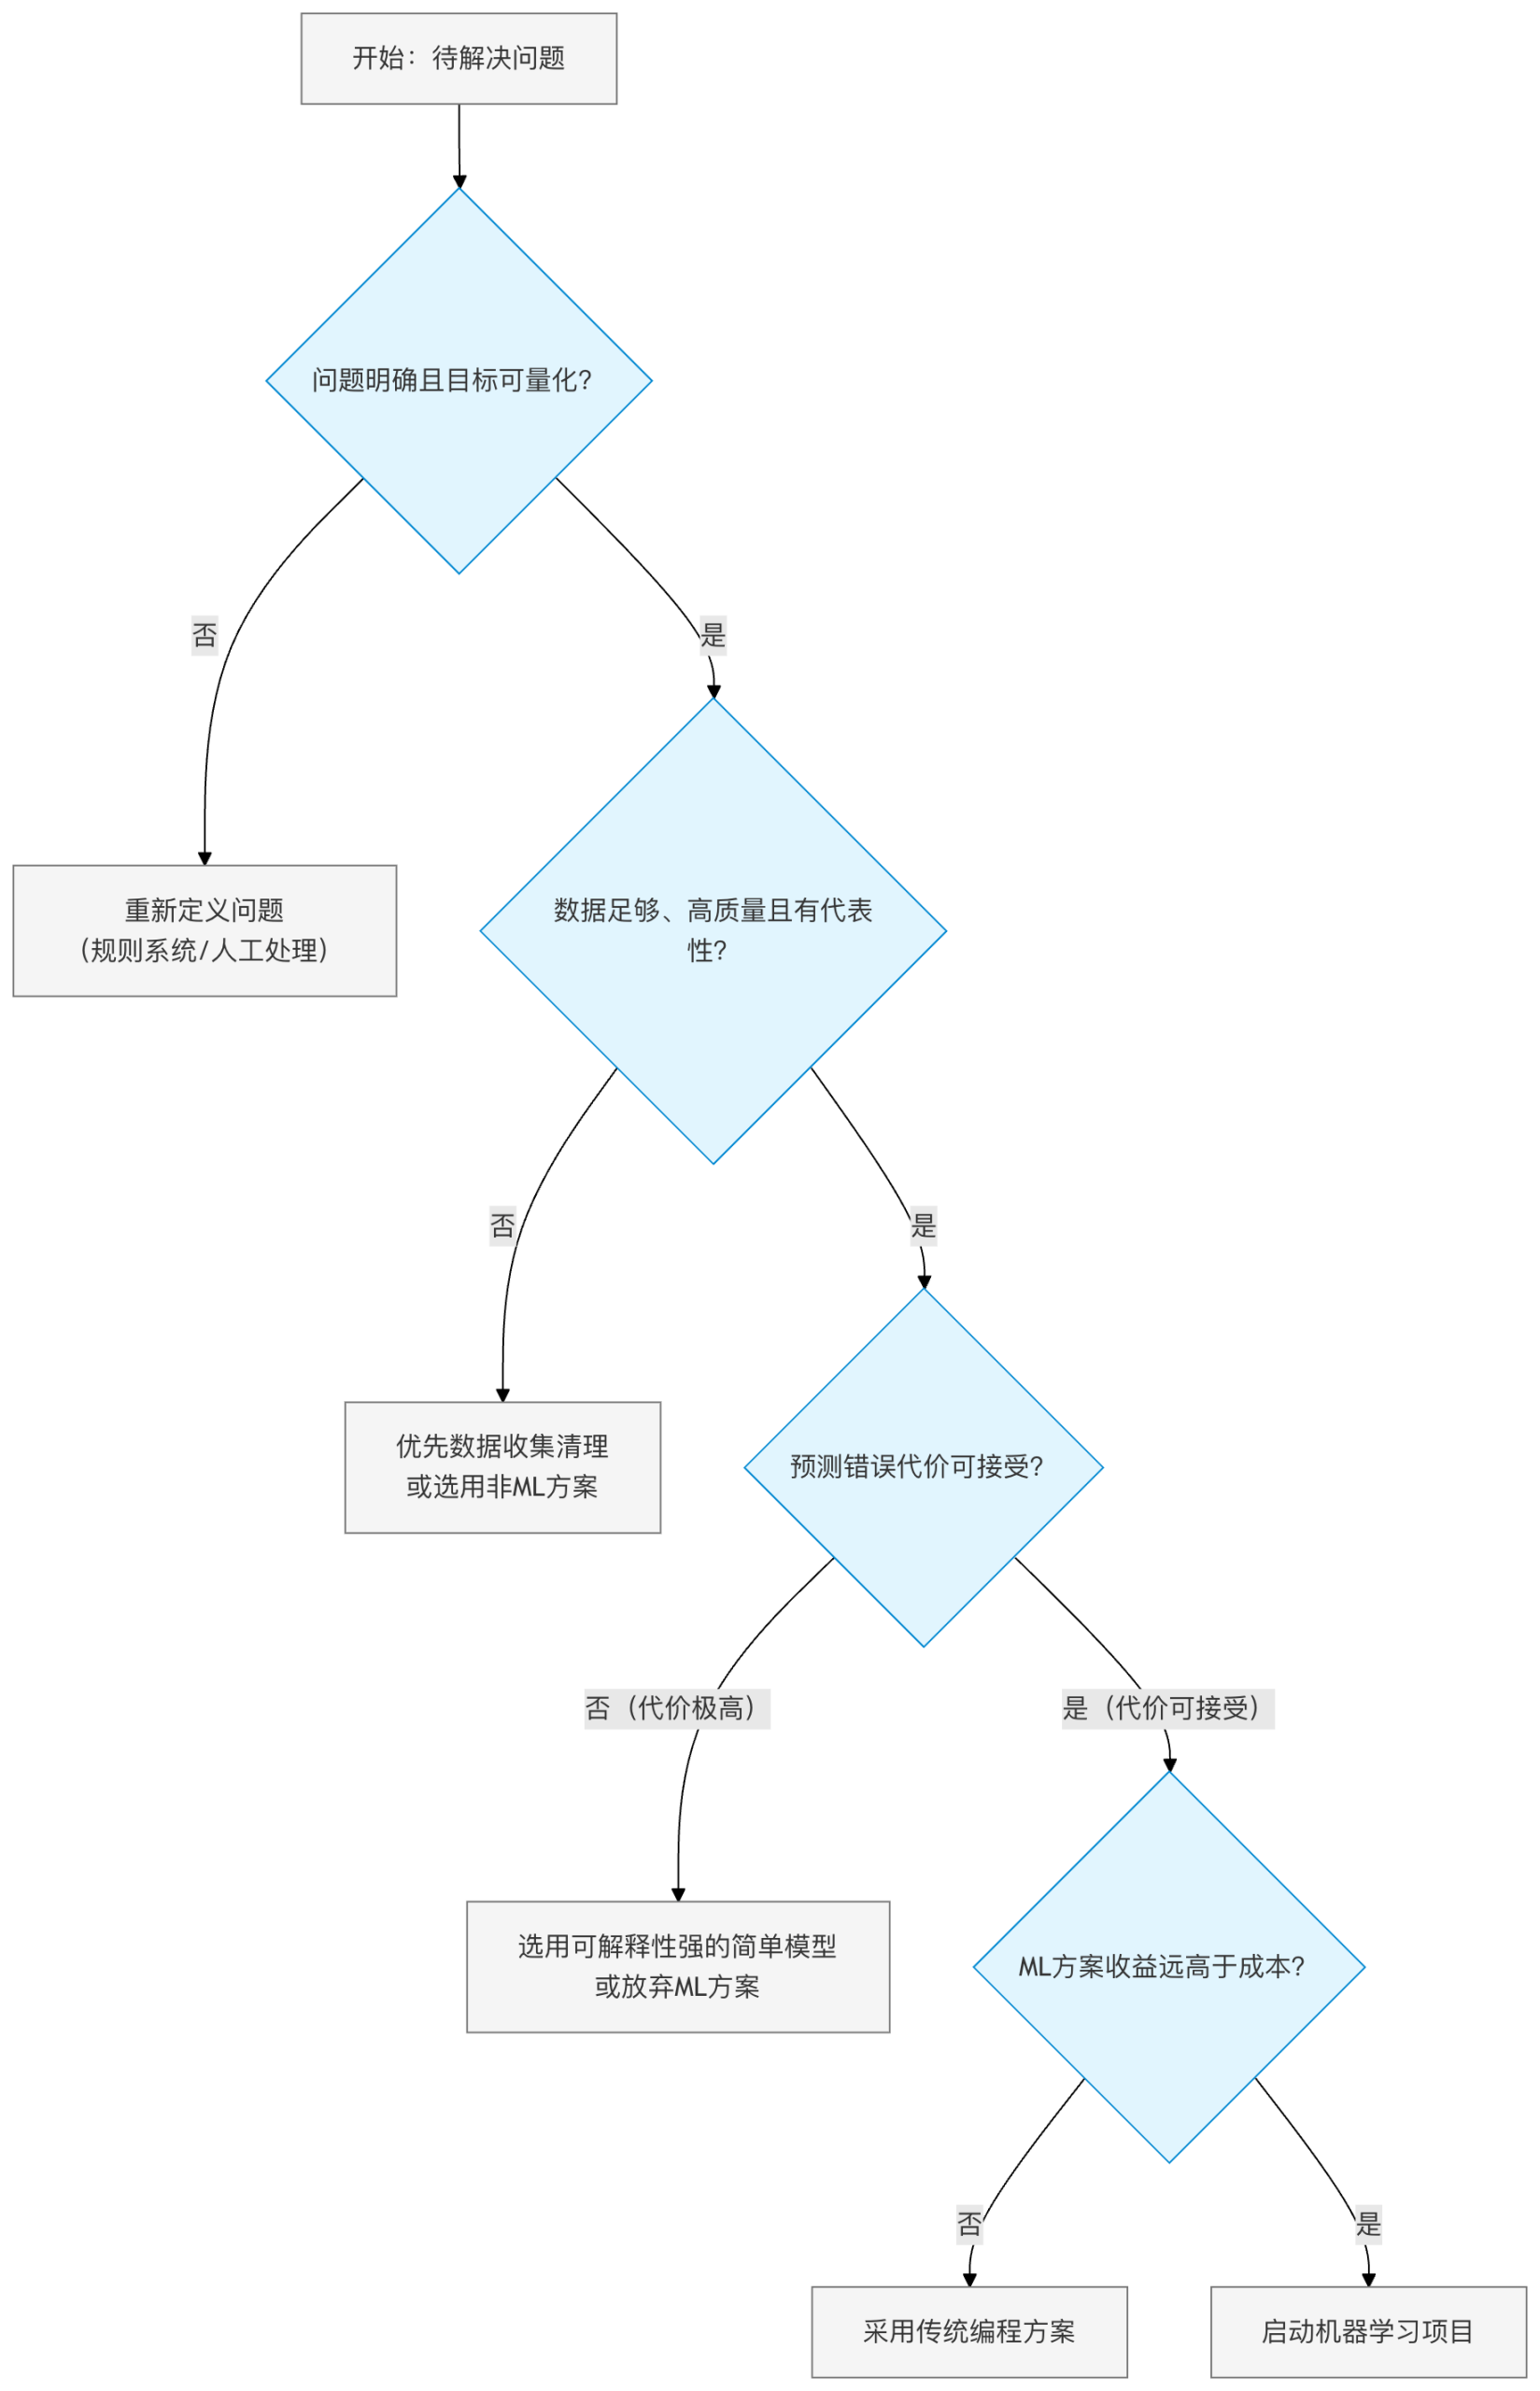
Анализ затрат и выгод - когда использовать машинное обучение?
Столкнувшись с этими затратами и ограничениями, нам не следует слепо применять машинное обучение. Перед началом проекта обязательно проведите анализ затрат и выгод и рассмотрите следующие альтернативы:
Блок-схема принятия решения: стоит ли использовать машинное обучение?
Прагматичные альтернативы
- Системы на основе правил: Если бизнес-логика ясна, стабильна и имеет мало исключений, написание правил if-else может быть быстрее, дешевле и надежнее.
- Статистические методы: Для многих аналитических задач классических статистических методов, таких как линейная регрессия и проверка гипотез, может уже быть достаточно, и они проще для интерпретации.
- Человеко-машинное сотрудничество: В некоторых сценариях использование машинного обучения в качестве вспомогательного инструмента (например, фильтрация случаев с высокой вероятностью для ручной проверки) более экономично и безопасно, чем полная автоматизация.
Итоги и руководство к действию
Машинное обучение — мощная технология, но это не «серебряная пуля» для всех проблем. Его успешное применение основано наясном понимании реальных затратиполном уважении к техническим границам.
Рекомендации к действию для начинающих
- Начните с малого: При запуске первого проекта выбирайте сценарий с небольшим объемом, легкодоступными данными и низкой ценой ошибок (например, анализ тональности отзывов к фильмам с использованием публичного набора данных).
- Оценивайте затраты комплексно: На этапе планирования проекта сознательно проведите приблизительную оценку затрат по четырем измерениям: данные, вычисления, развертывание и риск.
- Отдавайте приоритет простым решениям: Прежде чем пробовать сложные модели глубокого обучения, сначала попробуйте простые модели, такие как логистическая регрессия и деревья решений. Они дешевле, быстрее и проще для интерпретации.
- Непрерывный мониторинг и оценка: Развертывание модели — это не конец. Установите метрики мониторинга и регулярно оценивайте производительность модели и бизнес-ценность в реальных условиях.
Помните, что отличный практик машинного обучения — не только архитектор моделей, но иинженер, который взвешивает затраты, выгоды и риски.。
Другие расширения