モデルの現実コスト
想像してみてください。テストセットで正解率99%の画像認識モデルを訓練したばかりで、自信満々でそれを工場の生産ラインにデプロイしたとします。
しかし、数週間後、モデルが頻繁に誤判定を起こし、生産ラインが何度も不必要に停止して多大な経済的損失をもたらしたというフィードバックを受け取ります。問題はどこにあるのでしょうか?
このシナリオは、機械学習の分野でしばしば見落とされる真実を明らかにしています:モデルがラボやテスト環境で優れた性能を示しても、現実世界での成功を意味するものではありません。
モデルの開発からデプロイまでの道のりには、多くの制限と隠れたコストが存在します。
この記事では、これらの現実コストを深く掘り下げ、より包括的で実用的な機械学習の視点を構築するお手伝いをします。
正解率を超えて - モデルの総合コストを理解する
モデルのコストと言うとき、多くの人が最初に思い浮かべるのは、モデルのトレーニングに消費されるGPU時間と電気代です。しかし、これは氷山の一角にすぎません。
完全な機械学習プロジェクトのコストには、少なくとも次の4つの側面が含まれます:
1. データコスト:燃料の調達と浄化
機械学習モデルはデータを「燃料」としますが、高品質な燃料を入手するコストは非常に高くなります。
データ収集コスト:
- 金銭的コスト:アノテーション済みデータセットの購入、データ収集サービス(クラウドソーシングプラットフォームMTurkなど)の利用にかかる費用。
- 時間的コスト:アノテーション規約の定義、アノテーション担当者のトレーニングから初期アノテーションの完了まで、数週間から数か月かかる場合があります。
- コンプライアンスコスト:データ収集がGDPR(一般データ保護規則)、CCPA(カリフォルニア州消費者プライバシー法)などの法規制に準拠していることを確認するには、法的アドバイスやプロセス設計が必要になる場合があります。
データ前処理とアノテーションコスト:
- クリーニングコスト:実データにはノイズ、欠損値、異常値が多く含まれます。クリーニング作業は通常、プロジェクト全体の60〜80%の時間を占めます。
- アノテーションコスト:画像のバウンディングボックスアノテーションを例にとると、1枚の複雑な画像のアノテーションに数分かかる場合があり、10万枚のデータセットでは、アノテーションの人件費と管理コストが非常に大きくなります。
例
def estimate_labeling_cost(num_images, time_per_image, cost_per_hour):
"""
データアノテーションの総コストを見積もる
パラメータ:
num_images (int): アノテーションが必要な画像の総数
time_per_image (float): 1枚の画像あたりの平均アノテーション時間(時間)
cost_per_hour (float): アノテーション担当者の1時間あたりのコスト(通貨単位)
戻り値:
total_hours, total_cost: 総時間と総コスト
"""
total_hours = num_images * time_per_image
total_cost = total_hours * cost_per_hour
return total_hours, total_cost
# あるプロジェクトに10万枚の画像があり、1枚のアノテーションに0.05時間(3分)かかり、1時間あたりのコストが20元だと仮定する
hours, cost = estimate_labeling_cost(100000, 0.05, 20)
print(f"総時間: {hours:.0f} 時間")
print(f"総コスト: {cost:.2f} 元")
# 出力: 総時間: 5000 時間
# 出力: 総コスト: 100000.00 元
2. 計算コスト:訓練と推論のエネルギー料金
計算コストは、一度きりのトレーニングコストと継続的な推論コストに分けられます。
トレーニングコスト:
- AWS SageMaker、Google Cloud AI Platformなどのクラウドサービスで、時間単位で課金されるGPUインスタンスを使用します。
- モデルのチューニング(ハイパーパラメータ最適化)では、数十から数百のモデルコピーをトレーニングする必要がある場合があり、コストが倍増します。
推論コスト:
- モデルをデプロイした後、ユーザーリクエストを処理する(つまり予測を行う)たびに計算コストが発生します。
- 高並行処理サービス(例:ユーザーごとにパーソナライズされたレコメンドシステム)では、単回の推論コストが低くても、累積すると非常に大きくなります。
例
def estimate_training_cost(training_hours, instance_hourly_rate, num_trials=1):
"""
クラウドプラットフォームでモデルをトレーニングするコストを見積もる
パラメータ:
training_hours (float): 1回のトレーニングに必要な時間数
instance_hourly_rate (float): GPUインスタンスの1時間あたりの料金(米ドル)
num_trials (int): ハイパーパラメータ検索または実験の回数
戻り値:
total_cost: 推定総コスト
"""
total_cost = training_hours * instance_hourly_rate * num_trials
return total_cost
# モデルのトレーニングに10時間必要で、1時間4ドルのP3インスタンスを使用し、20セットのハイパーパラメータ実験を行うと仮定する
cost = estimate_training_cost(10, 4, 20)
print(f"推定トレーニング総コスト: {cost} ドル")
# 出力: 推定トレーニング総コスト: 800 ドル
3. デプロイとメンテナンスのコスト:モデルを継続的に稼働させる
モデルを本番環境にデプロイし、安定して稼働させ続けることは、長期的な投資です。
インフラストラクチャコスト:
- サーバー、コンテナ管理(例:Kubernetes)、ロードバランサー、ネットワークトラフィックの費用。
- デプロイパイプライン(ML向けCI/CD)の開発にかかるツールと人件費。
監視とメンテナンスのコスト:
- モデルの予測性能、遅延、リソース使用状況を継続的に監視する必要があります。
- データ分布は時間とともに変化する可能性があり(コンセプトドリフト)、定期的に新しいデータでモデルを再トレーニングまたは微調整する必要があります。これにより、継続的な再トレーニングコストが発生します。
4. 機会コストとリスクコスト:見えない代償
これは最も過小評価されがちな部分です。
機会コスト:
- チームが機械学習ソリューションの開発に3か月費やすということは、より単純なルールベースのシステムで1か月で問題を解決できた機会を逃したことを意味するかもしれません。
リスクコスト:
- モデルのバイアス:トレーニングデータが全ユーザーを代表していない場合、モデルが特定のグループに対して不公平になり、倫理的問題やPR危機を引き起こす可能性があります。
- 予測エラー:医療、金融、自動運転などの分野では、誤った予測が身体的な危害や重大な財産的損害につながり、法的リスクをもたらす可能性があります。
技術の天井 - 機械学習の内在的制約
コストを考慮しなくても、機械学習技術自体に固有の限界があります。
1. データ依存と「ガベージイン、ガベージアウト」
機械学習モデルはトレーニングデータに完全に依存します。データの品質が悪い、規模が小さい、またはバイアスがある場合、モデルのパフォーマンスは制限されます。
- 小データ問題:一部のニッチな分野(例:希少疾患の診断)では、信頼できるモデルをトレーニングするのに十分な高品質なデータを入手できない場合があります。
- データバイアス:履歴データに社会的偏見(例:採用における性別差別)が存在する場合、モデルはこれらの偏見を学習し、増幅させます。
2. 説明可能性のジレンマ:ブラックボックスの代償
多くの高性能モデル(例:ディープニューラルネットワーク)は複雑な「ブラックボックス」であり、その内部の意思決定ロジックを理解することは困難です。
- 高い信頼性と監査可能性が求められる分野(例:与信審査、司法支援)では、ブラックボックスモデルの使用が許可されない場合があります。
- モデルがエラーを起こしたとき、根本原因の診断が難しく、デバッグや修正の難易度が高まります。
3. 汎化能力の境界
モデルがトレーニングセットとテストセットで良いパフォーマンスを示しても、現実のすべての状況に対応できるわけではありません。
- 分布外データ:モデルは、トレーニングデータの分布と大きく異なる入力に対処できない場合があります。例えば、晴れた日の画像だけでトレーニングされた自動運転システムは、霧の日には完全に機能しなくなる可能性があります。
- 敵対的サンプル:人間には知覚できない微小な摂動を入力に加えるだけで、モデルが完全に誤った予測をする可能性があり、安全性が重視されるシステムにとって大きな脅威となります。
例
import numpy as np
# 簡単な「猫と犬の分類器」がトレーニング時に鮮明な画像しか見たことがないと仮定する
def trained_classifier_confidence(image):
"""鮮明な画像でトレーニングされたモデルをシミュレーションする"""
# ここでは簡略化する:画像のピクセル値の分散が大きい場合(詳細が多く鮮明であることを示す)、信頼度が高いとする
clarity = np.var(image)
if clarity > 1000: # 鮮明な画像の仮のしきい値
return 0.95 # 高信頼度
else:
return 0.55 # 低信頼度、モデルが不確実であることを示す
# 鮮明な画像(高分散)とぼやけた画像(低分散)をシミュレートする
clear_image = np.random.randn(100, 100) * 255 # 高分散、鮮明をシミュレート
blurry_image = np.random.randn(100, 100) * 50 + 128 # 低分散、ぼやけをシミュレート
print(f"鮮明な画像の予測信頼度: {trained_classifier_confidence(clear_image):.2f}")
print(f"ぼやけた画像の予測信頼度: {trained_classifier_confidence(blurry_image):.2f}")
# 出力例: 鮮明な画像の予測信頼度: 0.95
# 出力例: ぼやけた画像の予測信頼度: 0.55
# モデルが未見のぼやけた画像に対して自信を持っていないことを示す
費用対効果分析 - いつ機械学習を使うべきか?
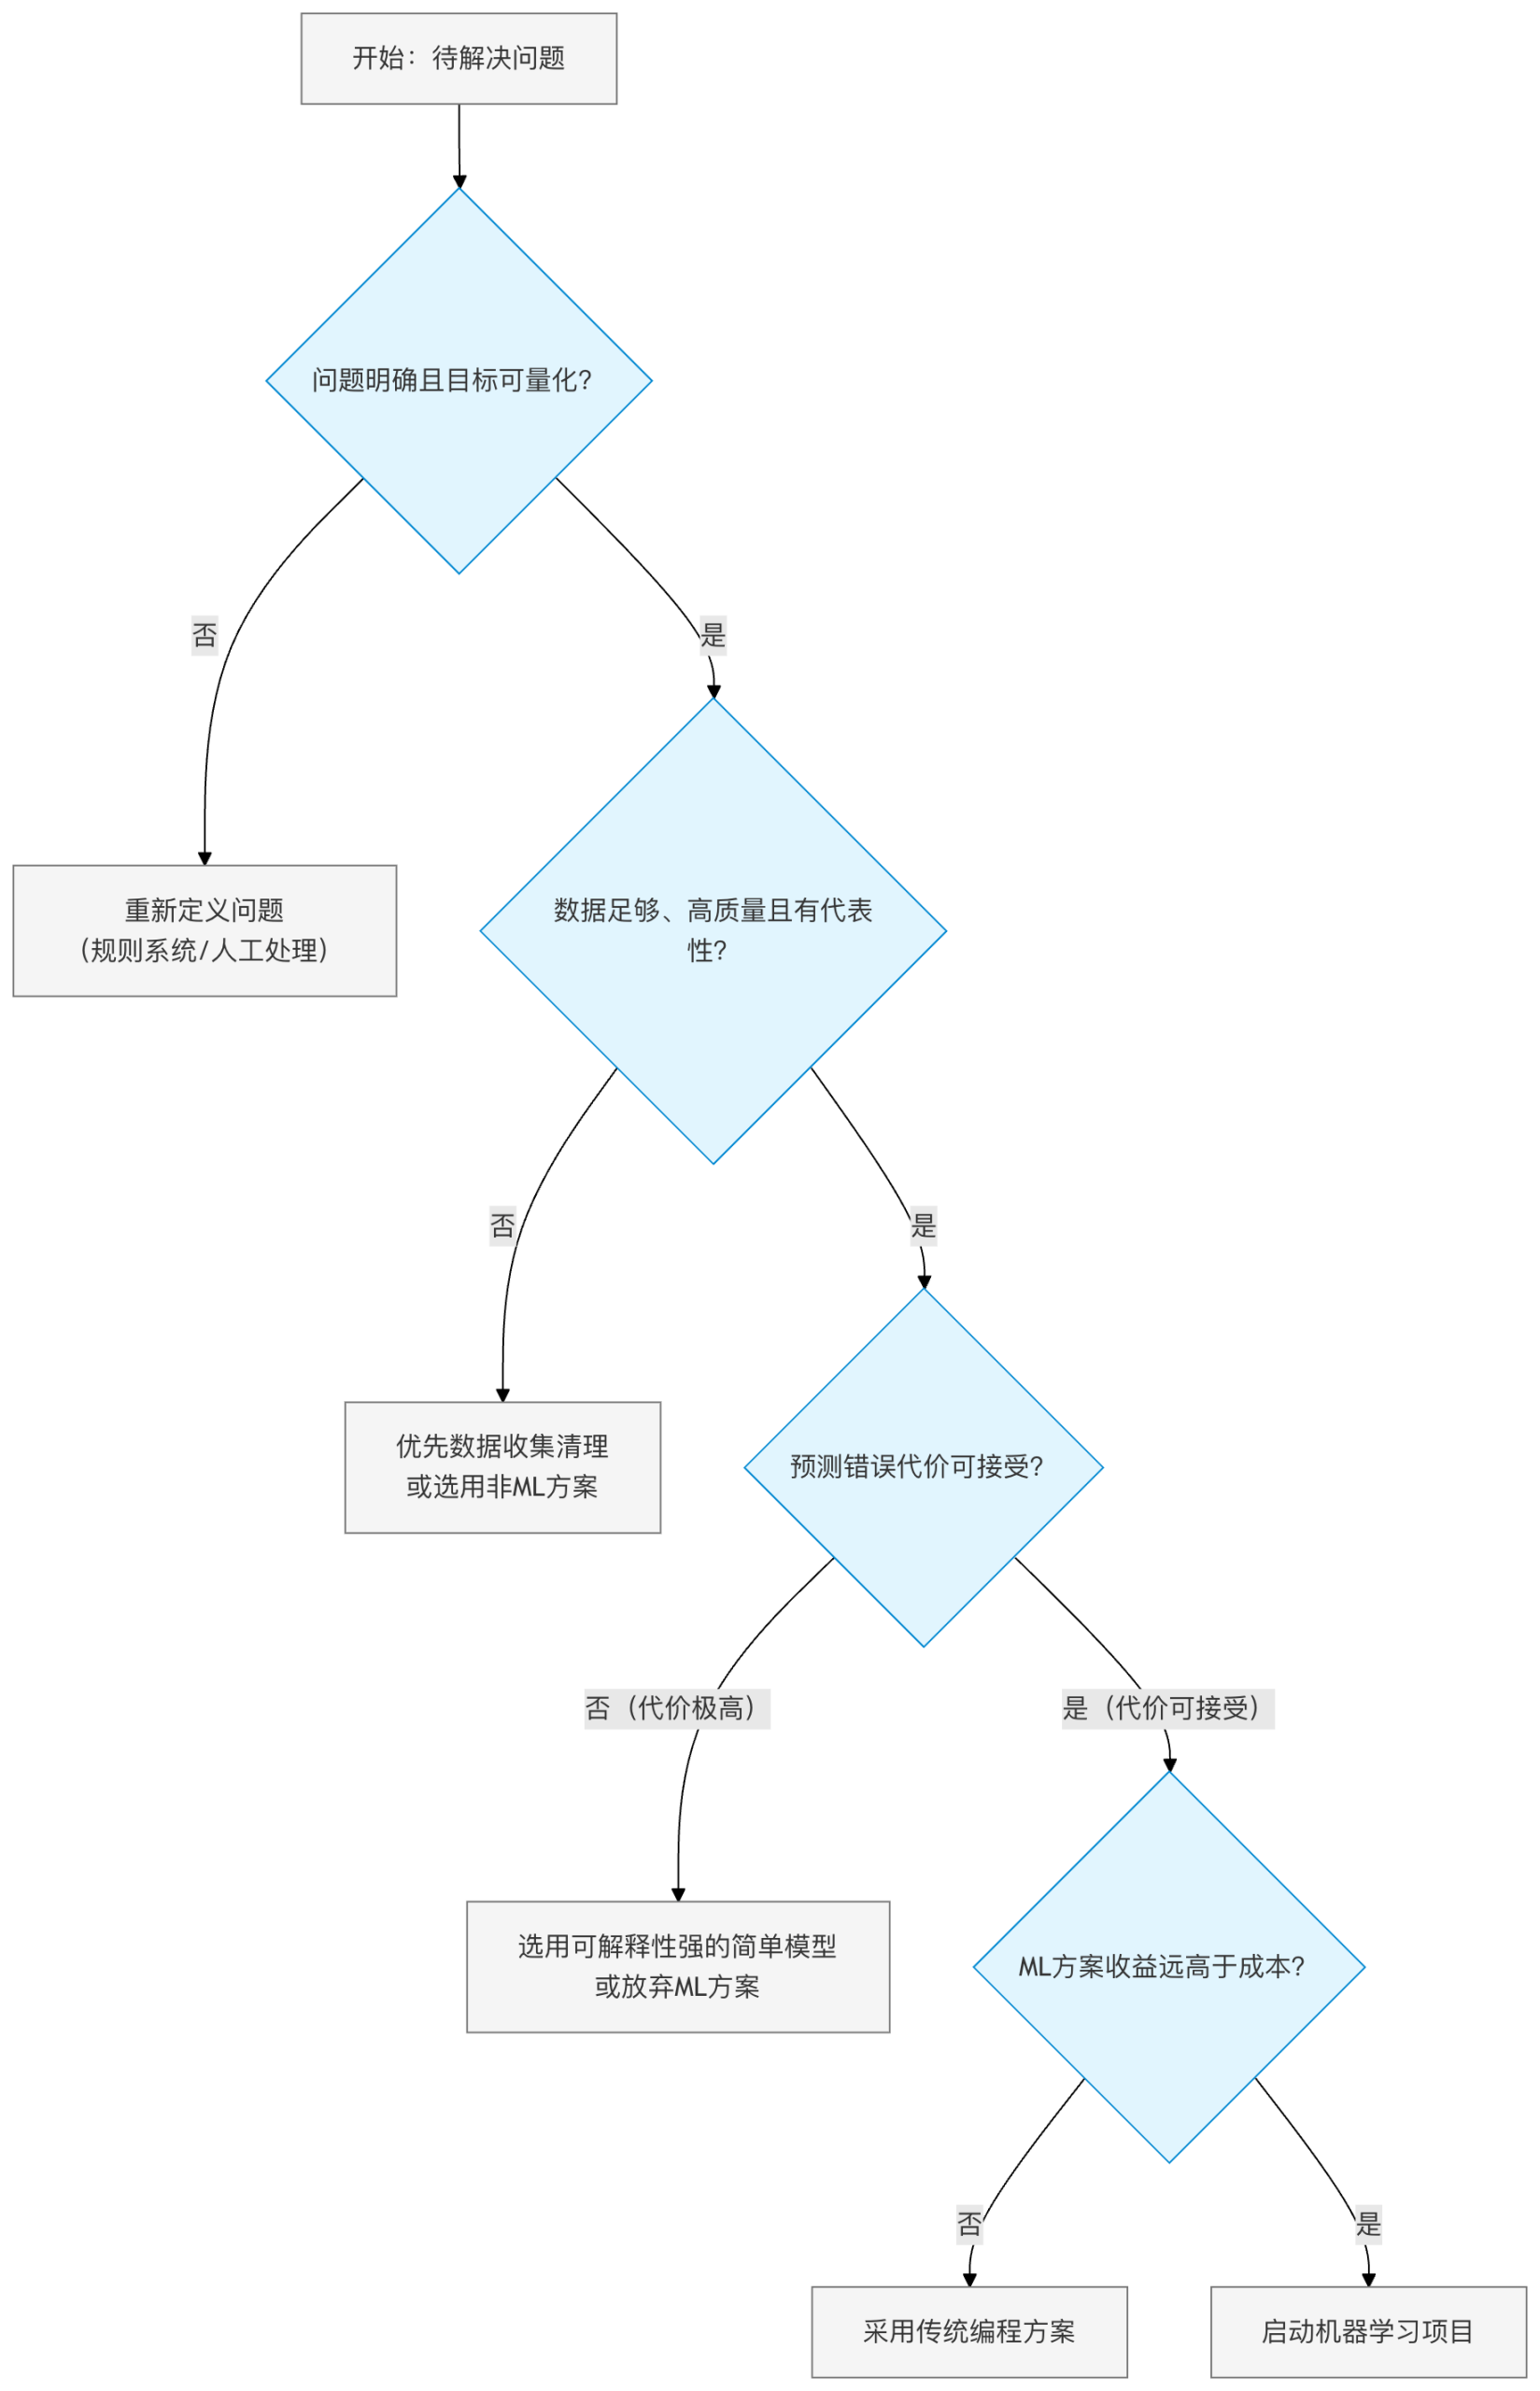
これらのコストと制限に直面したとき、機械学習を盲目的に適用すべきではありません。プロジェクトを開始する前に、必ず費用対効果分析を行い、以下の代替案を検討してください:
意思決定フローチャート:機械学習を使うべきか?
実用的な代替案
- ルールベースのシステム:ビジネスロジックが明確で安定しており、例外が少ない場合、if-else ルールを書く方がより速く、安く、信頼性が高いかもしれません。
- 統計的手法:多くの分析タスクでは、線形回帰や仮説検定などの古典的な統計手法で十分な場合が多く、解釈も容易です。
- 人と機械の協働:特定のシナリオでは、機械学習を補助ツールとして使用する(例えば、高確率のケースを抽出して人手で再確認する)方が、完全自動化よりも費用対効果と安全性に優れています。
まとめと行動ガイド
機械学習は強力な技術ですが、すべての問題を解決する「銀の弾丸」ではありません。その成功した応用は、現実のコストに対する冷静な認識と、技術的限界への十分な尊重の上に成り立ちます。
初心者への行動アドバイス
- 小さく始める:最初のプロジェクトを始める際は、範囲が狭く、データが入手しやすく、エラーのコストが低いシナリオ(公開データセットを使った映画レビューの感情分析など)を選びましょう。
- コストを包括的に見積もる:プロジェクト計画段階で、データ、計算、デプロイ、リスクの4つの観点から意識的に大まかなコスト見積もりを行いましょう。
- シンプルな解決策を優先する:複雑なディープラーニングモデルを試す前に、ロジスティック回帰や決定木などのシンプルなモデルを試しましょう。これらはコストが低く、高速で、解釈も容易です。
- 継続的な監視と評価:モデルの本番展開は終点ではありません。監視指標を設定し、実際の環境でのモデルのパフォーマンスとビジネス価値を定期的に評価しましょう。
覚えておいてください。優れた機械学習の実践者は、モデルアーキテクトであるだけでなく、コスト・効果・リスクを考慮したエンジニアでもあります。。
その他の拡張