El costo real de los modelos
Imagina que acabas de entrenar un modelo de reconocimiento de imágenes con una precisión del 99% en el conjunto de prueba. Con plena confianza, lo implementas en la línea de producción de una fábrica.
Sin embargo, semanas después recibes comentarios: el modelo comete errores frecuentemente, provocando paradas injustificadas en la línea de producción y enormes pérdidas económicas. ¿Dónde está el problema?
Este escenario revela una verdad a menudo ignorada en el campo del aprendizaje automático:El excelente desempeño de un modelo en el laboratorio o en un entorno de prueba no equivale a su éxito en el mundo real.
En el viaje del modelo desde el desarrollo hasta la implementación, existen muchas limitaciones y costos ocultos.
Este artículo te llevará a explorar en profundidad estos costos reales, ayudándote a desarrollar una perspectiva más completa y pragmática del aprendizaje automático.
Más allá de la precisión: entendiendo el costo integral de los modelos
Cuando hablamos del costo de un modelo, la mayoría piensa primero en el tiempo de GPU y la electricidad consumidos para entrenarlo. Pero esto es solo la punta del iceberg.
El costo de un proyecto completo de aprendizaje automático incluye al menos las siguientes cuatro dimensiones:
1. Costo de datos: obtención y limpieza del combustible
Los modelos de aprendizaje automático usan datos como "combustible", y el costo de obtener combustible de alta calidad es extremadamente alto.
Costo de recopilación de datos:
- Costo monetario: gastos en comprar conjuntos de datos etiquetados y utilizar servicios de recopilación de datos (como la plataforma de crowdsourcing MTurk).
- Costo de tiempo: desde definir las especificaciones de etiquetado y capacitar al personal de etiquetado hasta completar el etiquetado inicial, el ciclo puede durar semanas o incluso meses.
- Costo de cumplimiento normativo: garantizar que la recopilación de datos cumpla con regulaciones como GDPR (Reglamento General de Protección de Datos) y CCPA (Ley de Privacidad del Consumidor de California) puede requerir asesoría legal y diseño de procesos.
Costos de preprocesamiento y etiquetado de datos:
- Costo de limpieza: los datos reales están llenos de ruido, valores faltantes y valores atípicos. La limpieza generalmente ocupa del 60% al 80% del tiempo total del proyecto.
- Costo de etiquetado: tomando como ejemplo el etiquetado de cuadros delimitadores en imágenes, una imagen compleja puede requerir varios minutos de etiquetado. Para un conjunto de datos de cien mil imágenes, el costo de mano de obra y gestión del etiquetado es muy considerable.
Ejemplo
def estimate_labeling_cost(num_images, time_per_image, cost_per_hour):
"""
Estimar el costo total del etiquetado de datos
Parámetros:
num_images (int): número total de imágenes a etiquetar
time_per_image (float): tiempo promedio de etiquetado por imagen (horas)
cost_per_hour (float): costo por hora del personal de etiquetado (unidad monetaria)
Retorna:
total_hours, total_cost: tiempo total y costo total
"""
total_hours = num_images * time_per_image
total_cost = total_hours * cost_per_hour
return total_hours, total_cost
# Supongamos que un proyecto tiene 100,000 imágenes, cada una requiere 0.05 horas (3 minutos) de etiquetado y el costo por hora es de 20 yuanes.
hours, cost = estimate_labeling_cost(100000, 0.05, 20)
print(f"Tiempo total: {hours:.0f} horas")
print(f"Costo total: {cost:.2f} yuanes")
# Salida: Tiempo total: 5000 horas
# Salida: Costo total: 100000.00 yuanes
2. Costo computacional: la factura energética del entrenamiento y la inferencia
El costo computacional se divide en costo de entrenamiento único y costo de inferencia continuo.
Costo de entrenamiento:
- Uso de instancias GPU facturadas por hora en servicios en la nube (como AWS SageMaker, Google Cloud AI Platform).
- El proceso de ajuste de modelos (optimización de hiperparámetros) puede requerir entrenar decenas o cientos de copias del modelo, multiplicando el costo.
Costo de inferencia:
- Una vez implementado el modelo, cada vez que se procesa una solicitud de usuario (es decir, se realiza una predicción) se genera un costo computacional.
- Para servicios de alta concurrencia (como sistemas de recomendación personalizados para miles de usuarios), incluso si el costo de una sola inferencia es muy bajo, acumulado resulta extremadamente grande.
Ejemplo
def estimate_training_cost(training_hours, instance_hourly_rate, num_trials=1):
"""
Estimar el costo de entrenar un modelo en una plataforma en la nube
Parámetros:
training_hours (float): horas necesarias para un solo entrenamiento
instance_hourly_rate (float): tarifa por hora de la instancia GPU (en dólares)
num_trials (int): número de búsquedas de hiperparámetros o experimentos
Retorna:
total_cost: costo total estimado
"""
total_cost = training_hours * instance_hourly_rate * num_trials
return total_cost
# Supongamos que entrenar un modelo requiere 10 horas, usando una instancia P3 a 4 dólares por hora, y se realizan 20 experimentos de hiperparámetros.
cost = estimate_training_cost(10, 4, 20)
print(f"Costo total estimado de entrenamiento: {cost} dólares")
# Salida: Costo total estimado de entrenamiento: 800 dólares
3. Costos de implementación y mantenimiento: mantener el modelo en funcionamiento
Implementar el modelo en un entorno de producción y mantener su funcionamiento estable es una inversión a largo plazo.
Costo de infraestructura:
- Gastos de servidores, gestión de contenedores (como Kubernetes), balanceo de carga y tráfico de red.
- Costos de herramientas y mano de obra para desarrollar el pipeline de implementación (CI/CD para ML).
Costos de monitoreo y mantenimiento:
- Es necesario monitorear continuamente el rendimiento de predicción, la latencia y el uso de recursos del modelo.
- La distribución de datos puede cambiar con el tiempo (deriva conceptual), lo que requiere reentrenar o ajustar el modelo periódicamente con nuevos datos, generando costos continuos de reentrenamiento.
4. Costo de oportunidad y costo de riesgo: el precio invisible
Esta es la parte más fácil de subestimar.
Costo de oportunidad:
- Que un equipo dedique 3 meses a desarrollar una solución de aprendizaje automático puede significar perder la oportunidad de resolver el problema en 1 mes con un sistema de reglas más simple.
Costo de riesgo:
- Sesgo del modelo: si los datos de entrenamiento no representan a todos los usuarios, el modelo puede ser injusto con ciertos grupos, provocando problemas éticos y crisis de relaciones públicas.
- Errores de predicción: en campos como la medicina, las finanzas y la conducción autónoma, una predicción errónea puede causar daños personales o pérdidas materiales significativas, generando riesgos legales.
El techo de la tecnología: limitaciones inherentes del aprendizaje automático
Incluso sin considerar los costos, la tecnología de aprendizaje automático tiene límites inherentes.
1. Dependencia de datos y "basura entra, basura sale"
Los modelos de aprendizaje automático dependen completamente de sus datos de entrenamiento. Si la calidad de los datos es deficiente, su escala es pequeña o presentan sesgos, el desempeño del modelo se verá limitado.
- Problema de datos pequeños: en ciertos campos de nicho (como el diagnóstico de enfermedades raras), puede ser imposible obtener suficientes datos de alta calidad para entrenar un modelo confiable.
- Sesgo de datos: si los datos históricos contienen sesgos sociales (como la discriminación de género en la contratación), el modelo aprenderá y amplificará estos sesgos.
2. El dilema de la explicabilidad: el precio de la caja negra
Muchos modelos de alto rendimiento (como las redes neuronales profundas) son "cajas negras" complejas; es difícil entender su lógica interna de decisión.
- En áreas que requieren alta confiabilidad y auditabilidad (como la aprobación de créditos o la asistencia judicial), el uso de modelos de caja negra puede no estar permitido.
- Cuando el modelo comete errores, es difícil diagnosticar la causa raíz, lo que aumenta la dificultad de depuración y corrección.
3. Los límites de la capacidad de generalización
Que un modelo funcione bien en los conjuntos de entrenamiento y prueba no significa que pueda manejar todas las situaciones del mundo real.
- Datos fuera de distribución: el modelo puede no ser capaz de procesar entradas cuya distribución difiera demasiado de los datos de entrenamiento. Por ejemplo, un sistema de conducción autónoma entrenado solo con imágenes de días despejados podría fallar por completo en días de niebla.
- Muestras adversariales: realizar perturbaciones mínimas e imperceptibles para los humanos en la entrada puede provocar que el modelo haga predicciones completamente erróneas, lo que supone una gran amenaza para sistemas con altos requisitos de seguridad.
Ejemplo
import numpy as np
# Supongamos que un simple "clasificador de perros y gatos" solo ha visto imágenes nítidas durante el entrenamiento
def trained_classifier_confidence(image):
"""Simular un modelo entrenado con imágenes nítidas"""
# Aquí simplificamos: si la varianza de los valores de píxeles es grande (indica más detalles y nitidez), la confianza es alta
clarity = np.var(image)
if clarity > 1000: # Umbral hipotético para imágenes nítidas
return 0.95 # Alta confianza
else:
return 0.55 # Baja confianza, indica que el modelo no está seguro
# Simular una imagen nítida (alta varianza) y una imagen borrosa (baja varianza)
clear_image = np.random.randn(100, 100) * 255 # Alta varianza, simula nitidez
blurry_image = np.random.randn(100, 100) * 50 + 128 # Baja varianza, simula borrosidad
print(f"Confianza de predicción para imagen nítida: {trained_classifier_confidence(clear_image):.2f}")
print(f"Confianza de predicción para imagen borrosa: {trained_classifier_confidence(blurry_image):.2f}")
# Posible salida: Confianza de predicción para imagen nítida: 0.95
# Posible salida: Confianza de predicción para imagen borrosa: 0.55
# Indica que el modelo no tiene suficiente confianza en imágenes borrosas no vistas
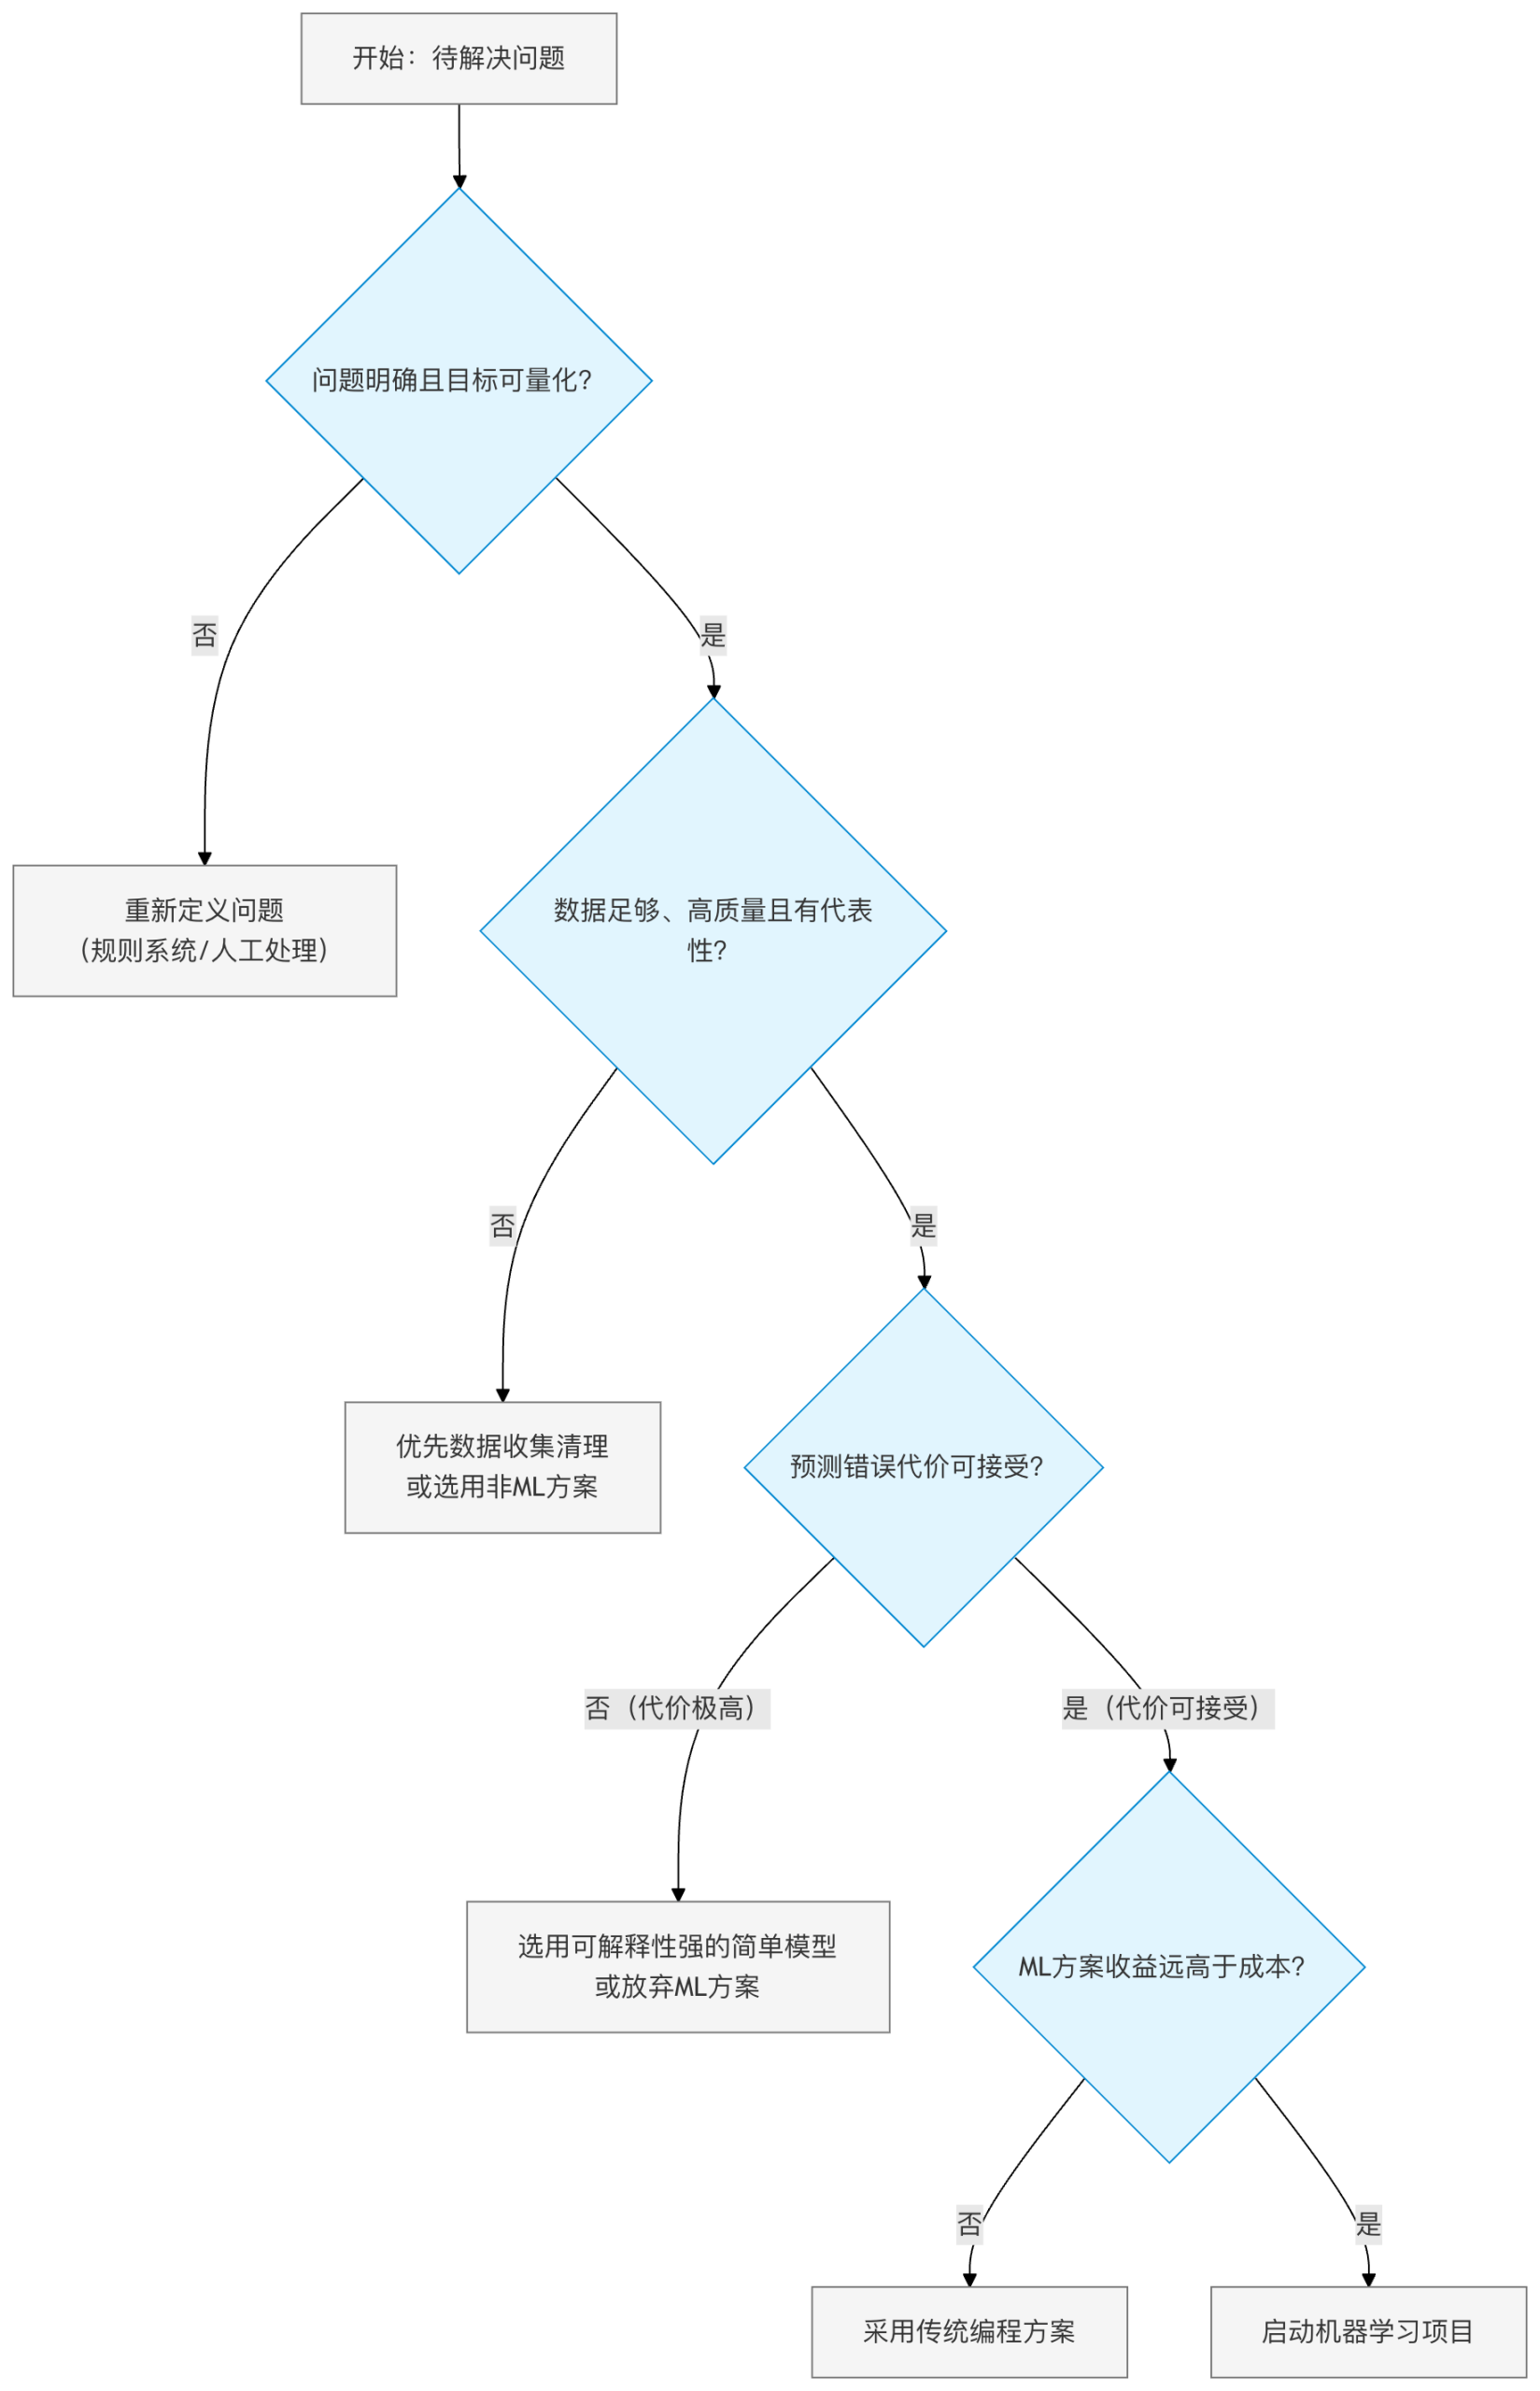
Análisis de costo-beneficio: ¿cuándo usar aprendizaje automático?
Ante estos costes y limitaciones, no deberíamos aplicar machine learning a ciegas. Antes de iniciar un proyecto, asegúrate de realizar un análisis de coste-beneficio y considera las siguientes alternativas:
Diagrama de flujo de decisión: ¿deberíamos usar aprendizaje automático?
Alternativas pragmáticas
- Sistemas basados en reglas: Si la lógica de negocio es clara y estable, y hay pocos casos excepcionales, escribir reglas if-else puede ser más rápido, barato y fiable.
- Métodos estadísticos: Para muchas tareas de análisis, métodos estadísticos clásicos como la regresión lineal y las pruebas de hipótesis pueden ser suficientes y más fáciles de interpretar.
- Colaboración humano-máquina: En algunos escenarios, utilizar machine learning como herramienta de apoyo (por ejemplo, filtrar casos de alta probabilidad para revisión humana) es más rentable y seguro que la automatización total.
Resumen y guía de acción
El machine learning es una tecnología poderosa, pero no es una "bala de plata" que resuelva todos los problemas. Su aplicación exitosa se basa en elcoste realclaro conocimiento ylímites técnicosy en el pleno respeto.
Recomendaciones de acción para principiantes
- Empieza poco a poco: Elige escenarios con un alcance pequeño, datos fáciles de obtener y bajo coste de error (por ejemplo, análisis de sentimiento de reseñas de películas con un conjunto de datos público).
- Estima los costes de forma integral: En la fase de planificación del proyecto, realiza conscientemente una estimación aproximada de los costes desde cuatro dimensiones: datos, computación, implementación y riesgos.
- Prioriza las soluciones simples: Antes de probar modelos complejos de deep learning, prueba primero modelos simples como regresión logística o árboles de decisión. Son más baratos, más rápidos y más fáciles de interpretar.
- Monitorización y evaluación continuas: El despliegue del modelo no es el final. Establece métricas de monitorización y evalúa periódicamente el rendimiento del modelo en el entorno real y su valor para el negocio.
Recuerda: un buen profesional de machine learning no solo es arquitecto de modelos, sino también uningeniero.。
Otras ampliaciones