Le coût réel des modèles
Imaginez que vous venez d'entraîner un modèle de reconnaissance d'images qui atteint 99% de précision sur l'ensemble de test, et que vous le déployez en toute confiance sur une ligne de production en usine.
Cependant, quelques semaines plus tard, vous recevez des retours : le modèle se trompe fréquemment, ce qui provoque l'arrêt de la ligne de production plusieurs fois sans raison, entraînant d'énormes pertes économiques. Où est le problème ?
Ce scénario révèle une vérité souvent négligée dans le domaine de l'apprentissage automatique :L'excellente performance d'un modèle dans un laboratoire ou un environnement de test n'équivaut pas à son succès dans le monde réel.
Dans le parcours d'un modèle, du développement au déploiement, il existe de nombreuses limites et coûts cachés.
Cet article vous fera découvrir en profondeur ces coûts réels et vous aidera à construire une perspective plus complète et pragmatique de l'apprentissage automatique.
Au-delà de la précision - Comprendre le coût total des modèles
Lorsque nous parlons du coût d'un modèle, la plupart des gens pensent d'abord au temps GPU et à l'électricité consommés pendant l'entraînement. Mais ce n'est que la partie émergée de l'iceberg.
Le coût d'un projet complet d'apprentissage automatique comprend au moins les quatre dimensions suivantes :
1. Coût des données : acquisition et purification du carburant
Les modèles d'apprentissage automatique utilisent les données comme « carburant », et le coût d'obtention d'un carburant de haute qualité est extrêmement élevé.
Coût de collecte des données:
- Coût monétaire: dépenses liées à l'achat d'ensembles de données annotées et à l'utilisation de services de collecte de données (comme la plateforme de crowdsourcing MTurk).
- Coût en temps: depuis la définition des spécifications d'annotation et la formation des annotateurs jusqu'à l'achèvement de l'annotation initiale, le cycle peut durer des semaines, voire des mois.
- Coût de conformité: garantir que la collecte de données respecte les lois et réglementations telles que le RGPD (Règlement général sur la protection des données) et le CCPA (loi californienne sur la protection de la vie privée des consommateurs) peut nécessiter des consultations juridiques et la conception de processus.
Coût de prétraitement et d'annotation des données:
- Coût de nettoyage: les données du monde réel sont remplies de bruit, de valeurs manquantes et de valeurs aberrantes. Le nettoyage prend généralement 60-80% du temps de l'ensemble du projet.
- Coût d'annotation: en prenant l'annotation de boîtes englobantes d'images comme exemple, l'annotation d'une seule image complexe peut prendre plusieurs minutes. Pour un ensemble de données de cent mille images, les coûts de main-d'œuvre et de gestion de l'annotation sont considérables.
Exemple
def estimate_labeling_cost(num_images, time_per_image, cost_per_hour):
"""
Estimer le coût total de l'annotation des données
Paramètres :
num_images (int) : nombre total d’images à annoter
time_per_image (float) : temps moyen pour annoter une seule image (heures)
cost_per_hour (float) : coût horaire d’un annotateur (unité monétaire)
Retourne :
total_hours, total_cost : Heures totales et coût total
"""
total_hours = num_images * time_per_image
total_cost = total_hours * cost_per_hour
return total_hours, total_cost
# Supposons qu’un projet comporte 100,000 images, que chaque image prenne 0.05 heure (3 minutes) à annoter, et que le coût horaire soit de 20 yuan
hours, cost = estimate_labeling_cost(100000, 0.05, 20)
print(f"Heures totales : {hours:.0f} heures")
print(f"Coût total : {cost:.2f} yuan")
# Sortie : Total des heures : 5000 heures
# Sortie : Coût total : 100000.00 yuan
2. Coût de calcul : la facture énergétique pour l'entraînement et l'inférence
Le coût de calcul se divise en coût d'entraînement ponctuel et coût d'inférence continu.
Coût d'entraînement:
- Utilisez des instances GPU facturées à l'heure à partir de services cloud (tels qu'AWS SageMaker, Google Cloud AI Platform).
- Le processus de réglage du modèle (optimisation des hyperparamètres) peut nécessiter l'entraînement de dizaines à des centaines de répliques du modèle, ce qui multiplie le coût.
Coût d'inférence:
- Une fois le modèle déployé, chaque fois qu'il traite une requête utilisateur (c'est-à-dire qu'il effectue une prédiction), un coût de calcul est engagé.
- Pour les services à forte concurrence (tels que les systèmes de recommandation personnalisés), même si le coût par inférence est très faible, le coût cumulé peut être énorme.
Exemple
def estimate_training_cost(training_hours, instance_hourly_rate, num_trials=1):
"""
Estimer le coût d'entraînement d'un modèle sur une plateforme cloud
Paramètres :
training_hours (float) : Nombre d'heures nécessaires pour une seule exécution d'entraînement
instance_hourly_rate (float) : Tarif horaire de l'instance GPU (USD)
num_trials (int) : Nombre de recherches d'hyperparamètres ou d'expériences
Retourne :
total_cost : Coût total estimé
"""
total_cost = training_hours * instance_hourly_rate * num_trials
return total_cost
# Supposons que l'entraînement d'un modèle prend 10 heures, en utilisant une instance P3 à $4 par heure, et en réalisant 20 ensembles d'expériences d'hyperparamètres
cost = estimate_training_cost(10, 4, 20)
print(f"Coût total estimé de l'entraînement : {cost} USD")
# Sortie : Coût total estimé de l'entraînement : 800 USD
3. Coût de déploiement et de maintenance : Maintenir le modèle en fonctionnement
Le déploiement d'un modèle dans un environnement de production et son maintien en fonctionnement stable est un investissement à long terme.
Coût d'infrastructure:
- Coûts des serveurs, de la gestion des conteneurs (tels que Kubernetes), de l'équilibrage de charge et du trafic réseau.
- Coûts des outils et de la main-d'œuvre pour le développement de pipelines de déploiement (CI/CD pour le ML).
Coût de surveillance et de maintenance:
- Il est nécessaire de surveiller en continu les performances de prédiction du modèle, la latence et l'utilisation des ressources.
- La distribution des données peut évoluer avec le temps (dérive conceptuelle), ce qui nécessite un réentraînement périodique ou un ajustement fin du modèle avec de nouvelles données, entraînant des coûts de réentraînement continus.
4. Coût d'opportunité et coût des risques : le prix invisible
C'est la partie la plus facilement sous-estimée.
Coût d'opportunité:
- Une équipe qui passe 3 mois à développer une solution d'apprentissage automatique peut manquer l'opportunité de résoudre le problème en 1 mois avec un système plus simple à base de règles.
Coût des risques:
- Biais du modèle: Si les données d'entraînement ne sont pas représentatives de tous les utilisateurs, le modèle peut être injuste envers certains groupes, déclenchant des problèmes éthiques et des crises de relations publiques.
- Erreurs de prédiction: Dans des domaines tels que la santé, la finance et la conduite autonome, une seule prédiction erronée peut entraîner des dommages corporels ou des dégâts matériels importants, entraînant des risques juridiques.
Le plafond de la technologie - Limites intrinsèques de l'apprentissage automatique
Même sans tenir compte du coût, la technologie d'apprentissage automatique elle-même a des limites inhérentes.
1. Dépendance aux données et « Garbage In, Garbage Out »
Les modèles d'apprentissage automatique dépendent entièrement de leurs données d'entraînement. Si les données sont de mauvaise qualité, en faible quantité ou biaisées, les performances du modèle seront limitées.
- Problème de petites données: Pour certains domaines de niche (comme le diagnostic de maladies rares), il peut être impossible d'obtenir suffisamment de données de haute qualité pour entraîner un modèle fiable.
- Biais des données: Si les données historiques contiennent des biais sociaux (comme la discrimination de genre à l'embauche), le modèle apprendra et amplifiera ces biais.
2. Le dilemme de l'interprétabilité : Le prix de la boîte noire
De nombreux modèles très performants (comme les réseaux de neurones profonds) sont des « boîtes noires » complexes, ce qui rend difficile la compréhension de leur logique de décision interne.
- Dans les domaines exigeant une grande fiabilité et une auditabilité (comme l'octroi de crédit et l'assistance judiciaire), l'utilisation de modèles de type boîte noire peut ne pas être autorisée.
- Lorsque le modèle fait des erreurs, il est difficile d'en diagnostiquer la cause racine, ce qui augmente la difficulté du débogage et de la correction.
3. Les limites de la capacité de généralisation
Le fait qu'un modèle soit performant sur les ensembles d'entraînement et de test ne signifie pas qu'il peut gérer toutes les situations du monde réel.
- Données hors distribution: Le modèle peut être incapable de gérer des entrées qui diffèrent trop de la distribution des données d'entraînement. Par exemple, un système de conduite autonome entraîné uniquement sur des images ensoleillées peut complètement échouer par temps brumeux.
- Exemples adversariaux: De minuscules perturbations de l'entrée, imperceptibles pour les humains, peuvent amener le modèle à faire des prédictions complètement fausses, ce qui constitue une menace majeure pour les systèmes ayant des exigences de sécurité élevées.
Exemple
import numpy as np
# Supposons qu'un simple « classifieur chat vs chien » n'ait vu que des images nettes pendant l'entraînement
def trained_classifier_confidence(image):
"""Simuler un modèle entraîné sur des images nettes"""
# Simplifié ici : si la variance des valeurs des pixels de l'image est grande (indiquant plus de détails, plus nette), la confiance est élevée
clarity = np.var(image)
if clarity > 1000: # Seuil supposé pour les images nettes
return 0.95 # Confiance élevée
else:
return 0.55 # Faible confiance, indiquant que le modèle est incertain
# Simuler une image nette (variance élevée) et une image floue (variance faible)
clear_image = np.random.randn(100, 100) * 255 # Variance élevée, simulant une image nette
blurry_image = np.random.randn(100, 100) * 50 + 128 # Variance faible, simulant une image floue
print(f"Confiance de prédiction pour l'image nette : {trained_classifier_confidence(clear_image):.2f}")
print(f"Confiance de prédiction pour l'image floue : {trained_classifier_confidence(blurry_image):.2f}")
# Sortie possible : Confiance de prédiction pour l'image nette : 0.95
# Sortie possible : Confiance de prédiction pour l'image floue : 0.55
# Indique que le modèle manque de confiance dans les images floues non vues
Analyse coûts-avantages - Quand utiliser l'apprentissage automatique ?
Face à ces coûts et limites, nous ne devrions pas appliquer aveuglément l'apprentissage automatique. Avant de démarrer un projet, veillez à mener une analyse coûts-avantages et à considérer les alternatives suivantes :
Organigramme de décision : Devons-nous utiliser l'apprentissage automatique ?
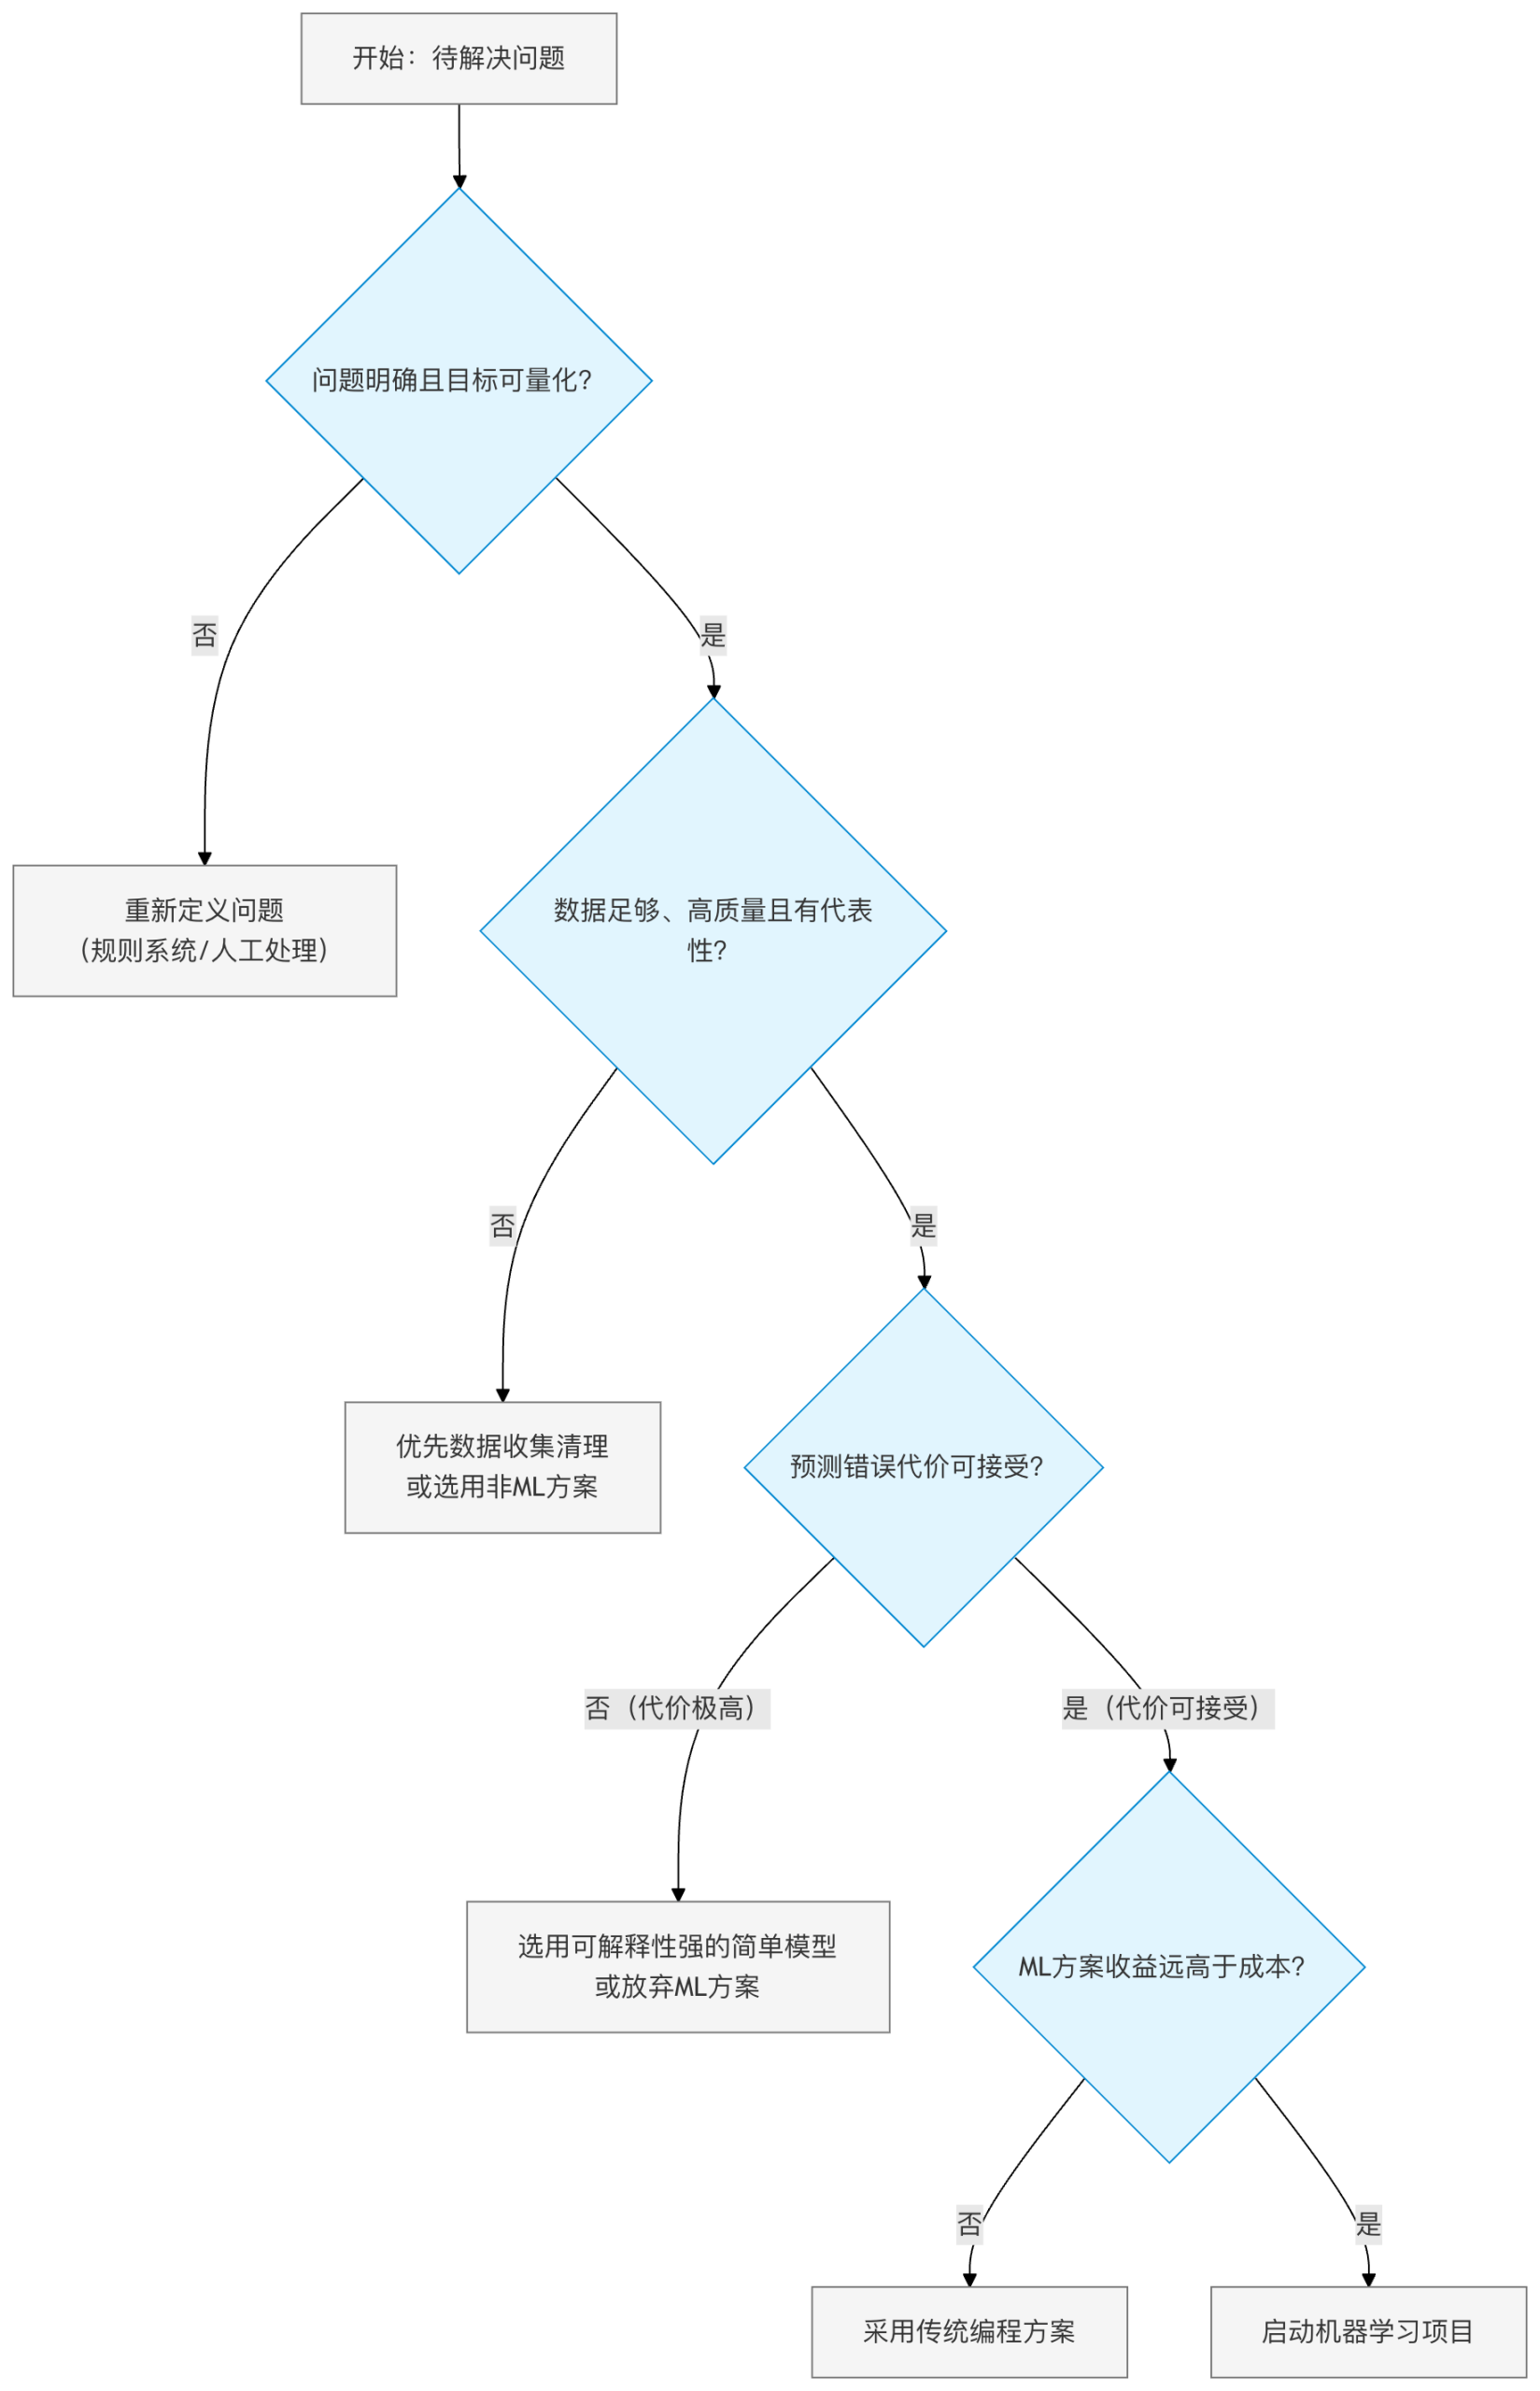
Alternatives pragmatiques
- Systèmes à base de règles: Si la logique métier est claire, stable et comporte peu d'exceptions, écrire des règles if-else peut être plus rapide, moins coûteux et plus fiable.
- Méthodes statistiques: Pour de nombreuses tâches analytiques, les méthodes statistiques classiques telles que la régression linéaire et les tests d'hypothèses peuvent déjà être suffisantes et sont plus faciles à interpréter.
- Collaboration homme-machine: Dans certains scénarios, utiliser l'apprentissage automatique comme outil auxiliaire (par ex., filtrer les cas à forte probabilité pour un examen manuel) est plus rentable et plus sûr que l'automatisation complète.
Résumé et guide d'action
L'apprentissage automatique est une technologie puissante, mais ce n'est pas une « solution miracle » à tous les problèmes. Son application réussie repose surune compréhension claire des coûts réelsetun respect total des limites techniques.
Suggestions d'action pour les débutants
- Commencer petit: Lorsque vous démarrez votre premier projet, choisissez un scénario de petite envergure, avec des données facilement accessibles et un faible coût des erreurs (par ex., l'analyse de sentiments sur des critiques de films à l'aide d'un jeu de données public).
- Estimer les coûts de manière exhaustive: Pendant la phase de planification du projet, réalisez consciemment une estimation approximative des coûts selon quatre dimensions : données, calcul, déploiement et risque.
- Prioriser les solutions simples: Avant d'essayer des modèles complexes d'apprentissage profond, essayez d'abord des modèles simples tels que la régression logistique et les arbres de décision. Ils sont moins coûteux, plus rapides et plus faciles à interpréter.
- Surveillance et évaluation continues: Le déploiement d'un modèle n'est pas la fin. Établissez des indicateurs de surveillance et évaluez régulièrement les performances et la valeur métier du modèle dans des environnements réels.
N'oubliez pas qu'un excellent praticien de l'apprentissage automatique n'est pas seulement un architecte de modèles, mais aussi uningénieur qui pèse les coûts, les bénéfices et les risques.。
Autres extensions