Sobreajuste, subajuste, sesgo y varianza
En el mundo del aprendizaje automático, construir un modelo es como entrenar a un estudiante; nuestro objetivo es que esteestudianteno solo pueda memorizar los ejemplos del libro de texto (datos de entrenamiento), sino que también comprenda profundamente los principios subyacentes, logrando así buenos resultados en preguntas de examen completamente nuevas y nunca antes vistas (datos de prueba). Sin embargo, esteestudiantepuede encontrarse con dos problemas típicos durante el proceso de aprendizaje:
- uno es aprender de manera demasiado rígida, limitándose a aplicar mecánicamente los ejemplos (subajuste);
- el otro es aprender de manera demasiado astuta, memorizando incluso los signos de puntuación y las características de la escritura de los ejemplos, lo que lo deja perplejo ante problemas nuevos (sobreajuste)。
Comprenderel sobreajusteyy el subajuste, así como los conceptos teóricos más profundos que hay detrás —sesgoyvarianza, es un paso clave para que todo profesional del aprendizaje automático pase de principiante a experto. Explican por qué el modelo comete errores y nos señalan la dirección para mejorar el modelo.
I. Conceptos clave: el rendimiento del modelo y el estado de "ajuste"
Primero, comprendamos a través de un ejemplo intuitivo qué es elajuste. Supongamos que queremos ajustar un conjunto de datos de puntos dispersos con un modelo matemático.
Ejemplo
import matplotlib.pyplot as plt
# -------------------------- Configurar fuente china start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows primero
'SimHei', 'Microsoft YaHei',
# Priorizar macOS
'PingFang SC', 'Heiti TC',
# Priorizar Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corregir el problema de que el signo negativo se muestre como un cuadrado
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de configuración de fuente china --------------------------
# Generar datos simulados: añadir algo de ruido aleatorio a la curva sinusoidal
np.random.seed(42)
X = np.linspace(0, 10, 20)
y_true = np.sin(X) # Los verdaderos patrones latentes (que no conocemos)
y_noise = np.random.randn(20) * 0.3 # Ruido aleatorio
y = y_true + y_noise # Los datos que realmente observamos
plt.scatter(X, y, label=Datos de observación (con ruido), color='blue', alpha=0.6)
plt.plot(X, y_true, label='Relación real (y=sin(x))', color='green', linewidth=2)
plt.xlabel('X')
plt.ylabel('y')
plt.title('Datos y patrones subyacentes')
plt.legend()
plt.grid(True)
plt.show()
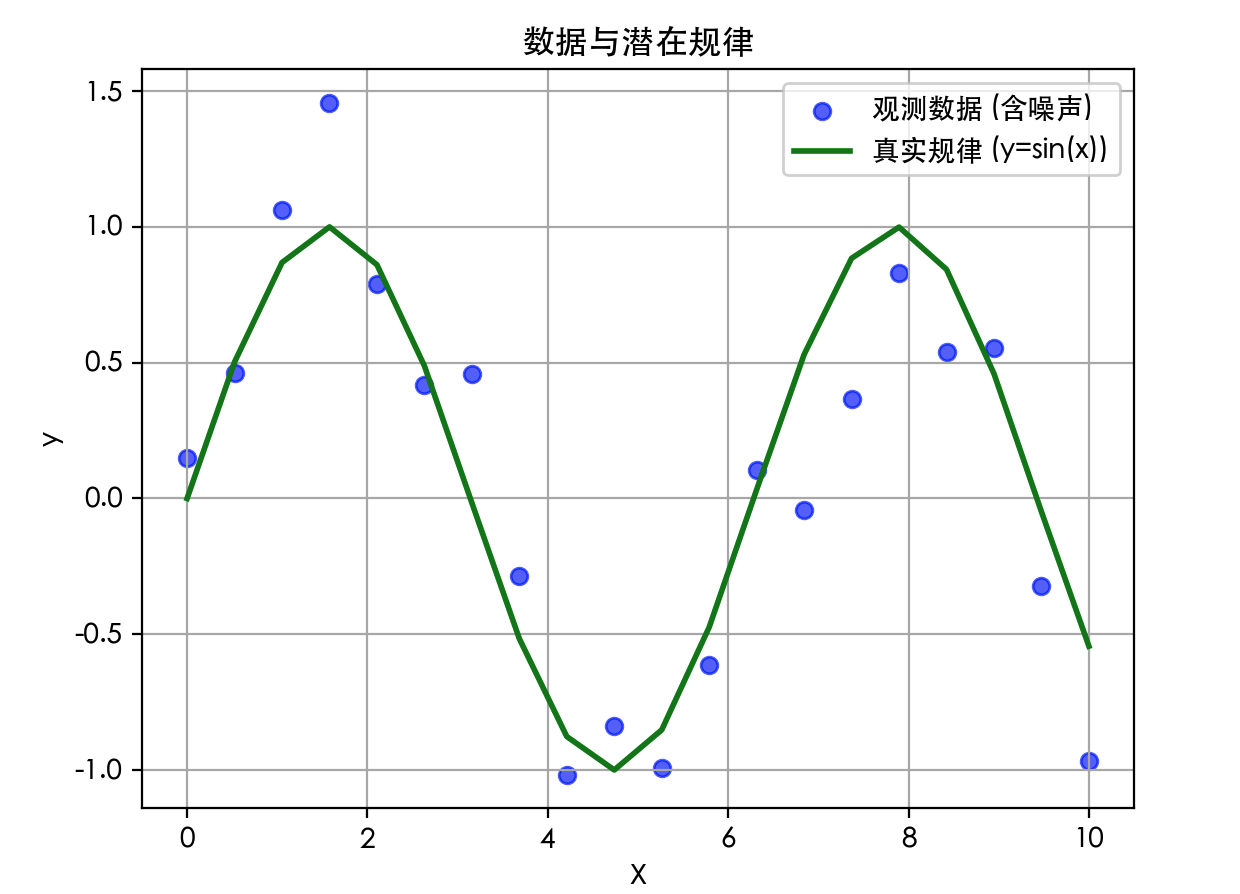
Nuestro objetivo es encontrar una curva (modelo) que describa de la mejor manera la regla que reflejan estos puntos azules (datos).
El grado en que el modelo describe los datos es elajuste。
1. Subajuste
El subajustese refiere a un modelo demasiado simple que no puede capturar las reglas o patrones básicos de los datos. Es como un estudiante que solo ha aprendido a sumar pero quiere resolver problemas de cálculo.
- Manifestación: el modelo en losdatos de entrenamientotiene un rendimiento deficiente (por ejemplo, baja precisión, gran error).
- Causa: la complejidad del modelo es demasiado baja, las características son insuficientes o el entrenamiento es inadecuado.
- Analogía: usar una línea recta (polinomio de grado 1) para ajustar datos con una tendencia claramente curva.
Ejemplo
from sklearn.preprocessing import PolynomialFeatures
from sklearn.metrics import mean_squared_error
# Intenta ajustar con un polinomio de grado 1 (línea recta)
poly = PolynomialFeatures(degree=1)
X_poly1 = poly.fit_transform(X.reshape(-1, 1))
model_under = LinearRegression()
model_under.fit(X_poly1, y)
y_pred_under = model_under.predict(X_poly1)
mse_train_under = mean_squared_error(y, y_pred_under)
print(fError cuadrático medio (MSE) del modelo subajustado en el conjunto de entrenamiento: {mse_train_under:.4f})
Salida:
欠拟合模型在训练集上的均方误差 (MSE): 0.4402
欠拟合模型在训练集上的均方误差 (MSE): 0.4402
2. El ajuste adecuado
Este es el estado ideal. El modelo es lo suficientemente complejo para aprender los patrones clave de los datos, pero no tan complejo como para aprender el ruido aleatorio. Rinde bien tanto en el conjunto de entrenamiento como en el conjunto de prueba desconocido.
- Manifestación: los errores en el conjunto de entrenamiento y en el de prueba son bajos y cercanos entre sí.
- Analogía: ajustar los datos con un polinomio de grado adecuado (por ejemplo, grado 3).
Ejemplo
poly = PolynomialFeatures(degree=3)
X_poly3 = poly.fit_transform(X.reshape(-1, 1))
model_good = LinearRegression()
model_good.fit(X_poly3, y)
y_pred_good = model_good.predict(X_poly3)
mse_train_good = mean_squared_error(y, y_pred_good)
print(fError cuadrático medio (MSE) del modelo con buen ajuste en el conjunto de entrenamiento: {mse_train_good:.4f})
Salida:
欠拟合模型在训练集上的均方误差 (MSE): 0.4402
良好拟合模型在训练集上的均方误差 (MSE): 0.3988
3. Sobreajuste
El sobreajustese refiere a un modelo demasiado complejo que no solo aprende las reglas reales de los datos, sino que también "memoriza" el ruido aleatorio y los valores atípicos de los datos de entrenamiento.
- Manifestación: el modelo en losdatos de entrenamientotiene un rendimiento excelente (error mínimo), pero en losdatos nuevos y no vistossu rendimiento cae drásticamente y su capacidad de generalización es deficiente.
- Causa: la complejidad del modelo es demasiado alta y la cantidad de datos de entrenamiento es demasiado pequeña.
- Analogía: ajustar los datos con un polinomio de grado muy alto (por ejemplo, grado 15), lo que hace que la curva pase por casi todos los puntos y se distorsione extremadamente.
Ejemplo
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures
from sklearn.metrics import mean_squared_error
# -------------------------- Configurar fuente china start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows primero
'SimHei', 'Microsoft YaHei',
# Priorizar macOS
'PingFang SC', 'Heiti TC',
# Priorizar Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corregir el problema de que el signo negativo se muestre como un cuadrado
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de configuración de fuente china --------------------------
# Generar datos simulados: añadir algo de ruido aleatorio a la curva sinusoidal
np.random.seed(42)
X = np.linspace(0, 10, 20)
y_true = np.sin(X) # Los verdaderos patrones latentes (que no conocemos)
y_noise = np.random.randn(20) * 0.3 # Ruido aleatorio
y = y_true + y_noise # Los datos que realmente observamos
# Intenta ajustar con un polinomio de grado 1 (línea recta)
poly = PolynomialFeatures(degree=1)
X_poly1 = poly.fit_transform(X.reshape(-1, 1))
model_under = LinearRegression()
model_under.fit(X_poly1, y)
y_pred_under = model_under.predict(X_poly1)
mse_train_under = mean_squared_error(y, y_pred_under)
print(fError cuadrático medio (MSE) del modelo subajustado en el conjunto de entrenamiento: {mse_train_under:.4f})
# Intentar ajustar con un polinomio de grado 3
poly = PolynomialFeatures(degree=3)
X_poly3 = poly.fit_transform(X.reshape(-1, 1))
model_good = LinearRegression()
model_good.fit(X_poly3, y)
y_pred_good = model_good.predict(X_poly3)
mse_train_good = mean_squared_error(y, y_pred_good)
print(fError cuadrático medio (MSE) del modelo con buen ajuste en el conjunto de entrenamiento: {mse_train_good:.4f})
# Intento de ajuste con polinomio de grado 15 (muy propenso a sobreajuste)
poly = PolynomialFeatures(degree=15)
X_poly15 = poly.fit_transform(X.reshape(-1, 1))
model_over = LinearRegression()
model_over.fit(X_poly15, y)
y_pred_over = model_over.predict(X_poly15)
mse_train_over = mean_squared_error(y, y_pred_over)
print(fError cuadrático medio (MSE) del modelo sobreajustado en el conjunto de entrenamiento: {mse_train_over:.4f})
# Visualizar los tres estados de ajuste
plt.figure(figsize=(15, 4))
# subajuste
plt.subplot(1, 3, 1)
plt.scatter(X, y, alpha=0.6)
plt.plot(X, y_pred_under, color='red', linewidth=2, label='Subajuste (orden 1)')
plt.plot(X, y_true, color='green', linestyle='--', label='patrón real')
plt.title(f'Subajuste MSE de entrenamiento: {mse_train_under:.4f}'\n# Buen ajuste)
plt.legend()
plt.grid(True)
'Buen ajuste (grado 3)'
plt.subplot(1, 3, 2)
plt.scatter(X, y, alpha=0.6)
plt.plot(X, y_pred_good, color='red', linewidth=2, label='patrón real')
plt.plot(X, y_true, color='green', linestyle='--', label=Buen ajuste MSE de entrenamiento: {mse_train_good:.4f})
plt.title(f# sobreajuste\n'Sobreajuste (grado 15)')
plt.legend()
plt.grid(True)
'patrón real'
plt.subplot(1, 3, 3)
plt.scatter(X, y, alpha=0.6)
plt.plot(X, y_pred_over, color='red', linewidth=2, label=Sobreajuste MSE de entrenamiento: {mse_train_over:.4f})
plt.plot(X, y_true, color='green', linestyle='--', label=En la figura se puede ver claramente:)
plt.title(fSubajuste (izquierda)\n: la línea roja no puede capturar en absoluto la tendencia de fluctuación de los datos.)
plt.legend()
plt.grid(True)
plt.tight_layout()
plt.show()
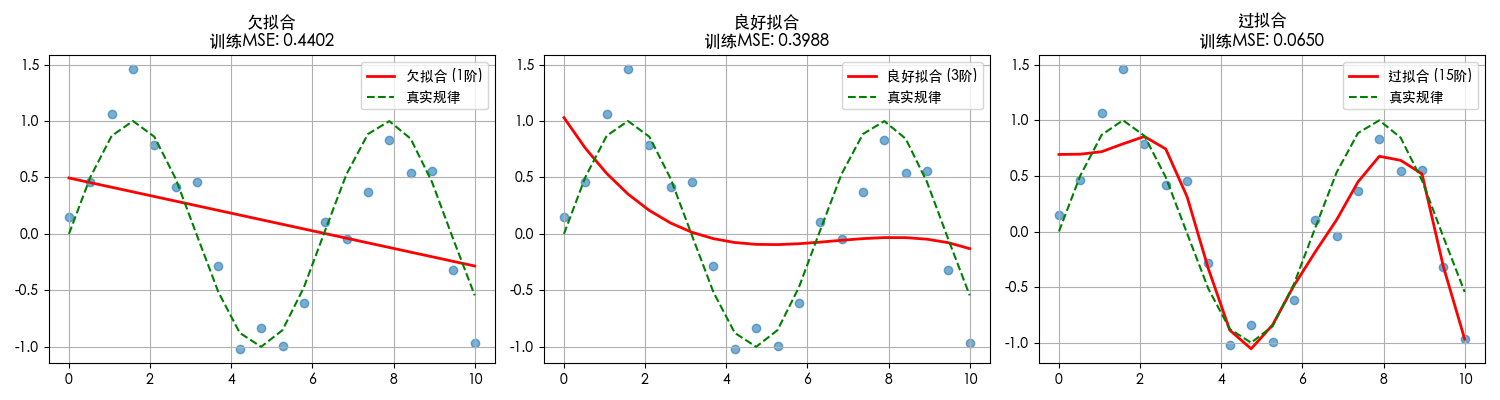
Ajuste adecuado (centro)
- : la curva roja sigue aproximadamente la tendencia de la regla real en verde.Sobreajuste (derecha)
- : la curva roja fluctúa violentamente, intentando pasar por cada punto azul, incluidos los puntos de ruido, perdiendo por completo la forma suave de la curva sinusoidal.II. Fundamento teórico: descomposición de sesgo y varianza
- El sesgo y la varianza proporcionan un marco teórico para comprender el sobreajuste y el subajuste. Describen dos fuentes diferentes de error del modelo.Podemos descomponer el
II. Fundamento teórico: descomposición de sesgo y varianza
en:
sesgo² + varianza + error irreducible1. SesgoDefinición: la diferencia entre el。
1. Sesgo
- (es decir, la predicción media) y el valor real. Refleja elerror sistemático, es decir, si la suposición del modelo sobre la naturaleza del problema es incorrecta.Manifestaciones de un sesgo altoerror sistemático, es decir, si las suposiciones del modelo sobre la naturaleza del problema son erróneas.
- Manifestaciones de alto sesgo: El modelo es demasiado simple, no puede capturar las características de los datos, lo que lleva asubajuste. No importa con qué datos se entrene, el resultado se desvía del valor real.
- Ejemplo: Siempre usar el modelo lineal simple "precio = área × 1000" para predecir diferentes casas, ignorando factores importantes como la ubicación o el piso; esto es un sesgo alto.
2. Varianza
- Definición: el rango de fluctuaciónde los propios valores predichos por el modelo.. Refleja la sensibilidad del modeloal ruido aleatorioen los datos de entrenamiento.
- Manifestación de alta varianza: el modelo es demasiado complejo y reacciona excesivamente a pequeñas variaciones en los datos de entrenamiento (incluido el ruido), lo que lleva asobreajuste. Si se entrena con otro conjunto de datos, el modelo resultante puede ser completamente diferente.
- Ejemplo: una red neuronal profunda, sin restricciones, puede generar un conjunto de reglas de predicción completamente diferente y extremadamente complejo para cada conjunto de datos de entrenamiento único; esto es alta varianza.
3. Compensación sesgo-varianza
Este es un equilibrio central en el aprendizaje automático.No podemos minimizar el sesgo y la varianza al mismo tiempo.
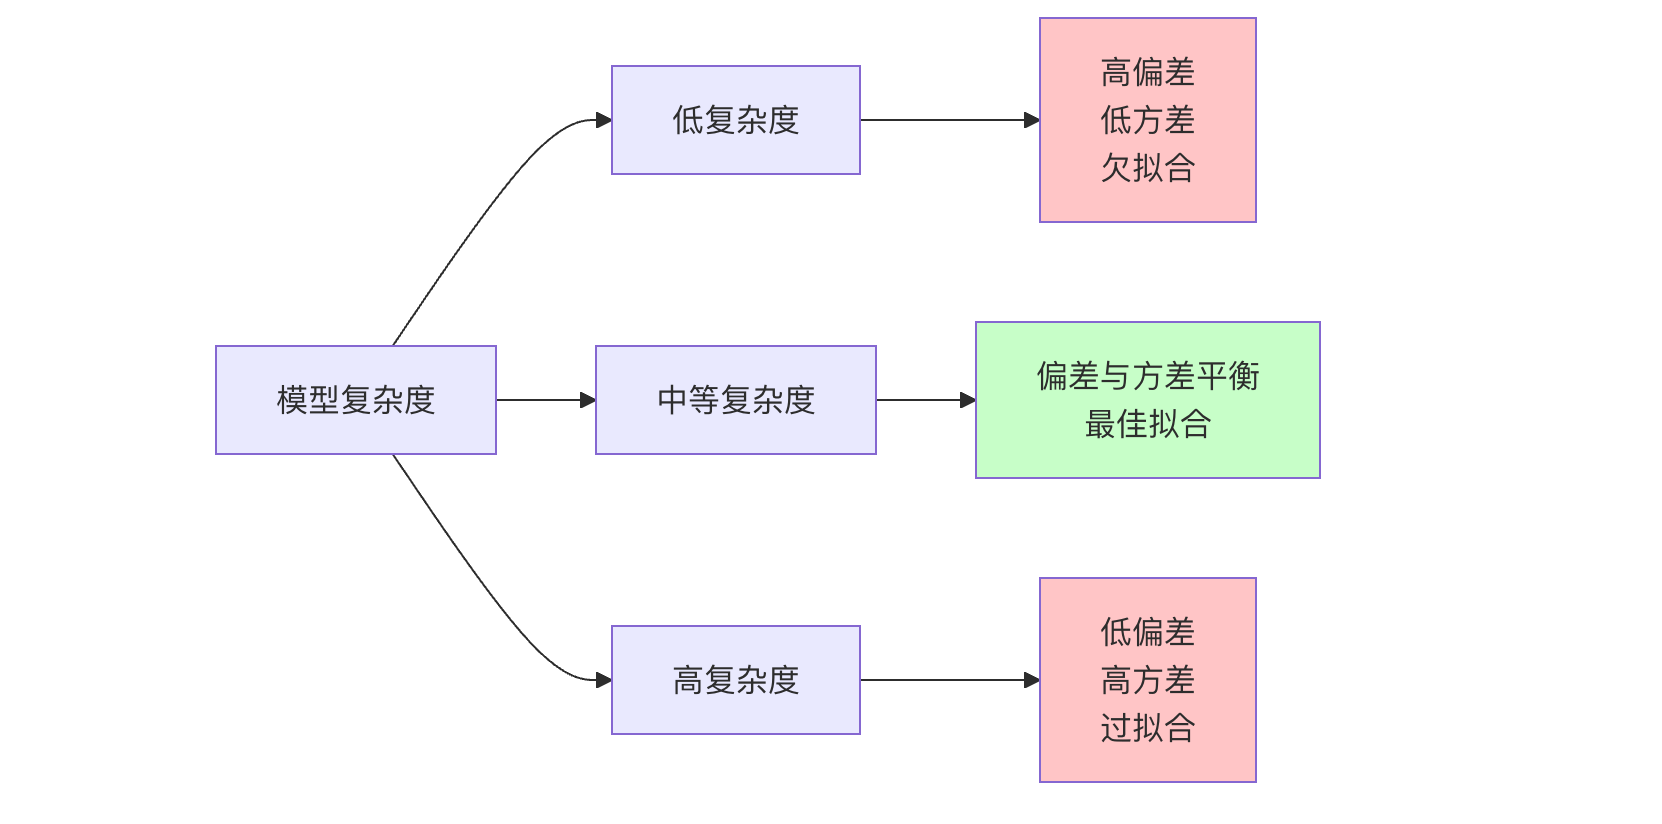
- Aumentar la complejidad del modelo: normalmente puedereducir el sesgo(el modelo se vuelve más capaz), peroaumentar la varianza(es más fácil aprender ruido).
- Reducir la complejidad del modelo: normalmente puedereducir la varianza(el modelo es más estable), peroaumentar el sesgo(el modelo se vuelve menos capaz).
Nuestro objetivo es encontrar el "punto óptimo" en el gráfico para minimizar el error total.
III. Diagnóstico y estrategias de solución
¿Cómo determinar en qué estado se encuentra el modelo? ¿Cómo solucionarlo?
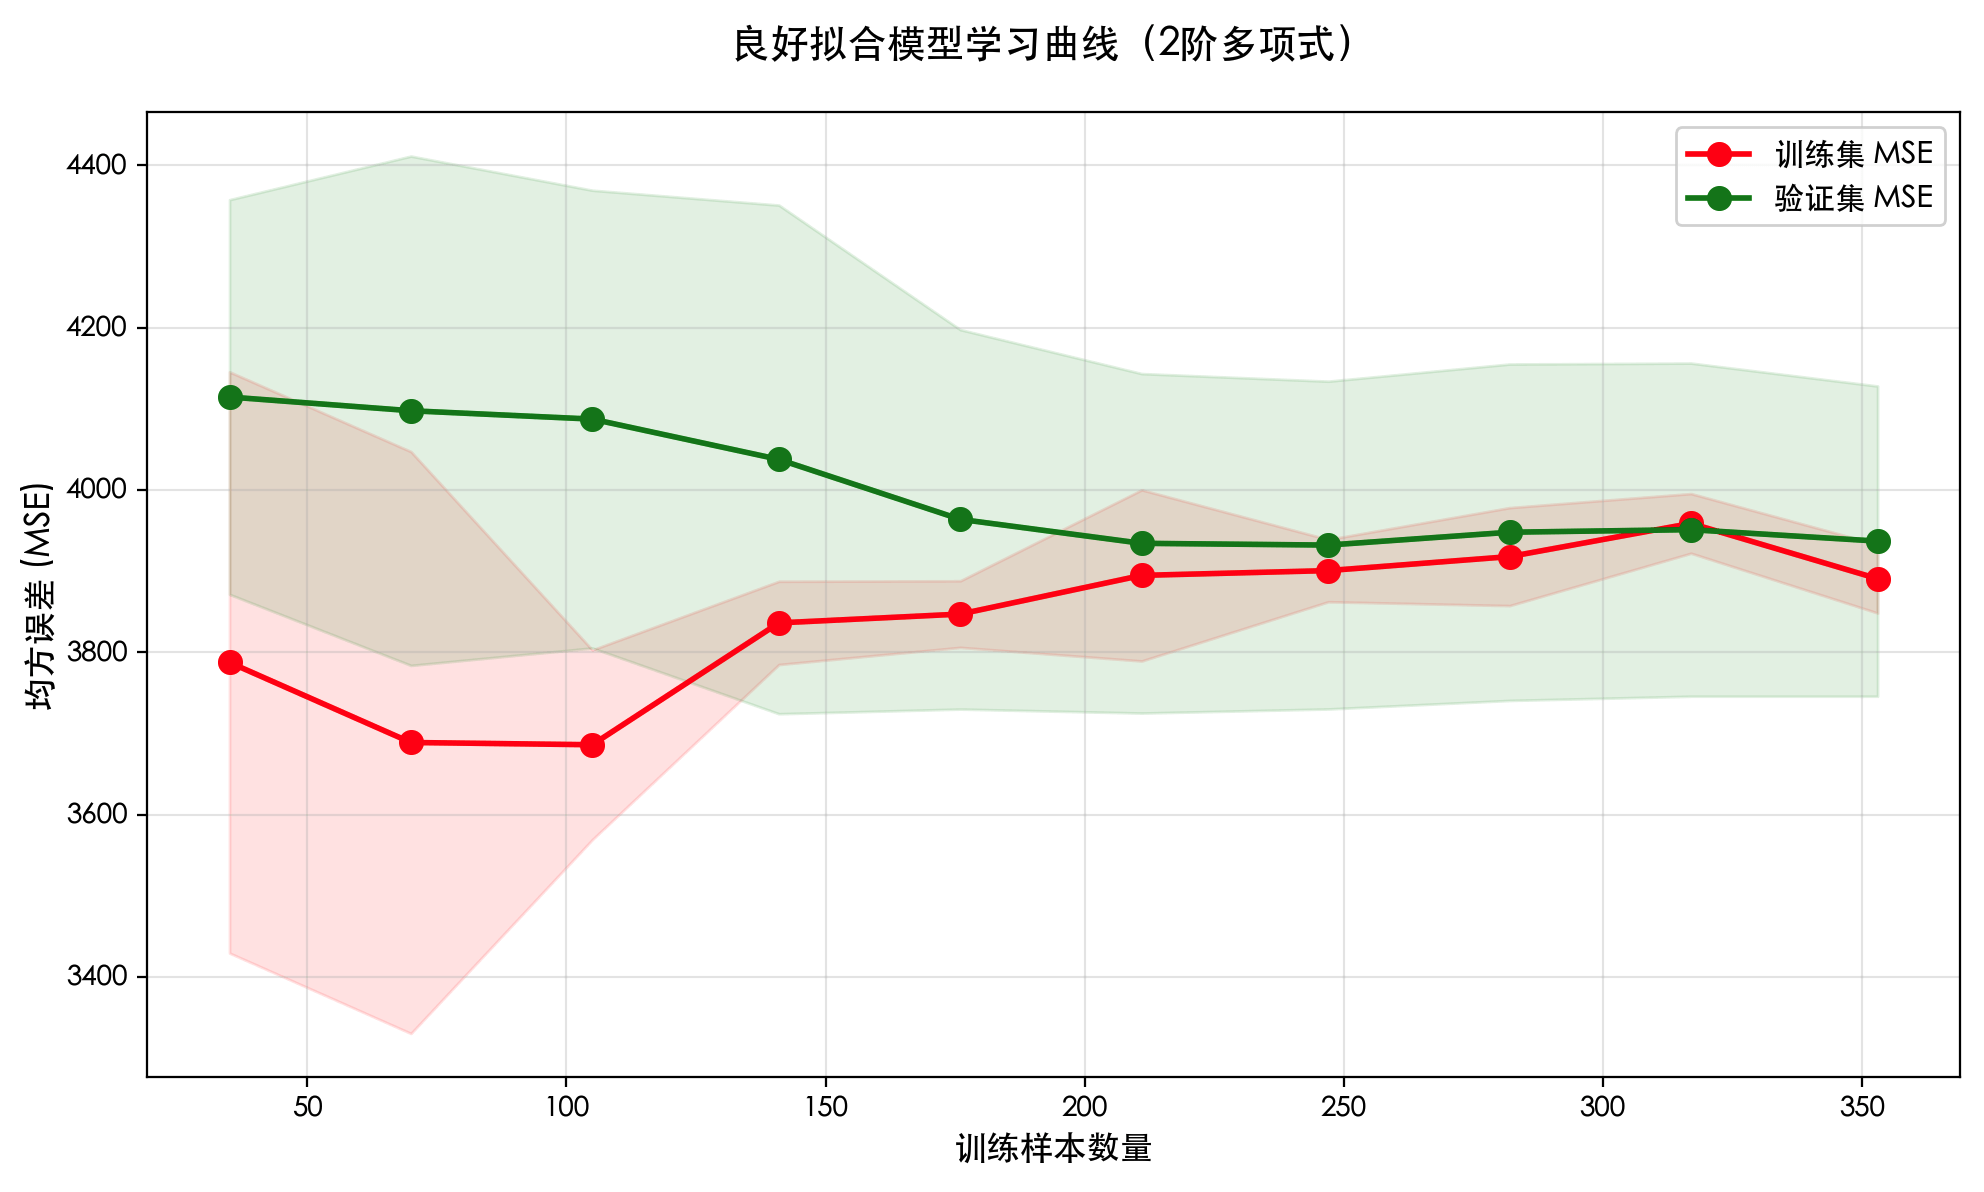
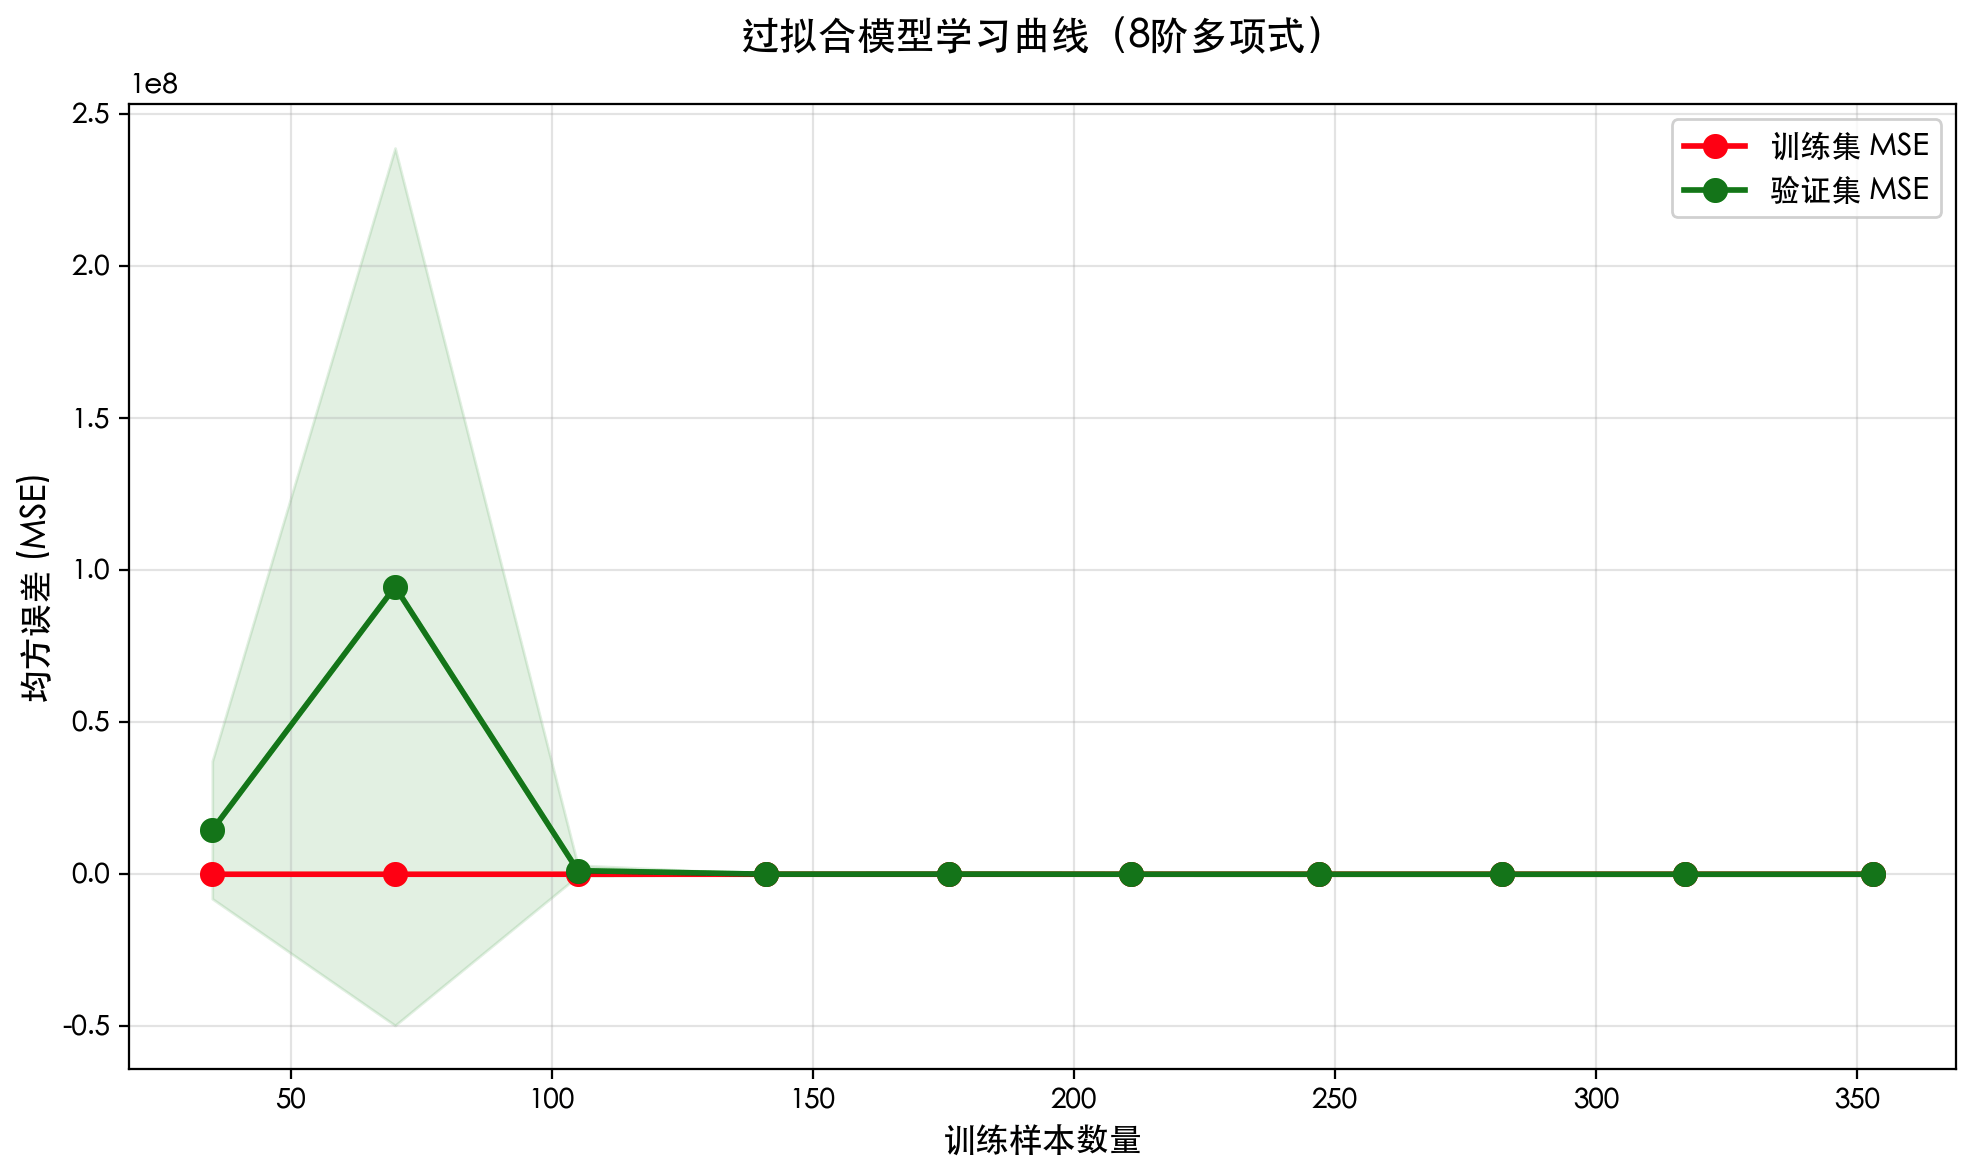
1. Método de diagnóstico: curva de aprendizaje
La curva de aprendizaje traza el rendimiento del modelo enel conjunto de entrenamientoyel conjunto de validación(como el error) a medida queel número de muestras de entrenamientoola complejidad del modelocambian.
Ejemplo
import matplotlib.pyplot as plt
from sklearn.datasets import load_diabetes
from sklearn.model_selection import train_test_split
from sklearn.model_selection import learning_curve
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.metrics import mean_squared_error
import warnings
warnings.filterwarnings('ignore')
# -------------------------- Configurar fuente china inicio --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows primero
'SimHei', 'Microsoft YaHei',
# macOS primero
'PingFang SC', 'Heiti TC',
# Linux primero
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corregir el problema de que el signo negativo se muestre como un cuadrado
plt.rcParams['axes.unicode_minus'] = False
# Configurar el estilo del gráfico
plt.rcParams['figure.figsize'] = (10, 6)
plt.rcParams['axes.grid'] = True
plt.rcParams['grid.alpha'] = 0.3
# -------------------------- Configurar fuente china fin --------------------------
# Cargar datos
data = load_diabetes()
X, y = data.data, data.target
# Usar solo una característica (más adecuado para la demostración de regresión polinómica)
X = X[:, np.newaxis, 2] # Seleccionar la tercera característica (BMI)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Definir la función de trazado de la curva de aprendizaje (versión optimizada)
def plot_learning_curve(estimator, title, X, y, cv=5, train_sizes=np.linspace(0.1, 1.0, 10)):
"""
Trazar la curva de aprendizaje
Parámetros:
estimator: estimador del modelo
title: título del gráfico
X: datos de características
y: variable objetivo
cv: número de pliegues de validación cruzada
train_sizes: proporción de muestras de entrenamiento
"""
# Obtener datos de la curva de aprendizaje
train_sizes_abs, train_scores, test_scores = learning_curve(
estimator, X, y, cv=cv, scoring='neg_mean_squared_error',
train_sizes=train_sizes, random_state=42, n_jobs=-1
)
# Calcular media y desviación estándar
train_scores_mean = -train_scores.mean(axis=1)
train_scores_std = train_scores.std(axis=1)
test_scores_mean = -test_scores.mean(axis=1)
test_scores_std = test_scores.std(axis=1)
# Trazar la curva de aprendizaje
plt.figure(figsize=(10, 6))
plt.fill_between(train_sizes_abs,
train_scores_mean - train_scores_std,
train_scores_mean + train_scores_std,
alpha=0.1, color='r')
plt.fill_between(train_sizes_abs,
test_scores_mean - test_scores_std,
test_scores_mean + test_scores_std,
alpha=0.1, color='g')
# Trazar la curva de la media
plt.plot(train_sizes_abs, train_scores_mean, 'o-', color='r', linewidth=2,
markersize=8, label='MSE del conjunto de entrenamiento')
plt.plot(train_sizes_abs, test_scores_mean, 'o-', color='g', linewidth=2,
markersize=8, label='MSE del conjunto de validación')
# Configurar atributos del gráfico
plt.xlabel('Número de muestras de entrenamiento', fontsize=12)
plt.ylabel('Error cuadrático medio (MSE)', fontsize=12)
plt.title(title, fontsize=14, pad=20)
plt.legend(loc='upper right', fontsize=11)
plt.tight_layout()
plt.show()
# Imprimir el rendimiento del modelo en el conjunto de prueba
estimator.fit(X_train, y_train)
y_pred = estimator.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
print(f{title} - MSE del conjunto de prueba: {mse:.2f})
# 1. Modelo de subajuste (polinomio de grado 1 - regresión lineal)
print("="*60)
print(Modelo de subajuste (polinomio de grado 1 - regresión lineal))
print("="*60)
plot_learning_curve(
make_pipeline(StandardScaler(), PolynomialFeatures(1), LinearRegression()),
'Curva de aprendizaje del modelo de subajuste (polinomio de grado 1)',
X, y
)
# 2. Modelo de buen ajuste (polinomio de grado 2)
print("\n" + "="*60)
print(Modelo de buen ajuste (polinomio de grado 2))
print("="*60)
plot_learning_curve(
make_pipeline(StandardScaler(), PolynomialFeatures(2), LinearRegression()),
'Curva de aprendizaje del modelo de buen ajuste (polinomio de grado 2)',
X, y
)
# 3. Modelo de sobreajuste (polinomio de grado 8)
print("\n" + "="*60)
print(Modelo de sobreajuste (polinomio de grado 8))
print("="*60)
plot_learning_curve(
make_pipeline(StandardScaler(), PolynomialFeatures(8), LinearRegression()),
'Curva de aprendizaje del modelo de sobreajuste (polinomio de grado 8)',
X, y
)
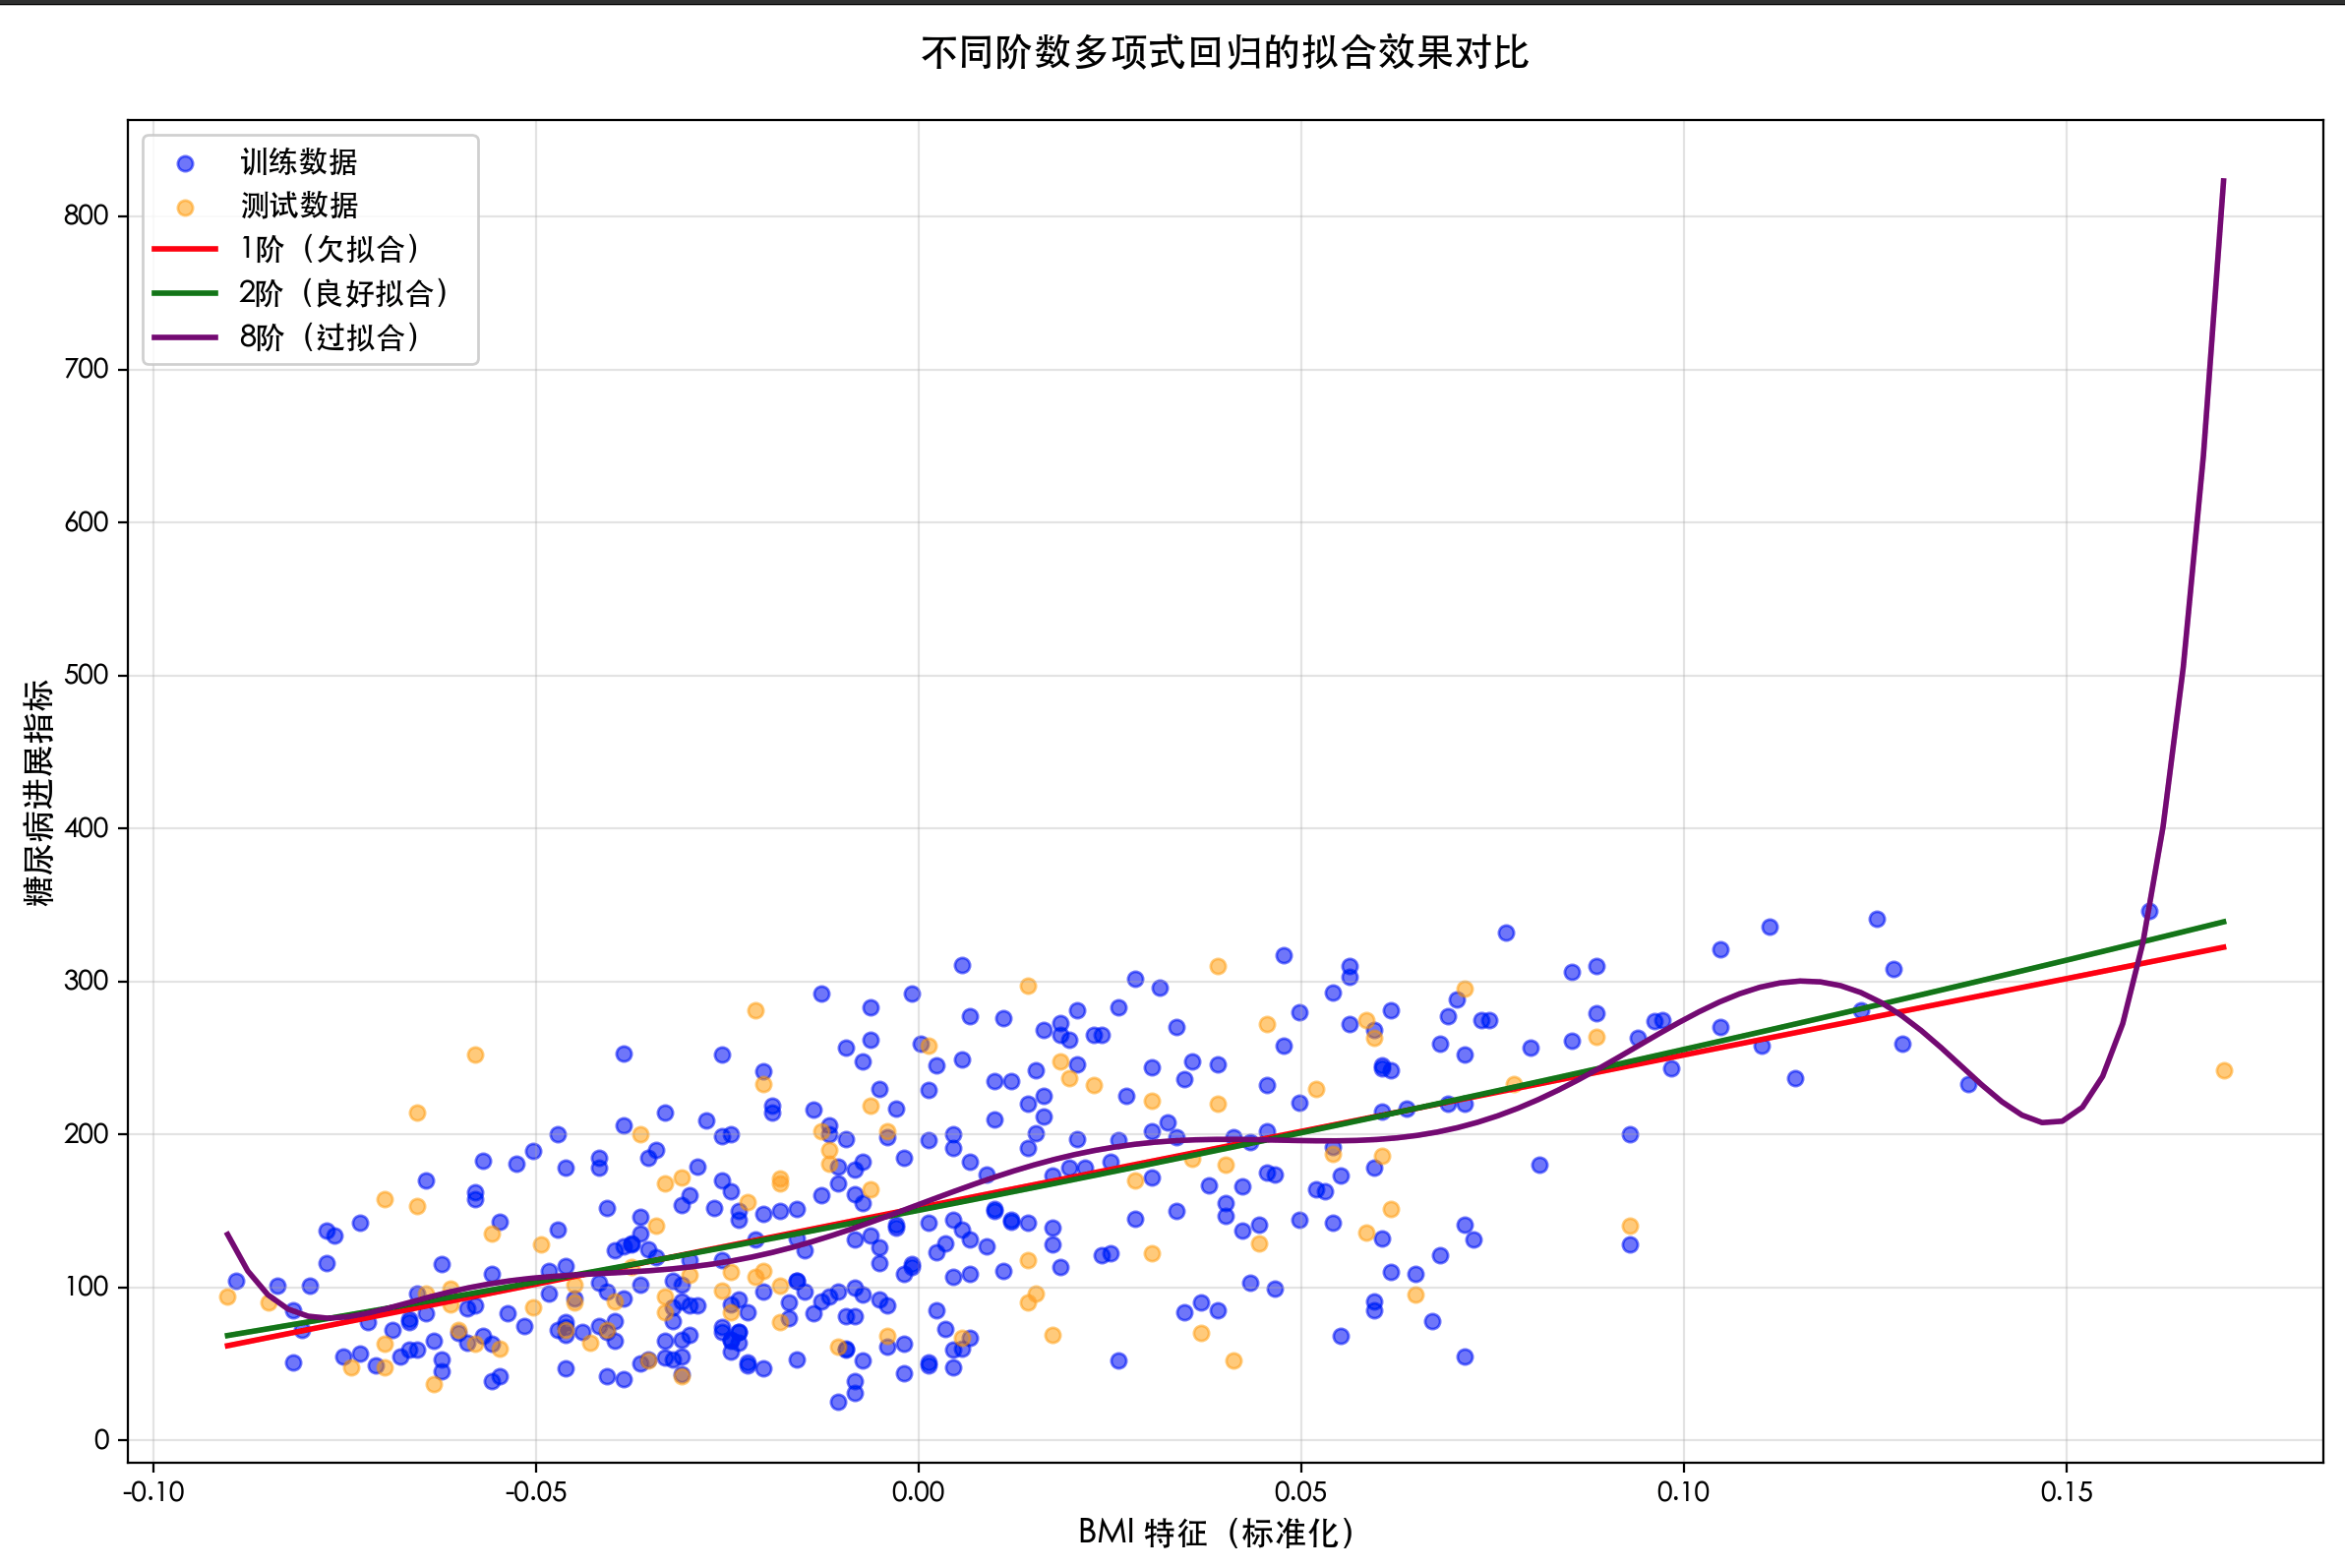
# Extra: visualizar el ajuste de modelos de diferentes grados
plt.figure(figsize=(12, 8))
X_plot = np.linspace(X.min(), X.max(), 100).reshape(-1, 1)
# Trazar los puntos de datos originales
plt.scatter(X_train, y_train, alpha=0.5, label='Datos de entrenamiento', color='blue', s=30)
plt.scatter(X_test, y_test, alpha=0.5, label='Datos de prueba', color='orange', s=30)
# Trazar las curvas de ajuste de diferentes grados
orders = [1, 2, 8]
colors = ['red', 'green', 'purple']
labels = ['Grado 1 (subajuste)', 'Grado 2 (buen ajuste)', 'Grado 8 (sobreajuste)']
for i, order in enumerate(orders):
model = make_pipeline(StandardScaler(), PolynomialFeatures(order), LinearRegression())
model.fit(X_train, y_train)
y_plot = model.predict(X_plot)
plt.plot(X_plot, y_plot, color=colors[i], linewidth=2, label=labels[i])
plt.xlabel('Característica BMI (estandarizada)', fontsize=12)
plt.ylabel('Indicador de progresión de la diabetes', fontsize=12)
plt.title('Comparación del ajuste de la regresión polinómica de diferentes grados', fontsize=14, pad=20)
plt.legend(fontsize=11)
plt.tight_layout()
plt.show()
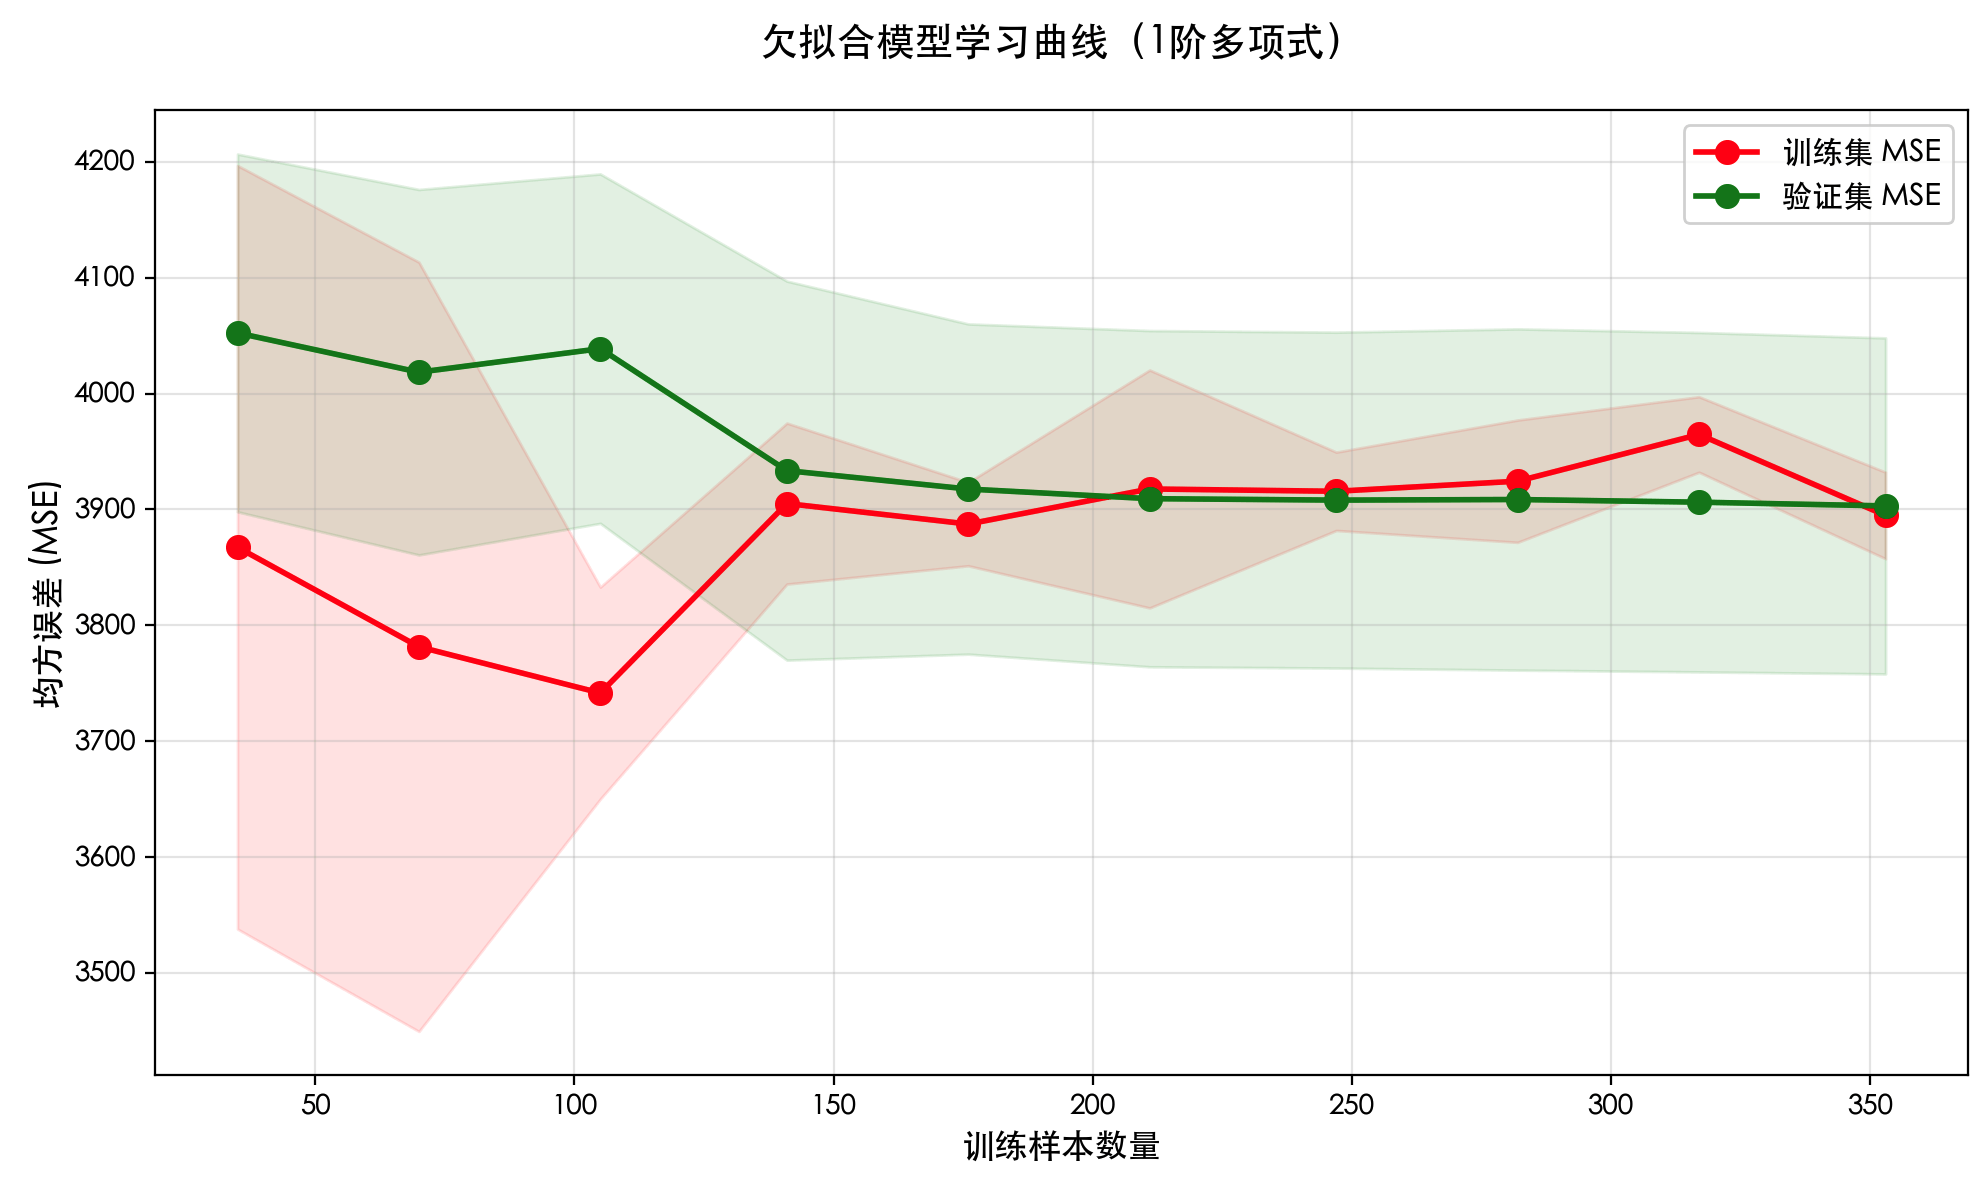
¿Cómo interpretar la curva de aprendizaje?
| Estado de ajuste | Error de entrenamiento | Error de validación | Características de la curva |
|---|---|---|---|
| Subajuste | Alto | Alto | Ambas curvas son altas y están muy cerca; agregar datos no ayuda. |
| Buen ajuste | bajo | bajo | Ambas curvas son bajas y están cerca entre sí, alcanzando un punto de equilibrio. |
| Sobreajuste | Muy bajo | Alto | El error de entrenamiento es muy bajo, pero el error de validación es alto, con una brecha clara en el medio. Agregar datos generalmente acerca ambas curvas. |
2. Estrategias de solución
Según el diagnóstico, podemos adoptar diferentes estrategias:
Resolver el subajuste (sesgo alto):
- Aumentar la complejidad del modelo: usar un modelo más potente (por ejemplo, cambiar de un modelo lineal a un modelo de árbol o red neuronal).
- Agregar más características: extraer o construir características más significativas.
- Reducir la regularización: si se usa regularización (como L1, L2), intentar reducir su intensidad.
- Extender el tiempo de entrenamiento: para modelos iterativos (como redes neuronales), entrenar más épocas.
Resolver el sobreajuste (varianza alta):
- Obtener más datos de entrenamiento: uno de los métodos más efectivos.
- Reducir la complejidad del modelo: elegir un modelo más simple (por ejemplo, reducir el grado del polinomio, la profundidad del árbol o el número de capas de la red neuronal).
- Selección de características: eliminar características irrelevantes o redundantes.
- Aumentar la regularización:
- Regularización L1 (Lasso): tiende a producir pesos dispersos, útil para la selección de características.
- Regularización L2 (Ridge): hace que los pesos decaigan, tendiendo a que todos los pesos sean pequeños.
- Dropout(para redes neuronales): durante el entrenamiento, "descarta" aleatoriamente una parte de las neuronas.
- Parada temprana(para modelos iterativos): detener el entrenamiento cuando el error del conjunto de validación deja de disminuir.
IV. Práctica: experimentar con un conjunto de datos real
Practiquemos con el clásico conjunto de datos de precios de Boston (o el conjunto de datos de diabetes, porque el de Boston está obsoleto).
Ejemplo
import matplotlib.pyplot as plt
from sklearn.datasets import load_diabetes
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_squared_error
# -------------------------- Configurar fuente china inicio --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows primero
'SimHei', 'Microsoft YaHei',
# macOS primero
'PingFang SC', 'Heiti TC',
# Linux primero
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corregir el problema de que el signo negativo se muestre como un cuadrado
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Configurar fuente china fin --------------------------
# Cargar datos
data = load_diabetes()
X, y = data.data, data.target
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Probar árboles de decisión de diferente complejidad
max_depths = [1, 3, 10, None] # None significa que no hay límite de profundidad; el árbol crece hasta que sea "puro".
train_errors = []
test_errors = []
for depth in max_depths:
model = DecisionTreeRegressor(max_depth=depth, random_state=42)
model.fit(X_train, y_train)
y_train_pred = model.predict(X_train)
y_test_pred = model.predict(X_test)
train_error = mean_squared_error(y_train, y_train_pred)
test_error = mean_squared_error(y_test, y_test_pred)
train_errors.append(train_error)
test_errors.append(test_error)
print(f"Profundidad máxima del árbol: {depth if depth is not None else 'Sin límite'}")
print(f" MSE del conjunto de entrenamiento: {train_error:.2f}")
print(f" MSE del conjunto de prueba: {test_error:.2f}")
print("-" * 30)
# Visualización
plt.figure(figsize=(10, 6))
depths = [str(d) if d else 'Sin límite' for d in max_depths]
x_index = np.arange(len(depths))
width = 0.35
plt.bar(x_index - width/2, train_errors, width, label='Error de entrenamiento', color='skyblue')
plt.bar(x_index + width/2, test_errors, width, label='Error de prueba', color='lightcoral')
plt.xlabel('Profundidad máxima del árbol de decisión (complejidad del modelo)')
plt.ylabel('Error cuadrático medio (MSE)')
plt.title('Equilibrio sesgo-varianza: rendimiento de árboles de decisión con diferente complejidad')
plt.xticks(x_index, depths)
plt.legend()
plt.grid(True, axis='y')
plt.tight_layout()
plt.show()
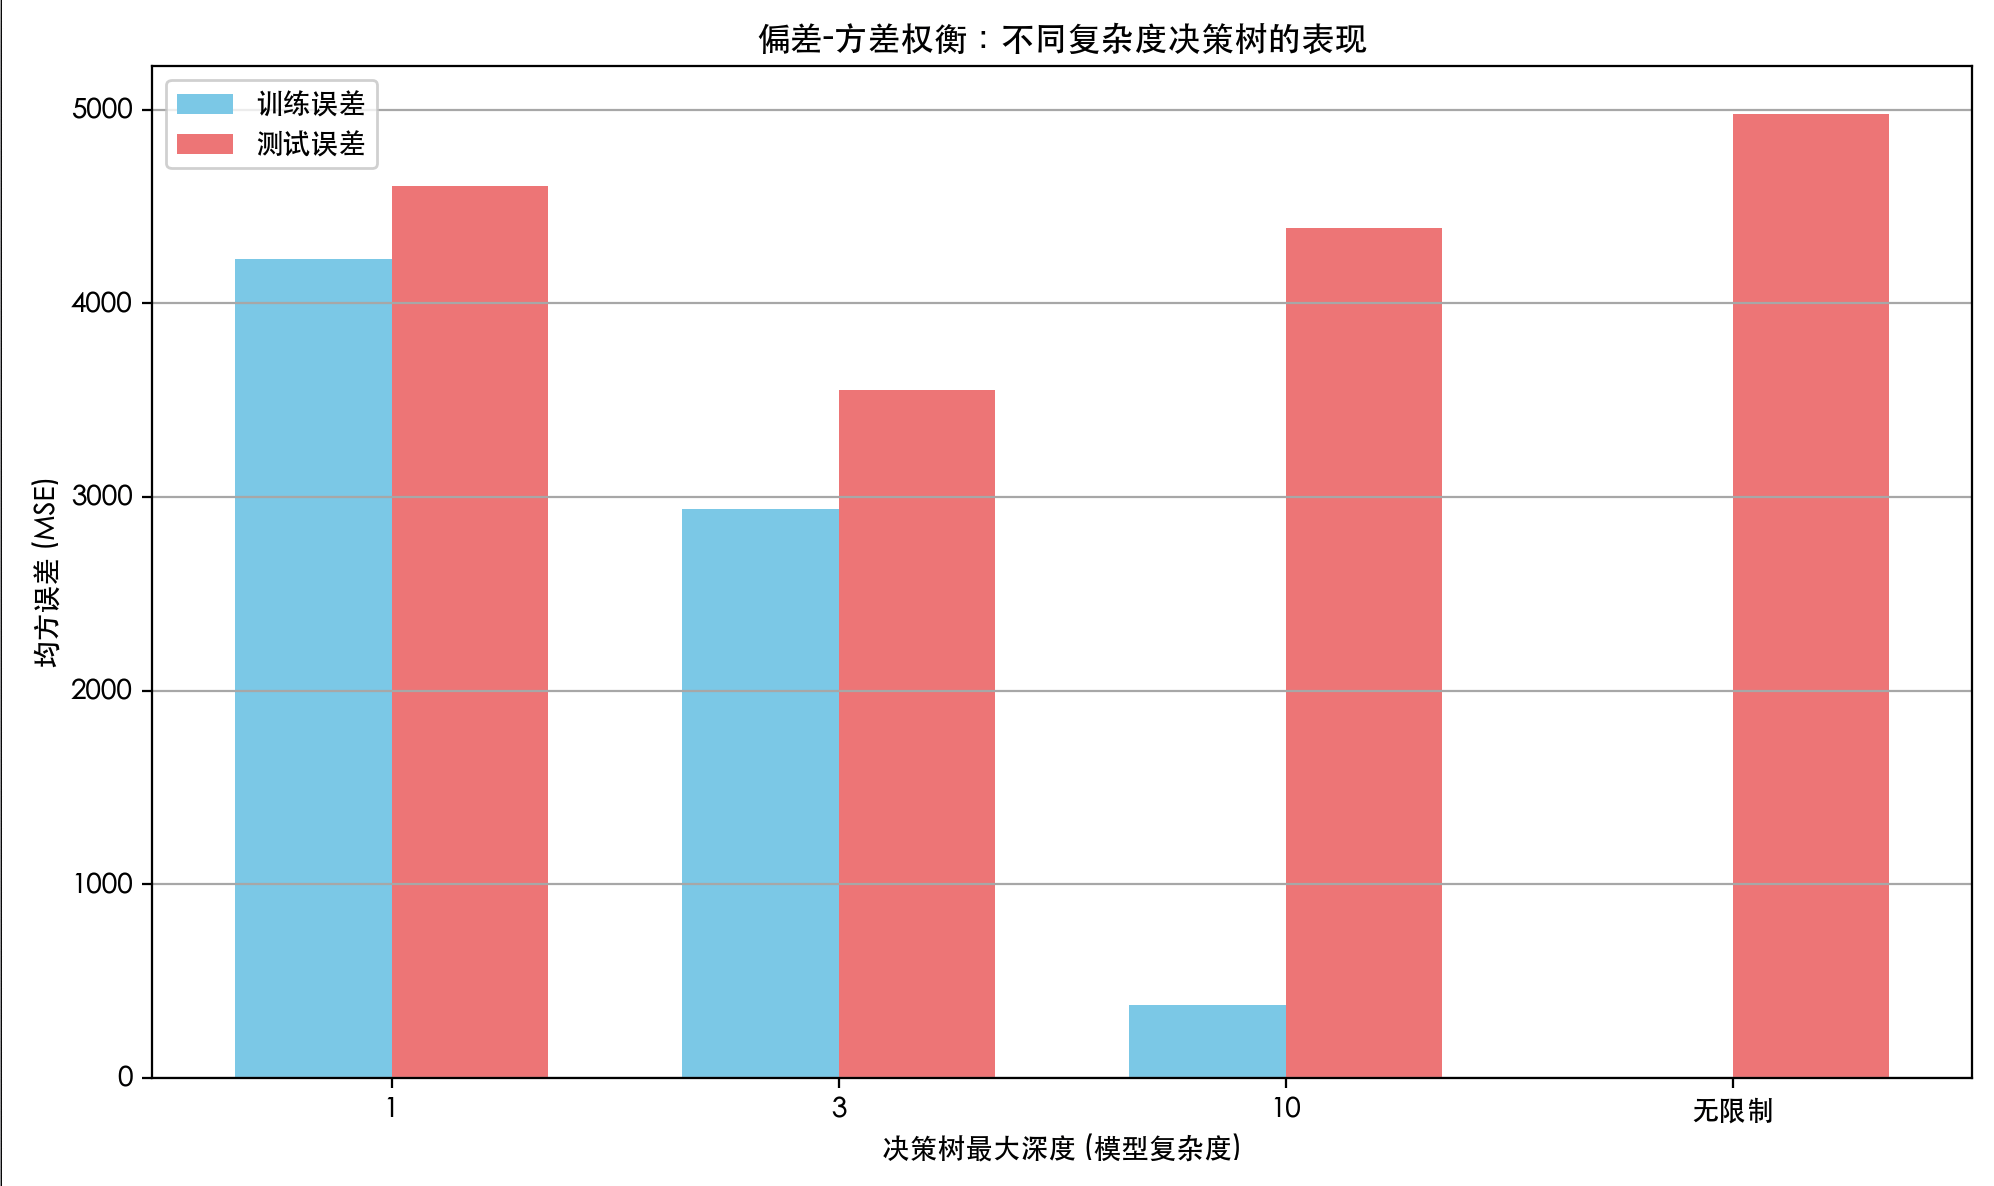
Resultados del análisis:
- Profundidad=1: el modelo es muy simple, el error de entrenamiento y de prueba son altos ->Sesgo alto, subajuste。
- Profundidad=3: A medida que aumenta la complejidad del modelo, ambos errores disminuyen significativamente y están relativamente cerca.Equilibrio entre sesgo y varianza, buen ajuste.。
- Profundidad=10 o sin límite.: Modelo muy complejo, error de entrenamiento extremadamente bajo, pero el error de prueba comienza a aumentar (o es mucho mayor que el error de entrenamiento).Alta varianza, sobreajuste.。
Resumen
Comprender el sobreajuste, el subajuste, el sesgo y la varianza es la base para construir excelentes modelos de aprendizaje automático. Recuerda este ciclo central:
- Entrenar el modelo. -> Evaluar su rendimiento en el conjunto de entrenamiento y en el conjunto de validación.。
- Diagnosticar problemas mediante curvas de aprendizaje o comparación de errores.: ¿Es alto sesgo (subajuste) o alta varianza (sobreajuste)?
- Aplicar la estrategia correspondiente.(Aumentar complejidad/datos, regularización, etc.) para mejorar.
- Volver al paso 1., hasta obtener un modelo satisfactorio y con buena capacidad de generalización en el conjunto de validación.