Surapprentissage, sous-apprentissage, biais et variance
Dans le monde de l'apprentissage automatique, construire un modèle revient à former un étudiant. Notre objectif est que cetétudiantpuisse non seulement mémoriser les exemples du manuel (données d'entraînement), mais aussi comprendre en profondeur les principes sous-jacents, afin d'obtenir de bons résultats sur des questions d'examen totalement inédites (données de test). Cependant, cetétudiantpeut rencontrer deux problèmes typiques au cours du processus d'apprentissage :
- L'un est un apprentissage trop rigide, se contentant d'appliquer mécaniquement les exemples (sous-apprentissage);
- L'autre est un apprentissage trop astucieux, mémorisant même la ponctuation et les caractéristiques d'écriture des exemples, de sorte qu'il est perdu face à de nouvelles questions (surapprentissage)。
Comprendrele surapprentissageetle sous-apprentissage, ainsi que les concepts théoriques plus profonds qui les sous-tendent—le biaisetla variance, est une étape clé pour tout praticien de l'apprentissage automatique, du débutant à la maîtrise. Ils expliquent pourquoi les modèles font des erreurs et nous montrent la direction pour améliorer le modèle.
I. Concepts clés : Performance du modèle et état d'« ajustement »
Tout d'abord, utilisons un exemple intuitif pour comprendre ce qu'estl'ajustement. Supposons que nous voulions utiliser un modèle mathématique pour ajuster un ensemble de points de données dispersés.
Exemple
import matplotlib.pyplot as plt
# -------------------------- Début de configuration de la police chinoise --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows en premier
'SimHei', 'Microsoft YaHei',
# macOS en premier
'PingFang SC', 'Heiti TC',
# Linux d'abord
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corriger le problème où les signes négatifs s'affichent sous forme de carrés
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de la configuration de la police chinoise --------------------------
# Générer des données simulées : ajouter un bruit aléatoire basé sur une courbe sinusoïdale
np.random.seed(42)
X = np.linspace(0, 10, 20)
y_true = np.sin(X) # Le véritable motif sous-jacent (que nous ne connaissons pas)
y_noise = np.random.randn(20) * 0.3 # Bruit aléatoire
y = y_true + y_noise # Les données que nous observons réellement
plt.scatter(X, y, label='Données observées (avec bruit)', color='blue', alpha=0.6)
plt.plot(X, y_true, label='Motif réel (y=sin(x))', color='green', linewidth=2)
plt.xlabel('X')
plt.ylabel('y')
plt.title('Données et motif sous-jacent')
plt.legend()
plt.grid(True)
plt.show()
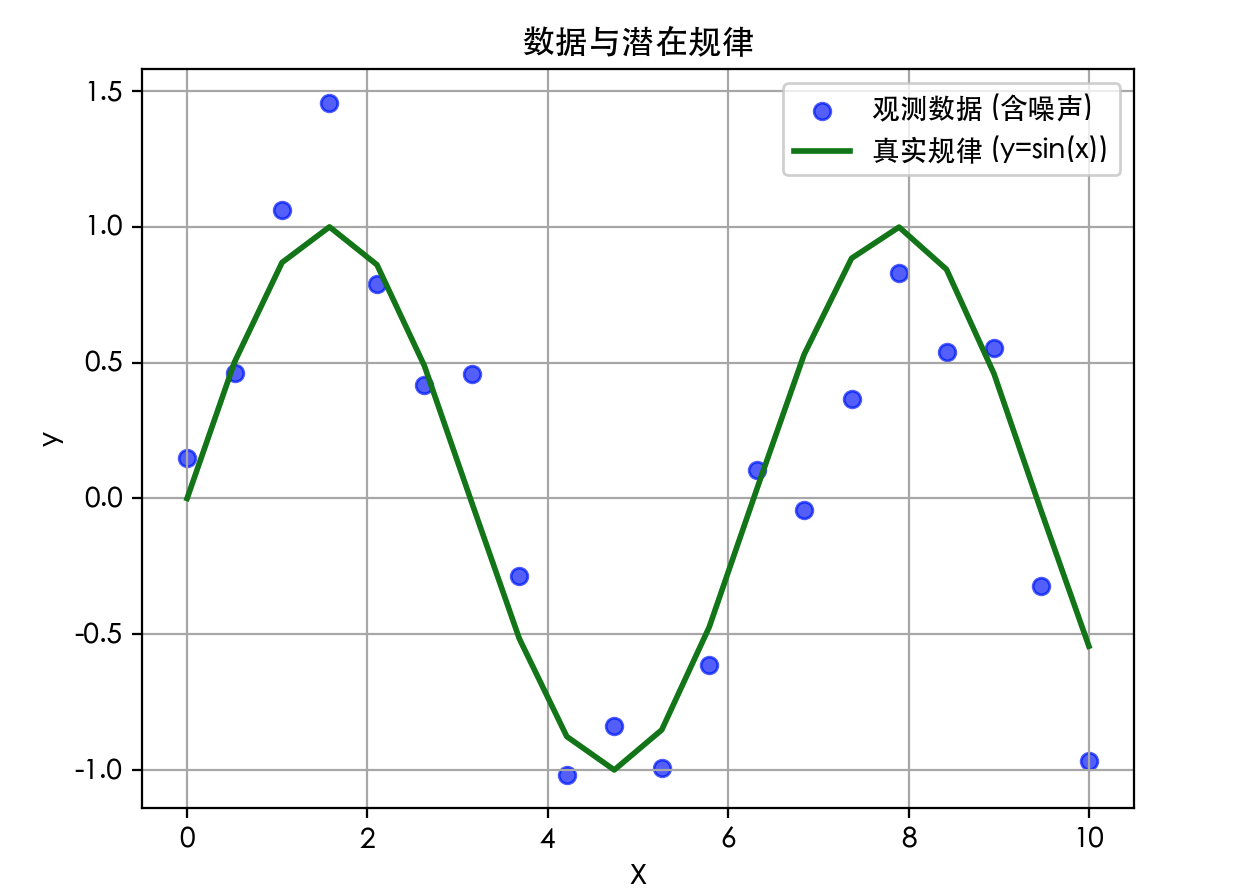
Notre objectif est de trouver une courbe (modèle) qui décrit le mieux le motif reflété par ces points bleus dispersés (données).
Le degré auquel le modèle décrit les données estl'ajustement。
1. Sous-apprentissage
Le sous-apprentissagedésigne un modèle trop simple pour capturer les motifs ou structures de base des données. C'est comme un élève qui n'a appris que l'addition mais à qui on demande de résoudre des problèmes d'analyse.
- Comportement: Le modèle est très peu performant surles données d'entraînement(par ex., faible précision, erreur élevée).
- Causes: La complexité du modèle est trop faible, les caractéristiques sont insuffisantes ou l'entraînement est inadéquat.
- Analogie: Utiliser une droite (polynôme de degré 1) pour ajuster des données présentant une tendance courbe évidente.
Exemple
from sklearn.preprocessing import PolynomialFeatures
from sklearn.metrics import mean_squared_error
# Essayez d'ajuster avec un polynôme de degré 1 (une droite)
poly = PolynomialFeatures(degree=1)
X_poly1 = poly.fit_transform(X.reshape(-1, 1))
model_under = LinearRegression()
model_under.fit(X_poly1, y)
y_pred_under = model_under.predict(X_poly1)
mse_train_under = mean_squared_error(y, y_pred_under)
print(f"Erreur quadratique moyenne (MSE) du modèle en sous-apprentissage sur l'ensemble d'entraînement : {mse_train_under:.4f}")
Sortie :
欠拟合模型在训练集上的均方误差 (MSE): 0.4402
欠拟合模型在训练集上的均方误差 (MSE): 0.4402
2. Ajustement idéal
C'est l'état idéal. Le modèle est suffisamment complexe pour apprendre les motifs clés des données, mais pas trop complexe au point d'apprendre le bruit aléatoire. Il obtient de bonnes performances à la fois sur l'ensemble d'entraînement et sur des ensembles de test non vus.
- Comportement: Les erreurs sur l'ensemble d'entraînement et sur l'ensemble de test sont faibles, et les deux sont proches.
- Analogie: Utiliser un polynôme de degré approprié (par exemple, degré 3) pour ajuster les données.
Exemple
poly = PolynomialFeatures(degree=3)
X_poly3 = poly.fit_transform(X.reshape(-1, 1))
model_good = LinearRegression()
model_good.fit(X_poly3, y)
y_pred_good = model_good.predict(X_poly3)
mse_train_good = mean_squared_error(y, y_pred_good)
print(f"Erreur quadratique moyenne (MSE) du modèle bien ajusté sur l'ensemble d'entraînement : {mse_train_good:.4f}")
Sortie :
欠拟合模型在训练集上的均方误差 (MSE): 0.4402
良好拟合模型在训练集上的均方误差 (MSE): 0.3988
3. Surapprentissage
Surapprentissagedésigne un modèle trop complexe, qui apprend non seulement les motifs réels présents dans les données, mais aussi à « mémoriser » le bruit aléatoire et les valeurs aberrantes des données d'entraînement.
- Comportement: Le modèle fonctionne extrêmement bien surles données d'entraînement(avec une très petite erreur), mais surde nouvelles données inéditesses performances chutent fortement, ce qui montre une faible capacité de généralisation.
- Causes: La complexité du modèle est trop élevée et la quantité de données d'entraînement est trop faible.
- Analogie: Utiliser un polynôme de très haut degré (par exemple, de degré 15) pour ajuster les données, ce qui fait que la courbe passe par presque chaque point de données et devient extrêmement déformée.
Exemple
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures
from sklearn.metrics import mean_squared_error
# -------------------------- Début de configuration de la police chinoise --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows en premier
'SimHei', 'Microsoft YaHei',
# macOS en premier
'PingFang SC', 'Heiti TC',
# Linux d'abord
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corriger le problème où les signes négatifs s'affichent sous forme de carrés
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de la configuration de la police chinoise --------------------------
# Générer des données simulées : ajouter un bruit aléatoire basé sur une courbe sinusoïdale
np.random.seed(42)
X = np.linspace(0, 10, 20)
y_true = np.sin(X) # Le véritable motif sous-jacent (que nous ne connaissons pas)
y_noise = np.random.randn(20) * 0.3 # Bruit aléatoire
y = y_true + y_noise # Les données que nous observons réellement
# Essayez d'ajuster avec un polynôme de degré 1 (une droite)
poly = PolynomialFeatures(degree=1)
X_poly1 = poly.fit_transform(X.reshape(-1, 1))
model_under = LinearRegression()
model_under.fit(X_poly1, y)
y_pred_under = model_under.predict(X_poly1)
mse_train_under = mean_squared_error(y, y_pred_under)
print(f"Erreur quadratique moyenne (MSE) du modèle en sous-apprentissage sur l'ensemble d'entraînement : {mse_train_under:.4f}")
# Essayer d'ajuster avec un polynôme de degré 3
poly = PolynomialFeatures(degree=3)
X_poly3 = poly.fit_transform(X.reshape(-1, 1))
model_good = LinearRegression()
model_good.fit(X_poly3, y)
y_pred_good = model_good.predict(X_poly3)
mse_train_good = mean_squared_error(y, y_pred_good)
print(f"Erreur quadratique moyenne (MSE) du modèle bien ajusté sur l'ensemble d'entraînement : {mse_train_good:.4f}")
# Essayer d'ajuster avec un polynôme de degré 15 (extrêmement sujet au surapprentissage)
poly = PolynomialFeatures(degree=15)
X_poly15 = poly.fit_transform(X.reshape(-1, 1))
model_over = LinearRegression()
model_over.fit(X_poly15, y)
y_pred_over = model_over.predict(X_poly15)
mse_train_over = mean_squared_error(y, y_pred_over)
print(f"Erreur quadratique moyenne (MSE) du modèle en surapprentissage sur l'ensemble d'entraînement : {mse_train_over:.4f}")
# Visualiser les trois états d'ajustement
plt.figure(figsize=(15, 4))
# Sous-apprentissage
plt.subplot(1, 3, 1)
plt.scatter(X, y, alpha=0.6)
plt.plot(X, y_pred_under, color='red', linewidth=2, label='Sous-apprentissage (1er degré)')
plt.plot(X, y_true, color='green', linestyle='--', label='Motif réel')
plt.title(f'Sous-apprentissage\nMSE d'entraînement : {mse_train_under:.4f}')
plt.legend()
plt.grid(True)
# Bon ajustement
plt.subplot(1, 3, 2)
plt.scatter(X, y, alpha=0.6)
plt.plot(X, y_pred_good, color='red', linewidth=2, label='Bon ajustement (3e degré)')
plt.plot(X, y_true, color='green', linestyle='--', label='Motif réel')
plt.title(f'Bon ajustement\nMSE d'entraînement : {mse_train_good:.4f}')
plt.legend()
plt.grid(True)
# Surapprentissage
plt.subplot(1, 3, 3)
plt.scatter(X, y, alpha=0.6)
plt.plot(X, y_pred_over, color='red', linewidth=2, label='Surapprentissage (degré 15)')
plt.plot(X, y_true, color='green', linestyle='--', label='Motif réel')
plt.title(f'Surapprentissage\nMSE d'entraînement : {mse_train_over:.4f}')
plt.legend()
plt.grid(True)
plt.tight_layout()
plt.show()
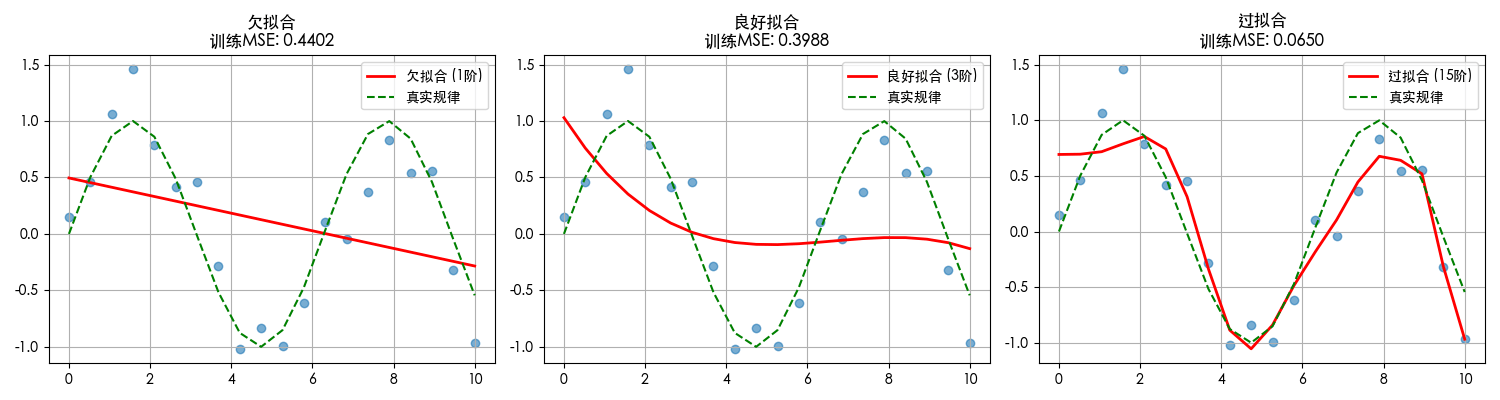
On peut clairement voir sur la figure :
- Sous-apprentissage (à gauche) :La ligne droite rouge ne parvient pas du tout à capturer la tendance fluctuante des données.
- Bon ajustement (au milieu) :La courbe rouge suit approximativement la tendance du motif réel vert.
- Surapprentissage (à droite) :La courbe rouge fluctue violemment, essayant de passer par chaque point dispersé bleu, y compris les points de bruit, perdant complètement la forme lisse de la courbe sinusoïdale.
II. Fondements théoriques : décomposition biais-variance
Le biais et la variance fournissent un cadre théorique pour comprendre le surapprentissage et le sous-apprentissage. Ils décrivent deux sources différentes d'erreur du modèle.
On peut décomposer l'erreur totaledu modèle en :Biais² + Variance + Erreur irréductible。
1. Biais
- Définition: La différence entre lavaleur attendue(c'est-à-dire la valeur prédite moyenne) et la valeur réelle. Elle reflète l'erreur systématiqueinhérente au modèle, c'est-à-dire si les hypothèses du modèle sur la nature du problème sont erronées.
- Comportement d'un biais élevé: Le modèle est trop simple pour capturer les caractéristiques des données, ce qui conduit à unsous-apprentissageQuelles que soient les données utilisées pour l'entraînement, les résultats s'écartent des valeurs réelles.
- Exemple: Toujours utiliser le modèle linéaire simple "prix de la maison = surface × 1000" pour prédire toutes sortes de maisons, en ignorant des facteurs importants tels que l'emplacement et l'étage, c'est un biais élevé.
2. Variance
- Définition: Laplage de fluctuationdes prédictions du modèle elles-mêmes. Elle reflète la sensibilité du modèle aubruit aléatoiredans les données d'entraînement.
- Symptômes d'une variance élevée: Le modèle est trop complexe et réagit de manière excessive aux petits changements (y compris le bruit) dans les données d'entraînement, ce qui conduit à unsurapprentissageL'entraînement sur un ensemble de données différent peut produire un modèle complètement différent.
- Exemple: Un réseau de neurones profond, s'il n'est contraint d'aucune manière, peut générer un ensemble de règles de prédiction complètement différent et extrêmement complexe pour chaque ensemble de données d'entraînement unique, c'est une variance élevée.
3. Compromis biais-variance
Il s'agit d'un compromis fondamental en apprentissage automatique.Nous ne pouvons pas minimiser simultanément le biais et la variance.
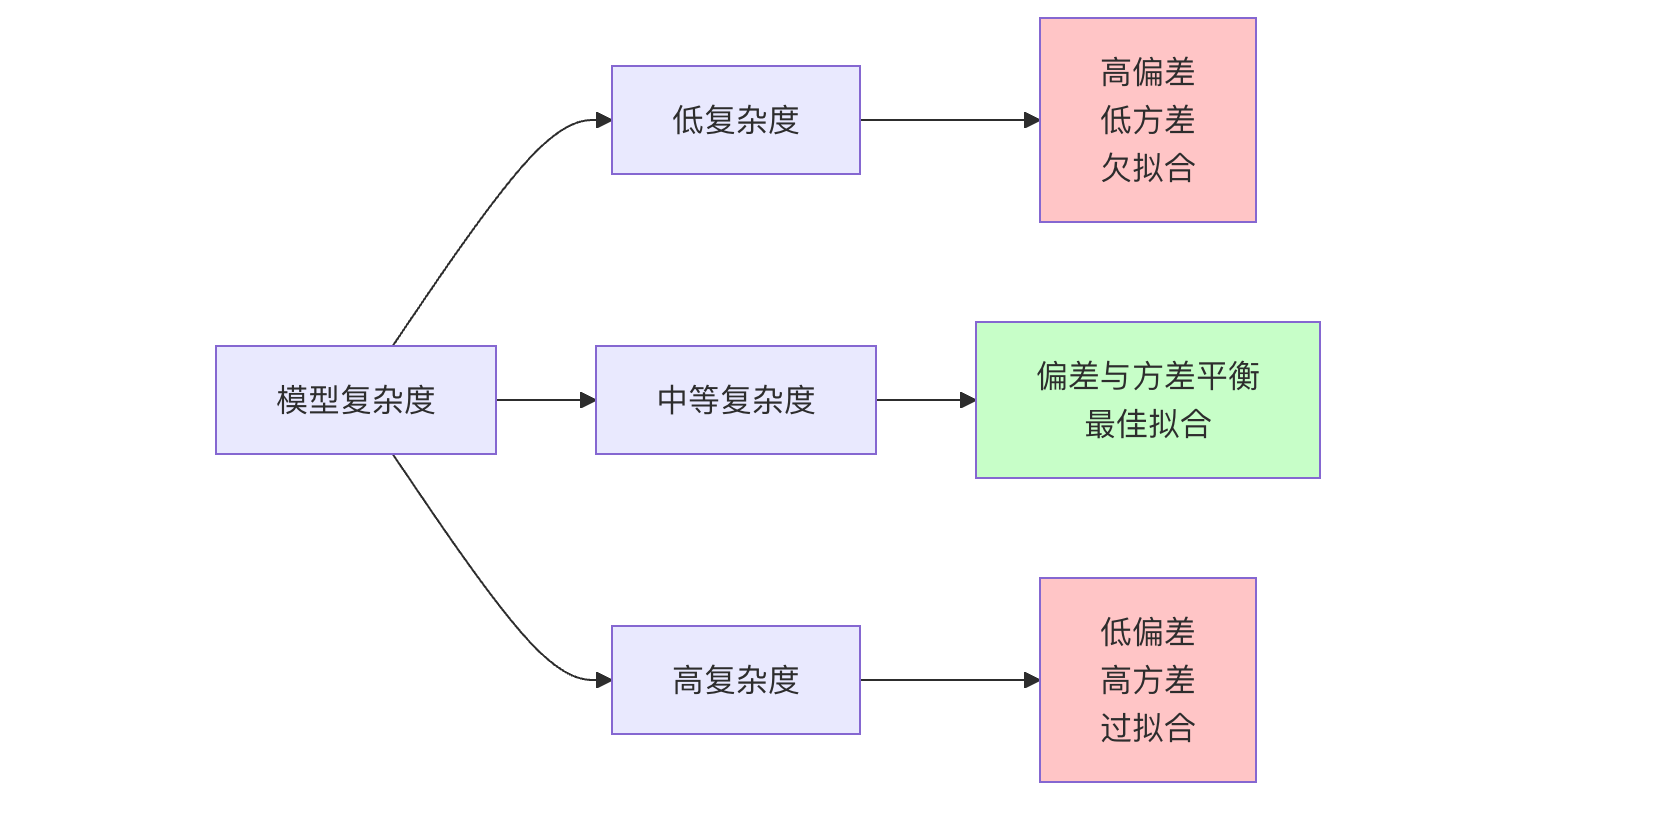
- Augmenter la complexité du modèle: réduit généralement lebiais(le modèle devient plus puissant), mais augmente lavariance(il apprend plus facilement le bruit).
- Réduire la complexité du modèle: réduit généralement lavariance(le modèle devient plus stable), mais augmente lebiais(le modèle devient plus faible).
Notre objectif est de trouver le « point idéal » dans la figure afin que l'erreur totale soit minimisée.
III. Diagnostic et contre-mesures
Comment pouvons-nous déterminer dans quel état se trouve le modèle ? Comment le résoudre ?
1. Méthode de diagnostic : courbes d'apprentissage
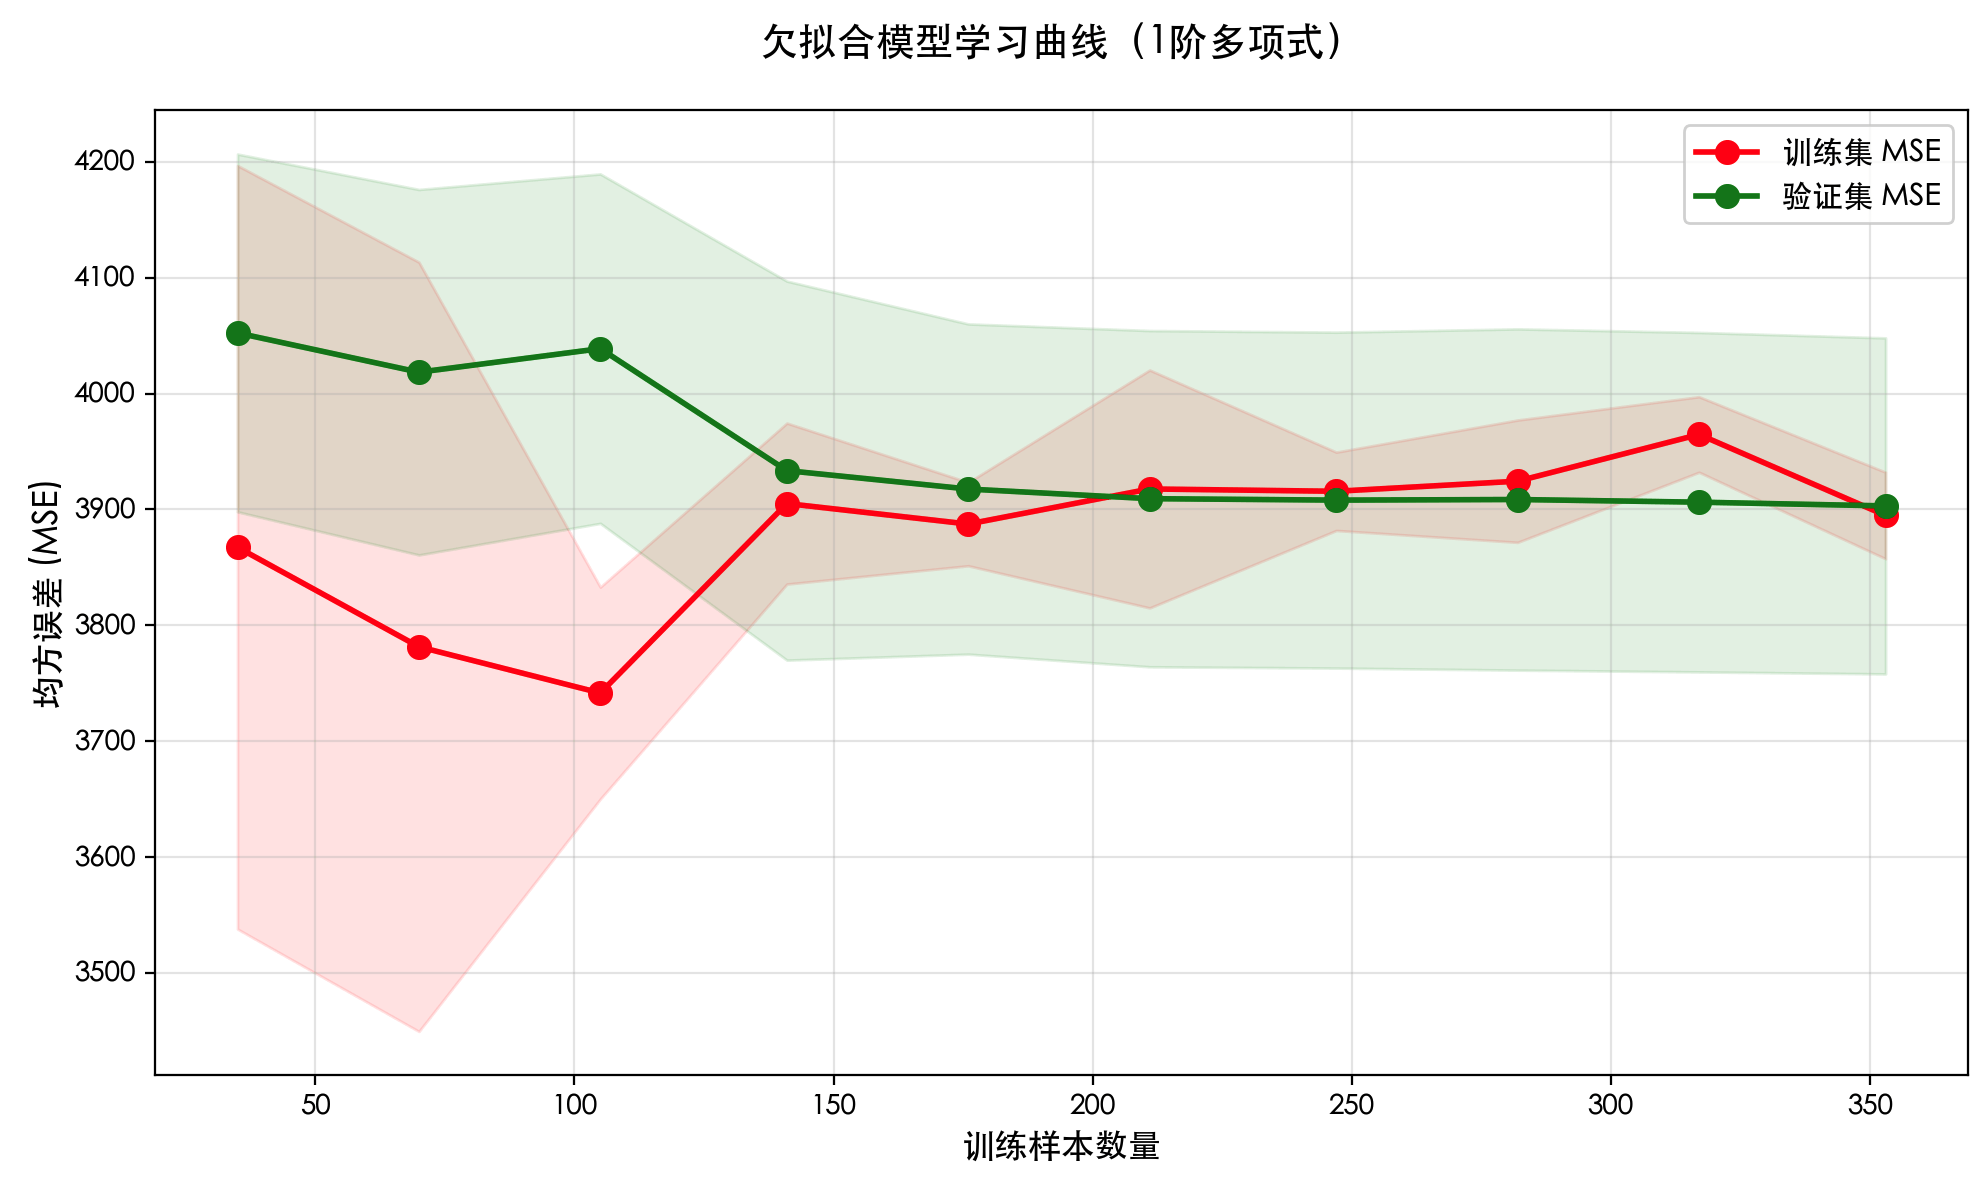
Une courbe d'apprentissage trace la performance du modèle (par exemple, l'erreur) sur l'ensemble d'entraînementet l'ensemble de validationen fonction dunombre d'échantillons d'entraînementoula complexité du modèle.
Exemple
import matplotlib.pyplot as plt
from sklearn.datasets import load_diabetes
from sklearn.model_selection import train_test_split
from sklearn.model_selection import learning_curve
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.metrics import mean_squared_error
import warnings
warnings.filterwarnings('ignore')
# -------------------------- Début de configuration de la police chinoise --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows en premier
'SimHei', 'Microsoft YaHei',
# macOS en premier
'PingFang SC', 'Heiti TC',
# Linux d'abord
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corriger le problème d'affichage des signes négatifs sous forme de blocs
plt.rcParams['axes.unicode_minus'] = False
# Définir le style du graphique
plt.rcParams['figure.figsize'] = (10, 6)
plt.rcParams['axes.grid'] = True
plt.rcParams['grid.alpha'] = 0.3
# -------------------------- Fin de la configuration de la police chinoise --------------------------
# Charger les données
data = load_diabetes()
X, y = data.data, data.target
# N'utiliser qu'une seule caractéristique (plus adapté pour la démonstration de régression polynomiale)
X = X[:, np.newaxis, 2] # Sélectionner la troisième caractéristique (IMC)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Définir la fonction de tracé de la courbe d'apprentissage (version optimisée)
def plot_learning_curve(estimator, title, X, y, cv=5, train_sizes=np.linspace(0.1, 1.0, 10)):
"""
Tracer la courbe d'apprentissage
Paramètres :
estimator: estimateur du modèle
title: titre du graphique
X: données de caractéristiques
y: variable cible
cv: nombre de plis de validation croisée
train_sizes: proportions des échantillons d'entraînement
"""
# Obtenir les données de la courbe d'apprentissage
train_sizes_abs, train_scores, test_scores = learning_curve(
estimator, X, y, cv=cv, scoring='neg_mean_squared_error',
train_sizes=train_sizes, random_state=42, n_jobs=-1
)
# Calculer la moyenne et l'écart-type
train_scores_mean = -train_scores.mean(axis=1)
train_scores_std = train_scores.std(axis=1)
test_scores_mean = -test_scores.mean(axis=1)
test_scores_std = test_scores.std(axis=1)
# Tracer les courbes d'apprentissage
plt.figure(figsize=(10, 6))
plt.fill_between(train_sizes_abs,
train_scores_mean - train_scores_std,
train_scores_mean + train_scores_std,
alpha=0.1, color='r')
plt.fill_between(train_sizes_abs,
test_scores_mean - test_scores_std,
test_scores_mean + test_scores_std,
alpha=0.1, color='g')
# Tracer les courbes moyennes
plt.plot(train_sizes_abs, train_scores_mean, 'o-', color='r', linewidth=2,
markersize=8, label='MSE de l'ensemble d'entraînement')
plt.plot(train_sizes_abs, test_scores_mean, 'o-', color='g', linewidth=2,
markersize=8, label='MSE de l'ensemble de validation')
# Définir les propriétés du graphique
plt.xlabel('Nombre d'échantillons d'entraînement', fontsize=12)
plt.ylabel('Erreur quadratique moyenne (MSE)', fontsize=12)
plt.title(title, fontsize=14, pad=20)
plt.legend(loc='upper right', fontsize=11)
plt.tight_layout()
plt.show()
# Afficher les performances du modèle sur l'ensemble de test
estimator.fit(X_train, y_train)
y_pred = estimator.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
print(f"{title} - MSE de l'ensemble de test : {mse:.2f}")
# 1. Modèle en sous-apprentissage (polynôme d'ordre 1 - régression linéaire)
print("="*60)
print("Modèle en sous-apprentissage (polynôme d'ordre 1 - régression linéaire)")
print("="*60)
plot_learning_curve(
make_pipeline(StandardScaler(), PolynomialFeatures(1), LinearRegression()),
'Courbe d'apprentissage du modèle en sous-apprentissage (polynôme d'ordre 1)',
X, y
)
# 2. Modèle bien ajusté (polynôme du 2e ordre)
print("\n" + "="*60)
print("Modèle bien ajusté (polynôme du 2e ordre)")
print("="*60)
plot_learning_curve(
make_pipeline(StandardScaler(), PolynomialFeatures(2), LinearRegression()),
'Courbe d'apprentissage du modèle bien ajusté (polynôme du 2e ordre)',
X, y
)
# 3. Modèle en surapprentissage (polynôme du 8e ordre)
print("\n" + "="*60)
print("Modèle en surapprentissage (polynôme du 8e ordre)")
print("="*60)
plot_learning_curve(
make_pipeline(StandardScaler(), PolynomialFeatures(8), LinearRegression()),
'Courbe d'apprentissage du modèle en surapprentissage (polynôme du 8e ordre)',
X, y
)
# Bonus : visualiser les effets d'ajustement des modèles d'ordres différents
plt.figure(figsize=(12, 8))
X_plot = np.linspace(X.min(), X.max(), 100).reshape(-1, 1)
# Tracer les points de données d'origine
plt.scatter(X_train, y_train, alpha=0.5, label='Données d'entraînement', color='blue', s=30)
plt.scatter(X_test, y_test, alpha=0.5, label='Données de test', color='orange', s=30)
# Tracer les courbes d'ajustement pour différents ordres
orders = [1, 2, 8]
colors = ['red', 'green', 'purple']
labels = ['ordre 1 (sous-apprentissage)', 'ordre 2 (bon ajustement)', 'ordre 8 (surapprentissage)']
for i, order in enumerate(orders):
model = make_pipeline(StandardScaler(), PolynomialFeatures(order), LinearRegression())
model.fit(X_train, y_train)
y_plot = model.predict(X_plot)
plt.plot(X_plot, y_plot, color=colors[i], linewidth=2, label=labels[i])
plt.xlabel('Caractéristique IMC (standardisée)', fontsize=12)
plt.ylabel('Indice de progression du diabète', fontsize=12)
plt.title('Comparaison des effets d’ajustement de la régression polynomiale pour différents ordres', fontsize=14, pad=20)
plt.legend(fontsize=11)
plt.tight_layout()
plt.show()
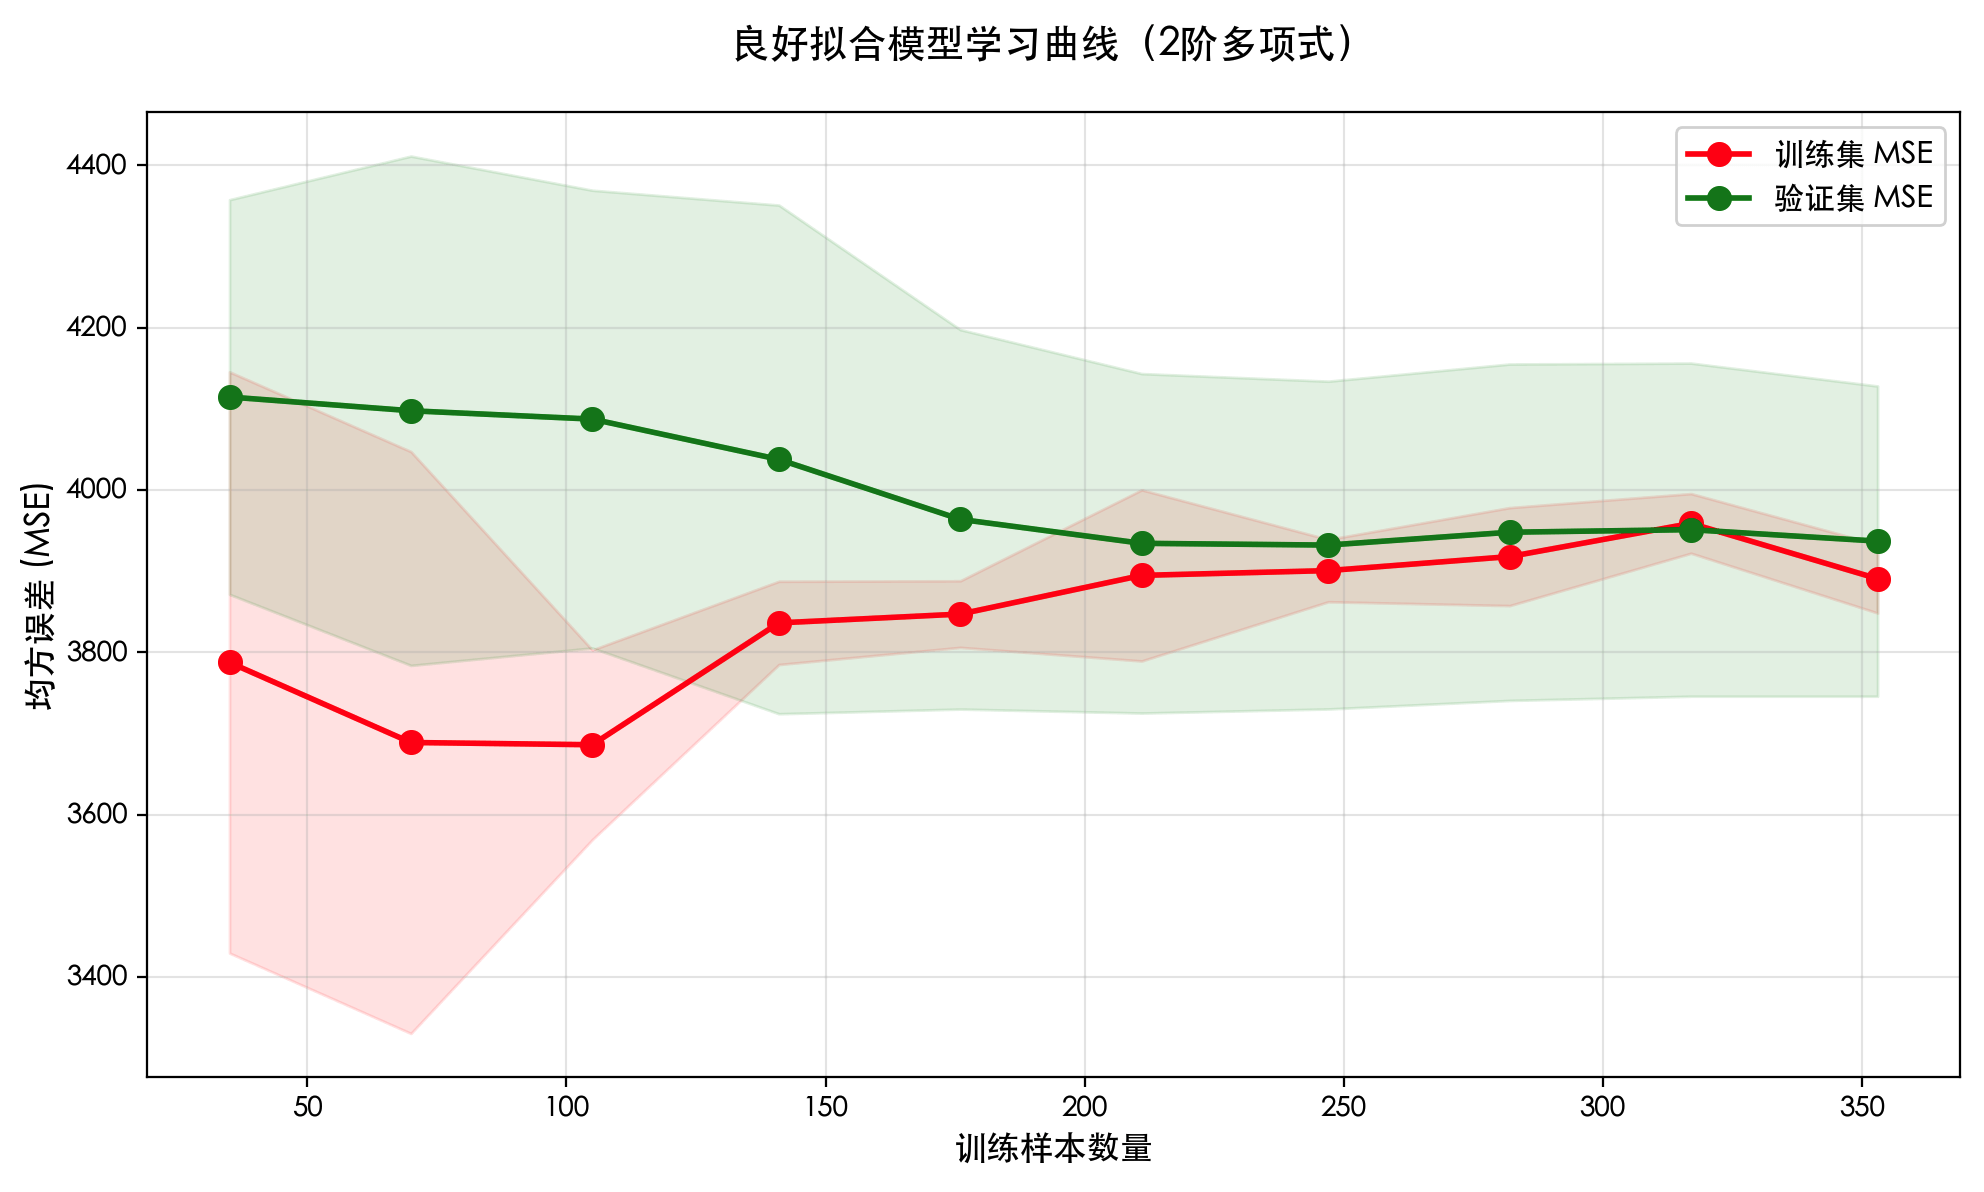
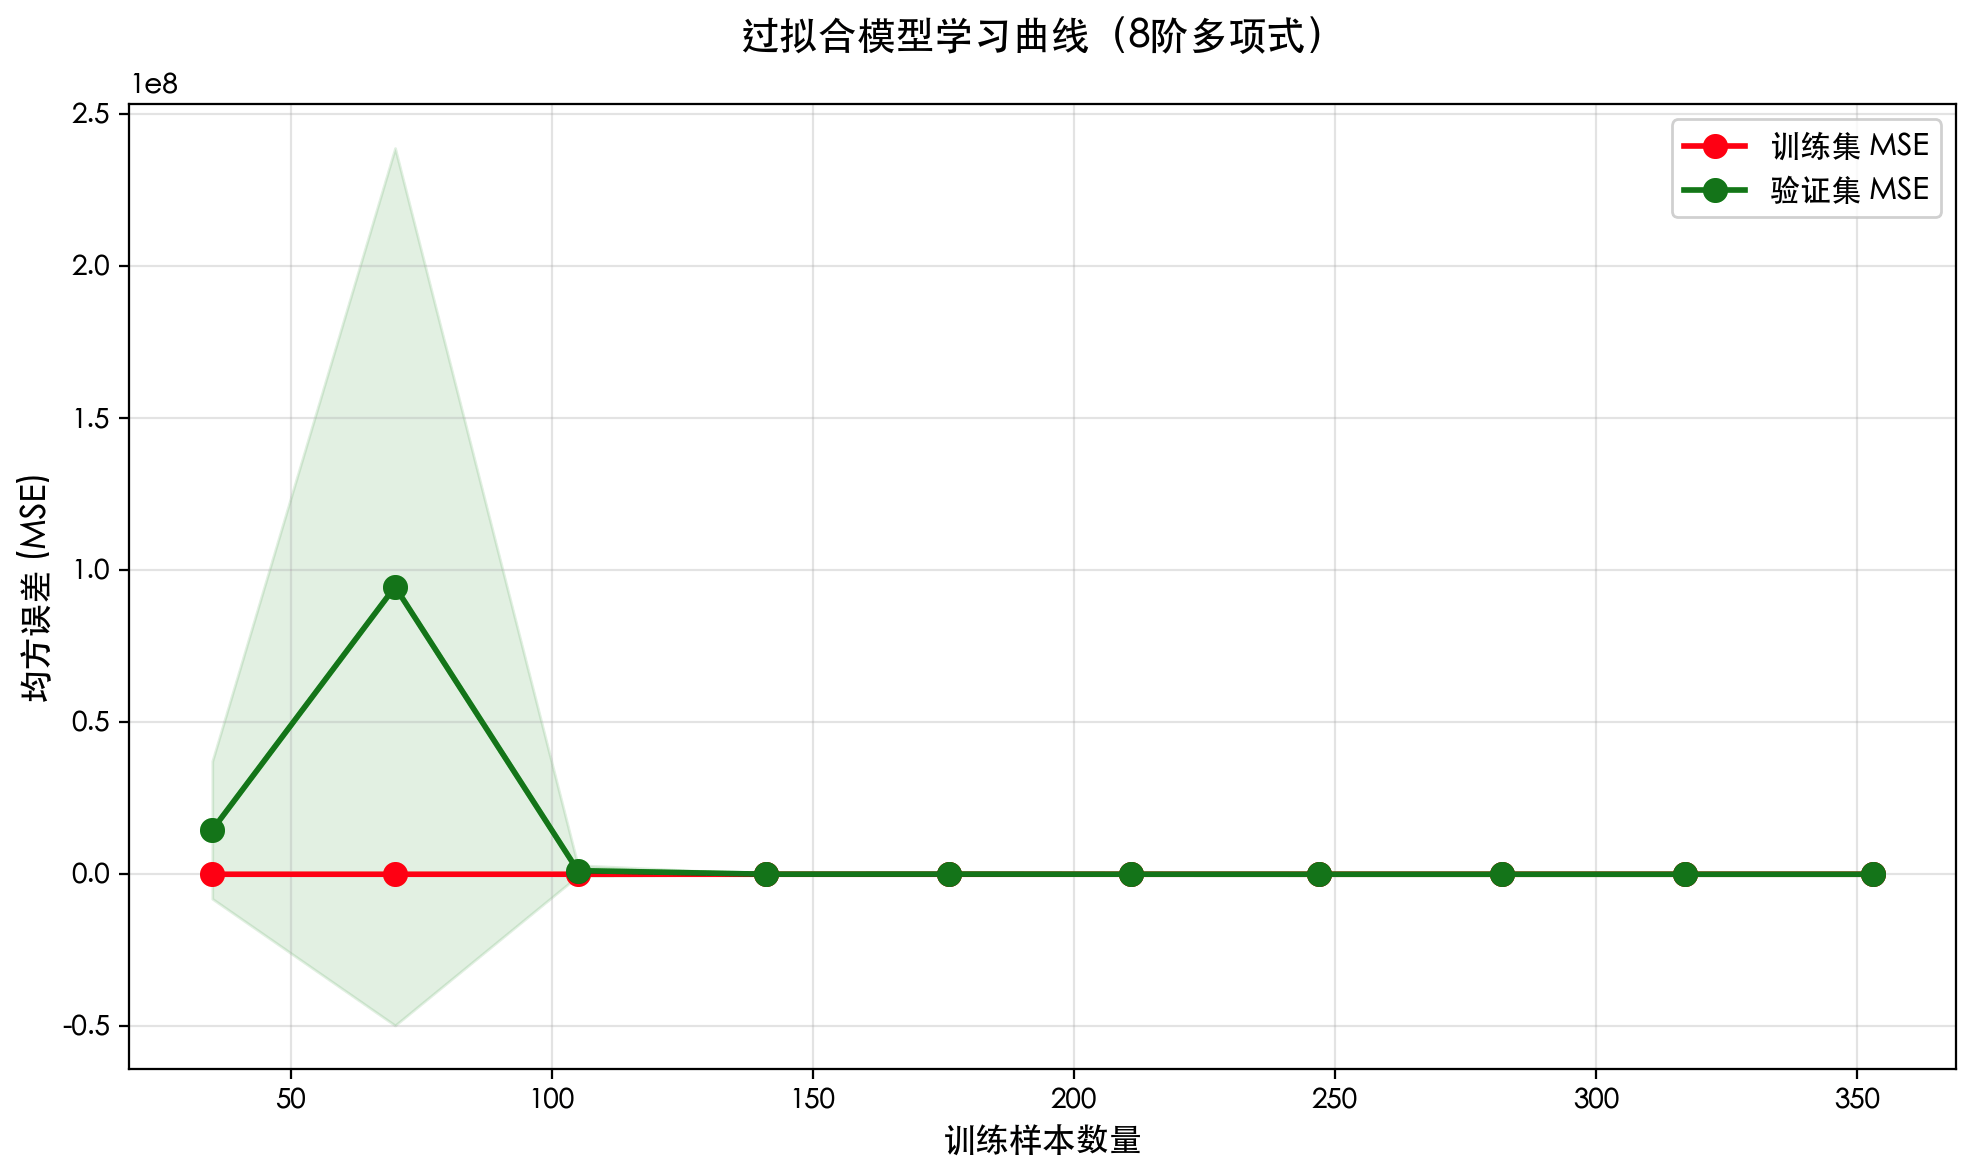
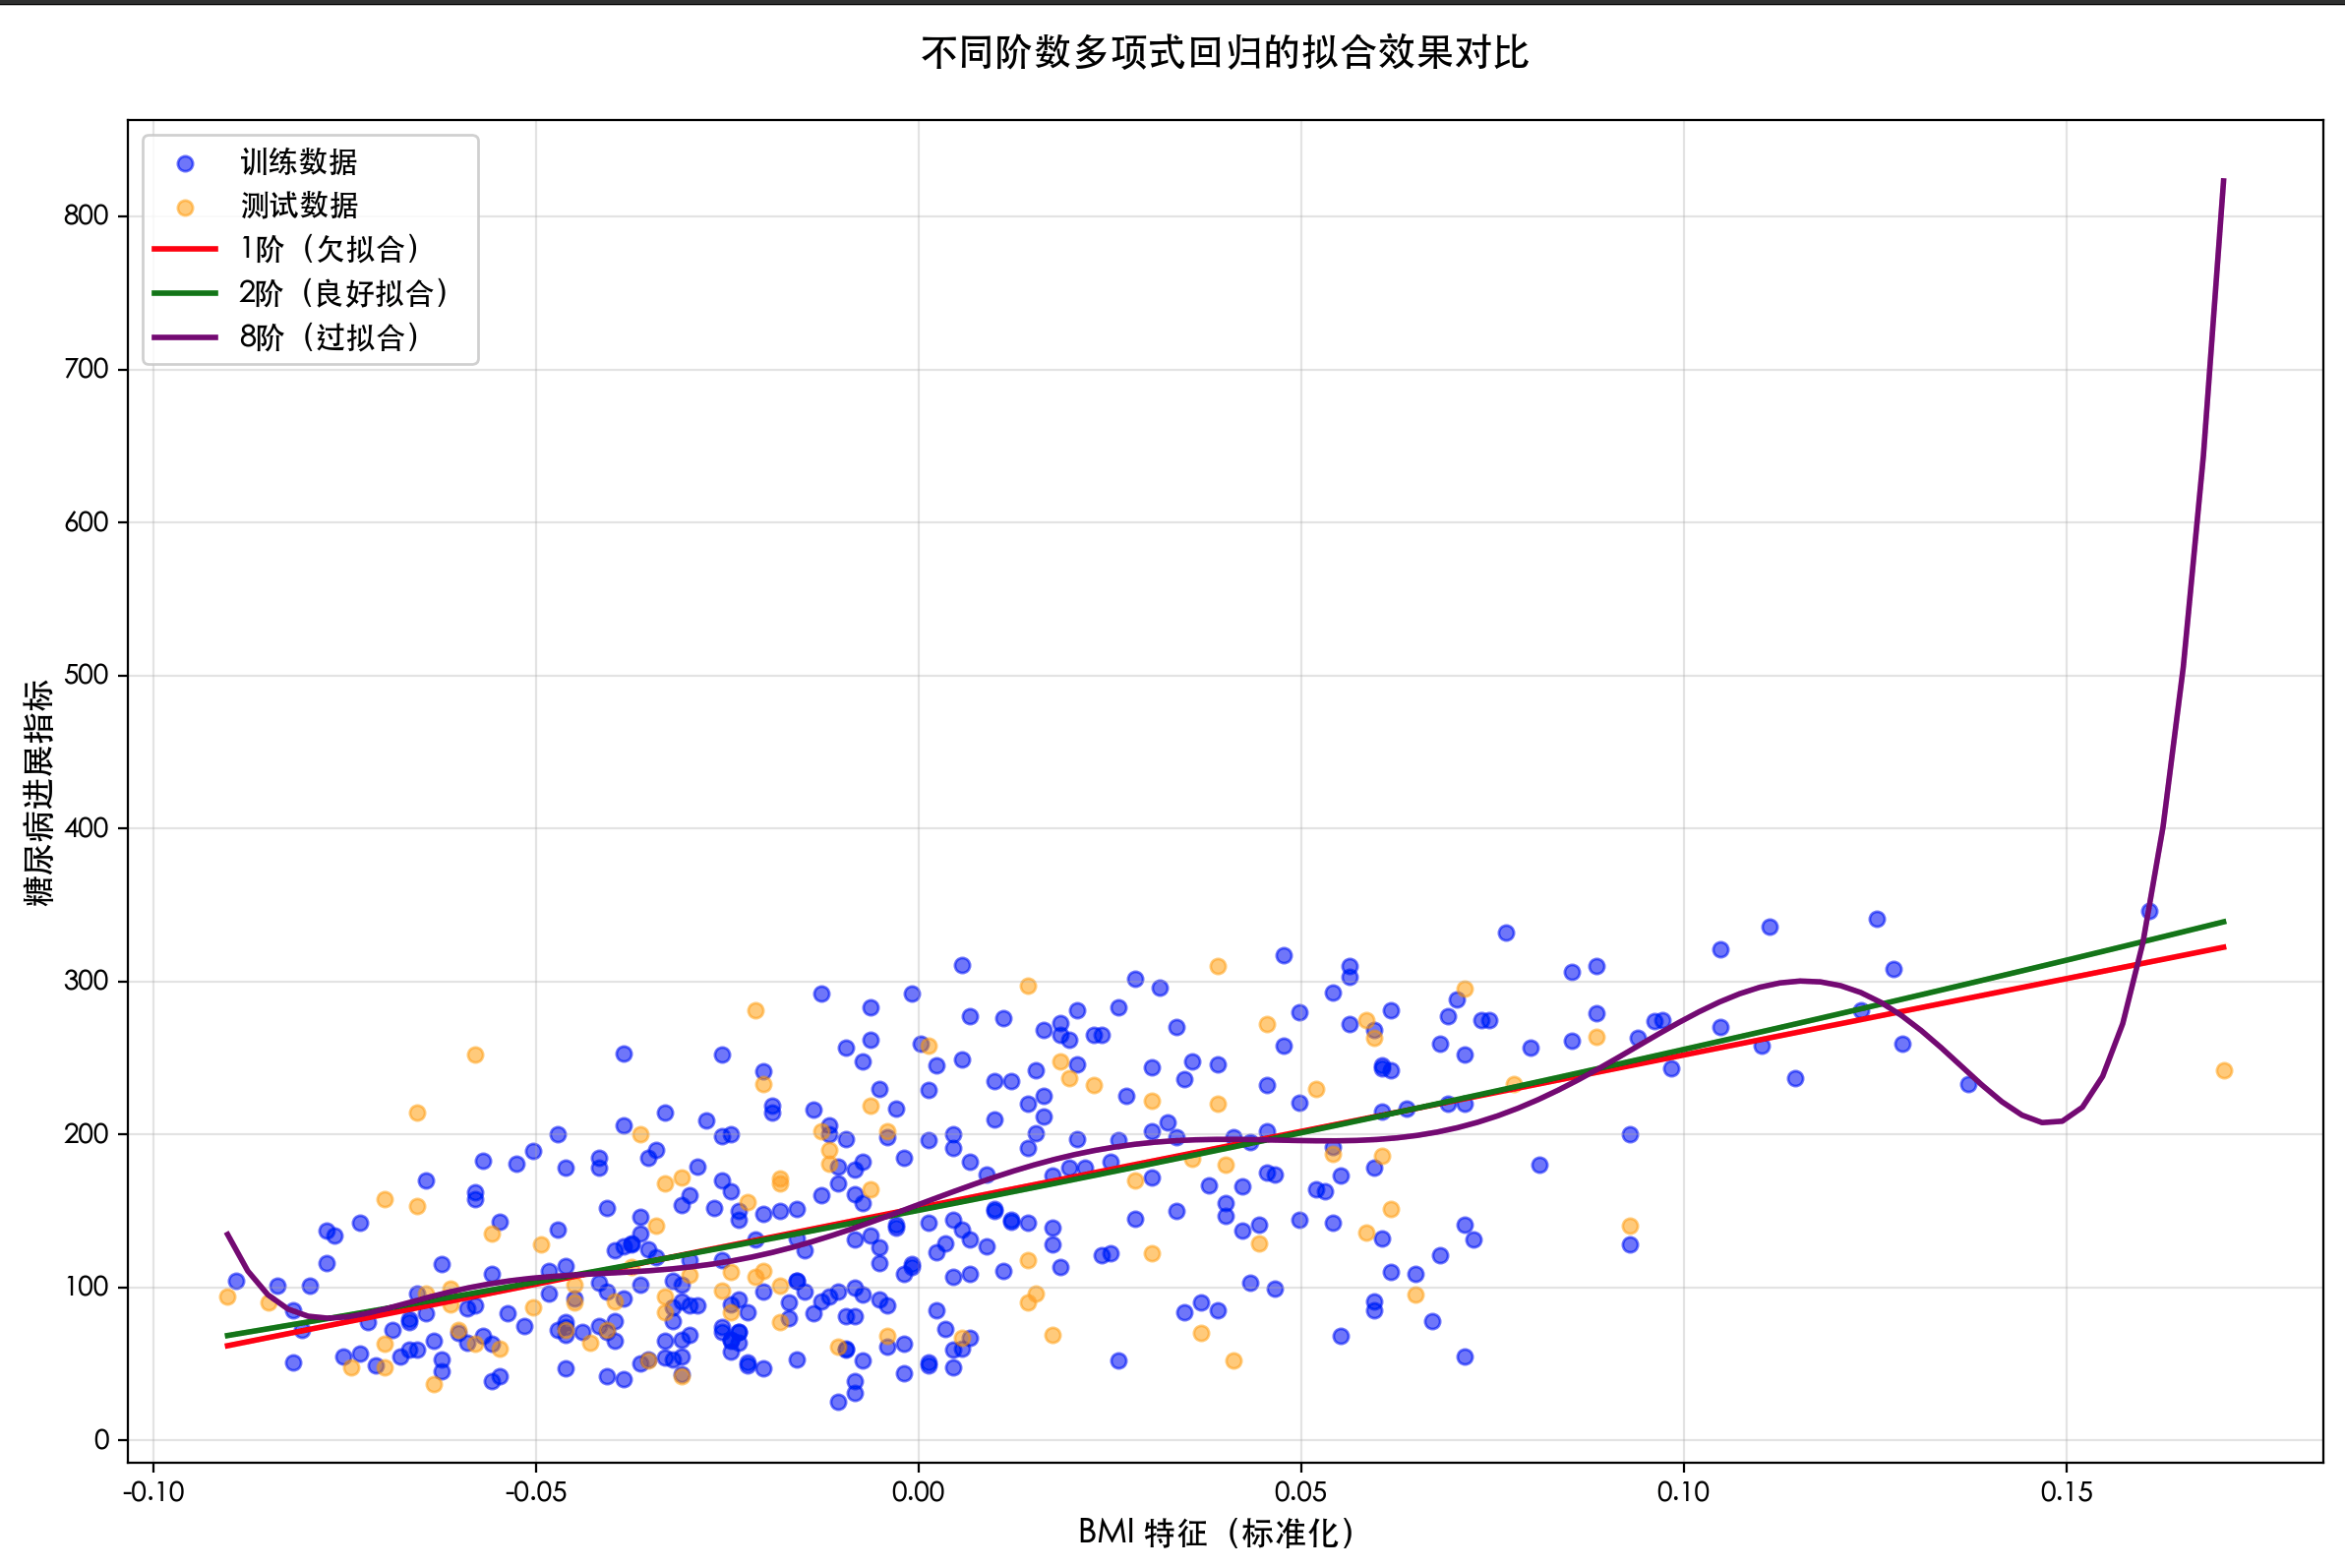
Comment interpréter les courbes d’apprentissage ?
| État d’ajustement | Erreur d’entraînement | Erreur de validation | Caractéristiques des courbes |
|---|---|---|---|
| Sous-apprentissage | Élevée | Élevée | Les deux courbes sont élevées et très proches ; l’ajout de données n’aide pas. |
| Bon ajustement | Faible | Faible | Les deux courbes sont basses et proches l’une de l’autre, atteignant un point d’équilibre. |
| Surapprentissage | Très faible | Élevée | L’erreur d’entraînement est très faible, mais l’erreur de validation est élevée, avec un écart évident entre les deux. L’ajout de données les rapproche généralement. |
2. Contre-mesures
D'après les résultats du diagnostic, nous pouvons adopter différentes stratégies :
Traiter le sous-apprentissage (biais élevé) :
- Augmenter la complexité du modèle: Utiliser des modèles plus puissants (par ex., passer de modèles linéaires à des modèles à base d'arbres, des réseaux de neurones).
- Ajouter davantage de caractéristiques: Extraire ou construire des caractéristiques plus significatives.
- Réduire la régularisation: Si une régularisation (par ex., L1, L2) est utilisée, essayez d'en atténuer la force.
- Prolonger la durée d'entraînement: Pour les modèles itératifs (par ex., les réseaux de neurones), entraînez-les pendant davantage d'époques.
Traiter le surapprentissage (variance élevée) :
- Obtenir davantage de données d'entraînement: L'une des méthodes les plus efficaces.
- Réduire la complexité du modèle: Choisir un modèle plus simple (par ex., un degré polynomial plus faible, réduire la profondeur de l'arbre, réduire le nombre de couches du réseau de neurones).
- Sélection de caractéristiques: Supprimer les caractéristiques non pertinentes ou redondantes.
- Augmenter la régularisation:
- Régularisation L1 (Lasso): A tendance à produire des poids parcimonieux et peut être utilisée pour la sélection de caractéristiques.
- Régularisation L2 (Ridge): Provoque une décroissance des poids, tendant à rendre tous les poids petits.
- Dropout(pour les réseaux de neurones) : Abandonne aléatoirement une partie des neurones pendant l'entraînement.
- Arrêt précoce(pour les modèles itératifs) : Arrêter l'entraînement lorsque l'erreur de validation ne diminue plus.
IV. Travaux pratiques : Expérience avec des jeux de données réels
Entraînons-nous sur le classique jeu de données Boston housing (ou sur le jeu de données diabetes, car le jeu de données Boston est obsolète).
Exemple
import matplotlib.pyplot as plt
from sklearn.datasets import load_diabetes
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_squared_error
# -------------------------- Début de configuration de la police chinoise --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows en premier
'SimHei', 'Microsoft YaHei',
# macOS en premier
'PingFang SC', 'Heiti TC',
# Linux d'abord
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corriger le problème d'affichage des signes négatifs sous forme de blocs
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de la configuration de la police chinoise --------------------------
# Charger les données
data = load_diabetes()
X, y = data.data, data.target
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Essayez des arbres de décision avec différentes complexités
max_depths = [1, 3, 10, None] # None signifie aucune limite de profondeur ; l'arbre continue de croître jusqu'à être « pur »
train_errors = []
test_errors = []
for depth in max_depths:
model = DecisionTreeRegressor(max_depth=depth, random_state=42)
model.fit(X_train, y_train)
y_train_pred = model.predict(X_train)
y_test_pred = model.predict(X_test)
train_error = mean_squared_error(y_train, y_train_pred)
test_error = mean_squared_error(y_test, y_test_pred)
train_errors.append(train_error)
test_errors.append(test_error)
print(f"Profondeur maximale de l'arbre : {depth if depth is not None else 'Illimité'}")
print(f" MSE de l'ensemble d'entraînement : {train_error:.2f}")
print(f" MSE de l'ensemble de test : {test_error:.2f}")
print("-" * 30)
# Visualisation
plt.figure(figsize=(10, 6))
depths = [str(d) if d else 'Illimité' for d in max_depths]
x_index = np.arange(len(depths))
width = 0.35
plt.bar(x_index - width/2, train_errors, width, label='Erreur d'entraînement', color='skyblue')
plt.bar(x_index + width/2, test_errors, width, label='Erreur de test', color='lightcoral')
plt.xlabel('Profondeur maximale de l'arbre de décision (complexité du modèle)')
plt.ylabel('Erreur quadratique moyenne (MSE)')
plt.title('Compromis biais-variance : performance des arbres de décision avec différentes complexités')
plt.xticks(x_index, depths)
plt.legend()
plt.grid(True, axis='y')
plt.tight_layout()
plt.show()
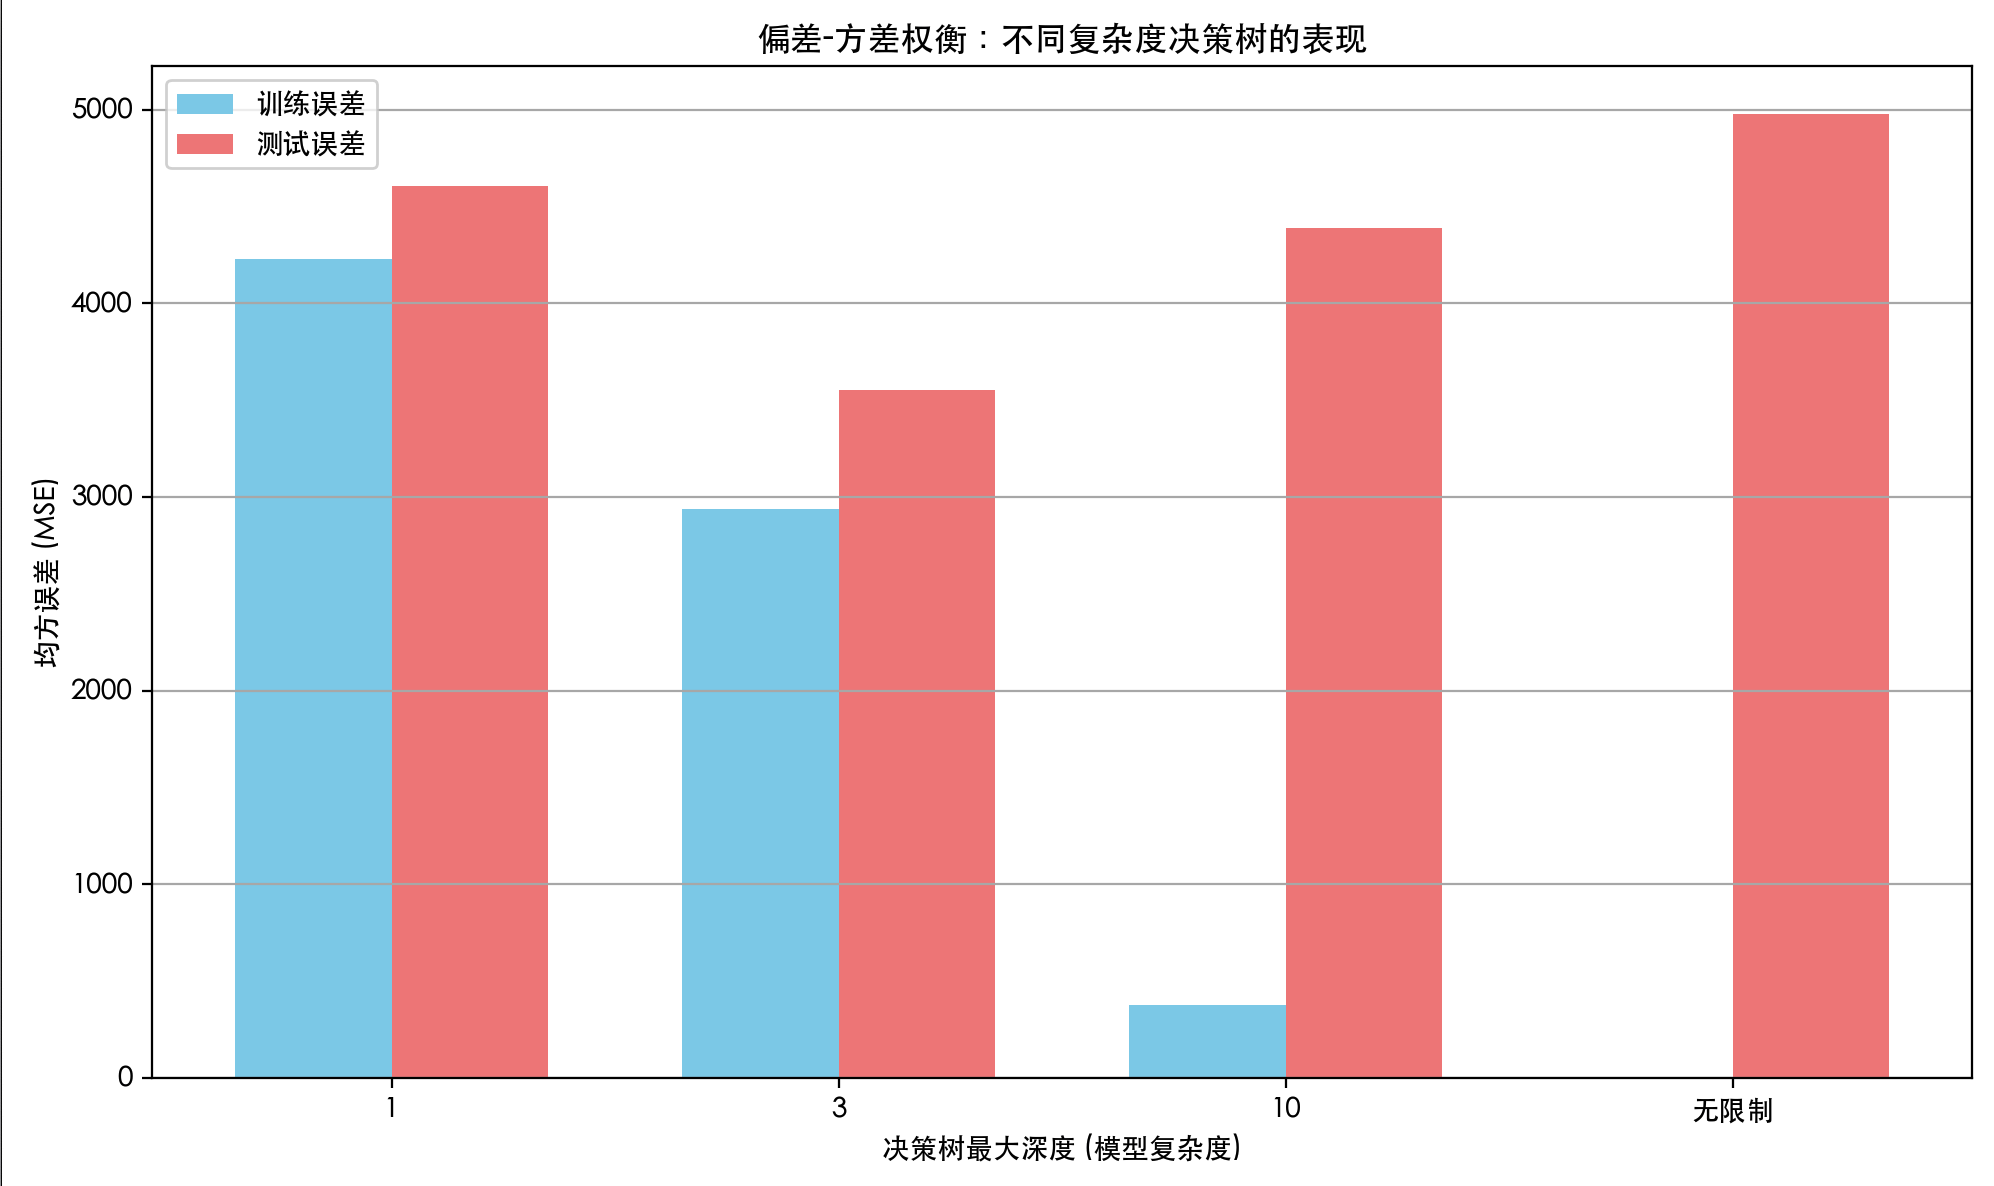
Résultats de l'analyse:
- Depth=1: Le modèle est très simple, les erreurs d'entraînement et de test sont élevées ->biais élevé, sous-apprentissage。
- Depth=3: La complexité du modèle augmente, les deux erreurs diminuent significativement et sont relativement proches ->Équilibre biais-variance, bon ajustement。
- Depth=10 ou illimité: Le modèle est très complexe, l'erreur d'entraînement est extrêmement faible, mais l'erreur de test commence à augmenter (ou est bien plus élevée que l'erreur d'entraînement) ->Variance élevée, surapprentissage。
Résumé
Comprendre le surapprentissage, le sous-apprentissage, le biais et la variance est la pierre angulaire de la construction d'excellents modèles d'apprentissage automatique. Rappelez-vous cette boucle principale :
- Entraîner le modèle -> Évaluer ses performances sur les ensembles d'entraînement et de validation。
- Diagnostiquer les problèmes à l'aide des courbes d'apprentissage ou d'une comparaison des erreurs: s'agit-il d'un biais élevé (sous-apprentissage) ou d'une variance élevée (surapprentissage) ?
- Appliquer la stratégie correspondante(augmenter la complexité/les données, la régularisation, etc.) pour améliorer.
- Revenir à l'étape 1, jusqu'à obtenir un modèle satisfaisant avec une forte capacité de généralisation sur l'ensemble de validation.