Переобучение, недообучение, смещение и дисперсия
В мире машинного обучения построение модели похоже на обучение студента. Наша цель состоит в том, чтобы этотстудентмог не только запомнить примеры задач из учебника (обучающие данные), но и глубоко понять лежащие в основе принципы, чтобы достичь хороших результатов на совершенно невиданных экзаменационных вопросах (тестовые данные). Однако этотстудентможет столкнуться с двумя типичными проблемами в процессе обучения:
- Одна — учиться слишком жёстко, лишь механически применяя примеры (недообучение);
- Другая — учиться слишком хитро, запоминая даже знаки препинания и особенности почерка в примерах, так что они теряются перед новыми вопросами (переобучение)。
Пониманиепереобученияинедообучения, а также более глубоких теоретических концепций, стоящих за ними, —смещениеидисперсия, — ключевой шаг для каждого практика машинного обучения на пути от новичка до мастера. Они объясняют, почему модели ошибаются, и показывают нам направление улучшения модели.
I. Основные понятия: производительность модели и состояние «подгонки»
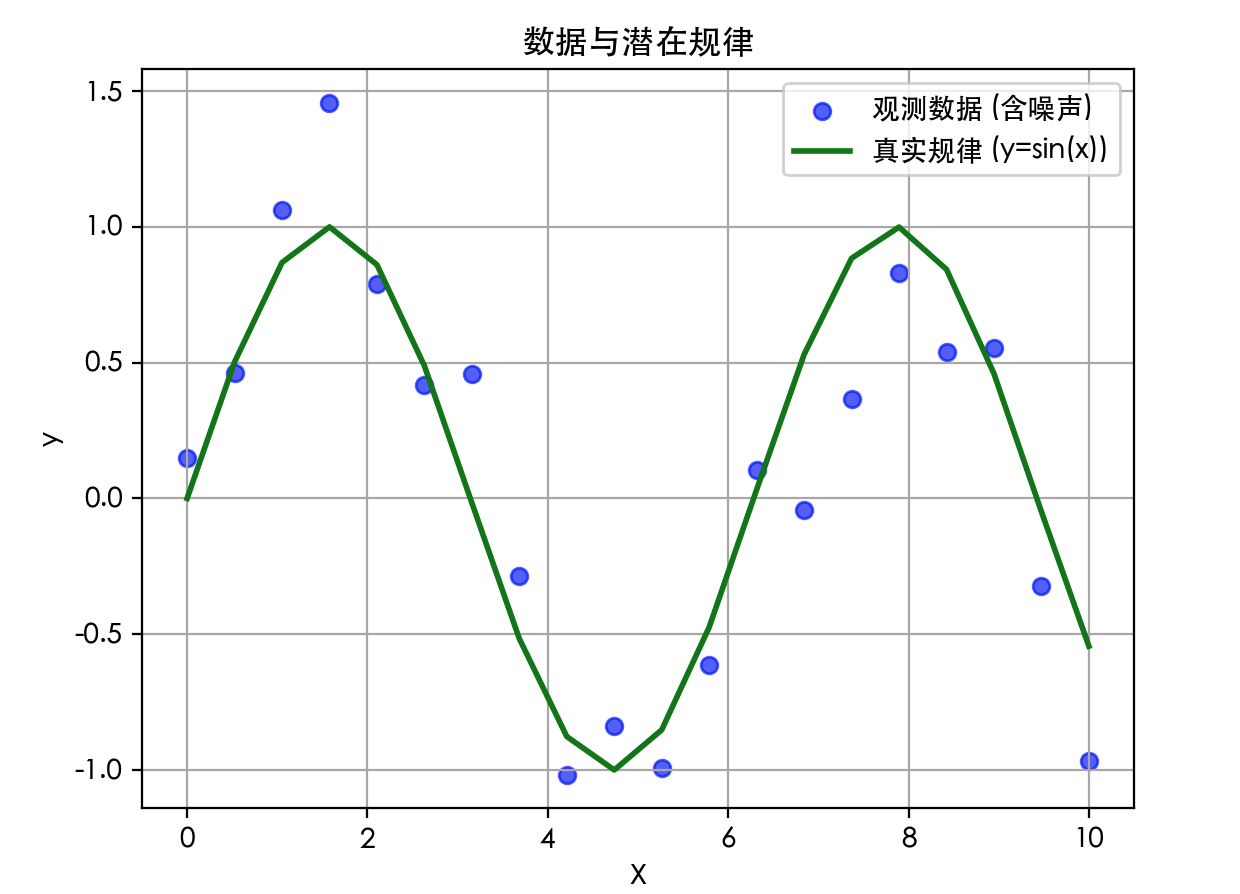
Сначала давайте на интуитивном примере разберёмся, что такоеподгонка. Предположим, мы хотим использовать математическую модель, чтобы подогнать набор разрозненных точек данных.
Пример
import matplotlib.pyplot as plt
# -------------------------- Начало настройки китайского шрифта --------------------------
plt.rcParams['font.sans-serif'] = [
# Сначала Windows
'SimHei', 'Microsoft YaHei',
# Сначала macOS
'PingFang SC', 'Heiti TC',
# Сначала Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Исправление проблемы, когда знаки минуса отображаются в виде квадратов
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Конец настройки китайского шрифта --------------------------
# Сгенерировать имитационные данные: добавить случайный шум на основе синусоиды
np.random.seed(42)
X = np.linspace(0, 10, 20)
y_true = np.sin(X) # Истинная лежащая в основе закономерность (которую мы не знаем)
y_noise = np.random.randn(20) * 0.3 # Случайный шум
y = y_true + y_noise # Данные, которые мы фактически наблюдаем
plt.scatter(X, y, label='Наблюдаемые данные (с шумом)', color='blue', alpha=0.6)
plt.plot(X, y_true, label='Истинная закономерность (y=sin(x))', color='green', linewidth=2)
plt.xlabel('X')
plt.ylabel('y')
plt.title('Данные и лежащая в основе закономерность')
plt.legend()
plt.grid(True)
plt.show()
Наша цель — найти кривую (модель), которая лучше всего описывает закономерность, отражённую этими синими точками диаграммы рассеяния (данными).
Степень, в которой модель описывает данные, — этоподгонка。
1. Недообучение
Недообучениеозначает модель, которая слишком проста, чтобы уловить базовые закономерности или структуры в данных. Это как студент, который выучил только сложение, но его просят решать задачи по математическому анализу.
- Поведение: модель работает очень плохо наобучающих данных(например, низкая точность, высокая ошибка).
- Причины: сложность модели слишком низкая, признаков недостаточно или обучение недостаточное.
- Аналогия: использование прямой линии (полинома первой степени) для подгонки данных с очевидной криволинейной тенденцией.
Пример
from sklearn.preprocessing import PolynomialFeatures
from sklearn.metrics import mean_squared_error
# Попробуйте выполнить подгонку полиномом 1-й степени (прямой линией)
poly = PolynomialFeatures(degree=1)
X_poly1 = poly.fit_transform(X.reshape(-1, 1))
model_under = LinearRegression()
model_under.fit(X_poly1, y)
y_pred_under = model_under.predict(X_poly1)
mse_train_under = mean_squared_error(y, y_pred_under)
print(f"Среднеквадратичная ошибка (MSE) недообученной модели на обучающем наборе: {mse_train_under:.4f}")
Вывод:
欠拟合模型在训练集上的均方误差 (MSE): 0.4402
欠拟合模型在训练集上的均方误差 (MSE): 0.4402
2. Оптимальная подгонка
Это идеальное состояние. Модель достаточно сложна, чтобы выучить ключевые закономерности в данных, но не настолько сложна, чтобы выучить случайный шум. Она хорошо работает как на обучающем наборе, так и на невидимых тестовых наборах.
- Поведение: Ошибки и на обучающем наборе, и на тестовом наборе низкие, и они близки.
- Аналогия: Использование полинома подходящей степени (например, 3-й степени) для подгонки данных.
Пример
poly = PolynomialFeatures(degree=3)
X_poly3 = poly.fit_transform(X.reshape(-1, 1))
model_good = LinearRegression()
model_good.fit(X_poly3, y)
y_pred_good = model_good.predict(X_poly3)
mse_train_good = mean_squared_error(y, y_pred_good)
print(f"Среднеквадратичная ошибка (MSE) хорошо подогнанной модели на обучающем наборе: {mse_train_good:.4f}")
Вывод:
欠拟合模型在训练集上的均方误差 (MSE): 0.4402
良好拟合模型在训练集上的均方误差 (MSE): 0.3988
3. Переобучение
Переобучениеотносится к модели, которая слишком сложна: она изучает не только истинные закономерности в данных, но и «запоминает» случайный шум и выбросы в обучающих данных.
- Поведение: Модель показывает чрезвычайно хорошие результаты наобучающих данных(с очень малой ошибкой), но нановых, не встречавшихся ранее данныхеё производительность резко падает, демонстрируя плохую способность к обобщению.
- Причины: Сложность модели слишком высока, а объём обучающих данных слишком мал.
- Аналогия: Использовать полином очень высокой степени (например, 15-й степени) для подгонки данных, из-за чего кривая проходит почти через каждую точку данных и становится крайне искажённой.
Пример
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures
from sklearn.metrics import mean_squared_error
# -------------------------- Начало настройки китайского шрифта --------------------------
plt.rcParams['font.sans-serif'] = [
# Сначала Windows
'SimHei', 'Microsoft YaHei',
# Сначала macOS
'PingFang SC', 'Heiti TC',
# Сначала Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Исправление проблемы, когда знаки минуса отображаются в виде квадратов
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Конец настройки китайского шрифта --------------------------
# Сгенерировать имитационные данные: добавить случайный шум на основе синусоиды
np.random.seed(42)
X = np.linspace(0, 10, 20)
y_true = np.sin(X) # Истинная лежащая в основе закономерность (которую мы не знаем)
y_noise = np.random.randn(20) * 0.3 # Случайный шум
y = y_true + y_noise # Данные, которые мы фактически наблюдаем
# Попробуйте выполнить подгонку полиномом 1-й степени (прямой линией)
poly = PolynomialFeatures(degree=1)
X_poly1 = poly.fit_transform(X.reshape(-1, 1))
model_under = LinearRegression()
model_under.fit(X_poly1, y)
y_pred_under = model_under.predict(X_poly1)
mse_train_under = mean_squared_error(y, y_pred_under)
print(f"Среднеквадратичная ошибка (MSE) недообученной модели на обучающем наборе: {mse_train_under:.4f}")
# Попробуйте подогнать полиномом 3-й степени
poly = PolynomialFeatures(degree=3)
X_poly3 = poly.fit_transform(X.reshape(-1, 1))
model_good = LinearRegression()
model_good.fit(X_poly3, y)
y_pred_good = model_good.predict(X_poly3)
mse_train_good = mean_squared_error(y, y_pred_good)
print(f"Среднеквадратичная ошибка (MSE) хорошо подогнанной модели на обучающем наборе: {mse_train_good:.4f}")
# Попробуйте выполнить подгонку полиномом 15-й степени (крайне склонен к переобучению)
poly = PolynomialFeatures(degree=15)
X_poly15 = poly.fit_transform(X.reshape(-1, 1))
model_over = LinearRegression()
model_over.fit(X_poly15, y)
y_pred_over = model_over.predict(X_poly15)
mse_train_over = mean_squared_error(y, y_pred_over)
print(f"Среднеквадратичная ошибка (MSE) переобученной модели на обучающем наборе: {mse_train_over:.4f}")
# Визуализация трёх состояний подгонки
plt.figure(figsize=(15, 4))
# Недообучение
plt.subplot(1, 3, 1)
plt.scatter(X, y, alpha=0.6)
plt.plot(X, y_pred_under, color='red', linewidth=2, label='Недообучение (1-я степень)')
plt.plot(X, y_true, color='green', linestyle='--', label='Истинная закономерность')
plt.title(f'Недообучение\nMSE на обучении: {mse_train_under:.4f}')
plt.legend()
plt.grid(True)
# Хорошая подгонка
plt.subplot(1, 3, 2)
plt.scatter(X, y, alpha=0.6)
plt.plot(X, y_pred_good, color='red', linewidth=2, label='Хорошая подгонка (3-я степень)')
plt.plot(X, y_true, color='green', linestyle='--', label='Истинная закономерность')
plt.title(f'Хорошая подгонка\nMSE на обучении: {mse_train_good:.4f}')
plt.legend()
plt.grid(True)
# Переобучение
plt.subplot(1, 3, 3)
plt.scatter(X, y, alpha=0.6)
plt.plot(X, y_pred_over, color='red', linewidth=2, label='Переобучение (15-й степени)')
plt.plot(X, y_true, color='green', linestyle='--', label='Истинная закономерность')
plt.title(f'Переобучение\nMSE на обучении: {mse_train_over:.4f}')
plt.legend()
plt.grid(True)
plt.tight_layout()
plt.show()
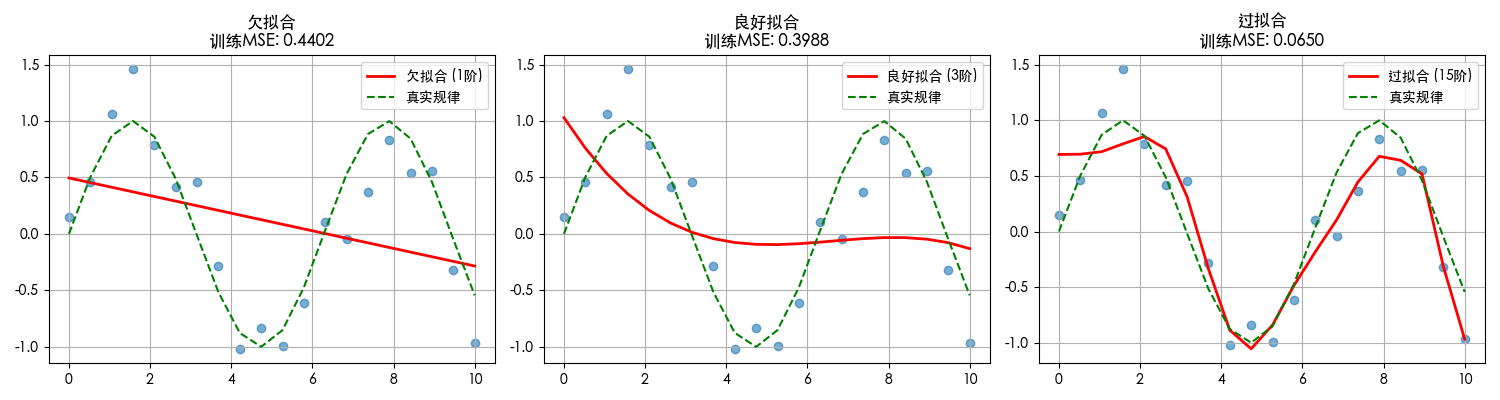
Из рисунка хорошо видно:
- Недообучение (слева):Красная прямая линия совершенно не улавливает колеблющуюся тенденцию данных.
- Хорошая подгонка (посередине):Красная кривая приблизительно следует тенденции зелёной истинной закономерности.
- Переобучение (справа):Красная кривая сильно колеблется, пытаясь пройти через каждую синюю разбросанную точку, включая шумовые точки, полностью теряя гладкую форму синусоиды.
II. Теоретические основы: разложение на смещение и дисперсию
Смещение и дисперсия дают теоретическую основу для понимания переобучения и недообучения. Они описывают два разных источника ошибки модели.
Мы можем разложитьобщую ошибку моделина:Смещение² + Дисперсия + Неустранимая ошибка。
1. Смещение
- Определение: разница междуожидаемым значением(то есть средним предсказанным значением) и истинным значением. Оно отражает присущую моделисистематическую ошибку, то есть верны ли предположения модели о природе задачи.
- Поведение при высоком смещении: модель слишком проста, чтобы уловить характеристики данных, что приводит кнедообучению. Независимо от того, какие данные используются для обучения, результаты отклоняются от истинных значений.
- Пример: всегда использовать простую линейную модель "цена дома = площадь × 1000" для предсказания всех видов домов, игнорируя такие важные факторы, как местоположение и этаж, — это высокое смещение.
2. Дисперсия
- Определение:диапазон колебанийсамих предсказаний модели. Он отражает чувствительность модели кслучайному шумув обучающих данных.
- Признаки высокой дисперсии: модель слишком сложна и слишком остро реагирует на небольшие изменения (включая шум) в обучающих данных, что приводит кпереобучению. Обучение на другом наборе данных может дать совершенно другую модель.
- Пример: глубокая нейронная сеть, если её никак не ограничивать, может сгенерировать совершенно другой, чрезвычайно сложный набор правил предсказания для каждого уникального набора обучающих данных, — это высокая дисперсия.
3. Компромисс между смещением и дисперсией
Это ключевой компромисс в машинном обучении.Мы не можем одновременно минимизировать и смещение, и дисперсию.
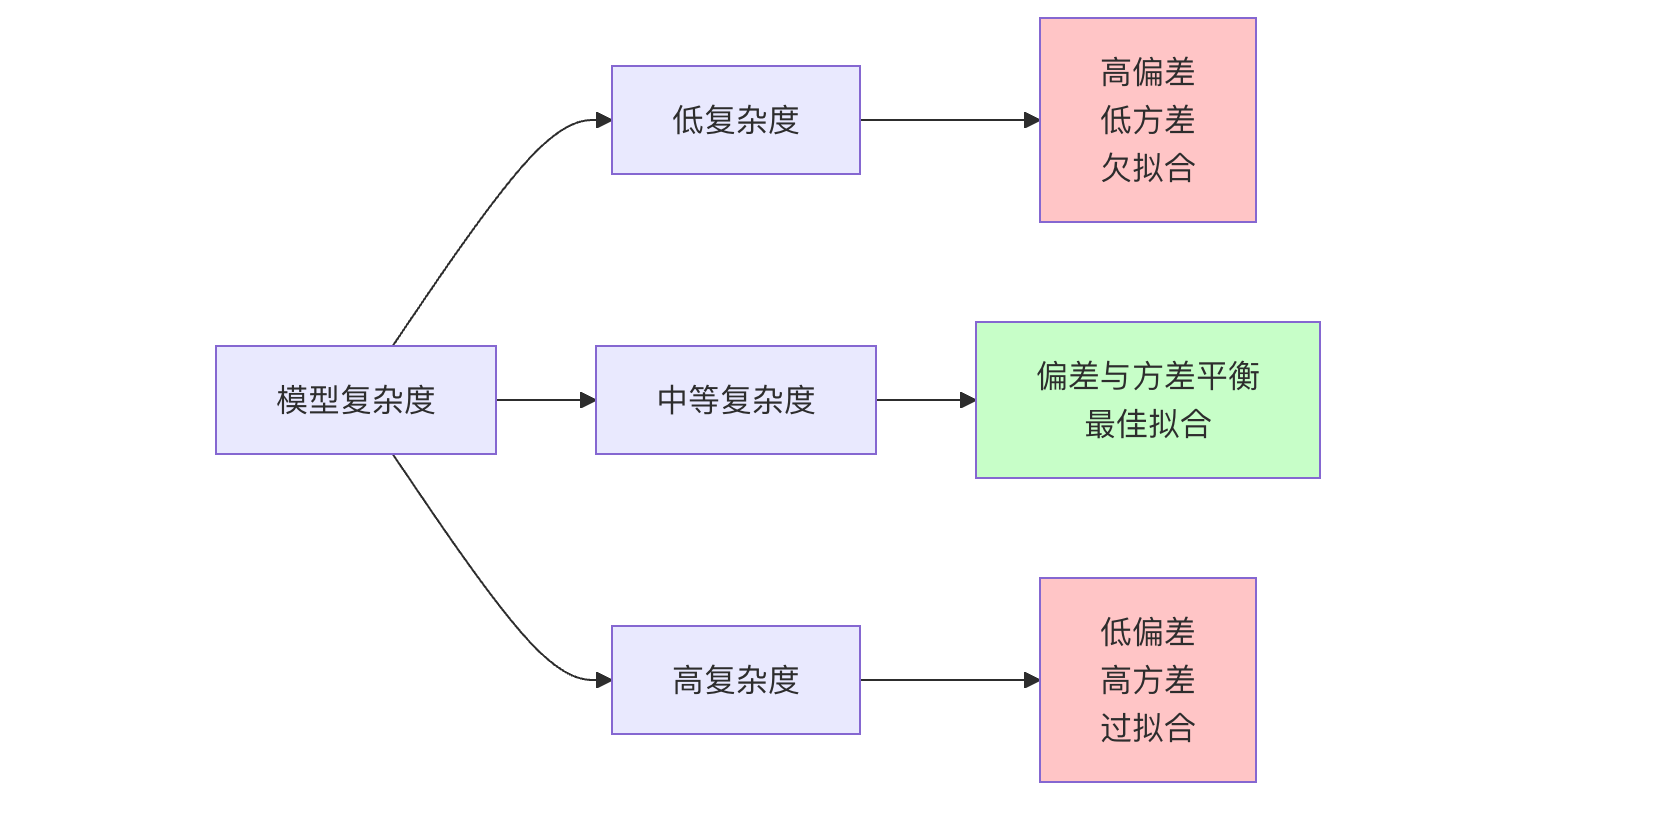
- Увеличение сложности модели: обычно уменьшаетсмещение(модель становится более мощной), но увеличиваетдисперсию(она легче выучивает шум).
- Уменьшение сложности модели: обычно уменьшаетдисперсию(модель становится более стабильной), но увеличиваетсмещение(модель становится слабее).
Наша цель — найти «оптимальную точку» на графике так, чтобы общая ошибка была минимизирована.
III. Диагностика и контрмеры
Как определить, в каком состоянии находится модель? Как это решить?
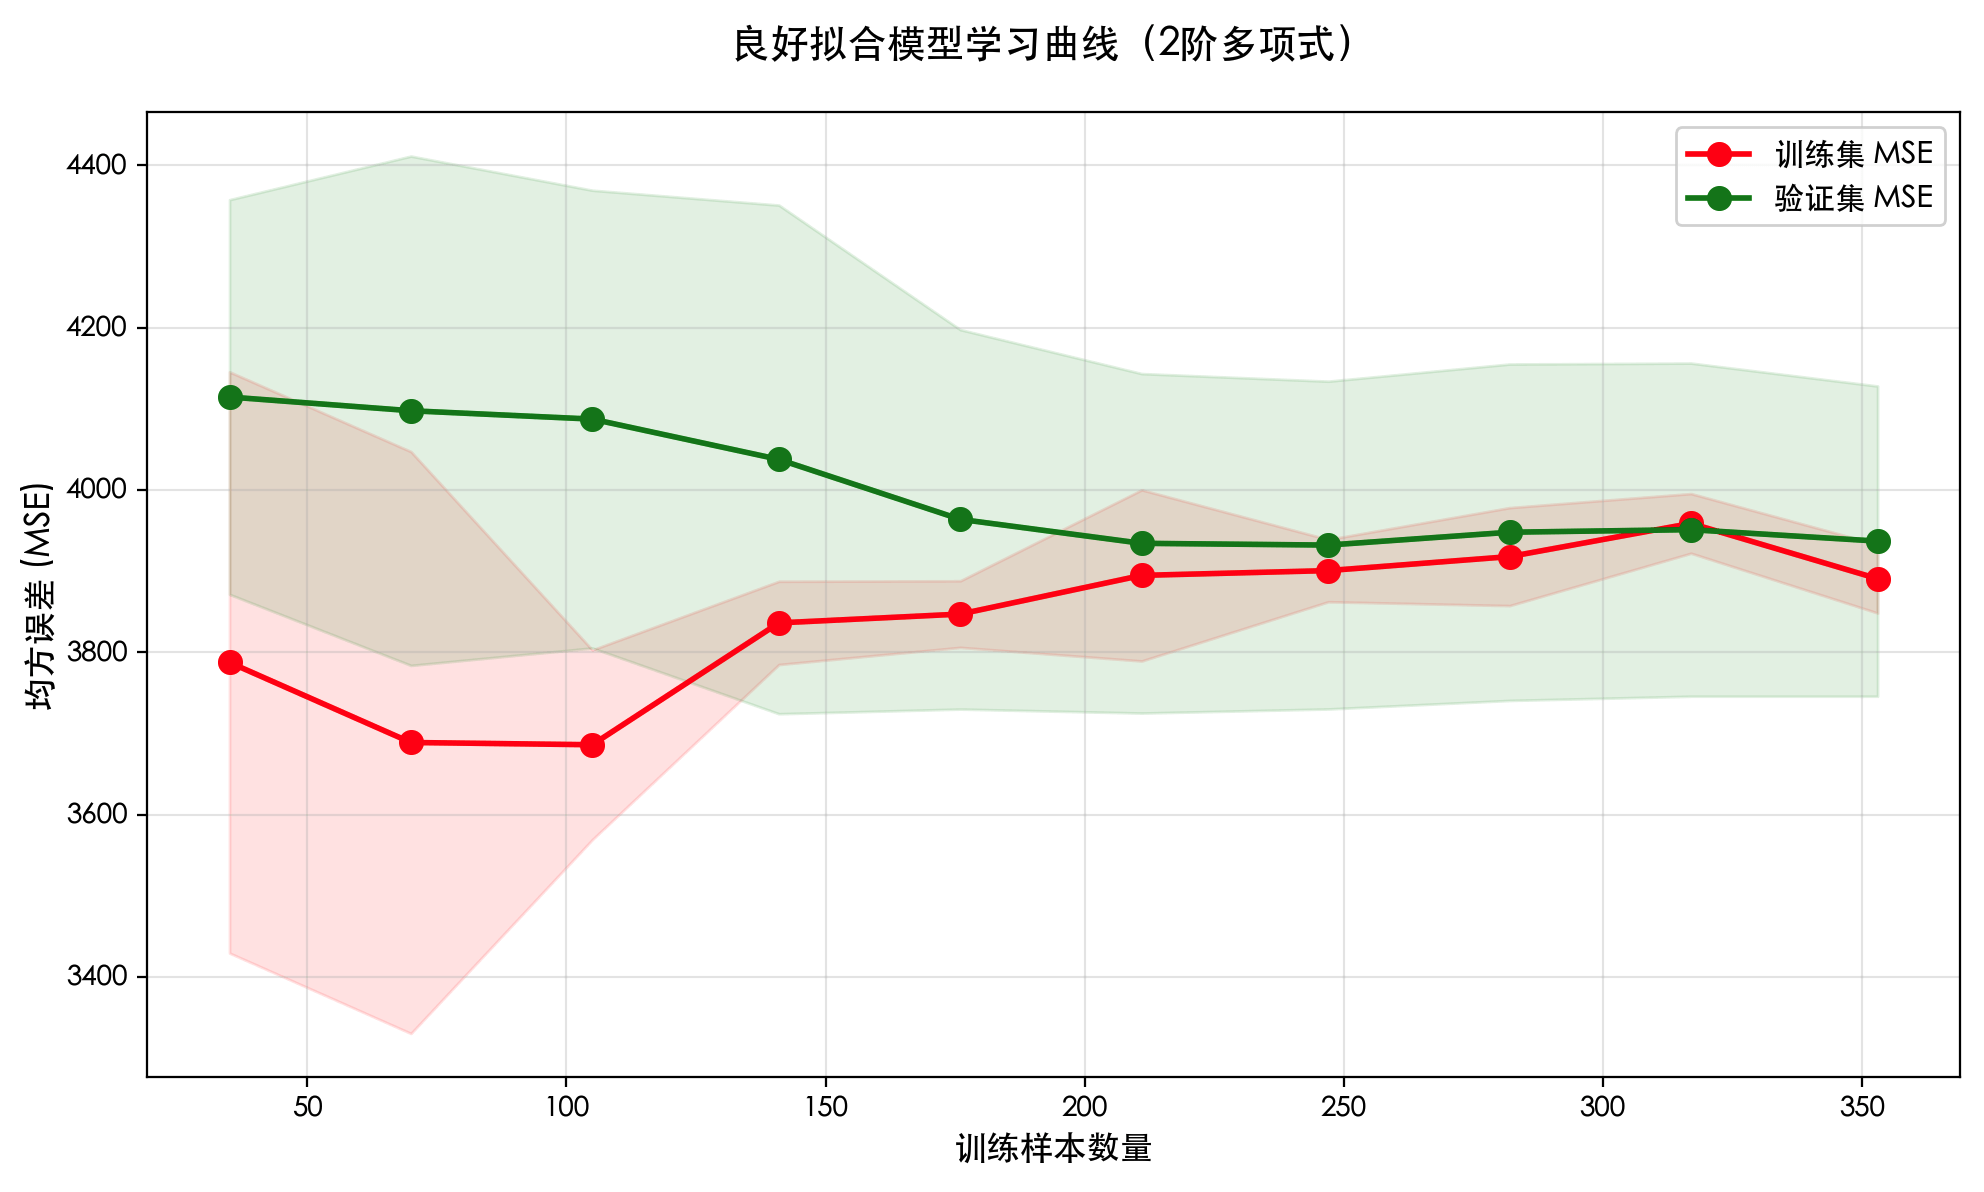
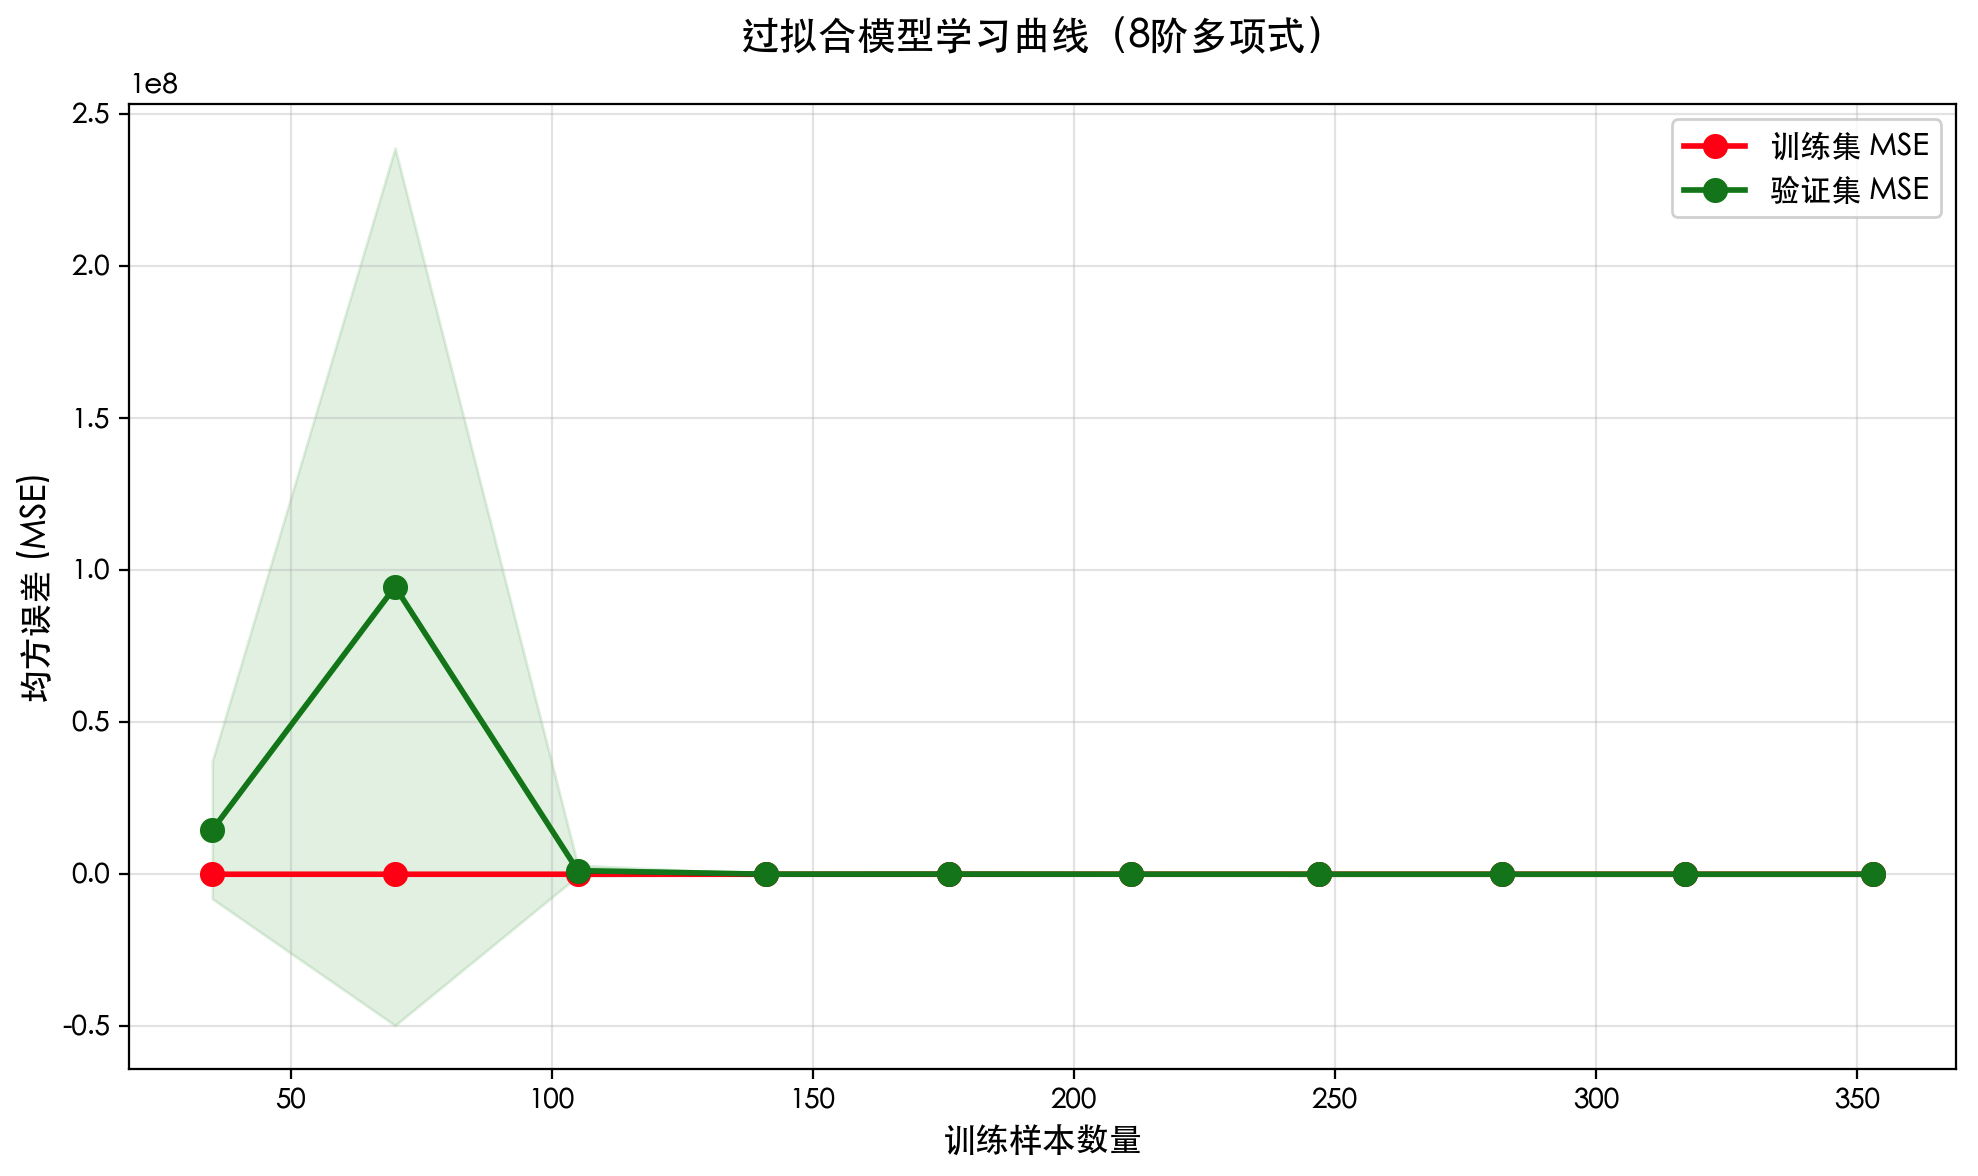
1. Метод диагностики: кривые обучения
Кривая обучения отображает производительность модели (например, ошибку) наобучающем набореивалидационном наборев зависимости отколичества обучающих примеровилисложности модели.
Пример
import matplotlib.pyplot as plt
from sklearn.datasets import load_diabetes
from sklearn.model_selection import train_test_split
from sklearn.model_selection import learning_curve
from sklearn.pipeline import make_pipeline
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures, StandardScaler
from sklearn.metrics import mean_squared_error
import warnings
warnings.filterwarnings('ignore')
# -------------------------- Начало настройки китайского шрифта --------------------------
plt.rcParams['font.sans-serif'] = [
# Сначала Windows
'SimHei', 'Microsoft YaHei',
# Сначала macOS
'PingFang SC', 'Heiti TC',
# Сначала Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Исправить проблему отображения отрицательных знаков в виде блоков
plt.rcParams['axes.unicode_minus'] = False
# Установить стиль графика
plt.rcParams['figure.figsize'] = (10, 6)
plt.rcParams['axes.grid'] = True
plt.rcParams['grid.alpha'] = 0.3
# -------------------------- Конец настройки китайского шрифта --------------------------
# Загрузить данные
data = load_diabetes()
X, y = data.data, data.target
# Использовать только один признак (лучше для демонстрации полиномиальной регрессии)
X = X[:, np.newaxis, 2] # Выбрать третий признак (BMI)
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Определить функцию построения кривой обучения (оптимизированная версия)
def plot_learning_curve(estimator, title, X, y, cv=5, train_sizes=np.linspace(0.1, 1.0, 10)):
"""
Построить кривую обучения
Параметры:
estimator: оценщик модели
title: заголовок графика
X: данные признаков
y: целевая переменная
cv: количество фолдов кросс-валидации
train_sizes: пропорции обучающих выборок
"""
# Получение данных кривой обучения
train_sizes_abs, train_scores, test_scores = learning_curve(
estimator, X, y, cv=cv, scoring='neg_mean_squared_error',
train_sizes=train_sizes, random_state=42, n_jobs=-1
)
# Вычисление среднего и стандартного отклонения
train_scores_mean = -train_scores.mean(axis=1)
train_scores_std = train_scores.std(axis=1)
test_scores_mean = -test_scores.mean(axis=1)
test_scores_std = -test_scores.std(axis=1)
# Построение кривых обучения
plt.figure(figsize=(10, 6))
plt.fill_between(train_sizes_abs,
train_scores_mean - train_scores_std,
train_scores_mean + train_scores_std,
alpha=0.1, color='r')
plt.fill_between(train_sizes_abs,
test_scores_mean - test_scores_std,
test_scores_mean + test_scores_std,
alpha=0.1, color='g')
# Построение средних кривых
plt.plot(train_sizes_abs, train_scores_mean, 'o-', color='r', linewidth=2,
markersize=8, label='MSE обучающей выборки')
plt.plot(train_sizes_abs, test_scores_mean, 'o-', color='g', linewidth=2,
markersize=8, label='MSE валидационной выборки')
# Задать свойства графика
plt.xlabel('Количество обучающих примеров', fontsize=12)
plt.ylabel('Среднеквадратичная ошибка (MSE)', fontsize=12)
plt.title(title, fontsize=14, pad=20)
plt.legend(loc='upper right', fontsize=11)
plt.tight_layout()
plt.show()
# Вывести производительность модели на тестовом наборе
estimator.fit(X_train, y_train)
y_pred = estimator.predict(X_test)
mse = mean_squared_error(y_test, y_pred)
print(f"{title} - MSE на тестовом наборе: {mse:.2f}")
# 1. Модель с недообучением (полином первой степени - линейная регрессия)
print("="*60)
print("Модель с недообучением (полином первой степени - линейная регрессия)")
print("="*60)
plot_learning_curve(
make_pipeline(StandardScaler(), PolynomialFeatures(1), LinearRegression()),
'Кривая обучения модели с недообучением (полином первой степени)',
X, y
)
# 2. Хорошо подходящая модель (полином 2-й степени)
print("\n" + "="*60)
print("Хорошо подходящая модель (полином 2-й степени)")
print("="*60)
plot_learning_curve(
make_pipeline(StandardScaler(), PolynomialFeatures(2), LinearRegression()),
'Кривая обучения для хорошо подходящей модели (полином 2-й степени)',
X, y
)
# 3. Переобученная модель (полином 8-й степени)
print("\n" + "="*60)
print("Переобученная модель (полином 8-й степени)")
print("="*60)
plot_learning_curve(
make_pipeline(StandardScaler(), PolynomialFeatures(8), LinearRegression()),
'Кривая обучения переобученной модели (полином 8-й степени)',
X, y
)
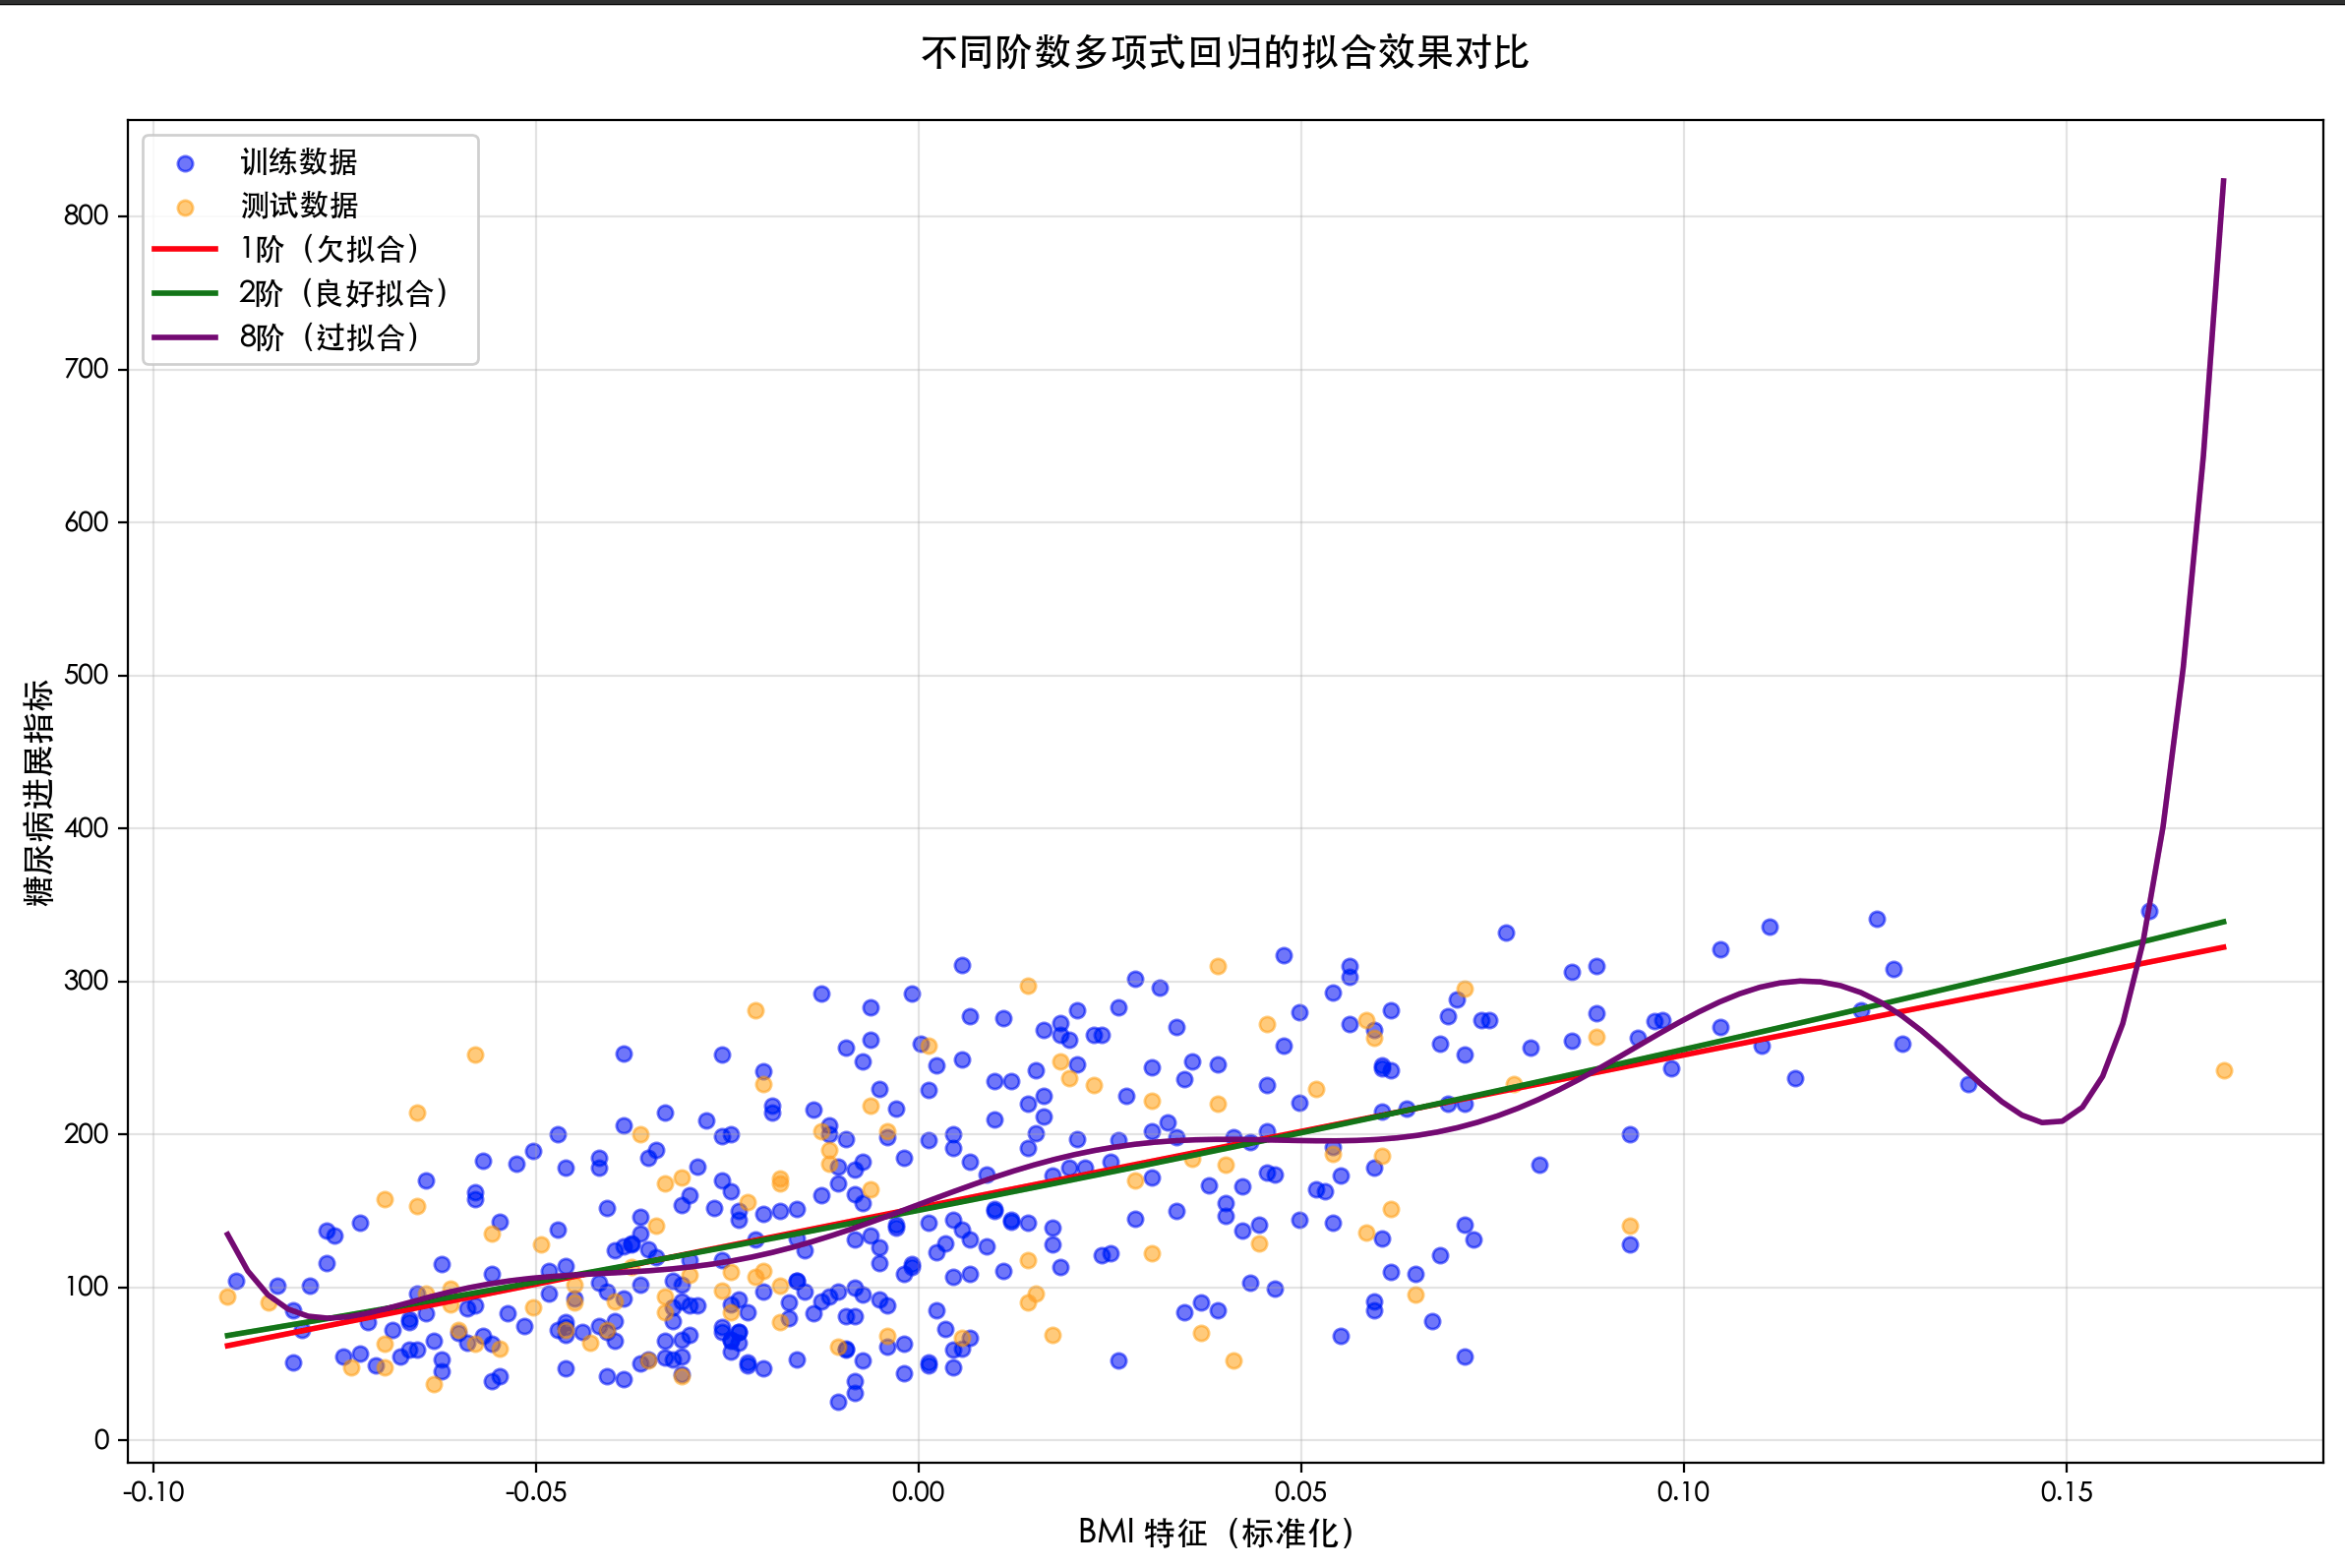
# Дополнительно: визуализировать эффекты подгонки моделей с разными порядками
plt.figure(figsize=(12, 8))
X_plot = np.linspace(X.min(), X.max(), 100).reshape(-1, 1)
# Построить исходные точки данных
plt.scatter(X_train, y_train, alpha=0.5, label='Обучающие данные', color='blue', s=30)
plt.scatter(X_test, y_test, alpha=0.5, label='Тестовые данные', color='orange', s=30)
# Построение кривых аппроксимации для разных порядков
orders = [1, 2, 8]
colors = ['red', 'green', 'purple']
labels = ['1-й порядок (недообучение)', '2-й порядок (хорошая подгонка)', '8-й порядок (переобучение)']
for i, order in enumerate(orders):
model = make_pipeline(StandardScaler(), PolynomialFeatures(order), LinearRegression())
model.fit(X_train, y_train)
y_plot = model.predict(X_plot)
plt.plot(X_plot, y_plot, color=colors[i], linewidth=2, label=labels[i])
plt.xlabel('признак ИМТ (стандартизированный)', fontsize=12)
plt.ylabel('Индекс прогрессирования диабета', fontsize=12)
plt.title('Сравнение эффектов подгонки полиномиальной регрессии с разными порядками', fontsize=14, pad=20)
plt.legend(fontsize=11)
plt.tight_layout()
plt.show()
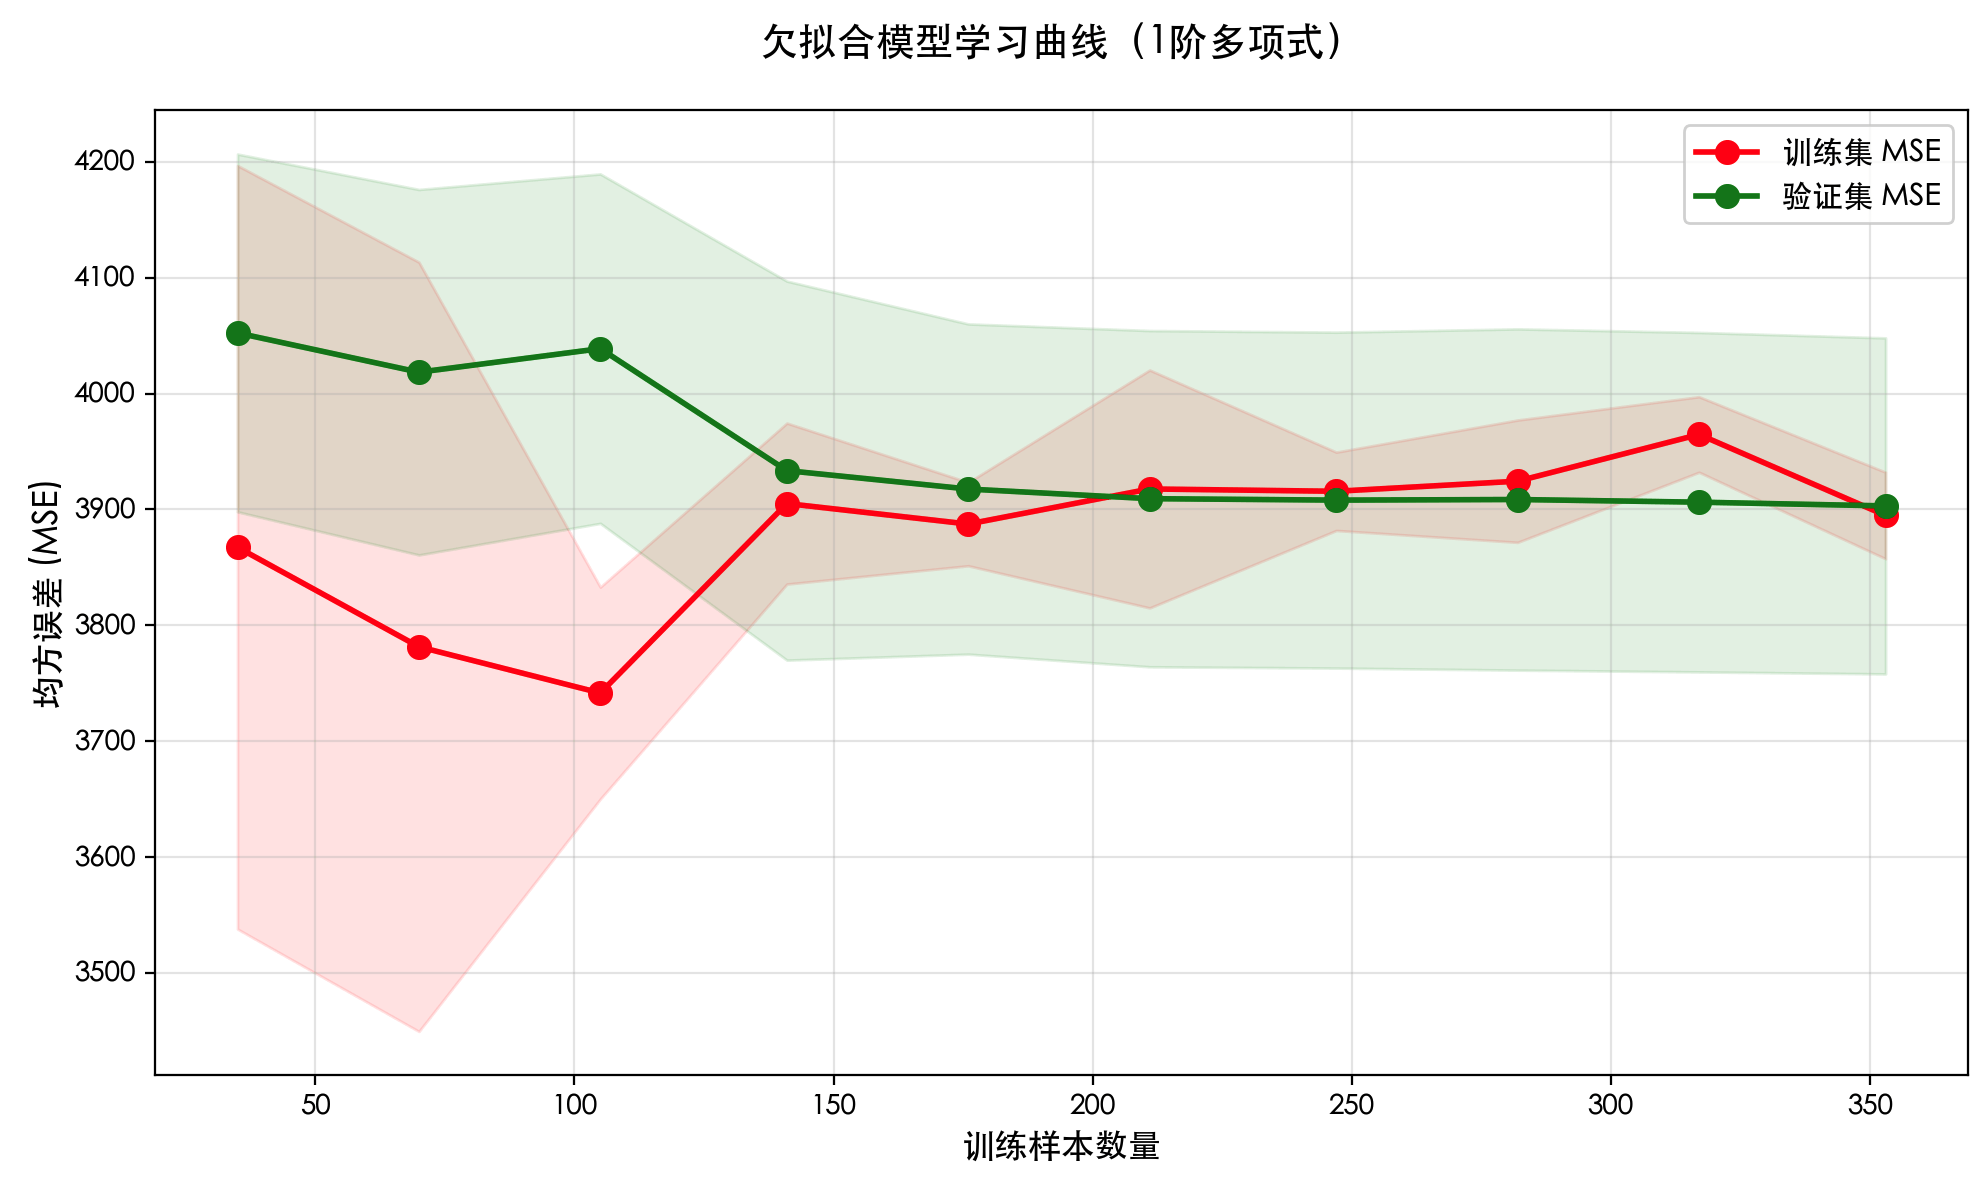
Как интерпретировать кривые обучения?
| Состояние подгонки | Ошибка обучения | Ошибка валидации | Характеристики кривой |
|---|---|---|---|
| Недообучение | Высокая | Высокая | Обе кривые высоки и очень близки; добавление данных не помогает. |
| Хорошая подгонка | Низкая | Низкая | Обе кривые низки и близки друг к другу, достигая точки баланса. |
| Переобучение | Очень низкая | Высокая | Ошибка обучения очень низкая, но ошибка валидации высокая, с заметным разрывом между ними. Добавление данных обычно сближает их. |
2. Контрмеры
По результатам диагностики мы можем применять разные стратегии:
Борьба с недообучением (высокое смещение):
- Увеличьте сложность модели: используйте более мощные модели (например, перейдите от линейных моделей к древовидным моделям, нейронным сетям).
- Добавьте больше признаков: извлекайте или конструируйте более значимые признаки.
- Уменьшите регуляризацию: если используется регуляризация (например, L1, L2), попробуйте ослабить её силу.
- Увеличьте время обучения: для итеративных моделей (например, нейронных сетей) обучайте больше эпох.
Борьба с переобучением (высокая дисперсия):
- Получите больше обучающих данных: один из самых эффективных методов.
- Уменьшите сложность модели: выберите более простую модель (например, меньшую степень полинома, уменьшите глубину дерева, уменьшите число слоёв нейронной сети).
- Отбор признаков: удалите нерелевантные или избыточные признаки.
- Увеличьте регуляризацию:
- L1-регуляризация (Lasso): склонна создавать разреженные веса и может использоваться для отбора признаков.
- L2-регуляризация (Ridge): вызывает затухание весов, стремясь сделать все веса малыми.
- Dropout(для нейронных сетей): Случайно "отключает" часть нейронов во время обучения.
- Early stopping(для итеративных моделей): Остановите обучение, когда ошибка валидации перестаёт уменьшаться.
IV. Практическое занятие: опыт работы с реальными наборами данных
Давайте попрактикуемся на классическом наборе данных о жилье в Бостоне (или на наборе данных по диабету, так как набор данных Boston устарел).
Пример
import matplotlib.pyplot as plt
from sklearn.datasets import load_diabetes
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeRegressor
from sklearn.metrics import mean_squared_error
# -------------------------- Начало настройки китайского шрифта --------------------------
plt.rcParams['font.sans-serif'] = [
# Сначала Windows
'SimHei', 'Microsoft YaHei',
# Сначала macOS
'PingFang SC', 'Heiti TC',
# Сначала Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Исправить проблему отображения отрицательных знаков в виде блоков
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Конец настройки китайского шрифта --------------------------
# Загрузить данные
data = load_diabetes()
X, y = data.data, data.target
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
# Попробуйте деревья решений с разной сложностью
max_depths = [1, 3, 10, None] # None означает отсутствие ограничения глубины; дерево продолжает расти, пока не станет "чистым"
train_errors = []
test_errors = []
for depth in max_depths:
model = DecisionTreeRegressor(max_depth=depth, random_state=42)
model.fit(X_train, y_train)
y_train_pred = model.predict(X_train)
y_test_pred = model.predict(X_test)
train_error = mean_squared_error(y_train, y_train_pred)
test_error = mean_squared_error(y_test, y_test_pred)
train_errors.append(train_error)
test_errors.append(test_error)
print(f"Максимальная глубина дерева: {depth if depth is not None else 'Неограниченная'}")
print(f" MSE на обучающей выборке: {train_error:.2f}")
print(f" MSE на тестовой выборке: {test_error:.2f}")
print("-" * 30)
# Визуализация
plt.figure(figsize=(10, 6))
depths = [str(d) if d else 'Неограниченная' for d in max_depths]
x_index = np.arange(len(depths))
width = 0.35
plt.bar(x_index - width/2, train_errors, width, label='Ошибка на обучающей выборке', color='skyblue')
plt.bar(x_index + width/2, test_errors, width, label='Ошибка на тестовой выборке', color='lightcoral')
plt.xlabel('Максимальная глубина дерева решений (сложность модели)')
plt.ylabel('Среднеквадратичная ошибка (MSE)')
plt.title('Компромисс между смещением и дисперсией: качество работы деревьев решений с разной сложностью')
plt.xticks(x_index, depths)
plt.legend()
plt.grid(True, axis='y')
plt.tight_layout()
plt.show()
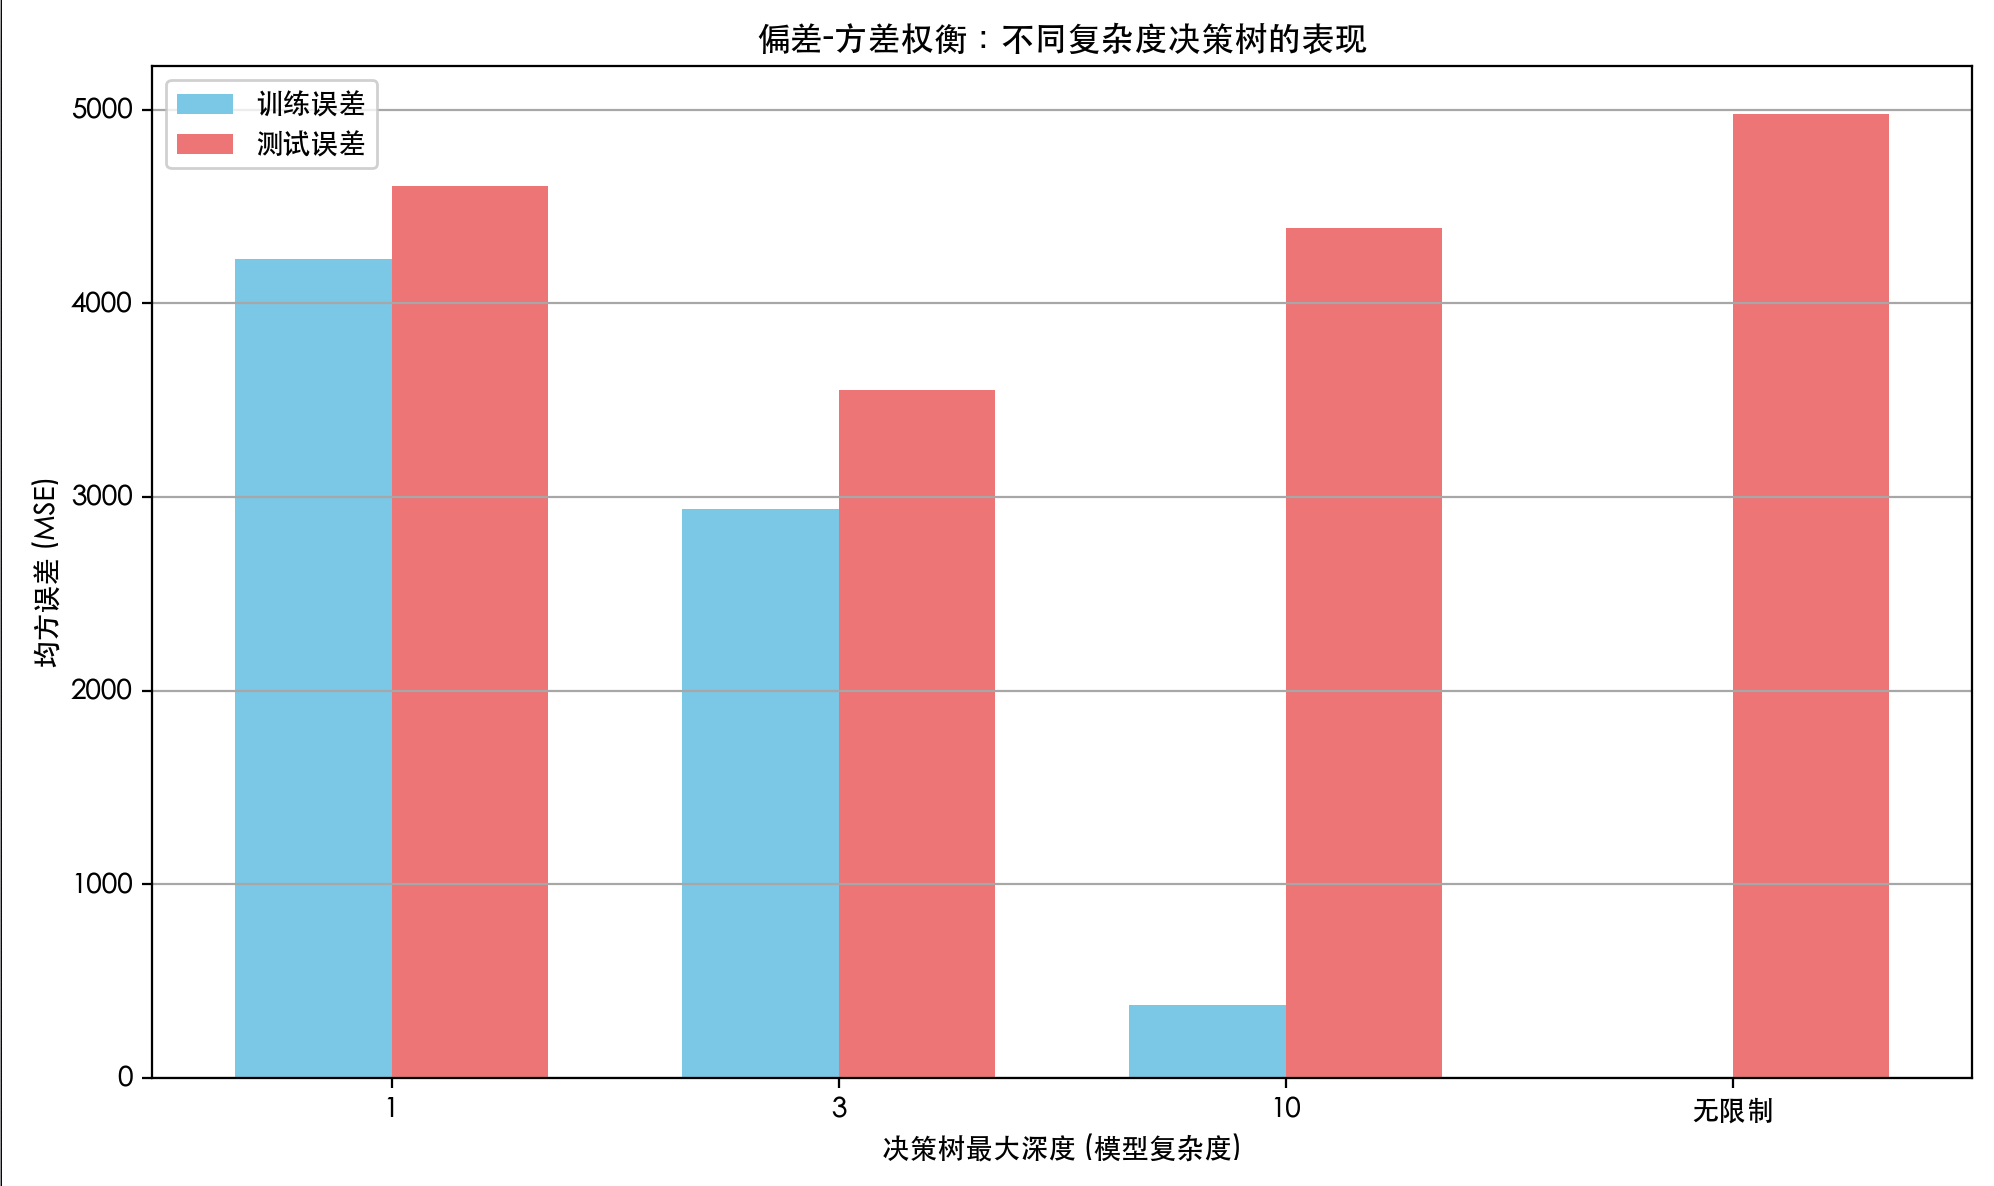
Результаты анализа:
- Depth=1: Модель очень простая, ошибки на обучающей и тестовой выборках высоки ->высокое смещение, недообучение。
- Depth=3: Сложность модели растёт, обе ошибки значительно уменьшаются и относительно близки ->баланс смещения и дисперсии, хорошая подгонка。
- Depth=10 или без ограничений: Модель очень сложная, ошибка на обучающей выборке чрезвычайно низкая, но ошибка на тестовой выборке начинает расти (или намного выше ошибки на обучающей выборке) ->высокая дисперсия, переобучение。
Итог
Понимание переобучения, недообучения, смещения и дисперсии — это краеугольный камень создания превосходных моделей машинного обучения. Запомните этот основной цикл:
- Обучите модель -> Оцените её эффективность на обучающем и валидационном наборах。
- Диагностируйте проблемы с помощью кривых обучения или сравнения ошибок: это высокое смещение (недообучение) или высокая дисперсия (переобучение)?
- Примените соответствующую стратегию(увеличьте сложность/данные, регуляризация и т. д.), чтобы улучшить результат.
- Вернитесь к шагу 1, пока на валидационном наборе не будет получена удовлетворительная модель с сильной способностью к обобщению.