Supuestos y limitaciones
El aprendizaje automático, como fuerza motriz central de la inteligencia artificial, ha logrado avances notables en campos como el reconocimiento de imágenes, el procesamiento del lenguaje natural y los sistemas de recomendación.
Sin embargo, como cualquier herramienta poderosa, el aprendizaje automático no es omnipotente. Su eficacia depende en gran medida de una serie desupuestos fundamentales, y cuando los datos del mundo real o los escenarios de los problemas violan estos supuestos, el rendimiento del modelo se verá gravemente afectado, e incluso se pueden obtener conclusiones completamente erróneas.
Comprender estas limitaciones y fronteras, especialmente lossupuestos y limitacionesque las respaldan, es crucial para aplicar el aprendizaje automático de manera correcta y segura. Esto no solo nos ayuda a evitar trampas, sino que también nos guía para elegir modelos más adecuados o mejorar los datos, construyendo así sistemas inteligentes más robustos y confiables.
Supuesto de independencia e idéntica distribución
Este es uno de los supuestos más centrales del aprendizaje supervisado.
Conceptos básicos
Las muestras de datos utilizadas para entrenar el modelo y aquellas que el modelo predecirá en el futuro se extraende la mismadistribución de probabilidadde manera independiente.
- Independencia: la aparición de una muestra de datos no afecta la probabilidad de que aparezca otra muestra de datos.
- Misma distribución: todos los datos (conjunto de entrenamiento, conjunto de validación, conjunto de prueba y futuros datos reales) siguen la misma ley subyacente de generación de datos.
Por qué es importante
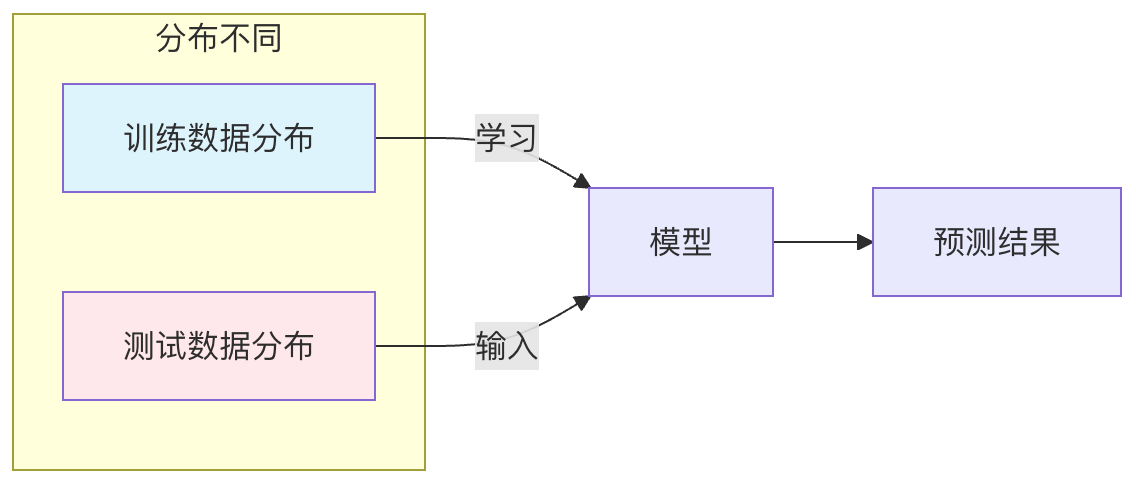
La esencia de un modelo de aprendizaje automático es aprender la ley subyacente de distribución de datos mediante el análisis de los datos de entrenamiento. Si los datos de entrenamiento y los de prueba provienen de distribuciones diferentes, significa que la ley aprendida por el modelo no se aplica al escenario de prueba y sus predicciones no serán fiables.
Consecuencias y ejemplos de la violación del supuesto
Cuando este supuesto se rompe, ocurre el problema dedesplazamiento de distribución, que principalmente incluye los siguientes tipos:
Desplazamiento de covariables
- Descripción: las características de entrada
Xcambian su distribución, pero la relación entre entradaXy salidaY(es decir, la distribución condicionalP(Y|X)) permanece sin cambios. - Ejemplo: se entrenó un clasificador de perros y gatos con un conjunto de datos de imágenes nítidas tomadas durante el día, y luego se utilizó para reconocer imágenes borrosas tomadas de noche. Aquí, la nitidez y la iluminación de las imágenes (características
X) han cambiado drásticamente en su distribución, pero las características visuales de "gatos" y "perros" en sí (relaciónP(Y|X)) no han cambiado. El modelo puede tener un mal rendimiento porque no está familiarizado con las características borrosas nocturnas.
Desplazamiento de etiquetas
- Descripción: las etiquetas de salida
Ycambian su distribución, pero dada una etiqueta, la distribución de las características de entradaP(X|Y)permanece sin cambios. - Ejemplo: se entrenó un modelo de diagnóstico de enfermedades con un conjunto de datos donde el 99% eran personas sanas y el 1% personas enfermas. En otra región, la prevalencia de la enfermedad puede aumentar al 10%. Aunque para las personas realmente enfermas, sus síntomas (
P(X|Y=患病)) son similares, el modelo ha visto muy pocas muestras de "enfermos" anteriormente, por lo que puede subestimar gravemente la probabilidad de enfermedad en los nuevos datos.
Desplazamiento conceptual
- Descripción: la relación de mapeo entre entrada
Xy salidaYen sí misma ha cambiado con el tiempo o el entorno. - Ejemplo: un modelo de predicción del precio de las acciones. Las leyes del mercado que afectan el precio de las acciones (
P(Y|X)) son dinámicas y cambiantes; un modelo entrenado con datos de los últimos diez años puede no predecir con precisión la evolución futura del precio de las acciones bajo políticas económicas completamente nuevas.
Supuesto de representatividad de los datos de entrenamiento
Este supuesto requiere queel conjunto de datos de entrenamiento represente adecuadamente todo el espacio de datos que el modelo pueda encontrar.。
Conceptos básicos
El modelo solo puede aprender de los datos que ha "visto". Si a los datos de entrenamiento les faltan ciertos escenarios, categorías o rangos de características importantes, el modelo no sabrá qué hacer al enfrentarse a estas situaciones "no vistas".
Consecuencias y ejemplos de la violación del supuesto
Esto conduce directamente a problemas demala capacidad de generalizaciónyy sesgo.
Cobertura de datos incompleta
- Ejemplo: si el conjunto de datos utilizado para entrenar el modelo de percepción de vehículos autónomos carece de imágenes en condiciones climáticas extremas como lluvias torrenciales o nevadas intensas, la capacidad del modelo para reconocer peatones y vehículos disminuirá significativamente, e incluso fallará, cuando se enfrente a este tipo de clima.
Sesgo de selección de muestras
- Descripción: la forma de recopilar datos excluye sistemáticamente a ciertos grupos.
- Ejemplo: si los datos de entrenamiento de un sistema de reconocimiento facial provienen principalmente de adultos de un tono de piel y grupo de edad específicos, su precisión será notablemente menor al reconocer a niños, ancianos o personas de otros tonos de piel. Esto no se debe a que el modelo sea "malo", sino a que no ha tenido la oportunidad de aprender las características de estos grupos.
Supuesto de estacionariedad
Este supuesto se aplica principalmente a datos de series temporales y requiere quelas propiedades estadísticas básicas de los datos (como la media y la varianza) no cambien con el tiempo.。
Conceptos básicos
Muchos modelos clásicos de series temporales (como ARIMA) o modelos de aprendizaje automático aplicados a datos secuenciales asumen implícitamente que el proceso de generación de datos es estacionario, o que puede volverse estacionario mediante métodos como la diferenciación.
Por qué es importante
Las tendencias o la estacionalidad en datos no estacionarios dominan el proceso de aprendizaje del modelo, haciendo que este capture estas pseudo-pautas que cambian con el tiempo en lugar de las verdaderas relaciones intrínsecas, lo que conduce a malas predicciones futuras.
Consecuencias y ejemplos de la violación del supuesto
- Ejemplo: predecir las ventas mensuales de helado. Los datos muestran una clara tendencia ascendente (posiblemente debido al crecimiento de la empresa) y picos en verano. Si se modela directamente con datos no estacionarios, el modelo puede simplemente predecir que el próximo mes será más alto que el actual, sin poder distinguir con precisión entre la tendencia a largo plazo, los efectos estacionales y las fluctuaciones aleatorias reales. Una vez que el mercado se satura (cambio de tendencia), las predicciones serán completamente erróneas.
Supuesto de existencia de correlación entre características y etiquetas
Este supuesto es lapremisa fundamentalpara que el aprendizaje automático funcione: las características que proporcionamosXdeben tener, con las etiquetas que queremos predecir,Yalgún tipo de correlación que el modelo pueda aprender.
Conceptos básicos
La tarea del modelo de aprendizaje automático es descubrirXyYel patrón de asociación entre ellas. Si ambas no están relacionadas en esencia, ningún modelo podrá hacer una predicción mejor que una suposición aleatoria.
Consecuencias y ejemplos de la violación del supuesto
- Ejemplo: intentar predecir si el mercado de valores subirá o bajará mañana usando el color de una taza de café. Entre estas dos variables prácticamente no existe ninguna relación causal significativa ni asociación estadística estable, por lo que, sin importar qué modelo avanzado se utilice, el resultado no será válido.
Ejercicio práctico: diagnostica tu problema
Antes de iniciar un proyecto de aprendizaje automático, reflexiona sobre la siguiente lista de preguntas para evaluar los posibles riesgos derivados de los supuestos y limitaciones:
- Consistencia de la fuente de datos: mis datos de entrenamiento (datos históricos) y los datos del escenario de aplicación futura, ¿se generaron en las mismas condiciones? ¿Existen diferencias de entorno, tiempo o grupo que no se hayan considerado?
- Verificación de integridad de los datos: mi conjunto de entrenamiento, ¿incluye todas las categorías importantes y casos extremos posibles? ¿El proceso de recopilación de datos tiene omisiones sistemáticas?
- Racionalidad de la relación: las características que elegí, desde la lógica empresarial o el sentido común, ¿están realmente relacionadas con el objetivo de predicción?
- Evaluación de estabilidad: si mis datos son una serie temporal, ¿sus propiedades estadísticas (como la media) fluctúan drásticamente con el tiempo?
Resumen
Reconocer los supuestos y limitaciones del aprendizaje automático no es negar su valor, sino utilizarlo de manera máscientíficay másresponsable. En la práctica, casi no existen supuestos absolutamente perfectos. Nuestro objetivo es, mediantepreprocesamiento de datos(como aumento de datos, remuestreo),selección de algoritmos(como algoritmos robustos al desplazamiento de distribución) ymonitoreo y evaluación continuos del modelo, mitigar en la medida de lo posible el impacto causado por la violación de estos supuestos.
Un buen profesional del aprendizaje automático no es solo un experto en ajuste de hiperparámetros, sino también un detective de datos que comprende profundamente los datos, los problemas y los límites de los modelos. Comprender estas limitaciones es el camino obligatorio para pasar de principiante a experto.
Otras extensiones