Ограничения предположений
Как основная движущая сила искусственного интеллекта, машинное обучение достигло значительных успехов в таких областях, как распознавание изображений, обработка естественного языка и рекомендательные системы.
Однако, как и любой мощный инструмент, машинное обучение не является панацеей. Его эффективность в значительной степени зависит от рядафундаментальных предположений. Когда реальные данные или сценарии задач нарушают эти предположения, производительность модели сильно страдает или даже приводит к совершенно неверным выводам.
Понимание этих ограничений и границ, особенноограничений допущений, лежащих в их основе, имеет решающее значение для правильного и безопасного применения машинного обучения. Это не только помогает нам избегать подводных камней, но и направляет нас при выборе более подходящих моделей или улучшении данных, тем самым создавая более надёжные и заслуживающие доверия интеллектуальные системы.
Допущение о независимости и одинаковом распределении (IID)
Это одно из наиболее фундаментальных допущений в обучении с учителем.
Базовые понятия
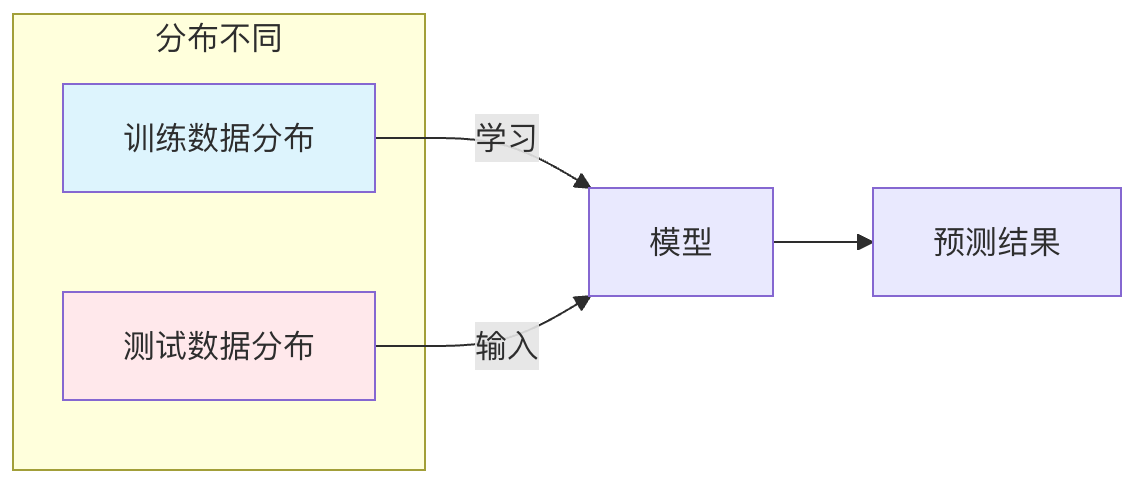
Допущение IID гласит: выборки данных, которые мы используем для обучения модели, и выборки данных, которые модель будет предсказывать в будущем,из одного и того жевероятностного распределениянезависимоизвлечены.
- НезависимостьПоявление одной выборки данных не влияет на вероятность появления другой выборки данных.
- Одинаковое распределениеВсе данные (обучающая выборка, валидационная выборка, тестовая выборка и будущие реальные данные) подчиняются одному и тому же базовому правилу генерации данных.
Почему это важно
Суть модели машинного обучения состоит в том, чтобы изучить лежащее в основе правило распределения данных путём анализа обучающих данных. Если обучающие данные и тестовые данные происходят из разных распределений, это означает, что правила, изученные моделью, не применимы к тестовому сценарию, и её результаты предсказаний будут ненадёжными.
Последствия и примеры нарушения допущений
Когда это допущение нарушается, возникает проблемасдвига распределения, в основном следующих типов:
Ковариационный сдвиг
- Описание: Входные признаки
Xизменились в распределении, но связь между входомXи выходомY(т.е. условное распределениеP(Y|X)) остаётся неизменным. - Пример: Классификатор кошек и собак был обучен на наборе данных чётких изображений, снятых днём, а затем использовался для распознавания размытых изображений, снятых ночью. Здесь распределение чёткости и освещённости изображений (признаки
X) резко изменилось, но визуальные признаки самих "кошек" и "собак" (связьP(Y|X)) не изменилась. Модель может работать плохо, потому что она незнакома с размытыми ночными признаками.
Сдвиг меток
- Описание: Выходные метки
Yизменились в распределении, но при заданной метке распределение входных признаковP(X|Y)остаётся неизменной. - Пример: Модель диагностики заболеваний была обучена на наборе данных, где здоровые люди составляют 99%, а больные — 1%. В другом регионе распространённость заболевания может вырасти до 10%. Хотя у действительно больных людей их симптомы (
P(X|Y=患病)) похожи, модель видела слишком мало "больных" образцов раньше и может сильно недооценивать вероятность заболевания на новых данных.
Сдвиг концепции
- Описание: Соотношение отображения между входными данными
Xи выходомYсамо изменяется со временем или в зависимости от среды. - Пример: Модель прогнозирования цен на акции. Рыночные правила, влияющие на цены акций (
P(Y|X)) динамичны и меняются со временем. Модель, обученная на данных за последнее десятилетие, может неточно предсказывать будущие тенденции цен на акции в условиях совершенно новой экономической политики.
Предположение о репрезентативности обучающих данных
Это предположение требует, чтобыобучающий набор данных полностью представлял всё пространство данных, с которым может столкнуться модель.。
Базовые понятия
Модель может учиться только на данных, которые она «видела». Если в обучающих данных отсутствуют некоторые важные сценарии, категории или диапазоны признаков, модель будет в замешательстве при столкновении с такими «невиданными» ситуациями.
Последствия и примеры нарушения допущений
Это напрямую приводит кплохой обобщающей способностиии смещениюпроблемам.
Неполный охват данных
- Пример: В наборе данных, используемом для обучения модели восприятия автономного вождения, если отсутствуют изображения экстремальных погодных условий, таких как сильный дождь и сильный снег, то, когда модель сталкивается с такой погодой, её способность распознавать пешеходов и транспортные средства значительно снижается или даже отказывает.
Смещение при отборе выборки
- Описание: Метод сбора данных систематически исключает определённые группы.
- Пример: Если обучающие данные системы распознавания лиц в основном поступают от взрослых с определёнными оттенками кожи и из определённых возрастных групп, её точность будет значительно ниже при распознавании детей, пожилых людей или людей с другими оттенками кожи. Это не потому, что модель «плохая», а потому, что у неё не было возможности изучить признаки этих групп.
Предположение о стационарности
Это предположение в основном касается данных временных рядов и требует, чтобыосновные статистические свойства данных (такие как среднее и дисперсия) не изменялись со временем.。
Базовые понятия
Многие классические модели временных рядов (такие как ARIMA) или модели машинного обучения, применяемые к последовательностным данным, неявно предполагают, что процесс порождения данных стационарен или может быть сделан стационарным с помощью таких методов, как взятие разностей.
Почему это важно
Тренды или сезонность в нестационарных данных доминируют в процессе обучения модели, из-за чего модель улавливает эти ложные закономерности, меняющиеся со временем, а не истинные внутренние взаимосвязи, и поэтому даёт плохие прогнозы на будущее.
Последствия и примеры нарушения допущений
- Пример: Прогнозирование месячных продаж мороженого. Данные показывают явный восходящий тренд (возможно, из-за роста компании) и летние пики. Если нестационарные данные используются непосредственно для моделирования, модель может просто предсказать, что в следующем месяце продажи будут выше, чем в этом месяце, не имея возможности точно различить долгосрочные тренды, сезонные эффекты и истинные случайные колебания. Как только рынок насытится (тренд изменится), прогнозы окажутся совершенно неверными.
Предположение о корреляции между признаками и метками
Это предположение — то, что позволяет машинному обучению работать —фундаментальное предварительное условие:признаки, которые мы предоставляемXдолжны иметь некоторую корреляцию с метками, которые мы хотим предсказатьYкоторую модель может изучить.
Базовые понятия
Задача модели машинного обучения — обнаружитьXиYэтой закономерности связи между ними. Если две переменные по сути не связаны, никакая модель не сможет делать прогнозы лучше случайного угадывания.
Последствия и примеры нарушения допущений
- Пример: Попытка использовать цвет кофейной чашки, чтобы предсказать, вырастет или упадёт фондовый рынок завтра. Между этими двумя переменными почти нет значимой причинно-следственной связи или стабильной статистической ассоциации, поэтому независимо от того, какая продвинутая модель используется, результаты недействительны.
Практическое упражнение: диагностика вашей проблемы
Перед началом проекта машинного обучения, пожалуйста, сначала рассмотрите следующий контрольный список вопросов, чтобы оценить потенциальные риски ограничений предположений:
- Согласованность источников данных: Были ли мои обучающие данные (исторические данные) и данные будущего сценария применения получены в одинаковых условиях? Есть ли неучтённые различия среды, времени или групп?
- Проверка полноты данных: Содержит ли мой обучающий набор все возможные важные категории и крайние случаи? Есть ли систематические пропуски в процессе сбора данных?
- Разумность взаимосвязи: С точки зрения бизнес-логики или здравого смысла, действительно ли выбранные мной признаки связаны с целью прогнозирования?
- Оценка стабильности: Если мои данные — временной ряд, сильно ли колеблются его статистические свойства (например, среднее) во времени?
Итог
Признание ограничений предположений машинного обучения — не для того, чтобы отрицать его ценность, а чтобы использовать егоболее научноиболее ответственно. В практических приложениях абсолютно идеальных предположений почти не существует. Наша цель — посредствомпредварительной обработки данных(например, дополнения данных, пересэмплирования),выбора алгоритма(например, алгоритмов, устойчивых к сдвигу распределения), инепрерывного мониторинга и оценки модели,чтобы как можно сильнее смягчить влияние этих нарушений предположений.
Выдающийся специалист по машинному обучению — это не только мастер настройки параметров, но и детектив данных, который глубоко понимает границы данных, задач и моделей. Понимание этих ограничений — необходимый путь от новичка к мастерству.
Другие расширения