Limites des hypothèses
En tant que force motrice centrale de l'intelligence artificielle, l'apprentissage automatique a accompli des réalisations remarquables dans des domaines tels que la reconnaissance d'images, le traitement du langage naturel et les systèmes de recommandation.
Cependant, comme tout outil puissant, l'apprentissage automatique n'est pas une panacée. Son efficacité dépend dans une large mesure d'une série dehypothèses fondamentales. Lorsque des données du monde réel ou des scénarios de problème violent ces hypothèses, les performances du modèle seront grandement compromises, voire aboutiront à des conclusions complètement erronées.
Comprendre ces limitations et ces frontières, en particulier leslimites des hypothèsesqui les sous-tendent, est crucial pour appliquer correctement et en toute sécurité l'apprentissage automatique. Cela nous aide non seulement à éviter les pièges, mais nous guide aussi dans le choix de modèles plus appropriés ou dans l'amélioration des données, construisant ainsi des systèmes intelligents plus robustes et dignes de confiance.
Hypothèse d'indépendance et d'identité de distribution (IID)
C'est l'une des hypothèses les plus fondamentales de l'apprentissage supervisé.
Concepts de base
L'hypothèse IID stipule que : les échantillons de données que nous utilisons pour entraîner le modèle et les échantillons de données que le modèle prédira à l'avenir sontissus de la mêmedistribution de probabilité et sontindépendammenttirés.
- IndépendanceL'occurrence d'un échantillon de données n'affecte pas la probabilité qu'un autre échantillon de données se produise.
- Distribution identiqueToutes les données (ensemble d'entraînement, ensemble de validation, ensemble de test et futures données réelles) suivent la même règle sous-jacente de génération des données.
Pourquoi c'est important
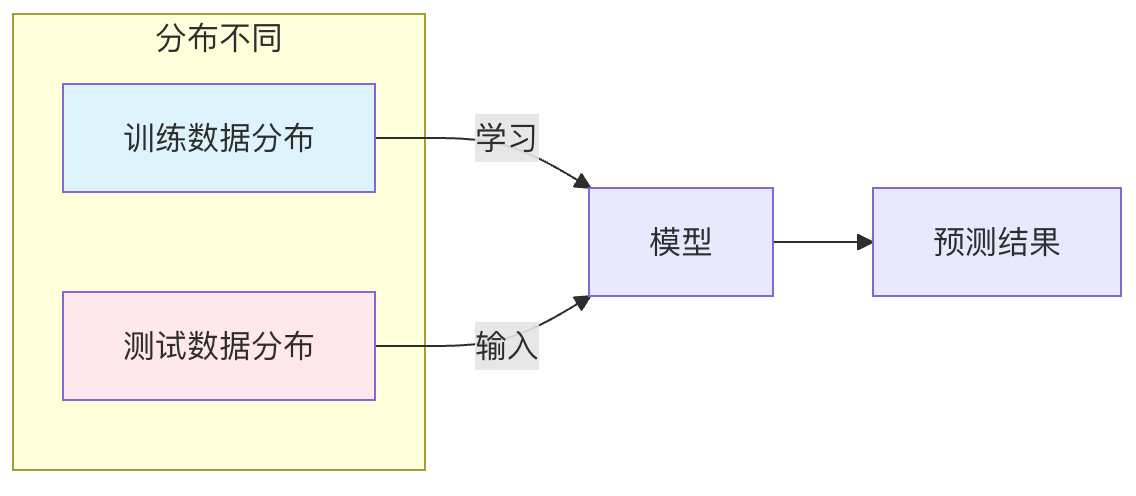
L'essence d'un modèle d'apprentissage automatique est d'apprendre la règle sous-jacente de distribution des données en analysant les données d'entraînement. Si les données d'entraînement et de test proviennent de distributions différentes, cela signifie que les règles apprises par le modèle ne s'appliquent pas au scénario de test, et ses résultats de prédiction seront peu fiables.
Conséquences et exemples de violations d'hypothèses
Lorsque cette hypothèse est violée, un problème dedécalage de distributionse produit, principalement dans les types suivants :
Décalage de covariables
- Description: Les caractéristiques d'entrée
Xont changé de distribution, mais la relation entre l'entréeXet la sortieY(c'est-à-dire la distribution conditionnelleP(Y|X)) reste inchangée. - Exemple: Un classifieur de chats et de chiens a été entraîné sur un jeu de données d'images nettes prises pendant la journée, puis utilisé pour reconnaître des images floues prises la nuit. Ici, la distribution de la netteté et de l'éclairage des images (caractéristiques
X) a changé de façon spectaculaire, mais les caractéristiques visuelles des « chats » et des « chiens » eux-mêmes (la relationP(Y|X)) n'a pas changé. Le modèle peut donner de mauvais résultats parce qu'il n'est pas familier avec les caractéristiques floues nocturnes.
Décalage d'étiquettes
- Description: Les étiquettes de sortie
Yont changé de distribution, mais étant donné l'étiquette, la distribution des caractéristiques d'entréeP(X|Y)reste inchangée. - Exemple: Un modèle de diagnostic de maladie a été entraîné sur un jeu de données où les personnes saines représentent 99 % et les personnes malades représentent 1 %. Dans une autre région, la prévalence de la maladie peut atteindre 10 %. Bien que, chez les personnes réellement malades, leurs symptômes (
P(X|Y=患病)) soient similaires, le modèle a vu trop peu d'échantillons « malades » auparavant, et peut gravement sous-estimer la probabilité de maladie dans de nouvelles données.
Changement de concept
- Description: La relation de correspondance entre l'entrée
Xet la sortieYelle-même change au fil du temps ou selon l'environnement. - Exemple: Modèle de prédiction du cours des actions. Les règles de marché affectant les cours des actions (
P(Y|X)) sont dynamiques et évoluent au fil du temps. Un modèle entraîné sur les données de la dernière décennie peut ne pas prédire avec précision les tendances futures du cours des actions dans le cadre de politiques économiques entièrement nouvelles.
Hypothèse de représentativité des données d'entraînement
Cette hypothèse exige quel'ensemble de données d'entraînement représente pleinement tout l'espace de données que le modèle peut rencontrer.。
Concepts de base
Un modèle ne peut apprendre qu'à partir des données qu'il a « vues ». Si les données d'entraînement manquent de certains scénarios, catégories ou plages de caractéristiques importants, le modèle sera en difficulté face à ces situations « non vues ».
Conséquences et exemples de violations d'hypothèses
Cela conduit directement àune mauvaise capacité de généralisationetet des problèmes de biais.
Couverture incomplète des données
- Exemple: Dans l'ensemble de données utilisé pour entraîner un modèle de perception de conduite autonome, si des images de conditions météorologiques extrêmes telles que de fortes pluies et de fortes neiges sont manquantes, alors lorsque le modèle rencontre de telles conditions météorologiques, sa capacité à reconnaître les piétons et les véhicules diminuera considérablement, voire échouera.
Biais de sélection d'échantillon
- Description: La méthode de collecte des données exclut systématiquement certains groupes.
- Exemple: Si les données d'entraînement d'un système de reconnaissance faciale proviennent principalement d'adultes de teints et de groupes d'âge spécifiques, sa précision sera nettement plus faible lors de la reconnaissance d'enfants, de personnes âgées ou de personnes d'autres teints. Ce n'est pas parce que le modèle est « mauvais », mais parce qu'il n'a pas eu l'occasion d'apprendre les caractéristiques de ces groupes.
Hypothèse de stationnarité
Cette hypothèse concerne principalement les données de séries temporelles et exige queles propriétés statistiques de base des données (telles que la moyenne et la variance) ne changent pas au fil du temps.。
Concepts de base
De nombreux modèles classiques de séries temporelles (tels que ARIMA) ou modèles d'apprentissage automatique appliqués à des données de séquence supposent implicitement que le processus de génération des données est stationnaire, ou peut être rendu stationnaire par des méthodes telles que la différenciation.
Pourquoi c'est important
Les tendances ou la saisonnalité dans les données non stationnaires dominent le processus d'apprentissage du modèle, ce qui amène le modèle à capturer ces motifs fallacieux qui évoluent dans le temps plutôt que de véritables relations intrinsèques, ce qui conduit à de mauvaises prédictions sur l'avenir.
Conséquences et exemples de violations d'hypothèses
- Exemple: Prédire les ventes mensuelles de glaces. Les données montrent une nette tendance à la hausse (peut-être due à la croissance de l'entreprise) et des pics estivaux. Si des données non stationnaires sont utilisées directement pour la modélisation, le modèle peut simplement prédire que le mois prochain sera plus élevé que ce mois-ci, sans pouvoir distinguer précisément les tendances à long terme, les effets saisonniers et les véritables fluctuations aléatoires. Une fois le marché saturé (la tendance change), les prédictions seront complètement fausses.
Hypothèse de corrélation entre les caractéristiques et les étiquettes
C'est cette hypothèse qui permet à l'apprentissage automatique de fonctionner — lacondition préalable fondamentale :les caractéristiques que nous fournissonsXdoivent avoir une certaine corrélation avec les étiquettes que nous voulons prédireYqui peut être apprise par le modèle.
Concepts de base
La tâche d'un modèle d'apprentissage automatique est de découvrirXetYce schéma d'association entre eux. Si les deux sont essentiellement sans lien, aucun modèle ne peut faire des prédictions meilleures qu'une devinette aléatoire.
Conséquences et exemples de violations d'hypothèses
- Exemple: Essayer d'utiliser la couleur d'une tasse à café pour prédire si le marché boursier montera ou baissera demain. Il n'existe presque aucune relation causale significative ni association statistique stable entre ces deux variables, donc quel que soit le modèle avancé utilisé, les résultats sont invalides.
Exercice pratique : Diagnostiquez votre problème
Avant de commencer un projet d'apprentissage automatique, veuillez d'abord examiner la liste de questions suivante afin d'évaluer les risques potentiels de limitation des hypothèses :
- Cohérence des sources de données: Mes données d'entraînement (données historiques) et les données du scénario d'application futur ont-elles été produites dans les mêmes conditions ? Y a-t-il des différences environnementales, temporelles ou de groupe non prises en compte ?
- Vérification de l'exhaustivité des données: Mon ensemble d'entraînement contient-il toutes les catégories importantes possibles et tous les cas limites ? Y a-t-il des omissions systématiques dans le processus de collecte des données ?
- Caractère raisonnable de la relation: Du point de vue de la logique métier ou du bon sens, les caractéristiques que j'ai sélectionnées sont-elles réellement liées à la cible de prédiction ?
- Évaluation de la stabilité: Si mes données sont une série temporelle, ses propriétés statistiques (comme la moyenne) fluctuent-elles fortement au fil du temps ?
Résumé
Reconnaître les limites des hypothèses de l'apprentissage automatique ne consiste pas à nier sa valeur, mais à l'utiliserde manière plus scientifiqueetde manière plus responsable. Dans les applications pratiques, des hypothèses absolument parfaites n'existent presque jamais. Notre objectif est, par le biais dele prétraitement des données(comme l'augmentation des données, le rééchantillonnage),la sélection d'algorithmes(comme les algorithmes robustes au décalage de distribution), etla surveillance et l'évaluation continues du modèle,pour atténuer autant que possible l'impact de ces violations d'hypothèses.
Un excellent praticien de l'apprentissage automatique n'est pas seulement un maître du réglage des paramètres, mais aussi un détective des données qui comprend profondément les limites des données, des problèmes et des modèles. Comprendre ces limitations est le chemin nécessaire pour passer de débutant à expert.
Autres extensions