Обучение без учителя - Снижение размерности
Представьте, что вы фотограф, который организует библиотеку, содержащую миллионы фотографий высокого разрешения. Каждая фотография состоит из миллионов пикселей (признаков). Если вы хотите быстро найти все фотографии закатов у моря, прямое сравнение каждого пикселя каждой фотографии почти невозможно, потому что данные слишком большие и слишком «жирные».
В машинном обучении мы часто сталкиваемся с похожей дилеммой: наборы данных имеют сотни или тысячи признаков (размерностей). Это не только приводит к чрезвычайно медленным вычислениям (проклятие размерности), но и, поскольку многие признаки избыточны или нерелевантны, может мешать нам находить истинные закономерности в данных.
Снижение размерности — это ключевая техника в обучении без учителя. Она действует как фитнес-тренер для данных, помогая нам ужать многомерные данные в пространство меньшей размерности, сохраняя при этом самую важную информацию по мере возможности. Сегодня давайте изучим снижение размерности просто и основательно.Основные понятия снижения размерности
Основные понятия снижения размерности
Что такое снижение размерности?
снижение размерности — это процесс уменьшения числа признаков в наборе данных.Оно использует математическое преобразование для отображения точек данных из исходного многомерного пространства в новое пространство с меньшей размерностью.Зачем выполнять снижение размерности?
Зачем снижать размерность?
Визуализация
- : Люди могут интуитивно понимать не более чем трёхмерное пространство. Снижая размерность до 2D или 3D, мы можем построить график многомерных данных и интуитивно наблюдать их структуру, группы и выбросы.Повышение эффективности
- : Меньшее число измерений данных означает меньше места для хранения, более высокую скорость обучения и более низкие вычислительные затраты.Удаление шума и избыточности
- : Многие алгоритмы (особенно алгоритмы вычисления расстояний, такие как KNN) страдают от снижения производительности в многомерном пространстве из-за нерелевантных или дублирующихся признаков. Снижение размерности позволяет выделить суть данных.Смягчение проклятия размерности
- : В многомерном пространстве данные становятся чрезвычайно разреженными, из-за чего многим моделям машинного обучения трудно находить эффективные закономерности.Ключевая идея: сохранение информации
Ключевая идея: сохранение информации
Как снизить размерность, максимально сохраняя ценную информацию в исходных данных (например, дисперсию и структуру данных)?Разные алгоритмы снижения размерности дают на это разные ответы.Подробное объяснение основных алгоритмов снижения размерности
Подробное объяснение основных алгоритмов снижения размерности
Линейное снижение размерностиНелинейное снижение размерностииЛинейное снижение размерности: метод главных компонент。
Линейное снижение размерности: метод главных компонент
Как работает PCA (четыре шага):Центрирование
: Вычтите среднее значение каждого признака, чтобы центр распределения данных переместился в начало системы координат.
- Вычислите ковариационную матрицу: Эта матрица описывает корреляции между различными признаками данных.
- Разложение по собственным значениям: Вычислите собственные значения и собственные векторы ковариационной матрицы.
- Собственные векторыуказывают направления новых осей координат (главных компонент),а собственные значенияпредставляют дисперсию данных вдоль этого направления. Чем больше собственное значение, тем больше информации содержит это направление.Выбор главных компонент: Отсортируйте собственные значения от наибольшего к наименьшему и выберите верхние
- собственные векторы, соответствующие наибольшим собственным значениям, чтобы сформировать матрицу проекции.Преобразование данных
k: Умножьте исходные данные на эту матрицу проекции, чтобы получить данные, уменьшенные до - размерности.Пример
k# Импорт необходимых библиотек
Пример
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.datasets import load_iris
# Сначала macOS
plt.rcParams['font.sans-serif'] = [
# Сначала Linux
'SimHei', 'Microsoft YaHei',
# Исправление проблемы, когда знаки минуса отображаются в виде квадратов
'PingFang SC', 'Heiti TC',
# -------------------------- Конец настройки китайского шрифта --------------------------
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# 1. Загрузите классический набор данных Iris (4 признака)
plt.rcParams['axes.unicode_minus'] = False
# Исходные данные: 150 образцов, 4 признака
# Метки, используемые для раскрашивания при визуализации
iris = load_iris()
X = iris.data "Исходная форма данных: {X.shape}"
y = iris.target # Вывод: (150, 4)
print(f# 2. Создайте модель PCA, укажите понижение до 2 измерений) # 3. Обучите модель (вычислите главные компоненты) и преобразуйте данные
"Форма данных после понижения размерности: {X_pca.shape}"
pca = PCA(n_components=2)
# Вывод: (150, 2)
X_pca = pca.fit_transform(X)
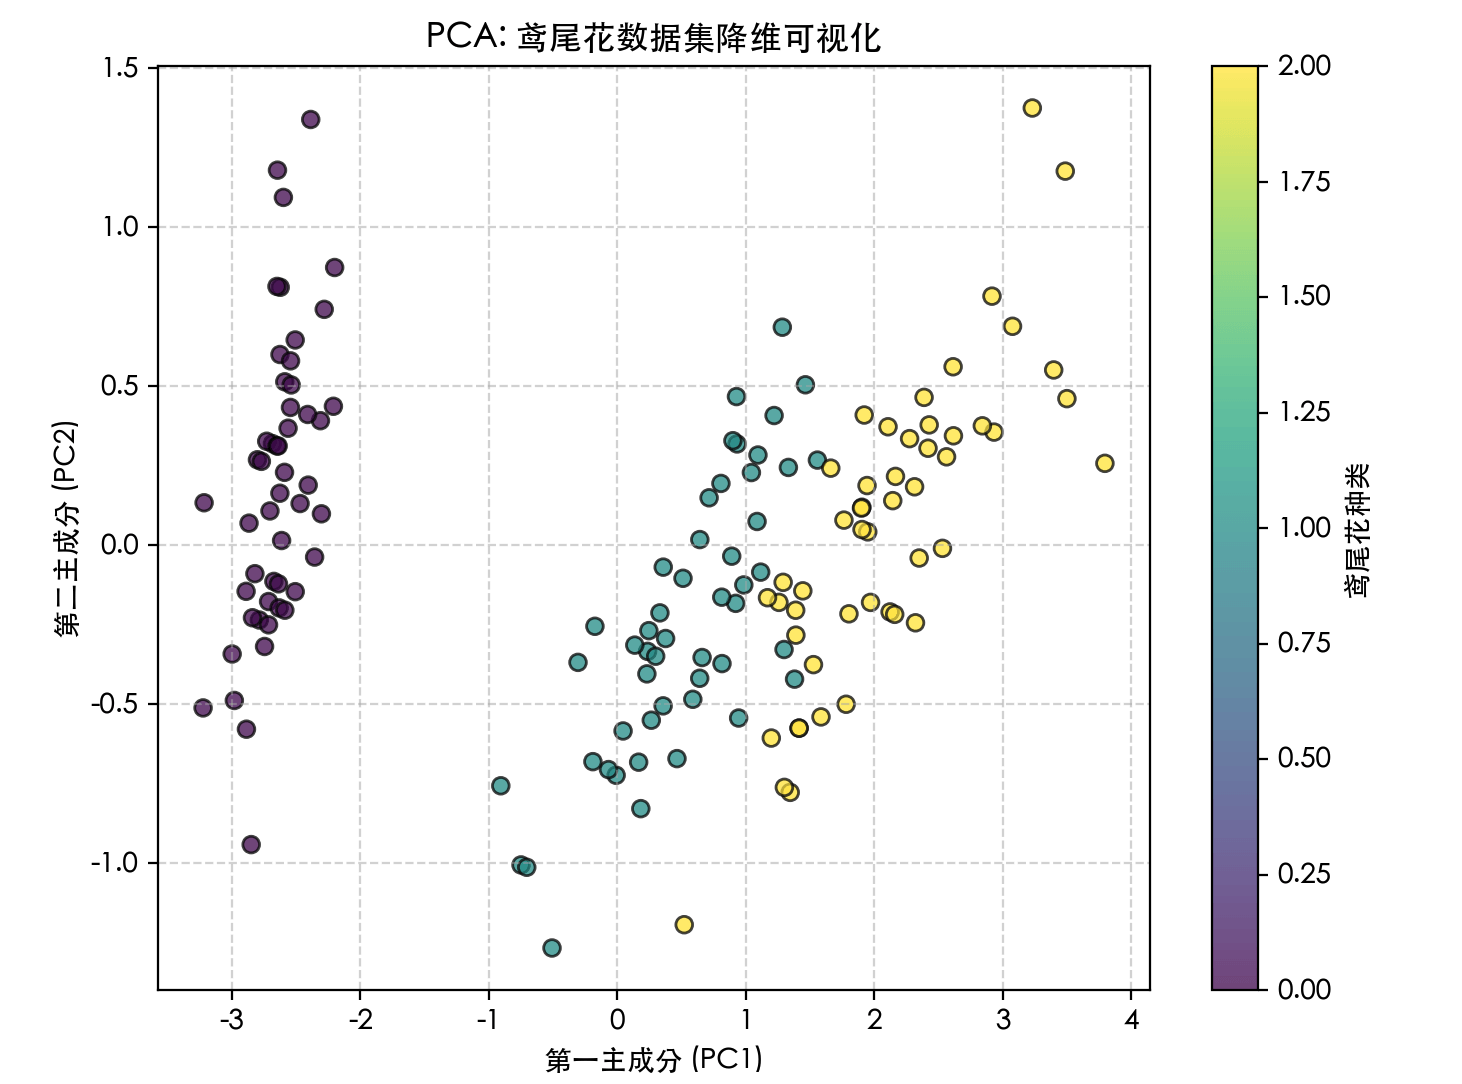
print(f"Доля объяснённой дисперсии по каждой главной компоненте: {pca.explained_variance_ratio_}") # Вывод может быть похож на: [0.9246, 0.0530], что означает, что первая главная компонента сохраняет 92.5% информации, а вторая — 5.3%
print(f# 4. Визуализируйте результат понижения размерности)
'Первая главная компонента (PC1)'
'Вторая главная компонента (PC2)'
plt.figure(figsize=(8, 6))
scatter = plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y, edgecolor='k', alpha=0.7)
plt.xlabel('PCA: Визуализация снижения размерности набора данных Iris')
plt.ylabel('Виды ирисов')
plt.title(Объяснение кода)
plt.colorbar(scatter, label=: Инициализируйте модель,)
plt.grid(True, linestyle='--', alpha=0.5)
plt.show()
параметр задаёт количество главных компонент, которые нужно сохранить (т.е. размерность после сокращения).:
PCA(n_components=2): Это комбинированный метод; сначала он вычисляет среднее и направления главных компонент данных (n_components), затем сразу преобразует данные в новое пространство (fit_transform(X): Это очень важный атрибут PCA; он показывает, какую часть дисперсии (информации) исходных данных сохраняет каждый новый признак (главная компонента). Это помогает решить, сколько главных компонент целесообразно выбрать.fitПреимущества и недостатки PCAtransform)。explained_variance_ratio_Преимущества
: Вычислительно эффективен, имеет понятные принципы и может эффективно устранять линейные корреляции.
- Недостатки: Это линейный метод, который предполагает, что главные компоненты данных линейны. Для данных на нелинейном многообразии, таких как «Swiss roll», PCA показывает плохие результаты.
- Нелинейное снижение размерности: t-SNEКогда данные имеют сложные нелинейные структуры, нам нужны методы нелинейного снижения размерности.
Нелинейное снижение размерности: t-SNE
Основная идея t-SNEt-SNE фокусируется насохранении локальной структуры данных.
Он пытается сделать точки, которые «похожи» (близки по расстоянию) в высокоразмерном пространстве, также «похожими» в низкоразмерном отображении; тогда как точки, которые «не похожи» в высокоразмерном пространстве, оказываются далеко друг от друга в низкоразмерном пространстве.
Пример# Импорт необходимых библиотек# Генерация данных Swiss roll
Пример
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.manifold import TSNE
from sklearn.datasets import make_swiss_roll # сначала macOS
# Сначала Linux
plt.rcParams['font.sans-serif'] = [
# Исправление проблемы, когда знаки минуса отображаются в виде квадратов
'SimHei', 'Microsoft YaHei',
# -------------------------- Конец настройки китайского шрифта --------------------------
'PingFang SC', 'Heiti TC',
# 1. Сгенерировать нелинейный набор данных: Swiss roll
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
"Форма данных Swiss roll: {X_swiss.shape}"
plt.rcParams['axes.unicode_minus'] = False
# 2. Использовать PCA (линейный метод), чтобы попытаться снизить размерность
# 3. Использовать t-SNE (нелинейный метод) для снижения размерности
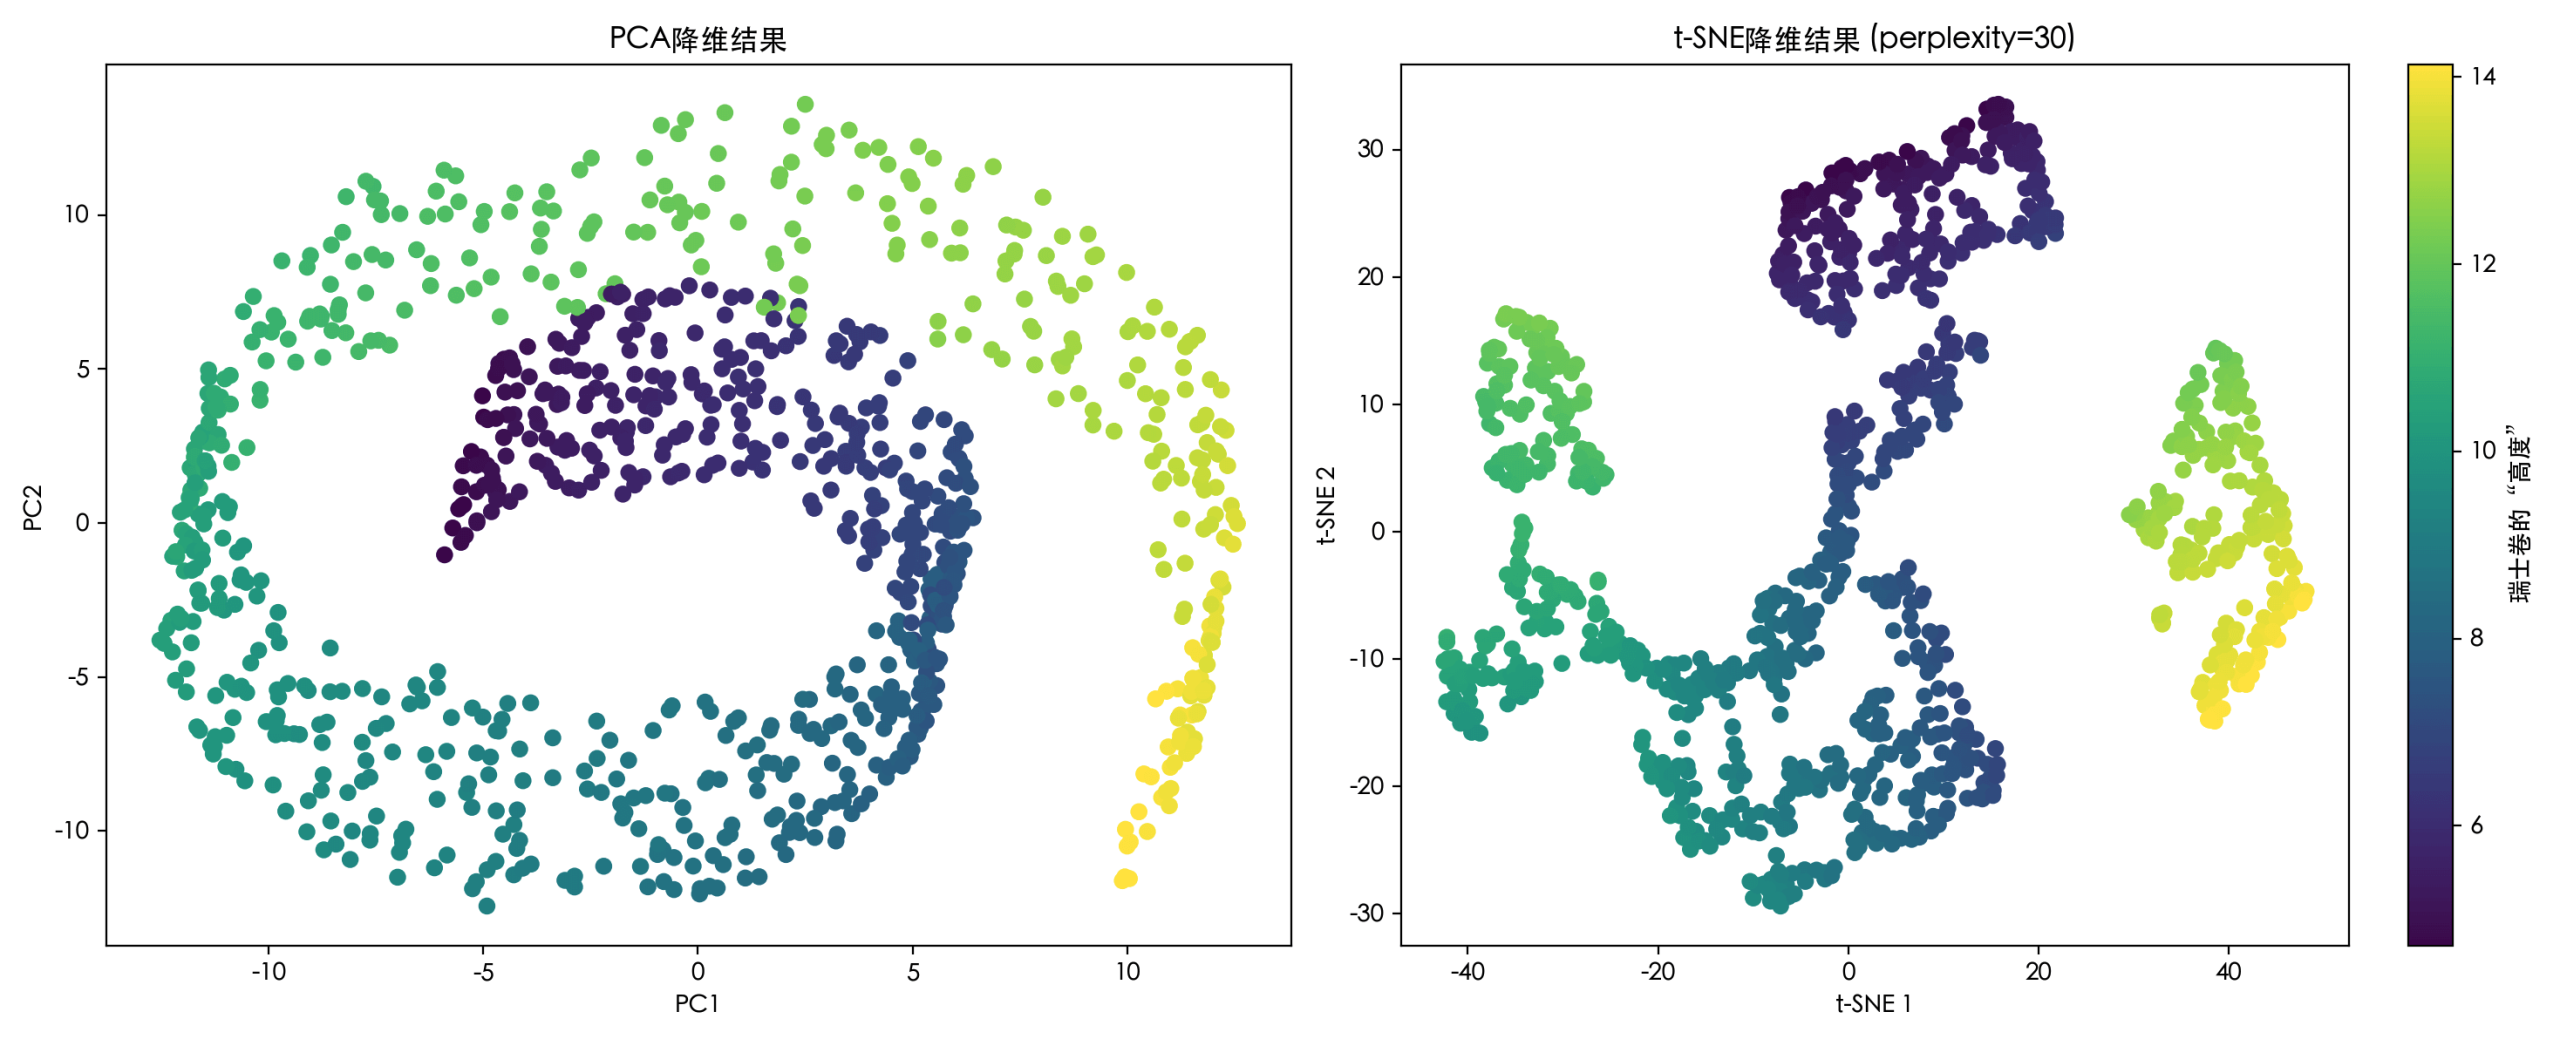
X_swiss, color = make_swiss_roll(n_samples=1000, noise=0.1)
print(f# perplexity — ключевой параметр t-SNE, обычно между 5 и 50, обеспечивающий сбалансированный фокус на локальной/глобальной структуре) # (1000, 3)
# 4. Сравнение визуализаций
pca = PCA(n_components=2)
X_swiss_pca = pca.fit_transform(X_swiss)
# Результат PCA
'Результат снижения размерности PCA'
tsne = TSNE(n_components=2, perplexity=30, random_state=42)
X_swiss_tsne = tsne.fit_transform(X_swiss)
# Результат t-SNE
fig, axes = plt.subplots(1, 2, figsize=(15, 6))
'Результат снижения размерности t-SNE (perplexity=30)'
axes[0].scatter(X_swiss_pca[:, 0], X_swiss_pca[:, 1], c=color, cmap='viridis')
axes[0].set_title('Швейцарский рулет "высота"')
axes[0].set_xlabel('PC1')
axes[0].set_ylabel('PC2')
Как выбрать методы снижения размерности и ключевые параметры
sc = axes[1].scatter(X_swiss_tsne[:, 0], X_swiss_tsne[:, 1], c=color, cmap='viridis')
axes[1].set_title(Блок-схема выбора алгоритма)
axes[1].set_xlabel('t-SNE 1')
axes[1].set_ylabel('t-SNE 2')
plt.colorbar(sc, ax=axes[1], label=Руководство по ключевым параметрам)
plt.tight_layout()
plt.show()
Объяснение кода:
perplexityПараметр: можно понимать как количество соседей, которое следует учитывать для каждой точки. Меньшие значения больше ориентируются на локальную структуру, большие значения — на глобальную структуру. Это наиболее важный параметр для настройки в t-SNE.random_state: обеспечивает воспроизводимость результатов, потому что процесс оптимизации t-SNE является стохастическим.- Из результатов визуализации видно, что PCA «сплющивает» Swiss roll, теряя его нелинейную закрученную структуру; тогда как t-SNE лучше разворачивает его на 2D-плоскости, сохраняя локальные отношения смежности данных.
Преимущества и недостатки t-SNE
Преимущества: отличный эффект визуализации сложных нелинейных данных, наглядно показывает структуры кластеров.
Недостатки:
- Медленная скорость вычислений, не подходит для больших наборов данных.
- Результаты обладаютслучайностью, каждый запуск может немного отличаться.
- Чувствительность к гиперпараметрам,
perplexityТребуется настройка. - В основномиспользуется для визуализации(2D/3D), признаки после снижения размерности обычно не используются для последующих задач машинного обучения, потому что смысл расстояний в низкоразмерном пространстве изменился.
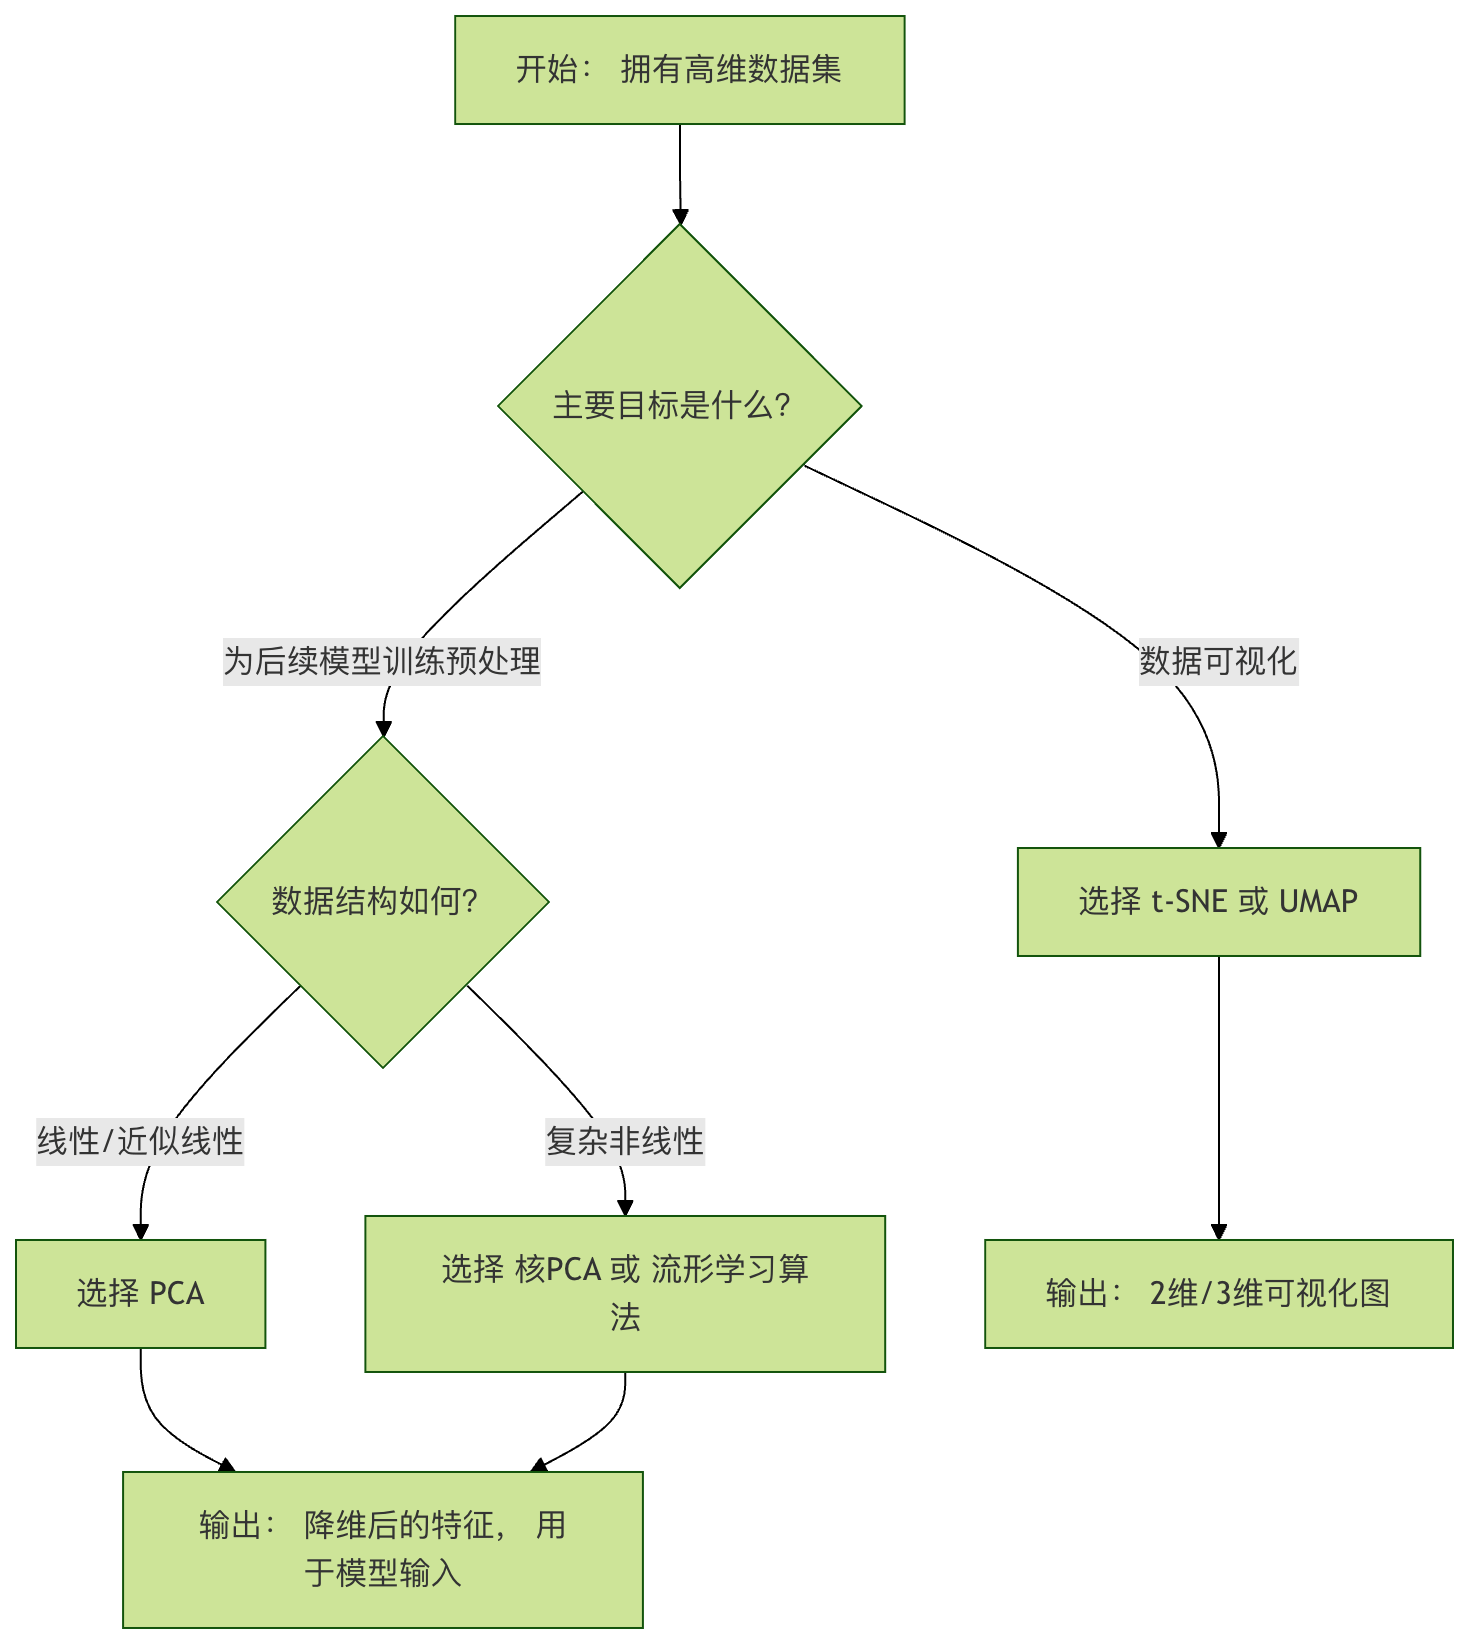
Как выбрать методы снижения размерности и ключевые параметры
Блок-схема выбора алгоритма
Руководство по ключевым параметрам
PCA: n_components
- Можно задать целое число (например, 2), чтобы указать конкретную размерность.
- Можно задать как
0 < n < 1десятичное число (например, 0.95), означающее сохранениенакопленной доли объяснённой дисперсии, достигающей порога при минимальном числе главных компонент.
Пример
pca = PCA(n_components=0.95)
pca.fit(X)
print(f"Чтобы сохранить 95% дисперсии, требуется {pca.n_components_} главных компонент")
t-SNE: perplexity
- Типичные значения — от 5 до 50.
- Для небольших наборов данных (<100 образцов) рекомендуются меньшие значения.
- Оптимальное значение обычно близко к числу "соседей" для каждой точки в данных. Его нужно выбирать, экспериментируя и наблюдая за результатами визуализации.
Практические упражнения и резюме
Практическое упражнение: применение снижения размерности к набору данных рукописных цифр MNIST
Пример
from sklearn.preprocessing import StandardScaler
# 1. Загрузите набор данных MNIST (возьмите только подмножество образцов, чтобы ускорить)
mnist = fetch_openml('mnist_784', version=1, as_frame=False)
X_mnist, y_mnist = mnist.data[:3000] / 255.0, mnist.target[:3000] # Нормализуйте, возьмите первые 3000 образцов
print(f"Форма данных MNIST: {X_mnist.shape}") # (3000, 784) -> 784 измерений!
# 2. Сначала используйте PCA, чтобы быстро уменьшить размерность до 50, удалив много шума
pca = PCA(n_components=50)
X_mnist_pca = pca.fit_transform(X_mnist)
print(f"Форма после PCA: {X_mnist_pca.shape}")
# 3. Затем используйте t-SNE, чтобы уменьшить 50-мерные данные до 2 измерений для визуализации
tsne = TSNE(n_components=2, perplexity=40, n_iter=300, random_state=42)
X_mnist_tsne = tsne.fit_transform(X_mnist_pca)
# 4. Визуализация
plt.figure(figsize=(10, 8))
scatter = plt.scatter(X_mnist_tsne[:, 0], X_mnist_tsne[:, 1],
c=y_mnist.astype(int), cmap='tab10', альфа=0.6, s=5)
plt.colorbar(scatter, ticks=range(10), label='Рукописные цифры')
plt.title('Визуализация t-SNE набора данных рукописных цифр MNIST после предобработки PCA')
plt.xlabel('t-SNE 1')
plt.ylabel('t-SNE 2')
plt.grid(True, linestyle='--', alpha=0.3)
plt.show()
Цель упражнения: Понаблюдайте, образуют ли разные цифры (0-9) четкие кластеры на 2D-плоскости. Попробуйте изменитьperplexityпараметры (например, измените на 10 или 50) и посмотрите, как изменится визуализация.
Итоги и ключевые моменты
Суть снижения размерности: это сжатие и извлечение информации, а не просто отбрасывание данных. Цель —выразить как можно больше исходной информации с меньшим числом измерений.。
PCA (король линейных методов): находит наиболее важные линейные направления данных путем максимизации дисперсии. Эффективен и стабилен, подходит для предобработки и удаления линейных корреляций.
t-SNE (мощный инструмент для визуализации): выявляет нелинейные структуры, сохраняя локальные сходства между точками данных. Эффект впечатляет, но метод медленный, а результаты случайны; в основном используется для исследовательского анализа данных.
Рабочий процесс:
- Уточните цель: это для визуализации или для предоставления более качественных признаков для последующих моделей?
- Исследование данных: сначала визуализируйте часть данных, чтобы получить предварительное представление об их линейности/нелинейности.
- Экспериментирование с методами: выбирайте алгоритмы в зависимости от цели и структуры данных и настраивайте ключевые параметры.
- Оценка результатов: оценивайте эффект снижения размерности с помощью визуализации, коэффициента сохранения информации или производительности в последующих задачах.
Снижение размерности — ключ к разгадке чёрного ящика многомерных данных.
Освоив PCA и t-SNE, вы сможете не только получить общее представление о глобальной структуре при работе со сложными данными, но и подготовить оптимизированные признаки для последующих моделей машинного обучения, значительно повысив эффективность и глубину анализа данных.
Другие расширения