Aprendizaje no supervisado - Reducción de dimensionalidad
Imagina que eres un fotógrafo organizando una biblioteca con millones de fotos de alta resolución. Cada foto se compone de millones de píxeles (características). Si quieres encontrar rápidamente todas las fotos de atardeceres en la playa, comparar directamente cada píxel de cada foto es casi imposible, porque la cantidad de datos es demasiado grande y demasiado "voluminosa".
En el aprendizaje automático, a menudo nos enfrentamos a un dilema similar: el conjunto de datos tiene cientos o miles de características (dimensiones). Esto no solo hace que el cálculo sea extremadamente lento (maldición de la dimensionalidad), sino que también, debido a que muchas características son redundantes o irrelevantes, interfiere en la búsqueda de los verdaderos patrones en los datos.
Reducción de dimensionalidad (Dimensionality Reduction)es una técnica central en el aprendizaje no supervisado. Actúa como un entrenador físico de datos, ayudándonos a reducir los datos de alta dimensión a un espacio de baja dimensión, conservando al máximo la información más importante. Hoy vamos a aprender la reducción de dimensionalidad de manera clara y profunda.
Conceptos básicos de la reducción de dimensionalidad
¿Qué es la reducción de dimensionalidad?
En pocas palabras,la reducción de dimensionalidad es el proceso de reducir el número de características del conjunto de datos.Mediante una transformación matemática, asigna los puntos de datos del espacio original de alta dimensión a un nuevo espacio de menor dimensión.
¿Por qué reducir la dimensionalidad?
La reducción de dimensionalidad no es simplemente descartar datos; su valor fundamental radica en:
- VisualizaciónLos humanos solo podemos comprender intuitivamente hasta tres dimensiones. Al reducir a 2D o 3D, podemos dibujar los datos de alta dimensión y observar visualmente su estructura, agrupaciones y puntos anómalos.
- Mejora de la eficienciaMenos dimensiones de datos implican menos espacio de almacenamiento, mayor velocidad de entrenamiento y menor costo computacional.
- Eliminación de ruido y redundanciaMuchos algoritmos (especialmente los basados en cálculo de distancias como KNN) ven degradado su rendimiento en espacios de alta dimensión debido a características irrelevantes o repetidas. La reducción de dimensionalidad puede extraer la esencia de los datos.
- Mitigación de la maldición de la dimensionalidadEn espacios de alta dimensión, los datos se vuelven extremadamente dispersos, lo que dificulta que muchos modelos de aprendizaje automático encuentren patrones efectivos.
Idea clave: preservación de la información
El desafío clave de la reducción de dimensionalidad es:¿Cómo reducir la dimensionalidad mientras se preserva al máximo la información valiosa de los datos originales (como la varianza y la estructura de los datos)?Los diferentes algoritmos de reducción de dimensionalidad tienen diferentes respuestas a esto.
Explicación detallada de los algoritmos de reducción de dimensionalidad más populares
Los algoritmos de reducción de dimensionalidad se dividen principalmente en dos categorías:Reducción linealyReducción no lineal。
Reducción lineal: Análisis de Componentes Principales
Análisis de Componentes Principales (PCA)es el método de reducción lineal más clásico y utilizado. Su objetivo es encontrar un nuevo conjunto de ejes de coordenadas (llamados "componentes principales") para los datos, de modo que la varianza de las proyecciones de los datos sobre estos nuevos ejes sea máxima.
Cómo funciona PCA (cuatro pasos):
- CentradoRestar la media de cada característica para que el centro de la distribución de datos se mueva al origen de coordenadas.
- Calcular la matriz de covarianzaEsta matriz describe la correlación entre las distintas características de los datos.
- Descomposición en valores propiosCalcular los valores propios y vectores propios de la matriz de covarianza.Los vectores propiosindican la dirección de los nuevos ejes (componentes principales),los valores propiosrepresentan la magnitud de la varianza de los datos en esa dirección. Cuanto mayor sea el valor propio, más información contiene esa dirección.
- Seleccionar los componentes principalesOrdena los valores propios de mayor a menor y selecciona los primeros
kvectores propios correspondientes a los valores propios más grandes, formando una matriz de proyección. - Transformación de datosMultiplica los datos originales por esta matriz de proyección y se obtienen los datos reducidos a
kdimensiones.
Ejemplo
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.datasets import load_iris
# -------------------------- Configurar fuente china start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows primero
'SimHei', 'Microsoft YaHei',
# macOS primero
'PingFang SC', 'Heiti TC',
# Linux primero
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corregir el problema de que el signo negativo se muestre como un cuadrado
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Configurar fuente china end --------------------------
# 1. Cargar el clásico conjunto de datos Iris (4 características)
iris = load_iris()
X = iris.data # Datos originales: 150 muestras, 4 características
y = iris.target # Etiquetas, para colorear en la visualización
print(f"Forma de los datos originales: {X.shape}") # Salida: (150, 4)
# 2. Crear el modelo PCA, especificando reducción a 2 dimensiones
pca = PCA(n_components=2)
# 3. Ajustar el modelo (calcular componentes principales) y transformar los datos
X_pca = pca.fit_transform(X)
print(f"Forma de los datos reducidos: {X_pca.shape}") # Salida: (150, 2)
print(f"Proporción de varianza explicada por cada componente principal: {pca.explained_variance_ratio_}")
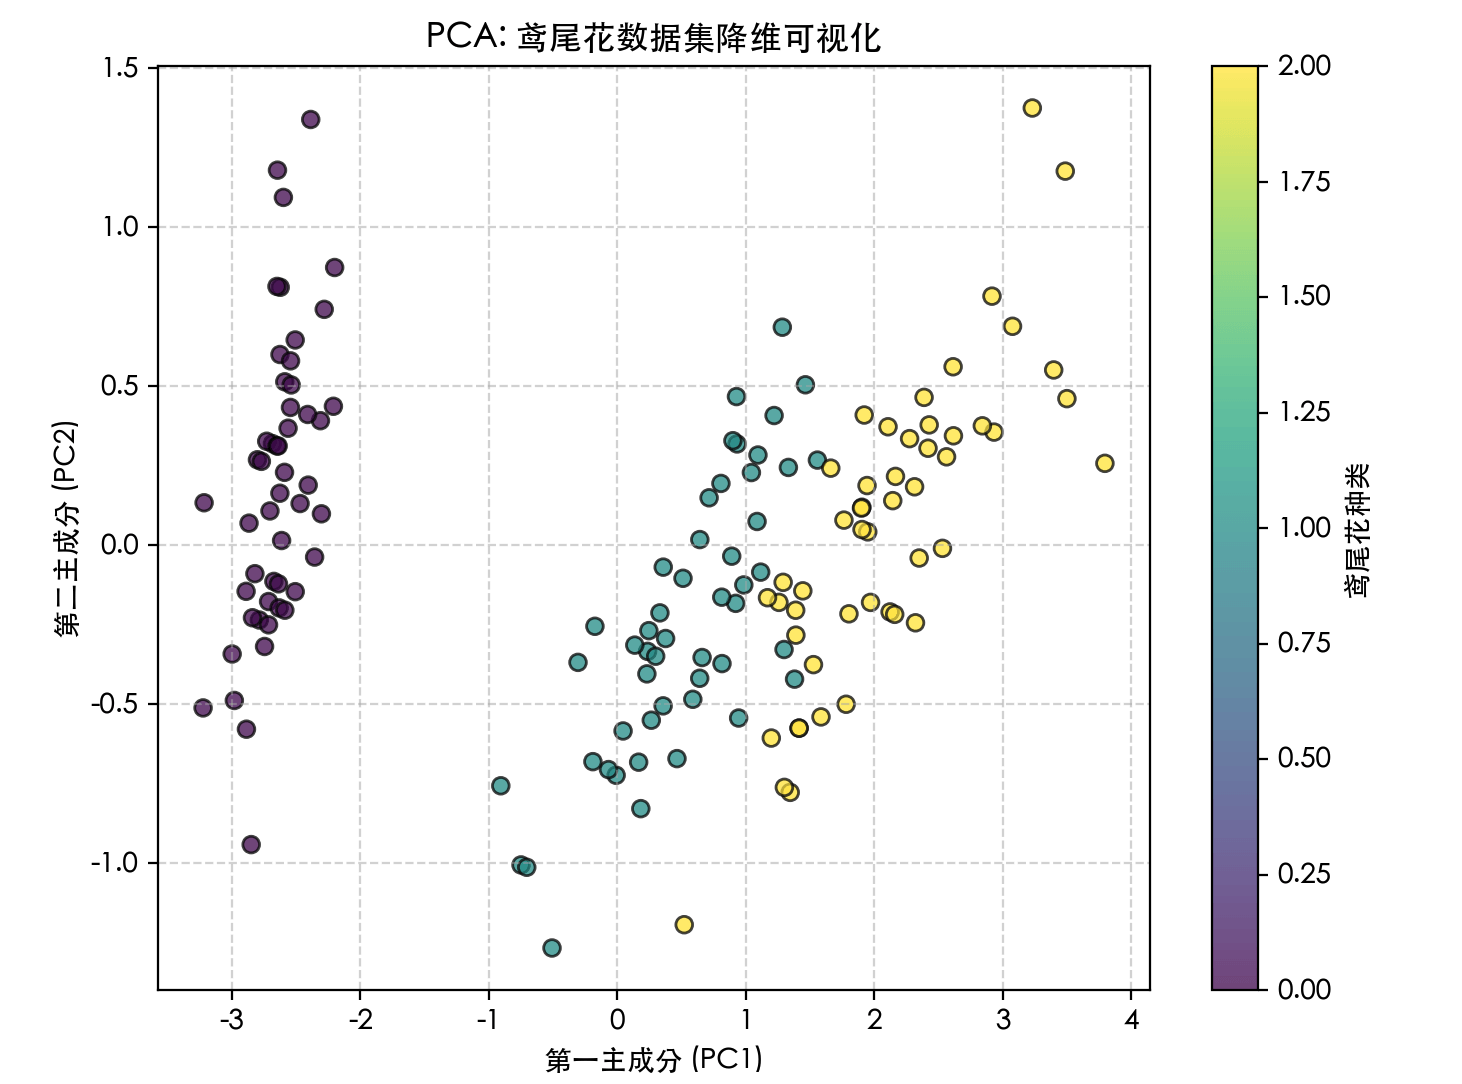
# La salida puede ser similar a: [0.9246, 0.0530] lo que indica que el primer componente principal conserva el 92.5% de la información y el segundo el 5.3%
# 4. Visualizar el resultado de la reducción de dimensionalidad
plt.figure(figsize=(8, 6))
scatter = plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y, edgecolor='k', alpha=0.7)
plt.xlabel('Primer componente principal (PC1)')
plt.ylabel('Segundo componente principal (PC2)')
plt.title('PCA: Visualización de la reducción de dimensionalidad del conjunto de datos Iris')
plt.colorbar(scatter, label='Especies de Iris')
plt.grid(True, linestyle='--', alpha=0.5)
plt.show()
Explicación del código:
PCA(n_components=2)Inicializar el modelo,n_componentsEl parámetro especifica el número de componentes principales a retener (es decir, la dimensión tras la reducción).fit_transform(X)Es un método combinado: primero calcula la media de los datos y la dirección de los componentes principales (fit), y luego transforma inmediatamente los datos al nuevo espacio (transform)。explained_variance_ratio_Es una propiedad muy importante de PCA; nos dice cuánta varianza (cantidad de información) de los datos originales conserva cada nueva característica (componente principal). Esto nos ayuda a decidir cuántos componentes principales son apropiados.
Ventajas y desventajas de PCA
- VentajasComputacionalmente eficiente, principio claro y elimina eficazmente las correlaciones lineales.
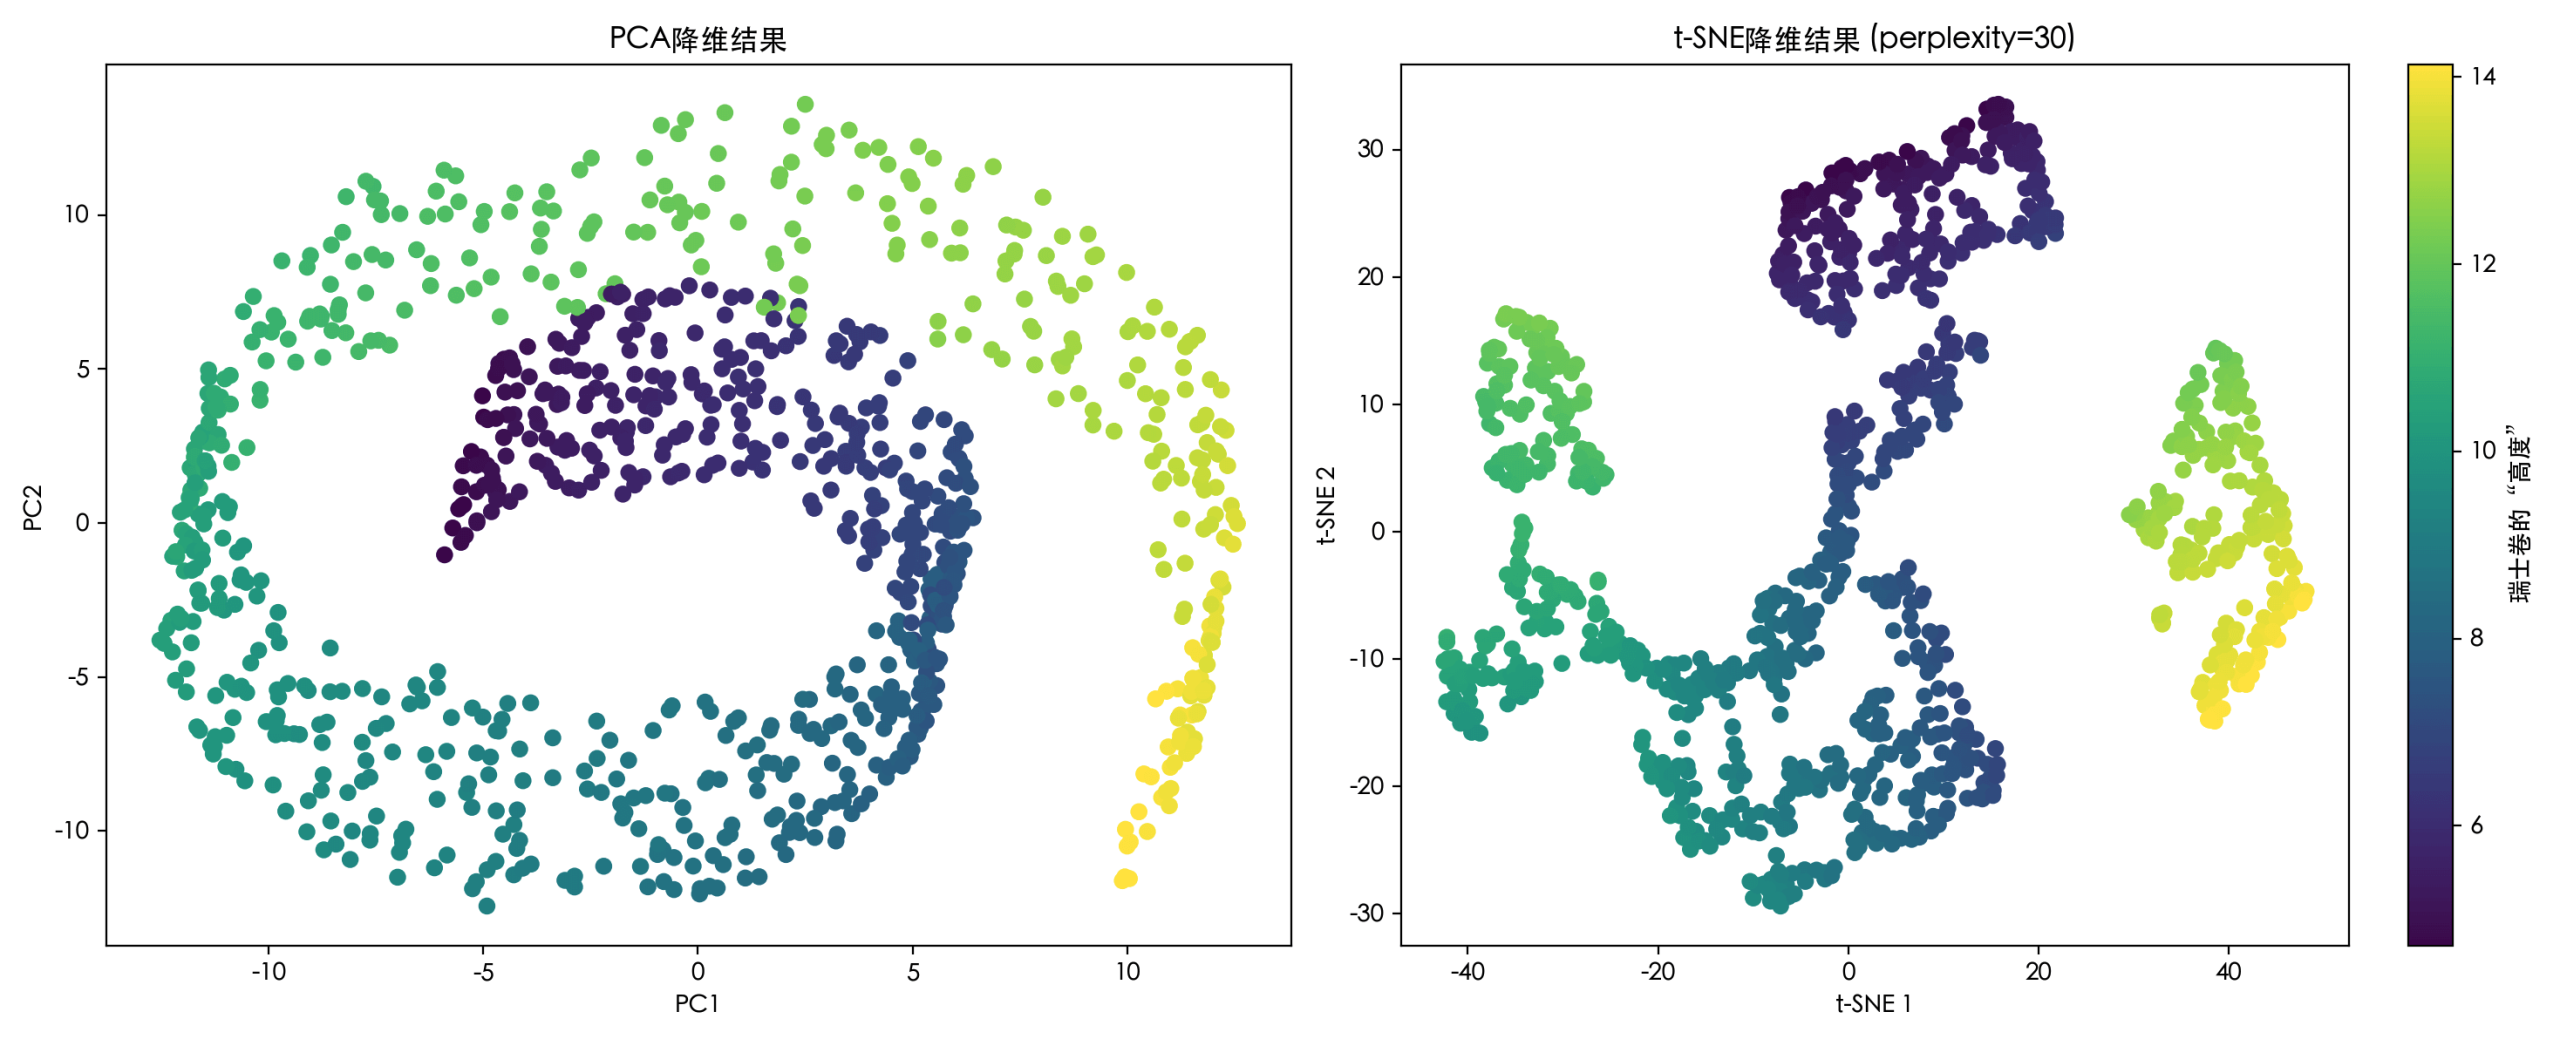
- DesventajasEs un método lineal que asume que los componentes principales de los datos son lineales. Para datos con estructura no lineal, como el "rollo suizo" (manifold), PCA no funciona bien.
Reducción no lineal: t-SNE
Cuando los datos tienen una estructura no lineal compleja, necesitamos métodos de reducción de dimensionalidad no lineales.Incrustación de vecinos estocásticos distribuida con t (t-SNE)es el algoritmo de reducción de dimensionalidad no lineal orientado a la visualización más popular en la actualidad.
Idea central de t-SNE
t-SNE se centra enpreservar la estructura local de los datos.Intenta que los puntos "similares" (cercanos en distancia) en el espacio de alta dimensión también lo sean en el mapeo de baja dimensión; mientras que los puntos "diferentes" en alta dimensión se alejan en la baja dimensión.
Ejemplo
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.manifold import TSNE
from sklearn.datasets import make_swiss_roll # Generar datos del rollo suizo
# -------------------------- Configurar fuente china start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows primero
'SimHei', 'Microsoft YaHei',
# macOS primero
'PingFang SC', 'Heiti TC',
# Linux primero
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corregir el problema de que el signo negativo se muestre como un cuadrado
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Configurar fuente china end --------------------------
# 1. Generar un conjunto de datos no lineal: rollo suizo
X_swiss, color = make_swiss_roll(n_samples=1000, noise=0.1)
print(f"Forma de los datos del rollo suizo: {X_swiss.shape}") # (1000, 3)
# 2. Usar PCA (método lineal) para intentar la reducción de dimensionalidad
pca = PCA(n_components=2)
X_swiss_pca = pca.fit_transform(X_swiss)
# 3. Usar t-SNE (método no lineal) para la reducción de dimensionalidad
# perplexity es el parámetro clave de t-SNE, normalmente entre 5 y 50, e indica un equilibrio entre la atención a la estructura local/global
tsne = TSNE(n_components=2, perplexity=30, random_state=42)
X_swiss_tsne = tsne.fit_transform(X_swiss)
# 4. Comparar visualizaciones
fig, axes = plt.subplots(1, 2, figsize=(15, 6))
# Resultado de PCA
axes[0].scatter(X_swiss_pca[:, 0], X_swiss_pca[:, 1], c=color, cmap='viridis')
axes[0].set_title('Resultado de reducción con PCA')
axes[0].set_xlabel('PC1')
axes[0].set_ylabel('PC2')
# Resultado de t-SNE
sc = axes[1].scatter(X_swiss_tsne[:, 0], X_swiss_tsne[:, 1], c=color, cmap='viridis')
axes[1].set_title('Resultado de reducción con t-SNE (perplexity=30)')
axes[1].set_xlabel('t-SNE 1')
axes[1].set_ylabel('t-SNE 2')
plt.colorbar(sc, ax=axes[1], label='"Altura" del rollo suizo')
plt.tight_layout()
plt.show()
Interpretación del código:
perplexityParámetro: puede entenderse como cuántos vecinos se consideran para cada punto. Un valor pequeño presta más atención a la estructura local; un valor grande presta más atención a la estructura global. Es el parámetro más importante a ajustar en t-SNE.random_state: garantiza que los resultados sean reproducibles, porque el proceso de optimización de t-SNE es aleatorio.- En los resultados de visualización se ve claramente que PCA "aplasta" el rollo suizo, perdiendo su estructura de enrollamiento no lineal; mientras que t-SNE despliega mejor este rollo en un plano bidimensional, conservando las relaciones de adyacencia local de los datos.
Ventajas y desventajas de t-SNE
Ventajas: el efecto de visualización para datos no lineales complejos es excelente, mostrando claramente la estructura de agrupamiento.
Desventajas:
- La velocidad de cálculo es lenta, no es adecuado para conjuntos de datos grandes.
- Los resultados tienenaleatoriedad, cada ejecución puede variar ligeramente.
- Es sensible a los hiperparámetros,
perplexityy requiere ajuste. - Principalmentese utiliza para visualización(2D/3D); las características reducidas generalmente no se usan para tareas posteriores de aprendizaje automático, porque el significado de las distancias en el espacio de baja dimensión cambia.
Cómo elegir el método de reducción de dimensionalidad y los parámetros clave
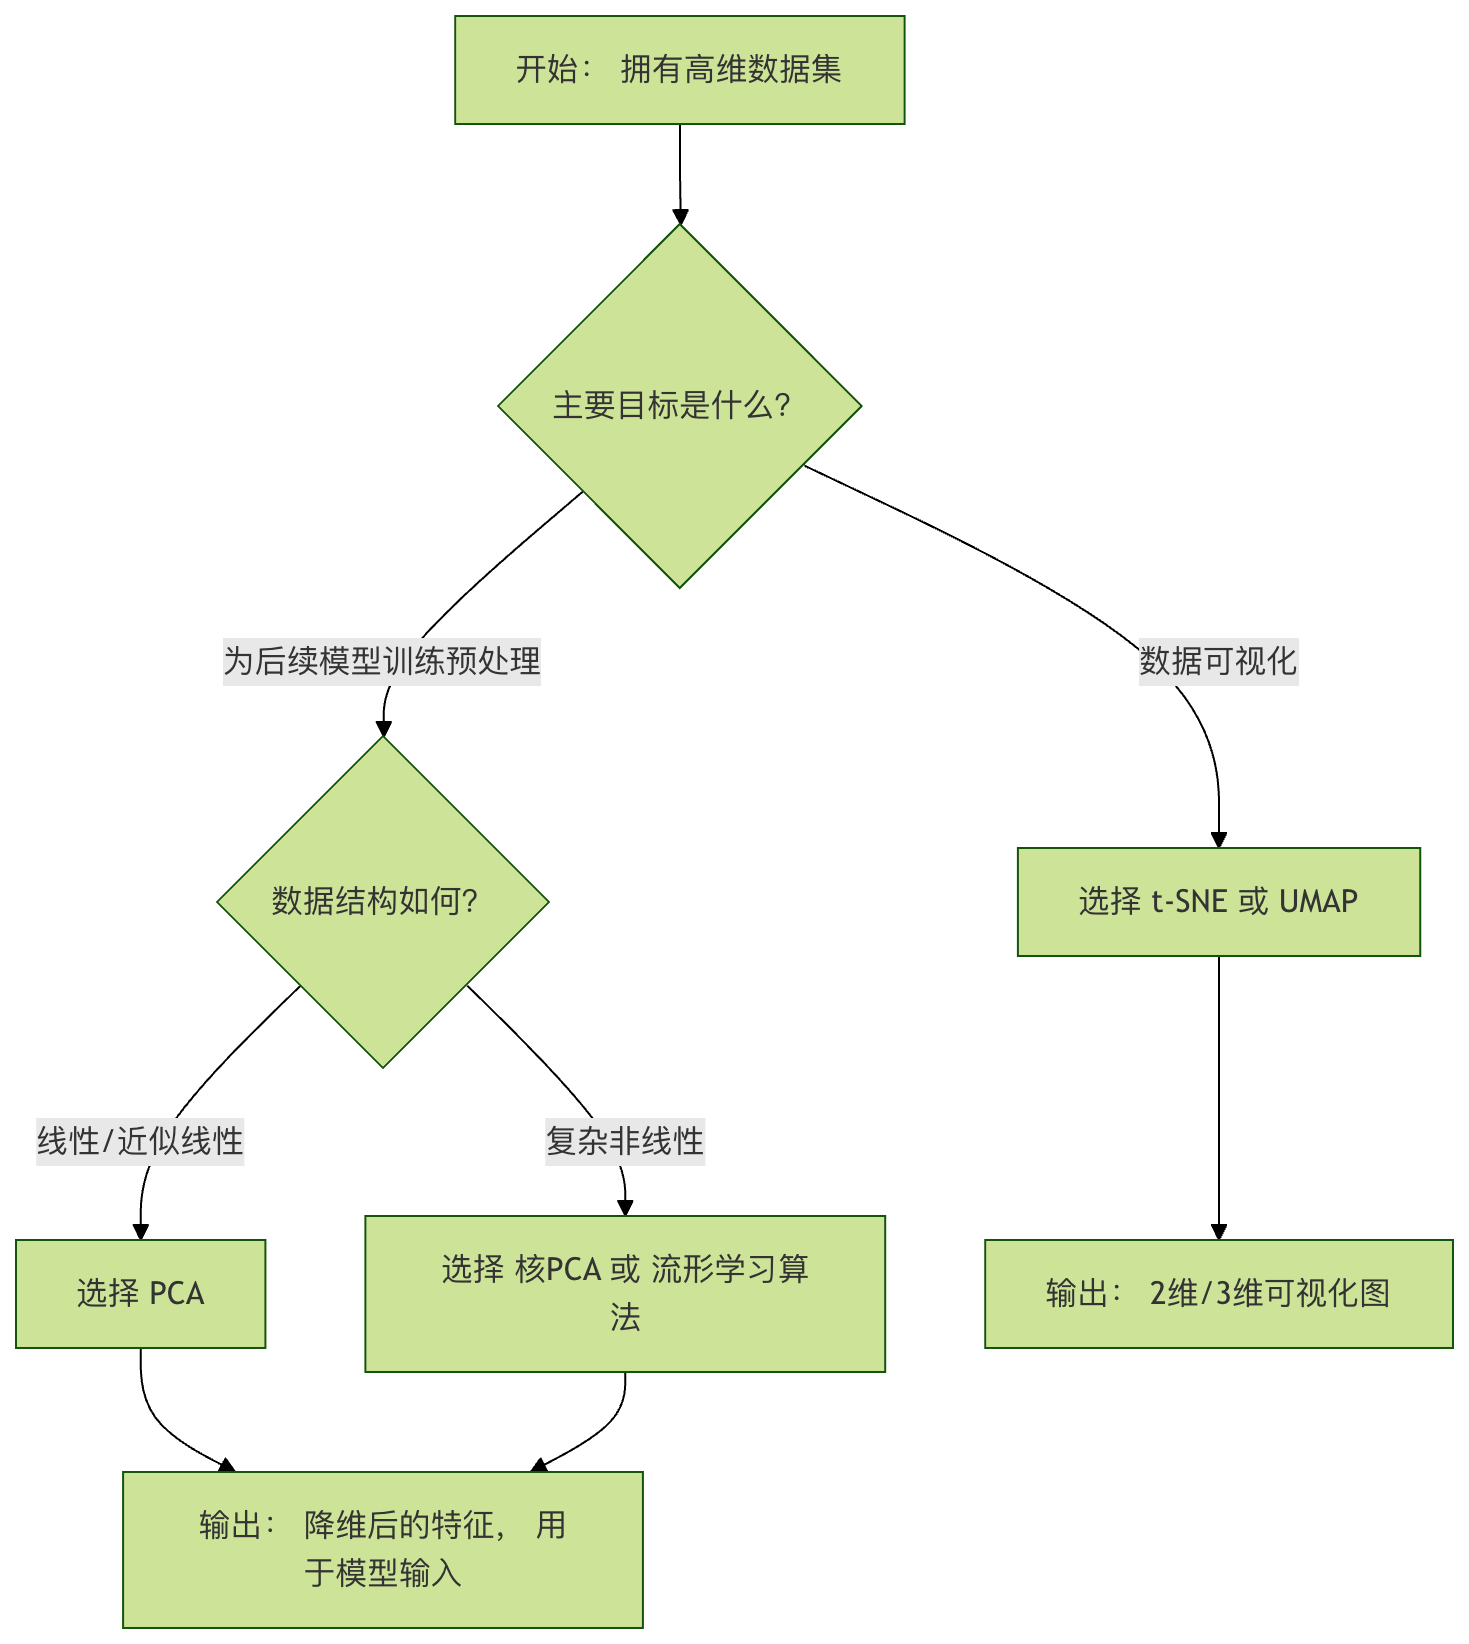
Diagrama de flujo para la selección del algoritmo
Guía de parámetros clave
PCA: n_components
- Puede establecerse como un número entero (por ejemplo, 2), especificando una dimensión concreta.
- Puede establecerse como
0 < n < 1un decimal (por ejemplo, 0.95), que indica conservarla tasa de varianza acumulada explicadalos componentes principales mínimos necesarios para alcanzar ese umbral.
Ejemplo
pca = PCA(n_components=0.95)
pca.fit(X)
print(f"Para conservar el 95% de la varianza, se necesitan {pca.n_components_} componentes principales")
t-SNE: perplexity
- Los valores típicos están entre 5 y 50.
- Para conjuntos de datos pequeños (<100 muestras), se recomienda usar valores más pequeños.
- El valor óptimo suele estar cerca del número de "vecinos" de cada punto en los datos. Debe elegirse observando los efectos de visualización mediante experimentos.
Práctica y resumen
Ejercicio práctico: Aplicar reducción de dimensionalidad en el conjunto de datos de dígitos manuscritos MNIST
Ejemplo
from sklearn.preprocessing import StandardScaler
# 1. Cargar el conjunto de datos MNIST (tomar solo una parte de las muestras para acelerar)
mnist = fetch_openml('mnist_784', version=1, as_frame=False)
X_mnist, y_mnist = mnist.data[:3000] / 255.0, mnist.target[:3000] # Normalizar y tomar las primeras 3000 muestras
print(f"Forma de los datos MNIST: {X_mnist.shape}") # (3000, 784) -> ¡784 dimensiones!
# 2. Primero usar PCA para reducir rápidamente a 50 dimensiones, eliminando gran parte del ruido
pca = PCA(n_components=50)
X_mnist_pca = pca.fit_transform(X_mnist)
print(f"Forma después de PCA: {X_mnist_pca.shape}")
# 3. Luego usar t-SNE para reducir los datos de 50 dimensiones a 2 dimensiones para visualización
tsne = TSNE(n_components=2, perplexity=40, n_iter=300, random_state=42)
X_mnist_tsne = tsne.fit_transform(X_mnist_pca)
# 4. Visualizar
plt.figure(figsize=(10, 8))
scatter = plt.scatter(X_mnist_tsne[:, 0], X_mnist_tsne[:, 1],
c=y_mnist.astype(int), cmap='tab10', alpha=0.6, s=5)
plt.colorbar(scatter, ticks=range(10), label='Dígitos escritos a mano')
plt.title('Visualización t-SNE del conjunto de datos MNIST de dígitos escritos a mano tras el preprocesamiento con PCA')
plt.xlabel('t-SNE 1')
plt.ylabel('t-SNE 2')
plt.grid(True, linestyle='--', alpha=0.3)
plt.show()
Objetivo del ejercicio: observar si los diferentes dígitos (0-9) forman grupos claros en el plano bidimensional. Intente modificar elperplexityparámetro (por ejemplo, cambiarlo a 10 o 50) y observe cómo cambia el efecto de visualización.
Resumen y puntos clave
La esencia de la reducción de dimensionalidad: es compresión y refinamiento de la información, no simplemente descartar datos. El objetivo esexpresar la mayor cantidad posible de información original con menos dimensiones。
PCA (el rey de lo lineal): encuentra las direcciones lineales más importantes de los datos maximizando la varianza. Es eficiente, estable y adecuado para preprocesamiento y eliminación de correlaciones lineales.
t-SNE (la herramienta ideal para visualización): revela estructuras no lineales manteniendo las similitudes locales entre los puntos de datos. El efecto es sorprendente, pero es lento y los resultados son aleatorios; se usa principalmente para análisis exploratorio de datos.
Flujo de trabajo:
- Definir el objetivo: ¿es para visualización o para proporcionar características más refinadas a los modelos posteriores?
- Exploración de datos: primero visualice parte de los datos para tener una idea inicial de su linealidad/no linealidad.
- Experimentación con métodos: elija el algoritmo según el objetivo y la estructura de los datos, y ajuste los parámetros clave.
- Evaluación de resultados: evalúe el efecto de la reducción de dimensionalidad mediante visualización, tasa de retención de información o el rendimiento en la tarea posterior.
La reducción de dimensionalidad es una llave clave para abrir la caja negra de los datos de alta dimensión.
Al dominar PCA y t-SNE, podrá, al enfrentarse a datos complejos, tanto contemplar la estructura global como preparar características simplificadas y eficientes para los modelos posteriores de aprendizaje automático, mejorando considerablemente la eficiencia y la profundidad del análisis de datos.
Otras extensiones