Apprentissage non supervisé - Réduction de dimensionnalité
Imaginez que vous êtes un photographe organisant une bibliothèque contenant des millions de photos haute résolution. Chaque photo est composée de millions de pixels (caractéristiques). Si vous voulez trouver rapidement toutes les photos de couchers de soleil au bord de la mer, comparer directement chaque pixel de chaque photo est presque impossible, car les données sont trop volumineuses et trop « épaisses ».
En apprentissage automatique, nous sommes souvent confrontés à un dilemme similaire : les jeux de données comportent des centaines ou des milliers de caractéristiques (dimensions). Cela conduit non seulement à des calculs extrêmement lents (la malédiction de la dimensionnalité), mais peut aussi, parce que de nombreuses caractéristiques sont redondantes ou non pertinentes, interférer avec notre capacité à trouver les véritables motifs dans les données.
La réduction de dimensionnalité est une technique essentielle en apprentissage non supervisé. Elle agit comme un coach de fitness des données, nous aidant à affiner des données de haute dimension vers un espace de dimension inférieure tout en préservant autant que possible les informations les plus importantes. Aujourd'hui, apprenons la réduction de dimensionnalité de manière simple et approfondie.Concepts de base de la réduction de dimensionnalité
Concepts de base de la réduction de dimensionnalité
Qu'est-ce que la réduction de dimensionnalité ?
la réduction de dimensionnalité est le processus de réduction du nombre de caractéristiques dans un jeu de données.Elle utilise une transformation mathématique pour projeter les points de données de l'espace original de grande dimension vers un nouvel espace de dimension inférieure.Pourquoi effectuer une réduction de dimensionnalité ?
Pourquoi réduire la dimensionnalité ?
Visualisation
- : Les humains ne peuvent comprendre intuitivement qu'un espace au maximum tridimensionnel. En réduisant les dimensions à 2D ou 3D, nous pouvons tracer des données de grande dimension et observer intuitivement leur structure, leurs regroupements et leurs valeurs aberrantes.Efficacité améliorée
- : Moins de dimensions de données signifie moins d'espace de stockage, une vitesse d'entraînement plus rapide et un coût de calcul inférieur.Suppression du bruit et des redondances
- : De nombreux algorithmes (en particulier les algorithmes de calcul de distance tels que KNN) subissent une dégradation des performances dans un espace de grande dimension en raison de caractéristiques non pertinentes ou redondantes. La réduction de dimensionnalité peut distiller l'essence des données.Atténuation de la malédiction de la dimensionnalité
- : Dans un espace de grande dimension, les données deviennent extrêmement éparses, ce qui rend difficile pour de nombreux modèles d'apprentissage automatique de trouver des motifs efficaces.Idée centrale : préservation de l'information
Idée centrale : préservation de l'information
Comment réduire les dimensions tout en maximisant la préservation des informations précieuses des données d'origine (telles que la variance et la structure des données) ?Différents algorithmes de réduction de dimensionnalité apportent différentes réponses à cette question.Explication détaillée des principaux algorithmes de réduction de dimensionnalité
Explication détaillée des principaux algorithmes de réduction de dimensionnalité
Réduction de dimensionnalité linéaireRéduction de dimensionnalité non linéaireetRéduction de dimensionnalité linéaire : analyse en composantes principales。
Réduction de dimensionnalité linéaire : analyse en composantes principales
Comment fonctionne l'ACP (quatre étapes) :Centrage
: Soustraire la moyenne de chaque caractéristique afin que le centre de la distribution des données se déplace vers l'origine du système de coordonnées.
- Calculer la matrice de covariance: Cette matrice décrit les corrélations entre les différentes caractéristiques des données.
- Décomposition en valeurs propres: Calculer les valeurs propres et les vecteurs propres de la matrice de covariance.
- Les vecteurs propresindiquent les directions des nouveaux axes de coordonnées (composantes principales),tandis que les valeurs propresreprésentent la variance des données le long de cette direction. Plus la valeur propre est grande, plus cette direction contient d'informations.Sélection des composantes principales: Trier les valeurs propres de la plus grande à la plus petite, et sélectionner les premiers
- vecteurs propres correspondant aux valeurs propres les plus grandes pour former une matrice de projection.Transformation des données
k: Multiplier les données d'origine par cette matrice de projection pour obtenir des données réduites à - dimensions.Exemple
k# Importer les bibliothèques nécessaires
Exemple
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.datasets import load_iris
# macOS en premier
plt.rcParams['font.sans-serif'] = [
# Linux d'abord
'SimHei', 'Microsoft YaHei',
# Corriger le problème où les signes négatifs s'affichent sous forme de carrés
'PingFang SC', 'Heiti TC',
# -------------------------- Fin de la configuration de la police chinoise --------------------------
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# 1. Charger le jeu de données Iris classique (4 caractéristiques)
plt.rcParams['axes.unicode_minus'] = False
# Données d'origine : 150 échantillons, 4 caractéristiques
# Étiquettes, utilisées pour la coloration dans la visualisation
iris = load_iris()
X = iris.data "Forme des données d'origine : {X.shape}"
y = iris.target # Sortie : (150, 4)
print(f# 2. Créer un modèle PCA, spécifier une réduction à 2 dimensions) # 3. Ajuster le modèle (calculer les composantes principales) et transformer les données
"Forme des données après réduction de dimensionnalité : {X_pca.shape}"
pca = PCA(n_components=2)
# Sortie : (150, 2)
X_pca = pca.fit_transform(X)
print(f"Ratio de variance expliqué par chaque composante principale : {pca.explained_variance_ratio_}") # La sortie peut être similaire à : [0.9246, 0.0530], indiquant que la première composante principale retient 92.5% de l'information, et que la seconde retient 5.3%
print(f# 4. Visualiser le résultat de la réduction de dimensionnalité)
'Première composante principale (PC1)'
'Deuxième composante principale (PC2)'
plt.figure(figsize=(8, 6))
scatter = plt.scatter(X_pca[:, 0], X_pca[:, 1], c=y, edgecolor='k', alpha=0.7)
plt.xlabel('PCA : Visualisation de la réduction de dimensionnalité du jeu de données Iris')
plt.ylabel('Espèces d'Iris')
plt.title(Explication du code)
plt.colorbar(scatter, label=: Initialiser le modèle,)
plt.grid(True, linestyle='--', alpha=0.5)
plt.show()
le paramètre spécifie le nombre de composantes principales à conserver (c'est-à-dire la dimensionnalité après réduction).:
PCA(n_components=2): Il s'agit d'une méthode combinée ; d'abord, elle calcule la moyenne et les directions des composantes principales des données (n_components), puis transforme immédiatement les données dans le nouvel espace (fit_transform(X): Il s'agit d'un attribut très important de PCA ; il nous indique quelle part de variance (d'information) des données d'origine chaque nouvelle caractéristique (composante principale) conserve. Cela nous aide à décider combien de composantes principales il est approprié de choisir.fitAvantages et inconvénients de PCAtransform)。explained_variance_ratio_Avantages
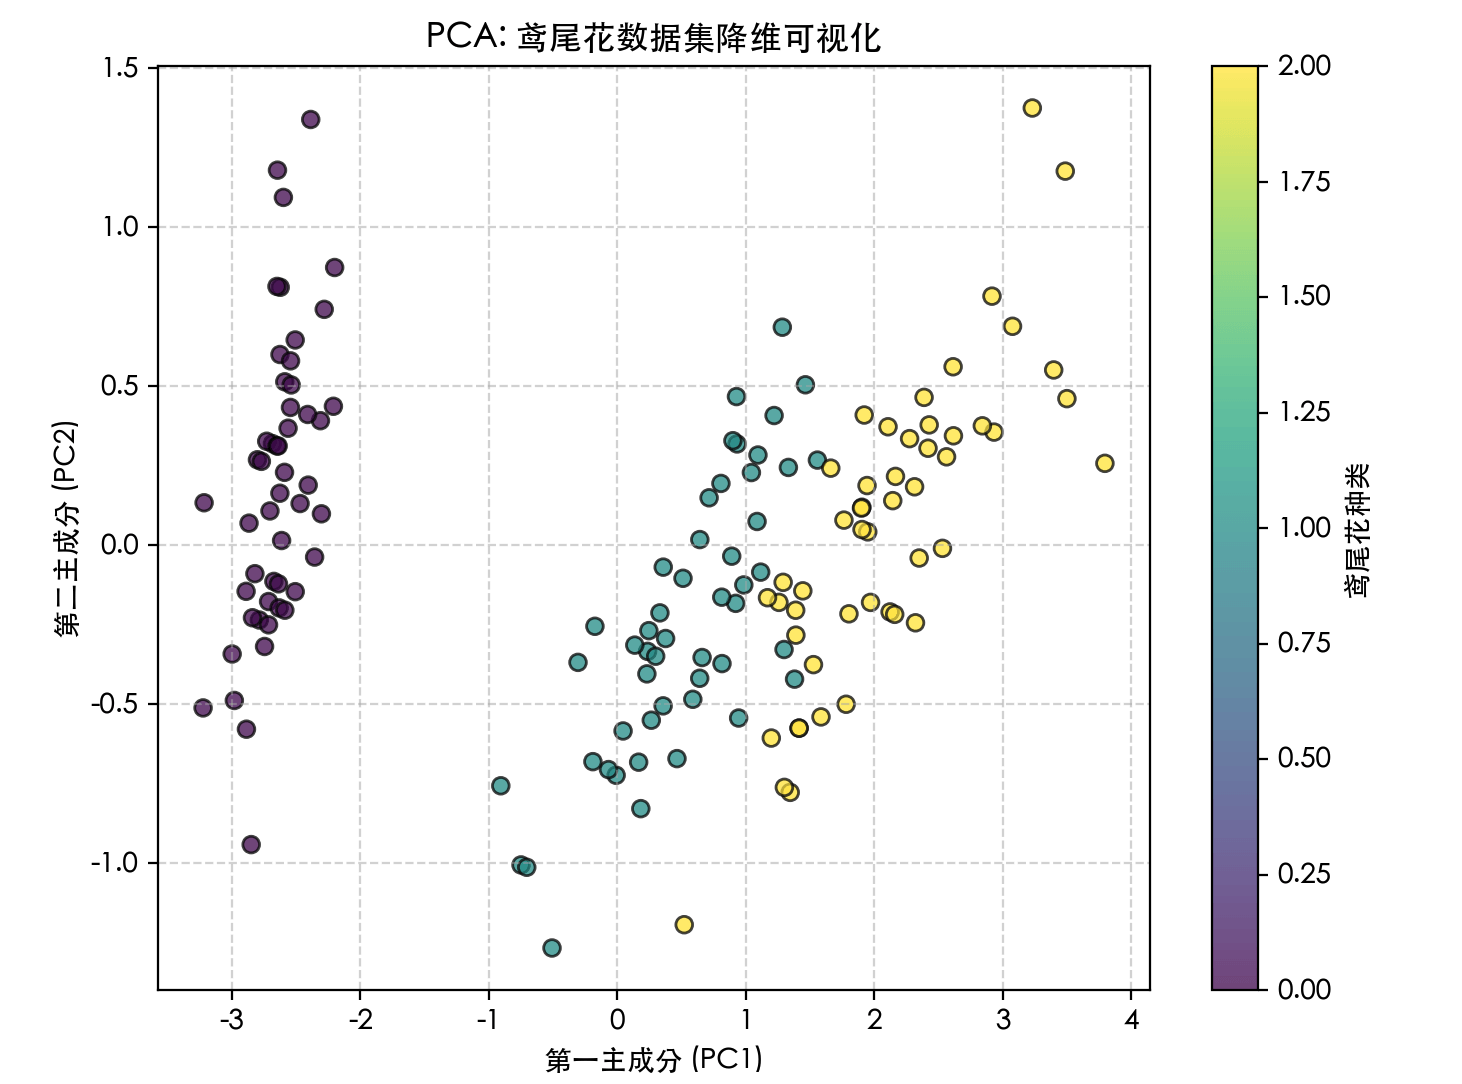
: Efficace en termes de calcul, principes clairs, et peut éliminer efficacement les corrélations linéaires.
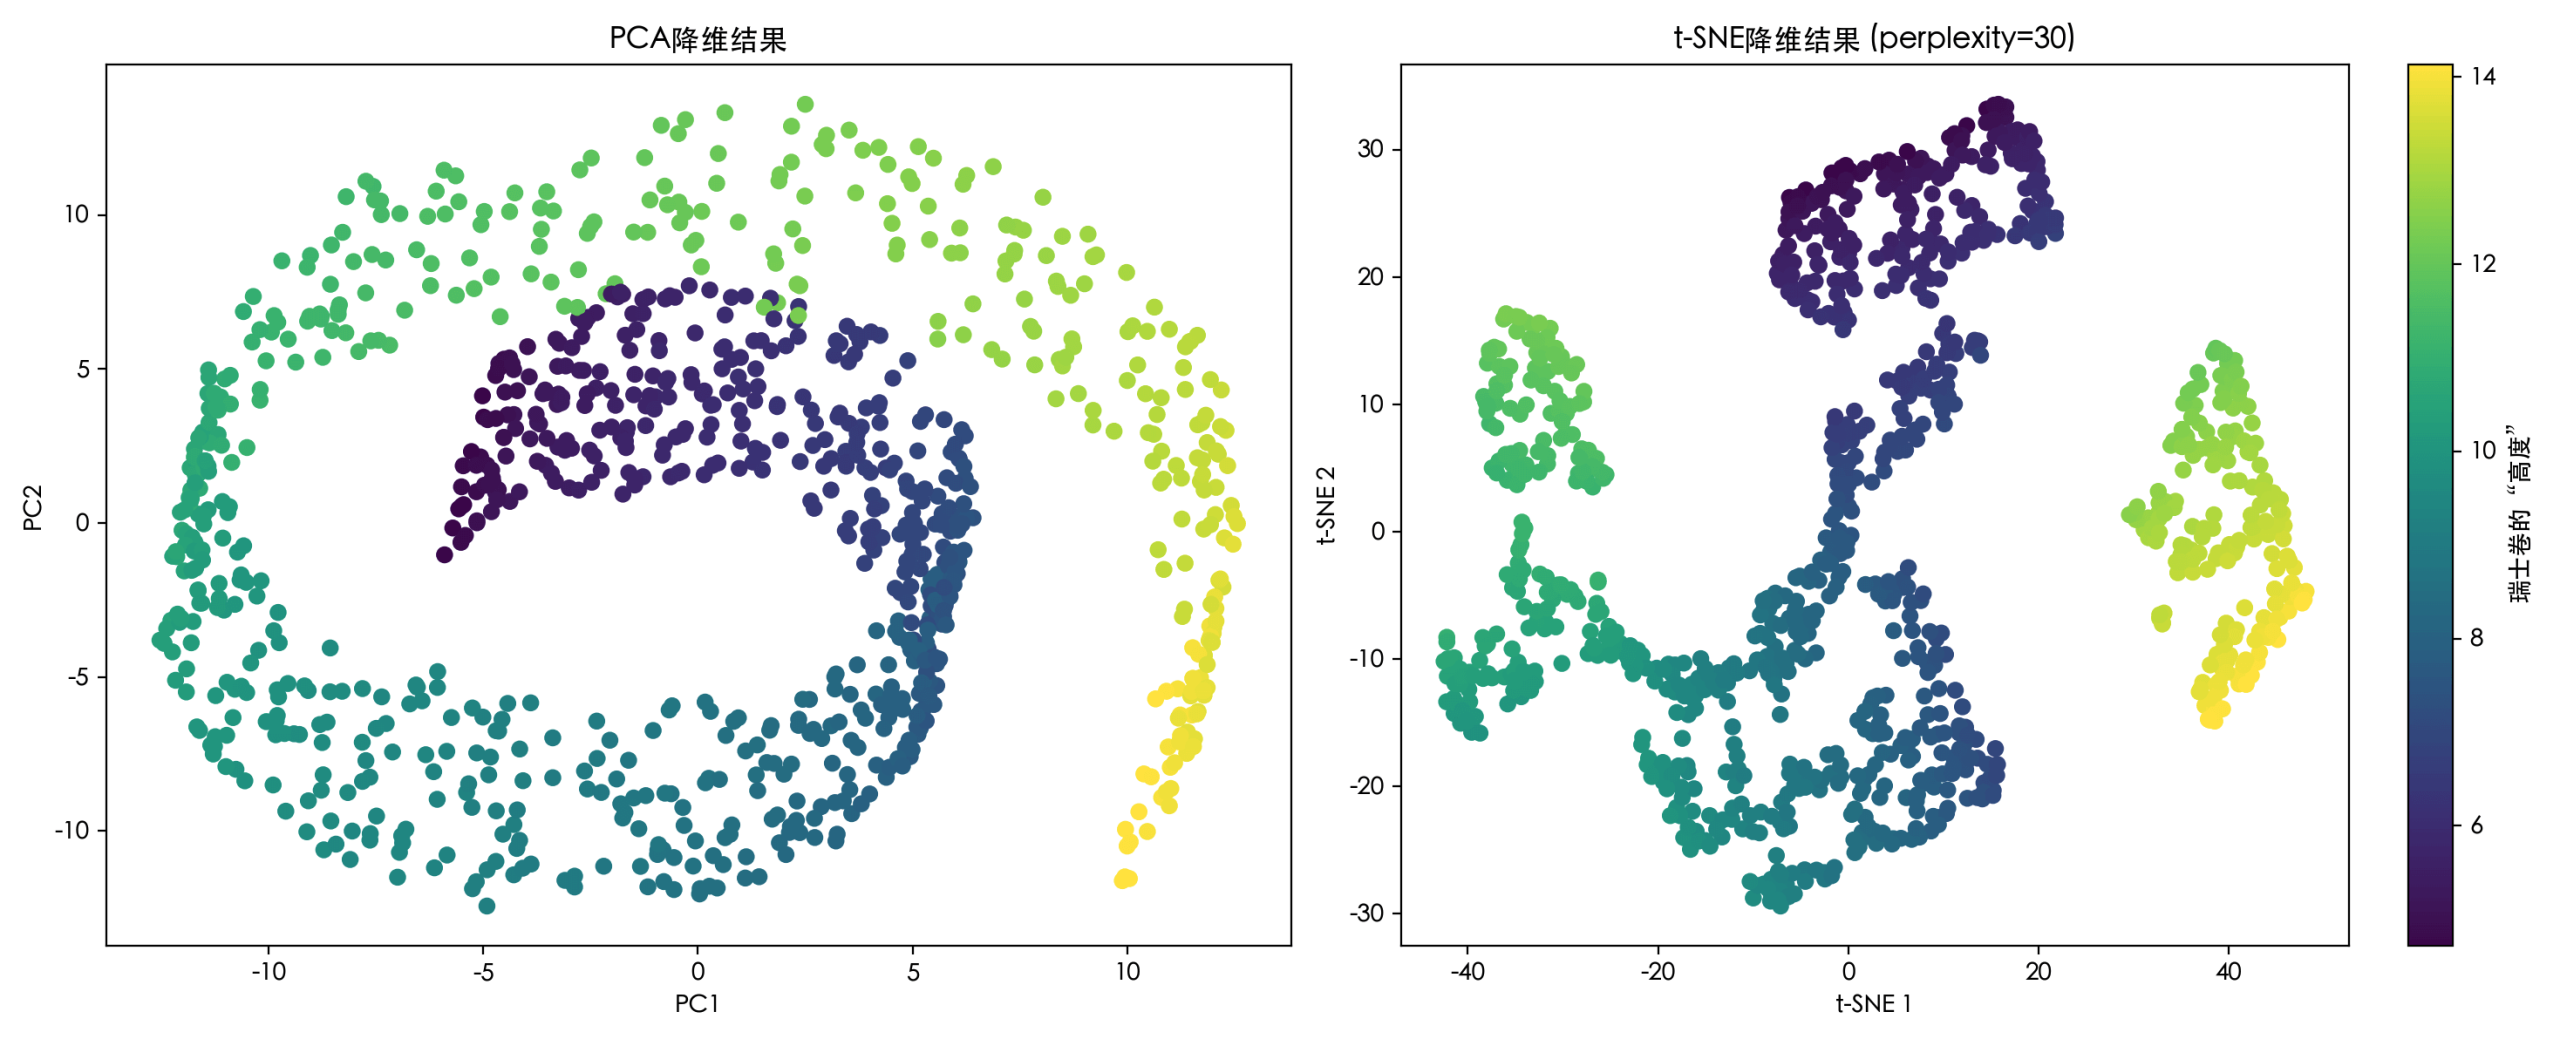
- Inconvénients: C'est une méthode linéaire et elle suppose que les composantes principales des données sont linéaires. Pour des données de variété non linéaires telles que le "Swiss roll", PCA ne donne pas de bons résultats.
- Réduction de dimension non linéaire : t-SNELorsque les données présentent des structures non linéaires complexes, nous avons besoin de méthodes de réduction de dimension non linéaires.
Réduction de dimension non linéaire : t-SNE
Idée centrale de t-SNEt-SNE se concentre surla préservation de la structure locale des données.
Il cherche à faire en sorte que les points qui sont « similaires » (proches en distance) dans l'espace de grande dimension soient aussi « similaires » dans la projection de faible dimension ; tandis que les points qui sont « non similaires » dans l'espace de grande dimension deviennent éloignés dans l'espace de faible dimension.
Exemple# Importer les bibliothèques nécessaires# Générer les données Swiss roll
Exemple
import numpy as np
import matplotlib.pyplot as plt
from sklearn.decomposition import PCA
from sklearn.manifold import TSNE
from sklearn.datasets import make_swiss_roll # macOS d'abord
# Linux d'abord
plt.rcParams['font.sans-serif'] = [
# Corriger le problème où les signes négatifs s'affichent sous forme de carrés
'SimHei', 'Microsoft YaHei',
# -------------------------- Fin de la configuration de la police chinoise --------------------------
'PingFang SC', 'Heiti TC',
# 1. Générer un jeu de données non linéaire : Swiss roll
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
"Forme des données Swiss roll : {X_swiss.shape}"
plt.rcParams['axes.unicode_minus'] = False
# 2. Utiliser PCA (méthode linéaire) pour tenter une réduction de dimension
# 3. Utiliser t-SNE (méthode non linéaire) pour la réduction de dimension
X_swiss, color = make_swiss_roll(n_samples=1000, noise=0.1)
print(f# la perplexité est un paramètre clé de t-SNE, généralement entre 5 et 50, représentant un équilibre entre la structure locale et globale) # (1000, 3)
# 4. Comparer les visualisations
pca = PCA(n_components=2)
X_swiss_pca = pca.fit_transform(X_swiss)
# Résultat de l'ACP
'Résultat de la réduction de dimension ACP'
tsne = TSNE(n_components=2, perplexity=30, random_state=42)
X_swiss_tsne = tsne.fit_transform(X_swiss)
# Résultat de t-SNE
fig, axes = plt.subplots(1, 2, figsize=(15, 6))
'Résultat de la réduction de dimension t-SNE (perplexity=30)'
axes[0].scatter(X_swiss_pca[:, 0], X_swiss_pca[:, 1], c=color, cmap='viridis')
axes[0].set_title('Swiss roll "hauteur"')
axes[0].set_xlabel('PC1')
axes[0].set_ylabel('PC2')
Comment choisir les méthodes de réduction de dimension et les paramètres clés
sc = axes[1].scatter(X_swiss_tsne[:, 0], X_swiss_tsne[:, 1], c=color, cmap='viridis')
axes[1].set_title(Organigramme de sélection des algorithmes)
axes[1].set_xlabel('t-SNE 1')
axes[1].set_ylabel('t-SNE 2')
plt.colorbar(sc, ax=axes[1], label=Guide des paramètres clés)
plt.tight_layout()
plt.show()
Explication de code:
perplexityParamètre : peut être compris comme le nombre de voisins à considérer pour chaque point. Des valeurs plus petites se concentrent davantage sur la structure locale, des valeurs plus grandes se concentrent davantage sur la structure globale. C'est le paramètre le plus important à régler dans t-SNE.random_state: garantit que les résultats sont reproductibles, car le processus d'optimisation de t-SNE est stochastique.- D'après les résultats de visualisation, il est clair que PCA « aplatit » le rouleau suisse, perdant sa structure enroulée non linéaire ; tandis que t-SNE déploie mieux ce rouleau sur un plan 2D, préservant les relations d'adjacence locales des données.
Avantages et inconvénients de t-SNE
Avantages: excellent effet de visualisation sur des données non linéaires complexes, montrant clairement les structures de clusters.
Inconvénients:
- Vitesse de calcul lente, ne convient pas aux grands jeux de données.
- Les résultats ontune part d'aléatoire, chaque exécution peut être légèrement différente.
- Sensible aux hyperparamètres,
perplexityNécessite un ajustement. - Principalementutilisé pour la visualisation(2D/3D), les caractéristiques de dimension réduite ne sont généralement pas utilisées pour les tâches d'apprentissage automatique ultérieures, car la signification des distances dans l'espace de faible dimension a changé.
Comment choisir les méthodes de réduction de dimension et les paramètres clés
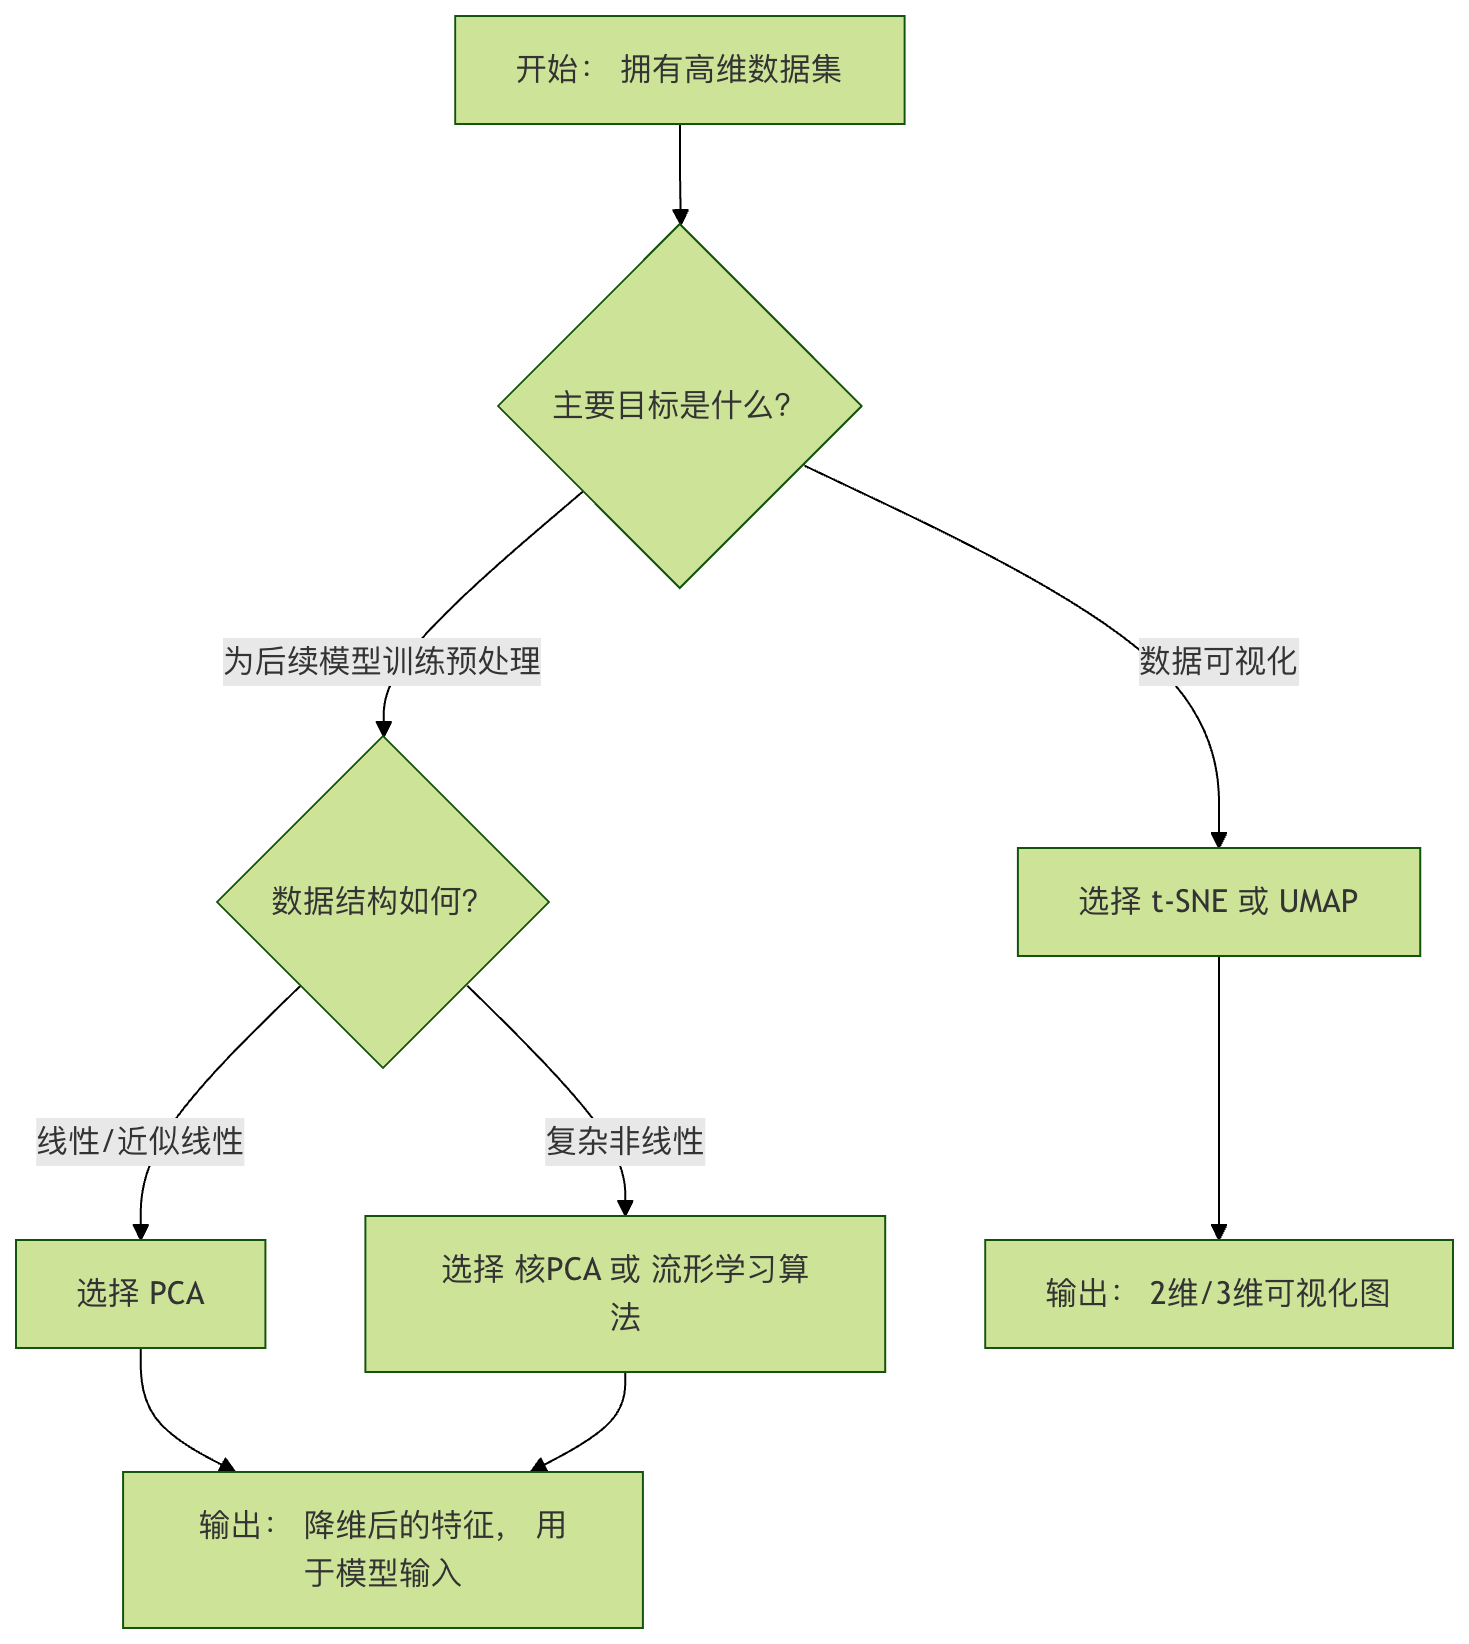
Organigramme de sélection d'algorithme
Guide des paramètres clés
PCA : n_components
- Peut être défini sur un entier (par exemple, 2) pour spécifier une dimension précise.
- Peut être défini à
0 < n < 1un nombre décimal (par ex., 0.95), signifiant conserverle ratio de variance expliquée cumuléeatteignant le seuil avec le nombre minimal de composantes principales.
Exemple
pca = PCA(n_components=0.95)
pca.fit(X)
print(f"Pour conserver 95% de la variance, {pca.n_components_} composantes principales sont nécessaires")
t-SNE : perplexity
- Les valeurs typiques sont comprises entre 5 et 50.
- Pour les petits jeux de données (<100 échantillons), des valeurs plus petites sont recommandées.
- La valeur optimale est généralement proche du nombre de "voisins" pour chaque point des données. Elle doit être choisie en expérimentant et en observant les résultats de visualisation.
Exercices pratiques et résumé
Exercice pratique : application de la réduction de dimensionnalité au jeu de données MNIST de chiffres manuscrits
Exemple
from sklearn.preprocessing import StandardScaler
# 1. Charger le jeu de données MNIST (prendre seulement un sous-ensemble d'échantillons pour accélérer)
mnist = fetch_openml('mnist_784', version=1, as_frame=False)
X_mnist, y_mnist = mnist.data[:3000] / 255.0, mnist.target[:3000] # Normaliser, prendre les 3000 premiers échantillons
print(f"Forme des données MNIST : {X_mnist.shape}") # (3000, 784) -> 784 dimensions!
# 2. Utiliser d'abord PCA pour réduire rapidement à 50 dimensions, en supprimant beaucoup de bruit
pca = PCA(n_components=50)
X_mnist_pca = pca.fit_transform(X_mnist)
print(f"Forme après PCA : {X_mnist_pca.shape}")
# 3. Utiliser ensuite t-SNE pour réduire les données de 50 dimensions à 2 dimensions pour la visualisation
tsne = TSNE(n_components=2, perplexity=40, n_iter=300, random_state=42)
X_mnist_tsne = tsne.fit_transform(X_mnist_pca)
# 4. Visualisation
plt.figure(figsize=(10, 8))
scatter = plt.scatter(X_mnist_tsne[:, 0], X_mnist_tsne[:, 1],
c=y_mnist.astype(int), cmap='tab10', alpha=0.6, s=5)
plt.colorbar(scatter, ticks=range(10), label='Chiffres manuscrits')
plt.title('Visualisation t-SNE du jeu de données MNIST de chiffres manuscrits après prétraitement PCA')
plt.xlabel('t-SNE 1')
plt.ylabel('t-SNE 2')
plt.grid(True, linestyle='--', alpha=0.3)
plt.show()
Objectif de l'exercice: Observer si différents chiffres (0-9) forment des clusters clairs sur le plan 2D. Essayez de modifierperplexityparamètres (par exemple, changez pour 10 ou 50) et voyez comment la visualisation change.
Résumé et points clés
L'essence de la réduction de dimensionnalité: Il s'agit d'une compression et d'une extraction d'informations, pas simplement de jeter des données. L'objectif estd'exprimer autant d'informations originales que possible avec moins de dimensions.。
PCA (le roi des méthodes linéaires): Trouve les directions linéaires les plus importantes des données en maximisant la variance. Efficace et stable, adapté au prétraitement et à la suppression des corrélations linéaires.
t-SNE (un outil puissant pour la visualisation): Révèle des structures non linéaires en conservant les similarités locales entre les points de données. L’effet est saisissant, mais il est lent et les résultats sont aléatoires, principalement utilisé pour l’analyse exploratoire des données.
Workflow:
- Clarifier l’objectif: S’agit-il de visualisation ou de fournir des caractéristiques plus raffinées pour les modèles en aval ?
- Exploration des données: Commencez par visualiser une partie des données pour avoir une idée préliminaire de leur linéarité/non-linéarité.
- Expérimentation de méthodes: Choisissez les algorithmes en fonction de l’objectif et de la structure des données, puis ajustez les paramètres clés.
- Évaluer les résultats: Évaluez l’effet de réduction de dimensionnalité via la visualisation, le taux de conservation de l’information ou les performances des tâches en aval.
La réduction de dimensionnalité est une clé pour percer la boîte noire des données de haute dimension.
En maîtrisant PCA et t-SNE, vous pouvez non seulement avoir un aperçu de la structure globale face à des données complexes, mais aussi préparer des caractéristiques allégées pour les modèles d’apprentissage automatique ultérieurs, ce qui améliore grandement l’efficacité et la profondeur de l’analyse des données.
Autres extensions