Распространённые типы данных
В этой главе вы познакомитесь с четырьмя наиболее распространёнными типами данных в машинном обучении: числовыми, текстовыми, изображениями и категориальными данными.
Типы данных похожи на виды ингредиентов, разные ингредиенты требуют разных способов обработки. Точно так же разные типы данных требуют разных методов обработки и алгоритмов.
Четыре основные категории типов данных
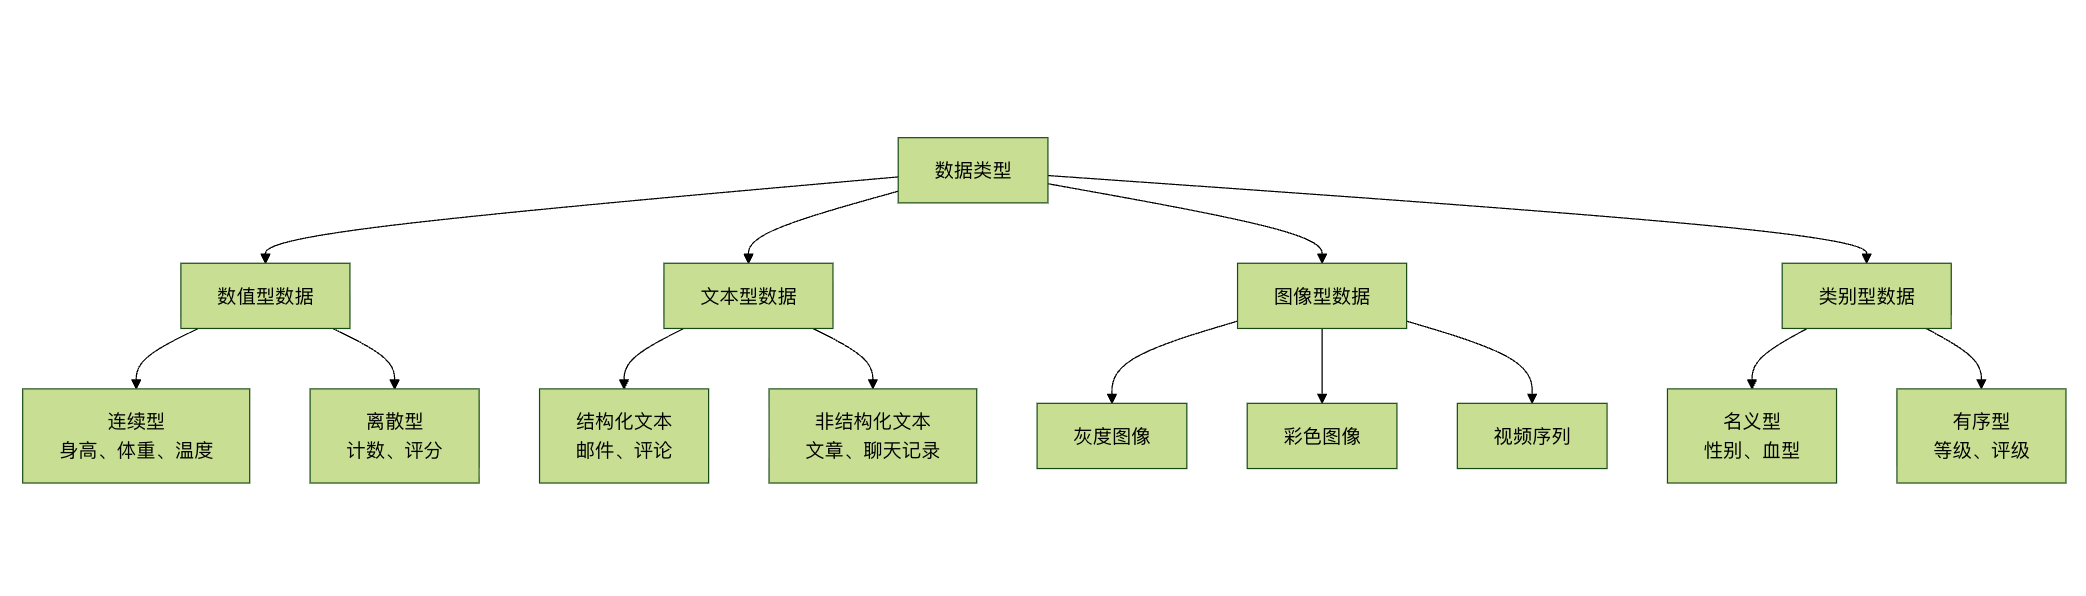
Числовые данные
Что такое числовые данные?
Числовые данные подобны результату измерения линейкой, с ними можно выполнять математические операции, и это самый распространённый тип данных в машинном обучении.
Классификация числовых данных
1. Непрерывные числовые данные
Пример
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
def continuous_data_example():
"""Пример непрерывных числовых данных"""
print("=== Пример непрерывных числовых данных ===")
# Сгенерировать непрерывные данные
np.random.seed(42)
n_samples = 1000
# Данные о росте (непрерывные)
heights = np.random.normal(170, 10, n_samples) # Среднее 170, стандартное отклонение 10
weights = heights * 0.7 + np.random.normal(0, 5, n_samples) # Вес коррелирует с ростом
temperatures = np.random.normal(36.5, 0.5, n_samples) # Температура тела
# Создать датафрейм
continuous_data = pd.DataFrame({
'Рост (см)': heights,
'Вес (кг)': weights,
'Температура тела (°C)': temperatures,
'Возраст': np.random.randint(18, 65, n_samples)
})
print("Пример непрерывных данных:")
print(continuous_data.head())
print(f"\nСтатистическая информация о данных:")
print(continuous_data.describe())
# Визуализировать распределение непрерывных данных
plt.figure(figsize=(12, 8))
plt.subplot(2, 2, 1)
plt.hist(continuous_data['Рост (см)'], bins=30, alpha=0.7, color='skyblue')
plt.title('Распределение роста')
plt.xlabel('Рост (cm)')
plt.ylabel('Частота')
plt.subplot(2, 2, 2)
plt.hist(continuous_data['Вес (kg)'], bins=30, alpha=0.7, color='lightgreen')
plt.title('Распределение веса')
plt.xlabel('Вес (kg)')
plt.ylabel('Частота')
plt.subplot(2, 2, 3)
plt.hist(continuous_data['Температура тела (°C)'], bins=30, alpha=0.7, color='salmon')
plt.title('Распределение температуры тела')
plt.xlabel('Температура тела (°C)')
plt.ylabel('Частота')
plt.subplot(2, 2, 4)
plt.scatter(continuous_data['Рост (cm)'], continuous_data['Вес (kg)'], alpha=0.6)
plt.title('Рост и вес')
plt.xlabel('Рост (cm)')
plt.ylabel('Вес (kg)')
plt.tight_layout()
plt.show()
return continuous_data
# Пример запуска
continuous_df = continuous_data_example()
. Дискретные числовые данные
Пример
def discrete_data_example():
"""Пример дискретных числовых данных"""
print("\n=== Пример дискретных числовых данных ===)
# Сгенерировать дискретные данные
np.random.seed(42)
n_samples = 500
# Дискретные данные
customer_count = np.random.poisson(10, n_samples) # Распределение Пуассона: количество клиентов
product_rating = np.random.randint(1, 6, n_samples) # Рейтинг от 1 до 5 звёзд
defect_count = np.random.binomial(20, 0.1, n_samples) # Биномиальное распределение: количество дефектов
call_duration = np.random.exponential(5, n_samples) * 60 # Экспоненциальное распределение: длительность звонка (секунды)
# Создать датафрейм
discrete_data = pd.DataFrame({
'Количество клиентов': customer_count,
'Рейтинг продукта': product_rating,
'Количество дефектов': defect_count,
'Длительность звонка (секунды)': call_duration.astype(int)
})
print("Пример дискретных данных:")
print(discrete_data.head())
print(f"\nСтатистическая информация о данных:")
print(discrete_data.describe())
# Визуализация дискретных данных
plt.figure(figsize=(12, 8))
plt.subplot(2, 2, 1)
plt.hist(discrete_data['Number of customers'], bins=range(0, max(discrete_data['Number of customers'])+2),
alpha=0.7, color='orange')
plt.title('Распределение количества клиентов')
plt.xlabel('Количество клиентов')
plt.ylabel('Частота')
plt.subplot(2, 2, 2)
value_counts = discrete_data['Product rating'].value_counts().sort_index()
plt.bar(value_counts.index, value_counts.values, color='purple', alpha=0.7)
plt.title('Распределение рейтинга продукта')
plt.xlabel('Рейтинг')
plt.ylabel('Частота')
plt.subplot(2, 2, 3)
plt.hist(discrete_data['Количество дефектов'], bins=range(0, max(discrete_data['Количество дефектов'])+2),
alpha=0.7, color='red')
plt.title('Распределение количества дефектов')
plt.xlabel('Количество дефектов')
plt.ylabel('Частота')
plt.subplot(2, 2, 4)
plt.hist(discrete_data['Длительность вызова (секунды)'], bins=30, alpha=0.7, color='brown')
plt.title('Распределение длительности вызова')
plt.xlabel('Длительность вызова (секунды)')
plt.ylabel('Частота')
plt.tight_layout()
plt.show()
return discrete_data
# Пример запуска
discrete_df = discrete_data_example()
Методы обработки числовых данных
Пример
class NumericDataProcessor:
def __init__(self):
self.scalers = {}
self.transformers = {}
def detect_outliers(self, data, method='iqr'):
"""Обнаружение выбросов"""
outliers_info = {}
for column in data.select_dtypes(include=[np.number]).columns:
if method == 'iqr':
Q1 = data[column].quantile(0.25)
Q3 = data[column].quantile(0.75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR
outliers = data[(data[column] < lower_bound) |
(data[column] > upper_bound)]
elif method == 'zscore':
z_scores = np.abs((data[column] - data[column].mean()) / data[column].std())
outliers = data[z_scores > 3]
outliers_info[column] = {
'count': len(outliers),
'indices': outliers.index.tolist(),
'percentage': (len(outliers) / len(data)) * 100
}
return outliers_info
def handle_missing_values(self, data, strategy='mean'):
"""Обработка пропущенных значений"""
processed_data = data.copy()
for column in processed_data.select_dtypes(include=[np.number]).columns:
if processed_data[column].isnull().sum() > 0:
if strategy == 'mean':
processed_data[column].fillna(processed_data[column].mean(), inplace=True)
elif strategy == 'median':
processed_data[column].fillna(processed_data[column].median(), inplace=True)
elif strategy == 'mode':
processed_data[column].fillna(processed_data[column].mode()[0], inplace=True)
elif strategy == 'forward':
processed_data[column].fillna(method='ffill', inplace=True)
elif strategy == 'backward':
processed_data[column].fillna(method='bfill', inplace=True)
return processed_data
def normalize_data(self, data, method='minmax'):
"""Стандартизация данных"""
from sklearn.preprocessing import MinMaxScaler, StandardScaler, RobustScaler
processed_data = data.copy()
numeric_columns = data.select_dtypes(include=[np.number]).columns
if method == 'minmax':
scaler = MinMaxScaler()
elif method == 'standard':
scaler = StandardScaler()
elif method == 'robust':
scaler = RobustScaler()
else:
raise ValueError("Метод должен быть 'minmax', 'standard' или 'robust'")
processed_data[numeric_columns] = scaler.fit_transform(processed_data[numeric_columns])
self.scalers[method] = scaler
return processed_data
def create_features(self, data):
"""Конструирование признаков"""
processed_data = data.copy()
numeric_columns = data.select_dtypes(include=[np.number]).columns
# Создание полиномиальных признаков
if len(numeric_columns) >= 2:
col1, col2 = numeric_columns[0], numeric_columns[1]
processed_data[f'{col1}_x_{col2}'] = data[col1] * data[col2]
processed_data[f'{col1}_div_{col2}'] = data[col1] / (data[col2] + 1e-8)
# Создание статистических признаков
for column in numeric_columns:
processed_data[f'{column}_log'] = np.log1p(data[column])
processed_data[f'{column}_sqrt'] = np.sqrt(np.abs(data[column]))
processed_data[f'{column}_square'] = data[column] ** 2
return processed_data
# Пример использования
processor = NumericDataProcessor()
# Обнаружение выбросов
outliers = processor.detect_outliers(continuous_df)
print("\nРезультаты обнаружения выбросов:")
for column, info in outliers.items():
if info['count'] > 0:
print(f"{column}: {info['count']} выбросов ({info['percentage']:.2f}%)")
# Стандартизация данных
normalized_data = processor.normalize_data(continuous_df, method='standard')
print("\nПример стандартизированных данных:")
print(normalized_data.head())
Текстовые данные
Что такое текстовые данные?
Текстовые данные подобны выражению человеческого языка, содержат богатую семантическую информацию, но требуют специальной обработки, прежде чем их можно будет использовать в моделях машинного обучения.
Классификация текстовых данных
1. Структурированные текстовые данные
Пример
import pandas as pd
import re
from collections import Counter
def structured_text_example():
"""Пример структурированных текстовых данных"""
print("\n=== Пример структурированных текстовых данных ===)
# Создание структурированных текстовых данных
structured_data = pd.DataFrame({
'Email ID': range(1, 11),
'Sender': [
'[email protected]', '[email protected]', '[email protected]',
'[email protected]', '[email protected]', '[email protected]',
'[email protected]', '[email protected]', '[email protected]',
'[email protected]'
],
'Тема': [
'Уведомление о встрече: встреча завтра в 3 часа дня',
'Коммерческое предложение: последний прайс-лист',
'Обратная связь клиентов: опрос удовлетворённости обслуживанием',
'Ход проекта: первый этап завершён',
'График праздников: уведомление о празднике Национального дня',
'Техническое обновление: объявление об обновлении системы',
'Научная конференция: уведомление о приёме докладов',
'Уведомление об обучении: обучение новых сотрудников',
'Документ политики: последние нормативные акты',
'Напоминание о здоровье: уведомление о медосмотре'
],
'Длина содержимого': [156, 234, 189, 145, 98, 267, 198, 134, 312, 87]
})
print("Пример структурированных текстовых данных:")
print(structured_data)
# Извлечение текстовых признаков
print("\n=== Анализ текстовых признаков ===)
# Анализ доменов электронной почты
domains = [email.split('@')[1] for email in structured_data['Sender']]
domain_counts = Counter(domains)
print(f"Распределение доменов электронной почты: {dict(domain_counts)}")
# Анализ ключевых слов темы
all_words = []
for subject in structured_data['Subject']:
words = re.findall(r'[\u4e00-\u9fff]+', subject) # Извлечение китайской лексики
all_words.extend(words)
word_counts = Counter(all_words)
print(f"Частота слов по темам: {dict(word_counts)}")
# Статистика длины содержимого
print(f"Статистика длины содержимого:")
print(structured_data['Content length'].describe())
return structured_data
# Пример запуска
structured_text_df = structured_text_example()
2. Неструктурированные текстовые данные
Пример
def unstructured_text_example():
"""Пример неструктурированных текстовых данных"""
print("\n=== Пример неструктурированных текстовых данных ===)
# Создание неструктурированных текстовых данных
unstructured_texts = [
"""
Технология искусственного интеллекта стремительно развивается, и в таких областях, как глубокое обучение, машинное обучение и обработка естественного языка, были достигнуты крупные прорывы.
Эти технологии широко применяются в различных отраслях, таких как здравоохранение, финансы, образование и транспорт, открывая новые возможности для общественного развития.
В будущем, с улучшением вычислительных мощностей и усовершенствованием алгоритмов, искусственный интеллект будет играть важную роль в большем числе областей.
""",
"""
Сегодня действительно хорошая погода, солнечно и с лёгким ветерком. Я решил прогуляться по парку и насладиться этим чудесным временем.
В парке много цветов: красных, жёлтых, фиолетовых, разноцветных и очень красивых. Маленькие птички поют на деревьях,
Бабочки танцуют среди цветов, и всё кажется таким гармоничным и естественным.
""",
"""
Сегодня фондовый рынок показал сильные результаты: индекс Shanghai Composite вырос на 2.3%, а индекс Shenzhen Component — на 1.8%.
Акции технологических компаний возглавили рост, многие акции достигли дневного лимита. Аналитики считают, что это в основном связано с недавно введенными благоприятными мерами.
Уверенность инвесторов укрепилась, торговля на рынке активна, а объём торгов значительно вырос.
""",
"""
Здоровый образ жизни включает сбалансированное питание, умеренные физические нагрузки, достаточный сон и позитивный настрой.
Рекомендуется ежедневно есть овощи и фрукты и сократить потребление жирной пищи; заниматься физическими упражнениями не менее 3 раз в неделю, каждое занятие — более 30 минут;
Обеспечьте себе 7-8 часов сна; научитесь регулировать эмоции и поддерживать позитивный и оптимистичный настрой.
"""
]
text_categories = ['Технологии', 'Жизнь', 'Финансы', 'Здоровье']
# Создать датафрейм
unstructured_df = pd.DataFrame({
'Текст': unstructured_texts,
'Категория': text_categories
})
print("Пример неструктурированных текстовых данных:")
for i, row in unstructured_df.iterrows():
print(f"\nКатегория: {row['类别']}")
print(f"Текст: {row['文本'][:100]}...")
return unstructured_df
# Пример запуска
unstructured_text_df = unstructured_text_example()
Методы обработки текстовых данных
Пример
# Методы обработки текстовых данных
import jieba
from sklearn.feature_extraction.text import TfidfVectorizer, CountVectorizer
from sklearn.preprocessing import LabelEncoder
class TextDataProcessor:
def __init__(self):
self.vectorizers = {}
self.label_encoders = {}
def clean_text(self, text):
"""Очистка текста"""
# Удалить специальные символы и цифры
text = re.sub(r'[^\u4e00-\u9fff\s]', '', text)
# Удалить лишние пробелы
text = re.sub(r'\s+', ' ', text).strip()
return text
def tokenize_chinese(self, text):
"""Сегментация китайского текста"""
words = jieba.lcut(text)
# Удалить стоп-слова (упрощённая версия)
stop_words = {'of', 'already', 'at', 'is', 'I', 'have', 'and', 'then', 'not', 'person', 'all', 'one', 'one', 'on', 'also', 'very', 'to', 'say', 'want', 'go', 'you', 'will', '-ing', 'none', 'see', 'good', 'self', '这'}
words = [word for word in words if word not in stop_words and len(words) > 1]
return words
def extract_features(self, texts, method='tfidf'):
"""Извлечение признаков"""
# Предобработка текста
cleaned_texts = [self.clean_text(text) for text in texts]
if method == 'tfidf':
vectorizer = TfidfVectorizer(max_features=1000, token_pattern=r'(?u)\b\w+\b')
elif method == 'count':
vectorizer = CountVectorizer(max_features=1000, token_pattern=r'(?u)\b\w+\b')
else:
raise ValueError("Метод должен быть 'tfidf' или 'count'")
features = vectorizer.fit_transform(cleaned_texts)
self.vectorizers[method] = vectorizer
return features.toarray(), vectorizer.get_feature_names_out()
def analyze_text_statistics(self, texts):
"""Статистический анализ текста"""
stats = []
for text in texts:
cleaned_text = self.clean_text(text)
words = self.tokenize_chinese(cleaned_text)
stats.append({
'Количество символов': len(text),
'Количество символов после очистки': len(cleaned_text),
'Количество слов': len(words),
'Средняя длина слова': np.mean([len(word) for word in words]) if words else 0,
'Количество уникальных слов': len(set(words))
})
return pd.DataFrame(stats)
def encode_labels(self, labels):
"""Кодирование меток"""
encoder = LabelEncoder()
encoded_labels = encoder.fit_transform(labels)
self.label_encoders['default'] = encoder
return encoded_labels, encoder.classes_
# Пример использования
text_processor = TextDataProcessor()
# Статистический анализ текста
text_stats = text_processor.analyze_text_statistics(unstructured_text_df['Text'])
print("\nСтатистический анализ текста: ")
print(text_stats)
# Извлечение признаков
features, feature_names = text_processor.extract_features(
unstructured_text_df['Text'], method='tfidf'
)
print(f"\nФорма матрицы признаков: {features.shape}")
print(f"Первые 10 признаков: {feature_names[:10]}")
# Кодирование меток
encoded_labels, label_classes = text_processor.encode_labels(
unstructured_text_df['Category']
)
print(f"\nЗакодированные метки: {encoded_labels}")
print(f"Классы меток: {label_classes}")
Данные изображений
Что такое данные изображений?
Данные изображений — это как цифровое представление визуального мира, состоящее из пикселей и содержащее богатую пространственную и цветовую информацию.
Классификация данных изображений
1. Изображение в оттенках серого
Пример
import numpy as np
import matplotlib.pyplot as plt
from PIL import Image
def grayscale_image_example():
"""Пример изображения в оттенках серого"""
print("\n=== Пример изображения в оттенках серого ===")
# Создать простое изображение в оттенках серого
# Создать изображение в оттенках серого 100x100
height, width = 100, 100
# Создать градиентное изображение
gradient = np.zeros((height, width))
for i in range(height):
gradient[i, :] = i # Вертикальный градиент
# Создать шахматный узор
checkerboard = np.zeros((height, width))
for i in range(0, height, 10):
for j in range(0, width, 10):
if (i // 10 + j // 10) % 2 == 0:
checkerboard[i:i+10, j:j+10] = 255
# Создать круговой узор
circle = np.zeros((height, width))
center_x, center_y = width // 2, height // 2
radius = 30
for i in range(height):
for j in range(width):
if (i - center_y) ** 2 + (j - center_x) ** 2 <= radius ** 2:
circle[i, j] = 255
# Отобразить изображение
plt.figure(figsize=(12, 4))
plt.subplot(1, 3, 1)
plt.imshow(gradient, cmap='gray')
plt.title('Градиентное изображение')
plt.axis('off')
plt.subplot(1, 3, 2)
plt.imshow(checkerboard, cmap='gray')
plt.title('Шахматный узор')
plt.axis('off')
plt.subplot(1, 3, 3)
plt.imshow(circle, cmap='gray')
plt.title('Узор из кругов')
plt.axis('off')
plt.tight_layout()
plt.show()
# Информация о данных изображения
print(f"Форма градиентного изображения: {gradient.shape}")
print(f"Тип данных: {gradient.dtype}")
print(f"Диапазон значений пикселей: {gradient.min()} - {gradient.max()}")
return gradient, checkerboard, circle
# Пример запуска
gradient_img, checkerboard_img, circle_img = grayscale_image_example()
2. Цветное изображение
Пример
def color_image_example():
"""Пример цветного изображения"""
print("\n=== Пример цветного изображения ===")
height, width = 100, 100
# Создать цветное RGB-изображение
# Красный градиент
red_gradient = np.zeros((height, width, 3), dtype=np.uint8)
red_gradient[:, :, 0] = np.linspace(0, 255, width) # Градиент красного канала
# Зелёный градиент
green_gradient = np.zeros((height, width, 3), dtype=np.uint8)
green_gradient[:, :, 1] = np.linspace(0, 255, width) # Градиент зелёного канала
# Синий градиент
blue_gradient = np.zeros((height, width, 3), dtype=np.uint8)
blue_gradient[:, :, 2] = np.linspace(0, 255, width) # Градиент синего канала
# Узор радуги
rainbow = np.zeros((height, width, 3), dtype=np.uint8)
for i in range(width):
hue = i / width
# Упрощённое преобразование HSV в RGB
if hue < 1/3:
rainbow[:, i] = [255 * (1 - 3*hue), 255 * 3*hue, 0]
elif hue < 2/3:
rainbow[:, i] = [0, 255 * (2 - 3*hue), 255 * (3*hue - 1)]
else:
rainbow[:, i] = [255 * (3*hue - 2), 0, 255 * (3 - 3*hue)]
# Отобразить изображение
plt.figure(figsize=(12, 8))
plt.subplot(2, 2, 1)
plt.imshow(red_gradient)
plt.title('Красный градиент')
plt.axis('off')
plt.subplot(2, 2, 2)
plt.imshow(green_gradient)
plt.title('Зелёный градиент')
plt.axis('off')
plt.subplot(2, 2, 3)
plt.imshow(blue_gradient)
plt.title('Синий градиент')
plt.axis('off')
plt.subplot(2, 2, 4)
plt.imshow(rainbow)
plt.title('Радужный узор')
plt.axis('off')
plt.tight_layout()
plt.show()
# Информация о каналах изображения
print(f"Форма цветного изображения: {rainbow.shape}")
print(f"Тип данных: {rainbow.dtype}")
print(f"Диапазон значений пикселей: {rainbow.min()} - {rainbow.max()}")
return red_gradient, green_gradient, blue_gradient, rainbow
# Пример запуска
red_img, green_img, blue_img, rainbow_img = color_image_example()
Методы обработки данных изображений
Пример
# Методы обработки данных изображений
from skimage import filters, feature, measure, transform
from skimage.color import rgb2gray, rgb2hsv
class ImageDataProcessor:
def __init__(self):
pass
def resize_image(self, image, target_size):
"""Изменение размера изображения"""
from skimage.transform import resize
return resize(image, target_size, anti_aliasing=True)
def normalize_image(self, image):
"""Нормализация изображения"""
return (image - image.min()) / (image.max() - image.min())
def extract_color_features(self, image):
"""Извлечь цветовые признаки"""
if len(image.shape) == 3: # Цветное изображение
# Вычислить статистические признаки для каждого канала
features = {}
for i, channel in enumerate(['R', 'G', 'B']):
channel_data = image[:, :, i]
features[f'{channel}_mean'] = np.mean(channel_data)
features[f'{channel}_std'] = np.std(channel_data)
features[f'{channel}_min'] = np.min(channel_data)
features[f'{channel}_max'] = np.max(channel_data)
# Вычислить признаки цветовой гистограммы
hist_r, _ = np.histogram(image[:, :, 0], bins=256, range=(0, 256))
hist_g, _ = np.histogram(image[:, :, 1], bins=256, range=(0, 256))
hist_b, _ = np.histogram(image[:, :, 2], bins=256, range=(0, 256))
features.update({
'hist_r_peak': np.argmax(hist_r),
'hist_g_peak': np.argmax(hist_g),
'hist_b_peak': np.argmax(hist_b)
})
return features
else: # Изображение в оттенках серого
return {
'mean': np.mean(image),
'std': np.std(image),
'min': np.min(image),
'max': np.max(image)
}
def extract_texture_features(self, image):
"""Извлечение текстурных признаков"""
if len(image.shape) == 3:
image = rgb2gray(image)
# Вычислить признаки краёв
edges = filters.sobel(image)
edge_density = np.sum(edges > 0) / edges.size
# Вычислить локальный бинарный шаблон (упрощённая версия)
lbp = feature.local_binary_pattern(image, P=8, R=1, method='uniform')
lbp_hist, _ = np.histogram(lbp.ravel(), bins=10)
return {
'edge_density': edge_density,
'lbp_hist': lbp_hist.tolist()
}
def augment_image(self, image):
"""Аугментация изображения"""
augmented = []
# Исходное изображение
augmented.append(image)
# Горизонтальное отражение
augmented.append(np.fliplr(image))
# Вертикальное отражение
augmented.append(np.flipud(image))
# Поворот на 90 градусов
augmented.append(np.rot90(image))
# Регулировка яркости
if len(image.shape) == 3:
brightened = np.clip(image * 1.2, 0, 255).astype(np.uint8)
else:
brightened = np.clip(image * 1.2, 0, 1)
augmented.append(brightened)
return augmented
def visualize_image_channels(self, image):
"""Визуализация каналов изображения"""
if len(image.shape) == 3:
plt.figure(figsize=(12, 3))
plt.subplot(1, 4, 1)
plt.imshow(image)
plt.title('Оригинальное изображение')
plt.axis('off')
plt.subplot(1, 4, 2)
plt.imshow(image[:, :, 0], cmap='Reds')
plt.title('Красный канал')
plt.axis('off')
plt.subplot(1, 4, 3)
plt.imshow(image[:, :, 1], cmap='Зелёные')
plt.title('Зелёный канал')
plt.axis('off')
plt.subplot(1, 4, 4)
plt.imshow(image[:, :, 2], cmap='Синие')
plt.title('Синий канал')
plt.axis('off')
plt.tight_layout()
plt.show()
# Пример использования
image_processor = ImageDataProcessor()
# Извлечь цветовые признаки
color_features = image_processor.extract_color_features(rainbow_img)
print("\nЦветовые признаки: ")
for key, value in color_features.items():
if not key.startswith('hist'):
print(f"{key}: {value:.2f}")
# Извлечение текстурных признаков
texture_features = image_processor.extract_texture_features(checkerboard_img)
print("\nТекстурные признаки: ")
for key, value in texture_features.items():
if key != 'lbp_hist':
print(f"{key}: {value:.4f}")
# Аугментация изображений
augmented_images = image_processor.augment_image(circle_img)
print(f"\nАугментация изображений: сгенерировано {len(augmented_images)} вариантов")
# Визуализация каналов изображения
image_processor.visualize_image_channels(rainbow_img)
Категориальные данные
Что такое категориальные данные?
Категориальные данные похожи на метки классификации, представляющие различные категории или группы, и они не могут подвергаться математическим операциям.
Классификация категориальных данных
1. Номинальные данные
Пример
def nominal_data_example():
"""Пример номинальных данных"""
print("\n=== Пример номинальных данных ===")
# Создание номинальных данных
nominal_data = pd.DataFrame({
'Student ID': range(1, 11),
'Имя': ['Чжан Сань', 'Ли Сы', 'Ван У', 'Zhao Liu', 'Qian Qi', 'Sun Ba', 'Zhou Jiu', 'У Ши', 'Чжэн Шии', 'Чэнь Шиэр'],
'Пол': ['Мужской', 'Женский', 'Мужской', 'Мужской', 'Женский', 'Женский', 'Мужской', 'Женский', 'Мужской', 'Женский'],
'Группа крови': ['A', 'B', 'O', 'AB', 'A', 'B', 'O', 'AB', 'A', 'O'],
'Город': ['Пекин', 'Шанхай', 'Гуанчжоу', 'Шэньчжэнь', 'Пекин', 'Шанхай', 'Гуанчжоу', 'Шэньчжэнь', 'Пекин', 'Шанхай'],
'Специальность': ['Информатика', 'Математика', 'Физика', 'Химия', 'Информатика', 'Математика', 'Физика', 'Химия', 'Информатика', 'Математика']
})
print("Пример номинальных данных:")
print(nominal_data)
# Категориальный статистический анализ
print("\n=== Категориальный статистический анализ ===)
for column in nominal_data.select_dtypes(include=['object']).columns:
if column != 'Name': # Пропустить столбец Name
value_counts = nominal_data[column].value_counts()
print(f"\n{column} распределение:")
print(value_counts)
print(f"Количество уникальных значений: {len(value_counts)}")
return nominal_data
# Пример запуска
nominal_df = nominal_data_example()
2. Порядковые данные
Пример
def ordinal_data_example():
"""Пример порядковых данных"""
print("\n=== Пример порядковых данных ===)
# Создание порядковых данных
ordinal_data = pd.DataFrame({
'Product ID': range(1, 11),
'Product Name': [f'Product {i}' for i in range(1, 11)],
'Quality Rating': ['Excellent', 'Good', 'Average', 'Excellent', 'Good', 'Average', 'Poor', 'Отлично', 'Хорошо', 'Средне'],
'Удовлетворённость клиентов': ['Очень удовлетворён', 'Удовлетворён', 'Нейтрально', 'Очень удовлетворён', 'Удовлетворён', 'Нейтрально', 'Не удовлетворён', 'Очень удовлетворён', 'Удовлетворён', 'Нейтрально'],
'Диапазон цен': ['Высокий', 'Средний', 'Низкий', 'Высокий', 'Средний', 'Низкий', 'Низкий', 'Высокий', 'Средний', 'Средний'],
'Рейтинг продаж': [1, 3, 5, 2, 4, 7, 9, 6, 8, 10]
})
print("Пример порядковых данных:")
print(ordinal_data)
# Статистический анализ порядковых данных
print("\n=== Статистический анализ порядковых данных ===)
# Определить порядок
quality_order = ['Плохое', 'Среднее', 'Хорошее', 'Отличное']
satisfaction_order = ['Недоволен', 'Нейтрально', 'Доволен', 'Очень доволен']
price_order = ['Низкий', 'Средний', 'Высокий']
# Преобразовать в порядковые категории
ordinal_data['quality_rating_ordered'] = pd.Categorical(
ordinal_data['quality_rating'], categories=quality_order, ordered=True
)
ordinal_data['customer_satisfaction_ordered'] = pd.Categorical(
ordinal_data['customer_satisfaction'], categories=satisfaction_order, ordered=True
)
ordinal_data['price_range_ordered'] = pd.Categorical(
ordinal_data['price_range'], categories=price_order, ordered=True
)
# Статистический анализ
for column in ['quality_rating_ordered', 'customer_satisfaction_ordered', 'price_range_ordered']:
print(f"\n{column} распределение:")
value_counts = ordinal_data[column].value_counts().sort_index()
print(value_counts)
# Вычислить медиану
median_value = ordinal_data[column].median()
print(f"Медиана: {median_value}")
return ordinal_data
# Пример запуска
ordinal_df = ordinal_data_example()
Методы обработки категориальных данных
Пример
# Методы обработки категориальных данных
from sklearn.preprocessing import LabelEncoder, OneHotEncoder, OrdinalEncoder
class CategoricalDataProcessor:
def __init__(self):
self.encoders = {}
self.feature_names = {}
def label_encoding(self, data, columns):
"""Кодирование меток"""
encoded_data = data.copy()
for column in columns:
encoder = LabelEncoder()
encoded_data[f'{column}_encoded'] = encoder.fit_transform(data[column])
self.encoders[f'{column}_label'] = encoder
print(f"{column} кодирование меток:")
for i, category in enumerate(encoder.classes_):
print(f" {category} -> {i}")
return encoded_data
def one_hot_encoding(self, data, columns):
"""Одноразрядное кодирование"""
encoded_data = data.copy()
for column in columns:
encoder = OneHotEncoder(sparse=False, drop='first') # Избежать мультиколлинеарности
encoded_features = encoder.fit_transform(data[[column]])
# Создать имена новых столбцов
feature_names = [f'{column}_{category}' for category in encoder.categories_[0][1:]]
# Добавить в DataFrame
for i, feature_name in enumerate(feature_names):
encoded_data[feature_name] = encoded_features[:, i]
self.encoders[f'{column}_onehot'] = encoder
self.feature_names[f'{column}_onehot'] = feature_names
print(f"{column} one-hot кодирование: создано {len(feature_names)} признаков")
return encoded_data
def ordinal_encoding(self, data, columns, categories_list):
"""Порядковое кодирование"""
encoded_data = data.copy()
for column, categories in zip(columns, categories_list):
encoder = OrdinalEncoder(categories=[categories])
encoded_data[f'{column}_ordinal'] = encoder.fit_transform(data[[column]])
self.encoders[f'{column}_ordinal'] = encoder
print(f"{column} порядковое кодирование:")
for i, category in enumerate(categories):
print(f" {category} -> {i}")
return encoded_data
def target_encoding(self, data, categorical_column, target_column):
"""Целевое кодирование"""
encoded_data = data.copy()
# Вычислить среднее целевой переменной для каждой категории
target_means = data.groupby(categorical_column)[target_column].mean()
# Применить кодирование
encoded_data[f'{categorical_column}_target'] = data[categorical_column].map(target_means)
print(f"{categorical_column} целевое кодирование:")
for category, mean_value in target_means.items():
print(f" {category} -> {mean_value:.4f}")
return encoded_data
def frequency_encoding(self, data, columns):
"""Частотное кодирование"""
encoded_data = data.copy()
for column in columns:
# Вычислить частоту для каждой категории
frequency = data[column].value_counts(normalize=True)
# Применить кодирование
encoded_data[f'{column}_frequency'] = data[column].map(частота)
print(f"{column} частотное кодирование:")
for category, freq in frequency.head().items():
print(f" {category} -> {freq:.4f}")
return encoded_data
def analyze_categorical_importance(self, data, categorical_columns, target_column):
"""Анализ важности категориальных признаков"""
importance_scores = {}
for column in categorical_columns:
# Вычислить разницу средних значений целевой переменной для каждой категории
category_means = data.groupby(column)[target_column].mean()
mean_difference = category_means.max() - category_means.min()
# Вычислить количество категорий
unique_count = data[column].nunique()
# Простая оценка важности
importance = mean_difference * np.log(unique_count + 1)
importance_scores[column] = importance
# Сортировка
sorted_importance = sorted(importance_scores.items(), key=lambda x: x[1], reverse=True)
print("\nВажность категориального признака:")
for column, importance in sorted_importance:
print(f"{column}: {importance:.4f}")
return importance_scores
# Пример использования
cat_processor = CategoricalDataProcessor()
# Добавить числовую целевую переменную для номинальных данных
nominal_df_with_target = nominal_df.copy()
nominal_df_with_target['Score'] = np.random.randint(60, 100, len(nominal_df))
# Кодирование меток
label_encoded = cat_processor.label_encoding(
nominal_df_with_target, ['Gender', 'Blood Type', 'City']
)
# Одноразрядное кодирование
onehot_encoded = cat_processor.one_hot_encoding(
nominal_df_with_target, ['Major']
)
# Целевое кодирование
target_encoded = cat_processor.target_encoding(
nominal_df_with_target, 'City', 'Score'
)
# Частотное кодирование
frequency_encoded = cat_processor.frequency_encoding(
nominal_df_with_target, ['Gender', 'Blood Type']
)
# Анализ важности признаков
importance_scores = cat_processor.analyze_categorical_importance(
nominal_df_with_target, ['Gender', 'Blood Type', 'City', 'Major'], 'Score'
)
Мультимодальное объединение данных
Пример объединения типов данных
Пример
class MultiModalDataProcessor:
def __init__(self):
self.numeric_processor = NumericDataProcessor()
self.text_processor = TextDataProcessor()
self.image_processor = ImageDataProcessor()
self.categorical_processor = CategoricalDataProcessor()
def create_multimodal_dataset(self):
"""Создать мультимодальный набор данных"""
print("\n=== Пример мультимодального набора данных ===)
n_samples = 100
# Числовые признаки
numeric_features = {
'Возраст': np.random.randint(18, 65, n_samples),
'Доход': np.random.normal(50000, 15000, n_samples),
'Опыт работы': np.random.randint(0, 20, n_samples)
}
# Категориальные признаки
categorical_features = {
'Пол': np.random.choice(['Мужской', 'Женский'], n_samples),
'Уровень образования': np.random.choice(['Среднее образование', "Бакалавр", "Магистр", 'PhD'], n_samples),
'Город': np.random.choice(['Пекин', 'Шанхай', 'Гуанчжоу', 'Шэньчжэнь'], n_samples)
}
# Текстовые признаки
text_features = [
f"Это текстовое описание образца {i}, содержащее некоторую базовую информацию и признаки."
for i in range(n_samples)
]
# Признаки изображений (смоделированные)
image_features = np.random.rand(n_samples, 64, 64, 3) # Симулировать 64x64 цветные изображения
# Целевая переменная
target = np.random.choice([0, 1], n_samples)
# Создание набора данных
dataset = {
'numeric': pd.DataFrame(numeric_features),
'categorical': pd.DataFrame(categorical_features),
'text': text_features,
'image': image_features,
'target': target
}
print(f"Размер набора данных: {n_samples}")
print(f"Числовые признаки: {list(numeric_features.keys())}")
print(f"Категориальные признаки: {list(categorical_features.keys())}")
print(f"Текстовые признаки: {len(text_features)} записей")
print(f"Признаки изображения: {image_features.shape}")
print(f"Целевая переменная: {np.bincount(target)}")
return dataset
def process_multimodal_data(self, dataset):
"""Обработка мультимодальных данных"""
print("\n=== Обработка мультимодальных данных ===)
processed_features = {}
# Обработка числовых признаков
numeric_data = dataset['numeric']
numeric_processed = self.numeric_processor.normalize_data(numeric_data, method='standard')
processed_features['numeric'] = numeric_processed
# Обработка категориальных признаков
categorical_data = dataset['categorical']
categorical_processed = self.categorical_processor.one_hot_encoding(
categorical_data, list(categorical_data.columns)
)
# Оставить только закодированные столбцы
categorical_encoded = categorical_processed.select_dtypes(include=[np.число])
processed_features['categorical'] = categorical_encoded
# Обработка текстовых признаков
text_data = dataset['text']
text_features, _ = self.text_processor.extract_features(text_data, method='tfidf')
processed_features['text'] = text_features
# Обработка признаков изображения
image_data = dataset['image']
# Извлечь простые признаки изображения (среднее, стандартное отклонение и т. д.)
image_features = []
for img in image_data:
features = self.image_processor.extract_color_features(img)
feature_vector = list(features.values())[:10] # Взять первые 10 признаков
image_features.append(feature_vector)
processed_features['image'] = np.array(image_features)
# Вывести результаты обработки
for modality, features in processed_features.items():
if isinstance(features, pd.DataFrame):
print(f"{modality} признаки: {features.shape}")
else:
print(f"{modality} признаки: {features.shape}")
return processed_features
def fuse_features(self, processed_features):
"""Объединение признаков"""
print("\n=== Объединение признаков ===)
# Объединить все признаки
feature_arrays = []
for modality, features in processed_features.items():
if isinstance(features, pd.DataFrame):
feature_arrays.append(features.values)
else:
feature_arrays.append(features)
# Горизонтальная конкатенация
fused_features = np.hstack(feature_arrays)
print(f"Форма объединённых признаков: {fused_features.shape}")
return fused_features
# Пример использования
multimodal_processor = MultiModalDataProcessor()
# Создать мультимодальный набор данных
multimodal_dataset = multimodal_processor.create_multimodal_dataset()
# Обработать мультимодальные данные
processed_multimodal = multimodal_processor.process_multimodal_data(multimodal_dataset)
# Объединение признаков
fused_features = multimodal_processor.fuse_features(processed_multimodal)