Types de données courants
Ce chapitre vous présentera les quatre types de données les plus courants en apprentissage automatique : données numériques, textuelles, d'image et catégorielles.
Les types de données sont comme les sortes d'ingrédients, différents ingrédients nécessitent différentes méthodes de traitement. De même, différents types de données nécessitent également différentes techniques de traitement et algorithmes.
Quatre grandes catégories de types de données
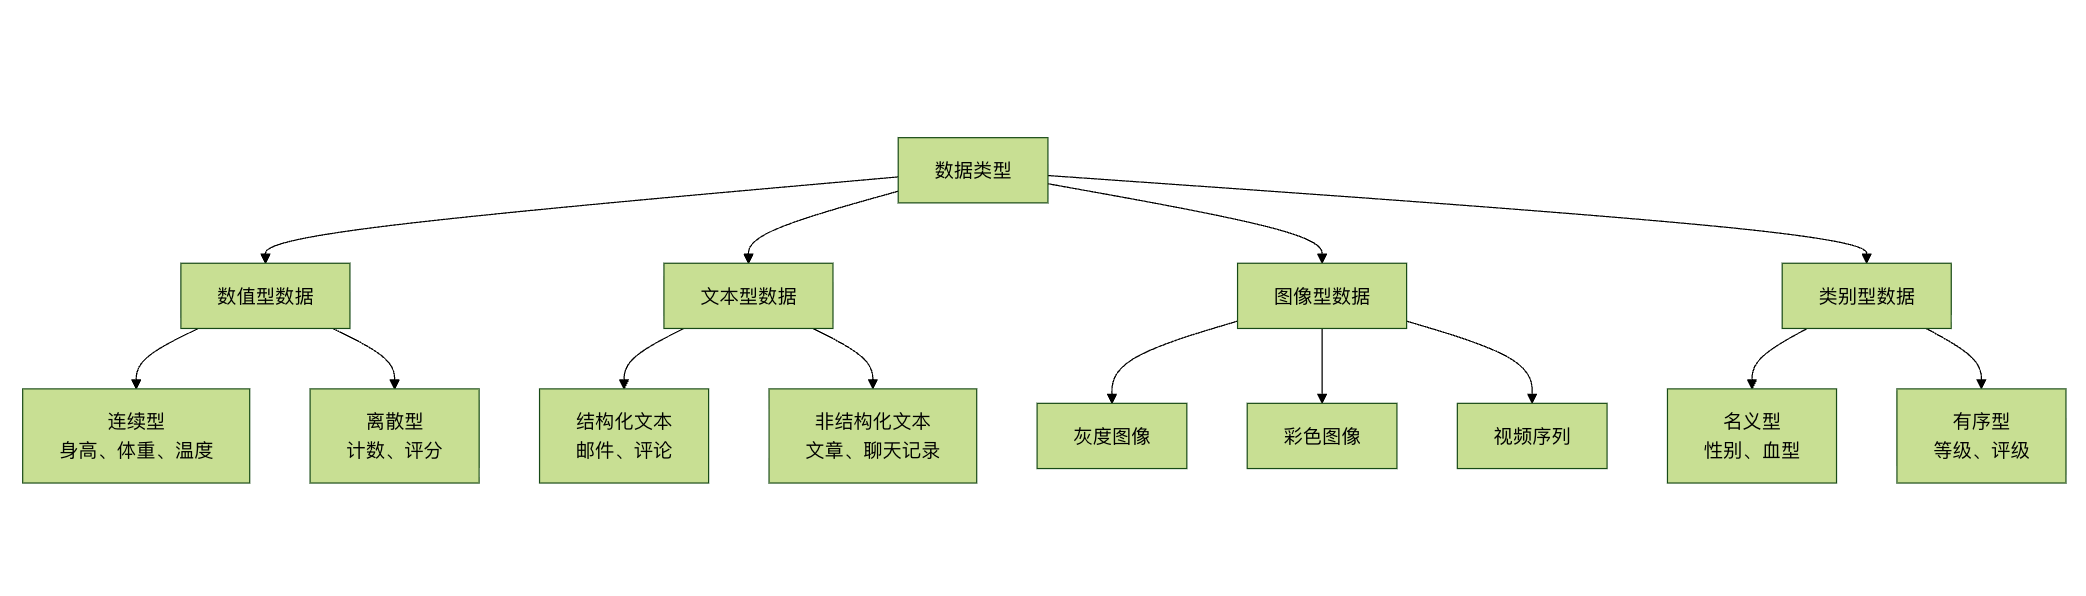
Données numériques
Qu'est-ce que les données numériques ?
Les données numériques sont comme le résultat d'une mesure à la règle, permettent d'effectuer des opérations mathématiques et sont le type de données le plus courant en apprentissage automatique.
Classification des données numériques
1. Données numériques continues
Exemple
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
def continuous_data_example():
"""Exemple de données numériques continues"""
print("=== Exemple de données numériques continues ===")
# Générer des données continues
np.random.seed(42)
n_samples = 1000
# Données de taille (continues)
heights = np.random.normal(170, 10, n_samples) # Moyenne 170, écart-type 10
weights = heights * 0.7 + np.random.normal(0, 5, n_samples) # Le poids est corrélé à la taille
temperatures = np.random.normal(36.5, 0.5, n_samples) # Température corporelle
# Créer un DataFrame
continuous_data = pd.DataFrame({
'Height (cm)': heights,
'Weight (kg)': weights,
'Body temperature (°C)': temperatures,
'Age': np.random.randint(18, 65, n_samples)
})
print("Exemple de données continues :")
print(continuous_data.head())
print(f"\nInformations statistiques sur les données :")
print(continuous_data.describe())
# Visualiser la distribution des données continues
plt.figure(figsize=(12, 8))
plt.subplot(2, 2, 1)
plt.hist(continuous_data['Height (cm)'], bins=30, alpha=0.7, color='skyblue')
plt.title('Distribution de la taille')
plt.xlabel('Taille (cm)')
plt.ylabel('Fréquence')
plt.subplot(2, 2, 2)
plt.hist(continuous_data['Poids (kg)'], bins=30, alpha=0.7, color='lightgreen')
plt.title('Distribution du poids')
plt.xlabel('Poids (kg)')
plt.ylabel('Fréquence')
plt.subplot(2, 2, 3)
plt.hist(continuous_data['Température corporelle (°C)'], bins=30, alpha=0.7, color='salmon')
plt.title('Distribution de la température corporelle')
plt.xlabel('Température corporelle (°C)')
plt.ylabel('Fréquence')
plt.subplot(2, 2, 4)
plt.scatter(continuous_data['Taille (cm)'], continuous_data['Poids (kg)'], alpha=0.6)
plt.title('Taille vs Poids')
plt.xlabel('Taille (cm)')
plt.ylabel('Poids (kg)')
plt.tight_layout()
plt.show()
return continuous_data
# Exemple d'exécution
continuous_df = continuous_data_example()
. Données numériques discrètes
Exemple
def discrete_data_example():
"""Exemple de données numériques discrètes"""
print("\n=== Exemple de données numériques discrètes ===)
# Générer des données discrètes
np.random.seed(42)
n_samples = 500
# Données discrètes
customer_count = np.random.poisson(10, n_samples) # Distribution de Poisson : nombre de clients
product_rating = np.random.randint(1, 6, n_samples) # Évaluation par étoiles de 1 à 5
defect_count = np.random.binomial(20, 0.1, n_samples) # Distribution binomiale : nombre de défauts
call_duration = np.random.exponential(5, n_samples) * 60 # Distribution exponentielle : durée d'appel (secondes)
# Créer un DataFrame
discrete_data = pd.DataFrame({
'Nombre de clients': customer_count,
'Évaluation du produit': product_rating,
'Nombre de défauts': defect_count,
'Durée d'appel (secondes)': call_duration.astype(int)
})
print("Exemple de données discrètes:")
print(discrete_data.head())
print(f"\nInformations statistiques sur les données :")
print(discrete_data.describe())
# Visualiser les données discrètes
plt.figure(figsize=(12, 8))
plt.subplot(2, 2, 1)
plt.hist(discrete_data['Nombre de clients'], bins=range(0, max(discrete_data['Nombre de clients'])+2),
alpha=0.7, color='orange')
plt.title('Distribution du nombre de clients')
plt.xlabel('Nombre de clients')
plt.ylabel('Fréquence')
plt.subplot(2, 2, 2)
value_counts = discrete_data['Note du produit'].value_counts().sort_index()
plt.bar(value_counts.index, value_counts.values, color='purple', alpha=0.7)
plt.title('Distribution des notes du produit')
plt.xlabel('Note')
plt.ylabel('Fréquence')
plt.subplot(2, 2, 3)
plt.hist(discrete_data['Nombre de défauts'], bins=range(0, max(discrete_data['Nombre de défauts'])+2),
alpha=0.7, color='red')
plt.title('Distribution du nombre de défauts')
plt.xlabel('Nombre de défauts')
plt.ylabel('Fréquence')
plt.subplot(2, 2, 4)
plt.hist(discrete_data['Durée d'appel (secondes)'], bins=30, alpha=0.7, color='brown')
plt.title('Distribution de la durée d'appel')
plt.xlabel('Durée d'appel (secondes)')
plt.ylabel('Fréquence')
plt.tight_layout()
plt.show()
return discrete_data
# Exemple d'exécution
discrete_df = discrete_data_example()
Méthodes de traitement des données numériques
Exemple
class NumericDataProcessor:
def __init__(self):
self.scalers = {}
self.transformers = {}
def detect_outliers(self, data, method='iqr'):
"""Détecter les valeurs aberrantes"""
outliers_info = {}
for column in data.select_dtypes(include=[np.number]).columns:
if method == 'iqr':
Q1 = data[column].quantile(0.25)
Q3 = data[column].quantile(0.75)
IQR = Q3 - Q1
lower_bound = Q1 - 1.5 * IQR
upper_bound = Q3 + 1.5 * IQR
outliers = data[(data[column] < lower_bound) |
(data[column] > upper_bound)]
elif method == 'zscore':
z_scores = np.abs((data[column] - data[column].mean()) / data[column].std())
outliers = data[z_scores > 3]
outliers_info[column] = {
'count': len(outliers),
'indices': outliers.index.tolist(),
'percentage': (len(outliers) / len(data)) * 100
}
return outliers_info
def handle_missing_values(self, data, strategy='mean'):
"""Gérer les valeurs manquantes"""
processed_data = data.copy()
for column in processed_data.select_dtypes(include=[np.number]).columns:
if processed_data[column].isnull().sum() > 0:
if strategy == 'mean':
processed_data[column].fillna(processed_data[column].mean(), inplace=True)
elif strategy == 'median':
processed_data[column].fillna(processed_data[column].median(), inplace=True)
elif strategy == 'mode':
processed_data[column].fillna(processed_data[column].mode()[0], inplace=True)
elif strategy == 'forward':
processed_data[column].fillna(method='ffill', inplace=True)
elif strategy == 'backward':
processed_data[column].fillna(method='bfill', inplace=True)
return processed_data
def normalize_data(self, data, method='minmax'):
"""Standardisation des données"""
from sklearn.preprocessing import MinMaxScaler, StandardScaler, RobustScaler
processed_data = data.copy()
numeric_columns = data.select_dtypes(include=[np.number]).columns
if method == 'minmax':
scaler = MinMaxScaler()
elif method == 'standard':
scaler = StandardScaler()
elif method == 'robust':
scaler = RobustScaler()
else:
raise ValueError("La méthode doit être 'minmax', 'standard' ou 'robust'")
processed_data[numeric_columns] = scaler.fit_transform(processed_data[numeric_columns])
self.scalers[method] = scaler
return processed_data
def create_features(self, data):
"""Ingénierie des caractéristiques"""
processed_data = data.copy()
numeric_columns = data.select_dtypes(include=[np.number]).columns
# Créer des caractéristiques polynomiales
if len(numeric_columns) >= 2:
col1, col2 = numeric_columns[0], numeric_columns[1]
processed_data[f'{col1}_x_{col2}'] = data[col1] * data[col2]
processed_data[f'{col1}_div_{col2}'] = data[col1] / (data[col2] + 1e-8)
# Créer des caractéristiques statistiques
for column in numeric_columns:
processed_data[f'{column}_log'] = np.log1p(data[column])
processed_data[f'{column}_sqrt'] = np.sqrt(np.abs(data[column]))
processed_data[f'{column}_square'] = data[column] ** 2
return processed_data
# Exemple d'utilisation
processor = NumericDataProcessor()
# Détecter les valeurs aberrantes
outliers = processor.detect_outliers(continuous_df)
print("\nRésultats de détection des valeurs aberrantes:")
for column, info in outliers.items():
if info['count'] > 0:
print(f"{column}: {info['count']} outliers ({info['percentage']:.2f}%)")
# Standardisation des données
normalized_data = processor.normalize_data(continuous_df, method='standard')
print("\nStandardized data example:")
print(normalized_data.head())
Données textuelles
Qu'est-ce que les données textuelles ?
Les données textuelles sont comme l'expression du langage humain, elles contiennent de riches informations sémantiques, mais nécessitent un traitement spécial avant de pouvoir être utilisées par les modèles d'apprentissage automatique.
Classification des données textuelles
1. Données textuelles structurées
Exemple
import pandas as pd
import re
from collections import Counter
def structured_text_example():
"""Exemple de données textuelles structurées"""
print("\n=== Exemple de données textuelles structurées ===)
# Créer des données textuelles structurées
structured_data = pd.DataFrame({
'Email ID': range(1, 11),
'Sender': [
'[email protected]', '[email protected]', '[email protected]',
'[email protected]', '[email protected]', '[email protected]',
'[email protected]', '[email protected]', '[email protected]',
'[email protected]'
],
'Objet': [
'Avis de réunion : réunion à 3 pm demain',
'Devis produit : dernière liste de prix',
'Retour client : enquête sur la satisfaction du service',
'Avancement du projet : première phase terminée',
'Organisation des congés : avis de congé pour la Fête nationale',
'Mise à jour technique : annonce de mise à niveau du système',
'Conférence académique : avis d'appel à communications',
'Avis de formation : formation des nouveaux employés',
'Document de politique : dernières réglementations',
'Rappel santé : avis d'examen médical'
],
'Longueur du contenu': [156, 234, 189, 145, 98, 267, 198, 134, 312, 87]
})
print("Exemple de données textuelles structurées :")
print(structured_data)
# Extraction de caractéristiques textuelles
print("\n=== Analyse des caractéristiques textuelles ===)
# Analyse des domaines de messagerie
domains = [email.split('@')[1] for email in structured_data['Sender']]
domain_counts = Counter(domains)
print(f"Répartition des domaines de messagerie : {dict(domain_counts)}")
# Analyse des mots-clés de l'objet
all_words = []
for subject in structured_data['Subject']:
words = re.findall(r'[\u4e00-\u9fff]+', subject) # Extraire le vocabulaire chinois
all_words.extend(words)
word_counts = Counter(all_words)
print(f"Fréquence des mots du sujet : {dict(word_counts)}")
# Statistiques sur la longueur du contenu
print(f"Statistiques sur la longueur du contenu :")
print(structured_data['Content length'].describe())
return structured_data
# Exemple d'exécution
structured_text_df = structured_text_example()
2. Données textuelles non structurées
Exemple
def unstructured_text_example():
"""Exemple de données textuelles non structurées"""
print("\n=== Exemple de données textuelles non structurées ===)
# Créer des données textuelles non structurées
unstructured_texts = [
"""
La technologie de l'intelligence artificielle se développe rapidement, et des percées majeures ont été réalisées dans des domaines tels que l'apprentissage profond, l'apprentissage automatique et le traitement du langage naturel.
Ces technologies sont largement appliquées dans de multiples secteurs tels que la santé, la finance, l'éducation et les transports, apportant de nouvelles opportunités pour le développement social.
À l'avenir, avec une puissance de calcul améliorée et de meilleurs algorithmes, l'intelligence artificielle jouera un rôle important dans davantage de domaines.
""",
"""
Le temps est vraiment agréable aujourd'hui, ensoleillé et avec une brise légère. J'ai décidé de me promener dans le parc et de profiter de ce moment merveilleux.
Il y a beaucoup de fleurs dans le parc, rouges, jaunes, violettes, colorées et très belles. De petits oiseaux chantent dans les arbres,
Les papillons dansent parmi les fleurs, et tout semble si harmonieux et naturel.
""",
"""
Le marché boursier a affiché de solides performances aujourd'hui, avec l'indice composite de Shanghai en hausse de 2.3% et l'indice des composants de Shenzhen en hausse de 1.8%.
Les actions technologiques ont mené les gains, de nombreux titres atteignant la limite quotidienne. Les analystes estiment que cela est principalement dû aux politiques favorables récemment introduites.
La confiance des investisseurs a été renforcée, les échanges sur le marché sont actifs et le volume de transactions s'est considérablement accru.
""",
"""
Un mode de vie sain comprend une alimentation équilibrée, une activité physique modérée, un sommeil adéquat et un état d'esprit positif.
Il est recommandé de manger des légumes et des fruits quotidiennement et de réduire les aliments gras ; faites de l'exercice au moins 3 fois par semaine, chaque séance durant plus de 30 minutes ;
Assurez-vous de dormir 7-8 heures ; apprenez à réguler vos émotions et à maintenir une attitude positive et optimiste.
"""
]
text_categories = ['Technologie', 'Vie', 'Finance', 'Santé']
# Créer un dataframe
unstructured_df = pd.DataFrame({
'Text': unstructured_texts,
'Category': text_categories
})
print("Exemple de données textuelles non structurées :")
for i, row in unstructured_df.iterrows():
print(f"\nCatégorie : {row['类别']}")
print(f"Texte : {row['文本'][:100]}...")
return unstructured_df
# Exemple d'exécution
unstructured_text_df = unstructured_text_example()
Méthodes de traitement des données textuelles
Exemple
# Méthodes de traitement des données textuelles
import jieba
from sklearn.feature_extraction.text import TfidfVectorizer, CountVectorizer
from sklearn.preprocessing import LabelEncoder
class TextDataProcessor:
def __init__(self):
self.vectorizers = {}
self.label_encoders = {}
def clean_text(self, text):
"""Nettoyage de texte"""
# Supprimer les caractères spéciaux et les nombres
text = re.sub(r'[^\u4e00-\u9fff\s]', '', text)
# Supprimer les espaces supplémentaires
text = re.sub(r'\s+', ' ', text).strip()
return text
def tokenize_chinese(self, text):
"""Segmentation en mots chinois"""
words = jieba.lcut(text)
# Supprimer les mots vides (version simplifiée)
stop_words = {'of', 'already', 'at', 'is', 'I', 'have', 'and', 'then', 'not', 'person', 'all', 'one', 'one', 'on', 'also', 'very', 'to', 'say', 'want', 'go', 'you', 'will', '-ing', 'none', 'see', 'good', 'self', '这'}
words = [word for word in words if word not in stop_words and len(word) > 1]
return words
def extract_features(self, texts, method='tfidf'):
"""Extraction de caractéristiques"""
# Prétraitement du texte
cleaned_texts = [self.clean_text(text) for text in texts]
if method == 'tfidf':
vectorizer = TfidfVectorizer(max_features=1000, token_pattern=r'(?u)\b\w+\b')
elif method == 'count':
vectorizer = CountVectorizer(max_features=1000, token_pattern=r'(?u)\b\w+\b')
else:
raise ValueError("La méthode doit être 'tfidf' ou 'count'")
features = vectorizer.fit_transform(cleaned_texts)
self.vectorizers[method] = vectorizer
return features.toarray(), vectorizer.get_feature_names_out()
def analyze_text_statistics(self, texts):
"""Analyse statistique du texte"""
stats = []
for text in texts:
cleaned_text = self.clean_text(text)
words = self.tokenize_chinese(cleaned_text)
stats.append({
'Nombre de caractères': len(text),
'Nombre de caractères après nettoyage': len(cleaned_text),
'Nombre de mots': len(words),
'Longueur moyenne des mots': np.mean([len(word) for word in words]) if words else 0,
'Nombre de mots uniques': len(set(words))
})
return pd.DataFrame(stats)
def encode_labels(self, labels):
"""Encodage des étiquettes"""
encoder = LabelEncoder()
encoded_labels = encoder.fit_transform(labels)
self.label_encoders['default'] = encoder
return encoded_labels, encoder.classes_
# Exemple d'utilisation
text_processor = TextDataProcessor()
# Analyse statistique de texte
text_stats = text_processor.analyze_text_statistics(unstructured_text_df['Text'])
print("\nAnalyse statistique de texte : ")
print(text_stats)
# Extraction de caractéristiques
features, feature_names = text_processor.extract_features(
unstructured_text_df['Text'], method='tfidf'
)
print(f"\nForme de la matrice de caractéristiques : {features.shape}")
print(f"10 premières caractéristiques : {feature_names[:10]}")
# Encodage des étiquettes
encoded_labels, label_classes = text_processor.encode_labels(
unstructured_text_df['Category']
)
print(f"\nÉtiquettes encodées : {encoded_labels}")
print(f"Classes d'étiquettes : {label_classes}")
Données d'image
Qu'est-ce que les données d'image ?
Les données d'image sont comme une représentation numérique du monde visuel, composées de pixels, contenant de riches informations spatiales et de couleur.
Classification des données d'image
1. Image en niveaux de gris
Exemple
import numpy as np
import matplotlib.pyplot as plt
from PIL import Image
def grayscale_image_example():
"""Exemple d'image en niveaux de gris"""
print("\n=== Exemple d'image en niveaux de gris ===")
# Créer une image en niveaux de gris simple
# Créer une image en niveaux de gris 100x100
height, width = 100, 100
# Créer une image en dégradé
gradient = np.zeros((height, width))
for i in range(height):
gradient[i, :] = i # Dégradé vertical
# Créer un motif en damier
checkerboard = np.zeros((height, width))
for i in range(0, height, 10):
for j in range(0, width, 10):
if (i // 10 + j // 10) % 2 == 0:
checkerboard[i:i+10, j:j+10] = 255
# Créer un motif circulaire
circle = np.zeros((height, width))
center_x, center_y = width // 2, height // 2
radius = 30
for i in range(height):
for j in range(width):
if (i - center_y) ** 2 + (j - center_x) ** 2 <= radius ** 2:
circle[i, j] = 255
# Afficher l'image
plt.figure(figsize=(12, 4))
plt.subplot(1, 3, 1)
plt.imshow(gradient, cmap='gray')
plt.title('Image en dégradé')
plt.axis('off')
plt.subplot(1, 3, 2)
plt.imshow(checkerboard, cmap='gray')
plt.title('Motif en damier')
plt.axis('off')
plt.subplot(1, 3, 3)
plt.imshow(circle, cmap='gray')
plt.title('Motif circulaire')
plt.axis('off')
plt.tight_layout()
plt.show()
# Informations sur les données d'image
print(f"Forme de l'image de dégradé : {gradient.shape}")
print(f"Type de données : {gradient.dtype}")
print(f"Plage de valeurs des pixels : {gradient.min()} - {gradient.max()}")
return gradient, checkerboard, circle
# Exemple d'exécution
gradient_img, checkerboard_img, circle_img = grayscale_image_example()
2. Image couleur
Exemple
def color_image_example():
"""Exemple d'image couleur"""
print("\n=== Exemple d'image couleur ===")
height, width = 100, 100
# Créer une image en couleurs RGB
# Dégradé rouge
red_gradient = np.zeros((height, width, 3), dtype=np.uint8)
red_gradient[:, :, 0] = np.linspace(0, 255, width) # Dégradé du canal rouge
# Dégradé vert
green_gradient = np.zeros((height, width, 3), dtype=np.uint8)
green_gradient[:, :, 1] = np.linspace(0, 255, width) # Dégradé du canal vert
# Dégradé bleu
blue_gradient = np.zeros((height, width, 3), dtype=np.uint8)
blue_gradient[:, :, 2] = np.linspace(0, 255, width) # Dégradé du canal bleu
# Motif arc-en-ciel
rainbow = np.zeros((height, width, 3), dtype=np.uint8)
for i in range(width):
hue = i / width
# Conversion simplifiée de HSV en RVB
if hue < 1/3:
rainbow[:, i] = [255 * (1 - 3*hue), 255 * 3*hue, 0]
elif hue < 2/3:
rainbow[:, i] = [0, 255 * (2 - 3*hue), 255 * (3*hue - 1)]
else:
rainbow[:, i] = [255 * (3*hue - 2), 0, 255 * (3 - 3*hue)]
# Afficher l'image
plt.figure(figsize=(12, 8))
plt.subplot(2, 2, 1)
plt.imshow(red_gradient)
plt.title('Dégradé rouge')
plt.axis('off')
plt.subplot(2, 2, 2)
plt.imshow(green_gradient)
plt.title('Dégradé vert')
plt.axis('off')
plt.subplot(2, 2, 3)
plt.imshow(blue_gradient)
plt.title('Dégradé bleu')
plt.axis('off')
plt.subplot(2, 2, 4)
plt.imshow(rainbow)
plt.title('Motif arc-en-ciel')
plt.axis('off')
plt.tight_layout()
plt.show()
# Informations sur les canaux de l'image
print(f"Forme de l'image couleur : {rainbow.shape}")
print(f"Type de données : {rainbow.dtype}")
print(f"Plage de valeurs des pixels : {rainbow.min()} - {rainbow.max()}")
return red_gradient, green_gradient, blue_gradient, rainbow
# Exemple d'exécution
red_img, green_img, blue_img, rainbow_img = color_image_example()
Méthodes de traitement des données d'image
Exemple
# Méthodes de traitement des données d'image
from skimage import filters, feature, measure, transform
from skimage.color import rgb2gray, rgb2hsv
class ImageDataProcessor:
def __init__(self):
pass
def resize_image(self, image, target_size):
"""Redimensionner l'image"""
from skimage.transform import resize
return resize(image, target_size, anti_aliasing=True)
def normalize_image(self, image):
"""Normalisation d'image"""
return (image - image.min()) / (image.max() - image.min())
def extract_color_features(self, image):
"""Extraire les caractéristiques de couleur"""
if len(image.shape) == 3: # Image couleur
# Calculer les caractéristiques statistiques pour chaque canal
features = {}
for i, channel in enumerate(['R', 'G', 'B']):
channel_data = image[:, :, i]
features[f'{channel}_mean'] = np.mean(channel_data)
features[f'{channel}_std'] = np.std(channel_data)
features[f'{channel}_min'] = np.min(channel_data)
features[f'{channel}_max'] = np.max(channel_data)
# Calculer les caractéristiques de l'histogramme de couleur
hist_r, _ = np.histogram(image[:, :, 0], bins=256, range=(0, 256))
hist_g, _ = np.histogram(image[:, :, 1], bins=256, range=(0, 256))
hist_b, _ = np.histogram(image[:, :, 2], bins=256, range=(0, 256))
features.update({
'hist_r_peak': np.argmax(hist_r),
'hist_g_peak': np.argmax(hist_g),
'hist_b_peak': np.argmax(hist_b)
})
return features
else: # Image en niveaux de gris
return {
'mean': np.mean(image),
'std': np.std(image),
'min': np.min(image),
'max': np.max(image)
}
def extract_texture_features(self, image):
"""Extraire les caractéristiques de texture"""
if len(image.shape) == 3:
image = rgb2gray(image)
# Calculer les caractéristiques de contour
edges = filters.sobel(image)
edge_density = np.sum(edges > 0) / edges.size
# Calculer le motif binaire local (version simplifiée)
lbp = feature.local_binary_pattern(image, P=8, R=1, method='uniform')
lbp_hist, _ = np.histogram(lbp.ravel(), bins=10)
return {
'edge_density': edge_density,
'lbp_hist': lbp_hist.tolist()
}
def augment_image(self, image):
"""Augmentation d'images"""
augmented = []
# Image originale
augmented.append(image)
# Retournement horizontal
augmented.append(np.fliplr(image))
# Retournement vertical
augmented.append(np.flipud(image))
# Rotation de 90 degrés
augmented.append(np.rot90(image))
# Ajustement de la luminosité
if len(image.shape) == 3:
brightened = np.clip(image * 1.2, 0, 255).astype(np.uint8)
else:
brightened = np.clip(image * 1.2, 0, 1)
augmented.append(brightened)
return augmented
def visualize_image_channels(self, image):
"""Visualiser les canaux de l'image"""
if len(image.shape) == 3:
plt.figure(figsize=(12, 3))
plt.subplot(1, 4, 1)
plt.imshow(image)
plt.title('Image originale')
plt.axis('off')
plt.subplot(1, 4, 2)
plt.imshow(image[:, :, 0], cmap='Reds')
plt.title('Canal rouge')
plt.axis('off')
plt.subplot(1, 4, 3)
plt.imshow(image[:, :, 1], cmap='Greens')
plt.title('Canal vert')
plt.axis('off')
plt.subplot(1, 4, 4)
plt.imshow(image[:, :, 2], cmap='Blues')
plt.title('Canal bleu')
plt.axis('off')
plt.tight_layout()
plt.show()
# Exemple d'utilisation
image_processor = ImageDataProcessor()
# Extraire les caractéristiques de couleur
color_features = image_processor.extract_color_features(rainbow_img)
print("\nCaractéristiques de couleur : ")
for key, value in color_features.items():
if not key.startswith('hist'):
print(f"{key}: {value:.2f}")
# Extraire les caractéristiques de texture
texture_features = image_processor.extract_texture_features(checkerboard_img)
print("\nCaractéristiques de texture : ")
for key, value in texture_features.items():
if key != 'lbp_hist':
print(f"{key}: {value:.4f}")
# Augmentation d'images
augmented_images = image_processor.augment_image(circle_img)
print(f"\nAugmentation d'images : {len(augmented_images)} variantes générées")
# Visualiser les canaux de l'image
image_processor.visualize_image_channels(rainbow_img)
Données catégorielles
Qu'est-ce que les données catégorielles ?
Les données catégorielles sont comme des étiquettes de classification, représentant différentes catégories ou groupes, et ne peuvent pas subir d'opérations mathématiques.
Classification des données catégorielles
1. Données nominales
Exemple
def nominal_data_example():
"""Exemple de données nominales"""
print("\n=== Exemple de données nominales ===")
# Créer des données nominales
nominal_data = pd.DataFrame({
'Student ID': range(1, 11),
'Name': ['Zhang San', 'Li Si', 'Wang Wu', 'Zhao Liu', 'Qian Qi', 'Sun Ba', 'Zhou Jiu', 'Wu Shi', 'Zheng Shiyi', 'Chen Shier'],
'Genre': ['Masculin', 'Féminin', 'Masculin', 'Masculin', 'Féminin', 'Féminin', 'Masculin', 'Féminin', 'Masculin', 'Féminin'],
'Groupe sanguin': ['A', 'B', 'O', 'AB', 'A', 'B', 'O', 'AB', 'A', 'O'],
'Ville': ['Pékin', 'Shanghai', 'Canton', 'Shenzhen', 'Pékin', 'Shanghai', 'Canton', 'Shenzhen', 'Pékin', 'Shanghai'],
'Spécialité': ['Informatique', 'Mathématiques', 'Physique', 'Chimie', 'Informatique', 'Mathématiques', 'Physique', 'Chimie', 'Informatique', 'Mathématiques']
})
print("Exemple de données nominales :")
print(nominal_data)
# Analyse statistique catégorielle
print("\n=== Analyse statistique catégorielle ===)
for column in nominal_data.select_dtypes(include=['object']).columns:
if column != 'Name': # Ignorer la colonne du nom
value_counts = nominal_data[column].value_counts()
print(f"\n{column} distribution :")
print(value_counts)
print(f"Nombre de valeurs uniques : {len(value_counts)}")
return nominal_data
# Exemple d'exécution
nominal_df = nominal_data_example()
2. Données ordinales
Exemple
def ordinal_data_example():
"""Exemple de données ordinales"""
print("\n=== Exemple de données ordinales ===)
# Créer des données ordinales
ordinal_data = pd.DataFrame({
'ID produit': range(1, 11),
'Nom du produit': [f'Produit {i}' for i in range(1, 11)],
'Note de qualité': ['Excellent', 'Bon', 'Moyen', 'Excellent', 'Bon', 'Moyen', 'Médiocre', 'Excellent', 'Bon', 'Moyen'],
'Satisfaction client': ['Très satisfait', 'Satisfait', 'Neutre', 'Très satisfait', 'Satisfait', 'Neutre', 'Insatisfait', 'Très satisfait', 'Satisfait', 'Neutre'],
'Gamme de prix': ['Élevé', 'Moyen', 'Faible', 'Élevé', 'Moyen', 'Faible', 'Faible', 'Élevé', 'Moyen', 'Moyen'],
'Classement des ventes': [1, 3, 5, 2, 4, 7, 9, 6, 8, 10]
})
print("Exemple de données ordinales :")
print(ordinal_data)
# Analyse statistique des données ordinales
print("\n=== Analyse statistique des données ordinales ===)
# Définir l'ordre
quality_order = ['Médiocre', 'Moyen', 'Bon', 'Excellent']
satisfaction_order = ['Insatisfait', 'Neutre', 'Satisfait', 'Très satisfait']
price_order = ['Bas', 'Moyen', 'Élevé']
# Convertir en catégories ordinales
ordinal_data['quality_rating_ordered'] = pd.Categorical(
ordinal_data['quality_rating'], categories=quality_order, ordered=True
)
ordinal_data['customer_satisfaction_ordered'] = pd.Categorical(
ordinal_data['customer_satisfaction'], categories=satisfaction_order, ordered=True
)
ordinal_data['price_range_ordered'] = pd.Categorical(
ordinal_data['price_range'], categories=price_order, ordered=True
)
# Analyse statistique
for column in ['quality_rating_ordered', 'customer_satisfaction_ordered', 'price_range_ordered']:
print(f"\n{column} distribution :")
value_counts = ordinal_data[column].value_counts().sort_index()
print(value_counts)
# Calculer la médiane
median_value = ordinal_data[column].median()
print(f"Médiane: {median_value}")
return ordinal_data
# Exemple d'exécution
ordinal_df = ordinal_data_example()
Méthodes de traitement des données catégorielles
Exemple
# Méthodes de traitement des données catégorielles
from sklearn.preprocessing import LabelEncoder, OneHotEncoder, OrdinalEncoder
class CategoricalDataProcessor:
def __init__(self):
self.encoders = {}
self.feature_names = {}
def label_encoding(self, data, columns):
"""Encodage des étiquettes"""
encoded_data = data.copy()
for column in columns:
encoder = LabelEncoder()
encoded_data[f'{column}_encoded'] = encoder.fit_transform(data[column])
self.encoders[f'{column}_label'] = encoder
print(f"{column} encodage des étiquettes :")
for i, category in enumerate(encoder.classes_):
print(f" {category} -> {i}")
return encoded_data
def one_hot_encoding(self, data, columns):
"""Encodage one-hot"""
encoded_data = data.copy()
for column in columns:
encoder = OneHotEncoder(sparse=False, drop='first') # Éviter la multicolinéarité
encoded_features = encoder.fit_transform(data[[column]])
# Créer de nouveaux noms de colonnes
feature_names = [f'{column}_{category}' for category in encoder.categories_[0][1:]]
# Ajouter au DataFrame
for i, feature_name in enumerate(feature_names):
encoded_data[feature_name] = encoded_features[:, i]
self.encoders[f'{column}_onehot'] = encoder
self.feature_names[f'{column}_onehot'] = feature_names
print(f"{column} encodage one-hot : {len(feature_names)} caractéristiques créées")
return encoded_data
def ordinal_encoding(self, data, columns, categories_list):
"""Encodage ordinal"""
encoded_data = data.copy()
for column, categories in zip(columns, categories_list):
encoder = OrdinalEncoder(categories=[categories])
encoded_data[f'{column}_ordinal'] = encoder.fit_transform(data[[column]])
self.encoders[f'{column}_ordinal'] = encoder
print(f"{column} encodage ordinal :")
for i, category in enumerate(categories):
print(f" {category} -> {i}")
return encoded_data
def target_encoding(self, data, categorical_column, target_column):
"""Encodage de la cible"""
encoded_data = data.copy()
# Calculer la moyenne de la cible pour chaque catégorie
target_means = data.groupby(categorical_column)[target_column].mean()
# Appliquer l'encodage
encoded_data[f'{categorical_column}_target'] = data[categorical_column].map(target_means)
print(f"{categorical_column} encodage de la cible :")
for category, mean_value in target_means.items():
print(f" {category} -> {mean_value:.4f}")
return encoded_data
def frequency_encoding(self, data, columns):
"""Encodage de fréquence"""
encoded_data = data.copy()
for column in columns:
# Calculer la fréquence pour chaque catégorie
frequency = data[column].value_counts(normalize=True)
# Appliquer l'encodage
encoded_data[f'{column}_frequency'] = data[column].map(fréquence)
print(f"{column} encodage de fréquence:")
for category, freq in frequency.head().items():
print(f" {category} -> {freq:.4f}")
return encoded_data
def analyze_categorical_importance(self, data, categorical_columns, target_column):
"""Analyser l'importance des variables catégorielles"""
importance_scores = {}
for column in categorical_columns:
# Calculer la différence moyenne de la cible pour chaque catégorie
category_means = data.groupby(column)[target_column].mean()
mean_difference = category_means.max() - category_means.min()
# Calculer le nombre de catégories
unique_count = data[column].nunique()
# Score d'importance simple
importance = mean_difference * np.log(unique_count + 1)
importance_scores[column] = importance
# Trier
sorted_importance = sorted(importance_scores.items(), key=lambda x: x[1], reverse=True)
print("\nImportance des caractéristiques catégorielles :")
for column, importance in sorted_importance:
print(f"{column}: {importance:.4f}")
return importance_scores
# Exemple d'utilisation
cat_processor = CategoricalDataProcessor()
# Ajouter une cible numérique pour les données nominales
nominal_df_with_target = nominal_df.copy()
nominal_df_with_target['Score'] = np.random.randint(60, 100, len(nominal_df))
# Encodage des étiquettes
label_encoded = cat_processor.label_encoding(
nominal_df_with_target, ['Gender', 'Blood Type', 'City']
)
# Encodage one-hot
onehot_encoded = cat_processor.one_hot_encoding(
nominal_df_with_target, ['Major']
)
# Encodage de la cible
target_encoded = cat_processor.target_encoding(
nominal_df_with_target, 'City', 'Score'
)
# Encodage de fréquence
frequency_encoded = cat_processor.frequency_encoding(
nominal_df_with_target, ['Gender', 'Blood Type']
)
# Analyser l'importance des caractéristiques
importance_scores = cat_processor.analyze_categorical_importance(
nominal_df_with_target, ['Gender', 'Blood Type', 'City', 'Major'], 'Score'
)
Fusion de données multimodales
Exemple de fusion de types de données
Exemple
class MultiModalDataProcessor:
def __init__(self):
self.numeric_processor = NumericDataProcessor()
self.text_processor = TextDataProcessor()
self.image_processor = ImageDataProcessor()
self.categorical_processor = CategoricalDataProcessor()
def create_multimodal_dataset(self):
"""Créer un jeu de données multimodal"""
print("\n=== Exemple de jeu de données multimodal ===)
n_samples = 100
# Caractéristiques numériques
numeric_features = {
'Age': np.random.randint(18, 65, n_samples),
'Revenu': np.random.normal(50000, 15000, n_samples),
'Expérience professionnelle': np.random.randint(0, 20, n_samples)
}
# Caractéristiques catégorielles
categorical_features = {
'Genre': np.random.choice(['Homme', 'Femme'], n_samples),
'Niveau d'éducation': np.random.choice(['Lycée', "Licence", "Master", 'Doctorat'], n_samples),
'Ville': np.random.choice(['Pékin', 'Shanghai', 'Canton', 'Shenzhen'], n_samples)
}
# Caractéristiques textuelles
text_features = [
f"Ceci est la description textuelle de l'échantillon {i}, contenant des informations de base et des caractéristiques."
for i in range(n_samples)
]
# Caractéristiques d'image (simulées)
image_features = np.random.rand(n_samples, 64, 64, 3) # Simuler des images couleur 64x64
# Variable cible
target = np.random.choice([0, 1], n_samples)
# Créer le jeu de données
dataset = {
'numeric': pd.DataFrame(numeric_features),
'categorical': pd.DataFrame(categorical_features),
'text': text_features,
'image': image_features,
'target': target
}
print(f"Taille du jeu de données : {n_samples}")
print(f"Caractéristiques numériques : {list(numeric_features.keys())}")
print(f"Caractéristiques catégorielles : {list(categorical_features.keys())}")
print(f"Caractéristiques textuelles : {len(text_features)} entrées")
print(f"Caractéristiques de l'image : {image_features.shape}")
print(f"Variable cible : {np.bincount(target)}")
return dataset
def process_multimodal_data(self, dataset):
"""Traiter les données multimodales"""
print("\n=== Traitement des données multimodales ===)
processed_features = {}
# Traiter les caractéristiques numériques
numeric_data = dataset['numeric']
numeric_processed = self.numeric_processor.normalize_data(numeric_data, method='standard')
processed_features['numeric'] = numeric_processed
# Traiter les caractéristiques catégorielles
categorical_data = dataset['categorical']
categorical_processed = self.categorical_processor.one_hot_encoding(
categorical_data, list(categorical_data.columns)
)
# Conserver uniquement les colonnes encodées
categorical_encoded = categorical_processed.select_dtypes(include=[np.nombre])
processed_features['categorical'] = categorical_encoded
# Traiter les caractéristiques textuelles
text_data = dataset['text']
text_features, _ = self.text_processor.extract_features(text_data, method='tfidf')
processed_features['text'] = text_features
# Traitement des caractéristiques d'image
image_data = dataset['image']
# Extraire des caractéristiques d'image simples (moyenne, écart-type, etc.)
image_features = []
for img in image_data:
features = self.image_processor.extract_color_features(img)
feature_vector = list(features.values())[:10] # Prendre les 10 premières caractéristiques
image_features.append(feature_vector)
processed_features['image'] = np.array(image_features)
# Afficher les résultats du traitement
for modality, features in processed_features.items():
if isinstance(features, pd.DataFrame):
print(f"{modality} caractéristiques : {features.shape}")
else:
print(f"{modality} caractéristiques : {features.shape}")
return processed_features
def fuse_features(self, processed_features):
"""Fusion des caractéristiques"""
print("\n=== Fusion des caractéristiques ===)
# Fusionner toutes les caractéristiques
feature_arrays = []
for modality, features in processed_features.items():
if isinstance(features, pd.DataFrame):
feature_arrays.append(features.values)
else:
feature_arrays.append(features)
# Concaténation horizontale
fused_features = np.hstack(feature_arrays)
print(f"Forme des caractéristiques fusionnées : {fused_features.shape}")
return fused_features
# Exemple d'utilisation
multimodal_processor = MultiModalDataProcessor()
# Créer un ensemble de données multimodal
multimodal_dataset = multimodal_processor.create_multimodal_dataset()
# Traiter les données multimodales
processed_multimodal = multimodal_processor.process_multimodal_data(multimodal_dataset)
# Fusion de caractéristiques
fused_features = multimodal_processor.fuse_features(processed_multimodal)