Biais des données
L'apprentissage automatique change le monde, des systèmes de recommandation aux voitures autonomes ; ses applications sont partout.
Cependant, ces systèmes intelligents ne sont pas parfaits ; ils partagent un point faible commun« talon d'Achille » (Achilles' Heel)—le biais des données.
Aujourd'hui, nous allons nous pencher sur cette question centrale qui affecte l'équité et la précision des modèles d'apprentissage automatique.
Qu'est-ce que le biais des données ?
Le biais des données désigne des données d'entraînement qui ne peuvent pas représenter fidèlement les conditions du monde réel, ce qui amène les modèles d'apprentissage automatique à apprendre des schémas incorrects ou à faire des prédictions biaisées. En termes simples, c'est « garbage in, garbage out » : si les données d'entrée posent problème, les résultats en sortie seront également défectueux.
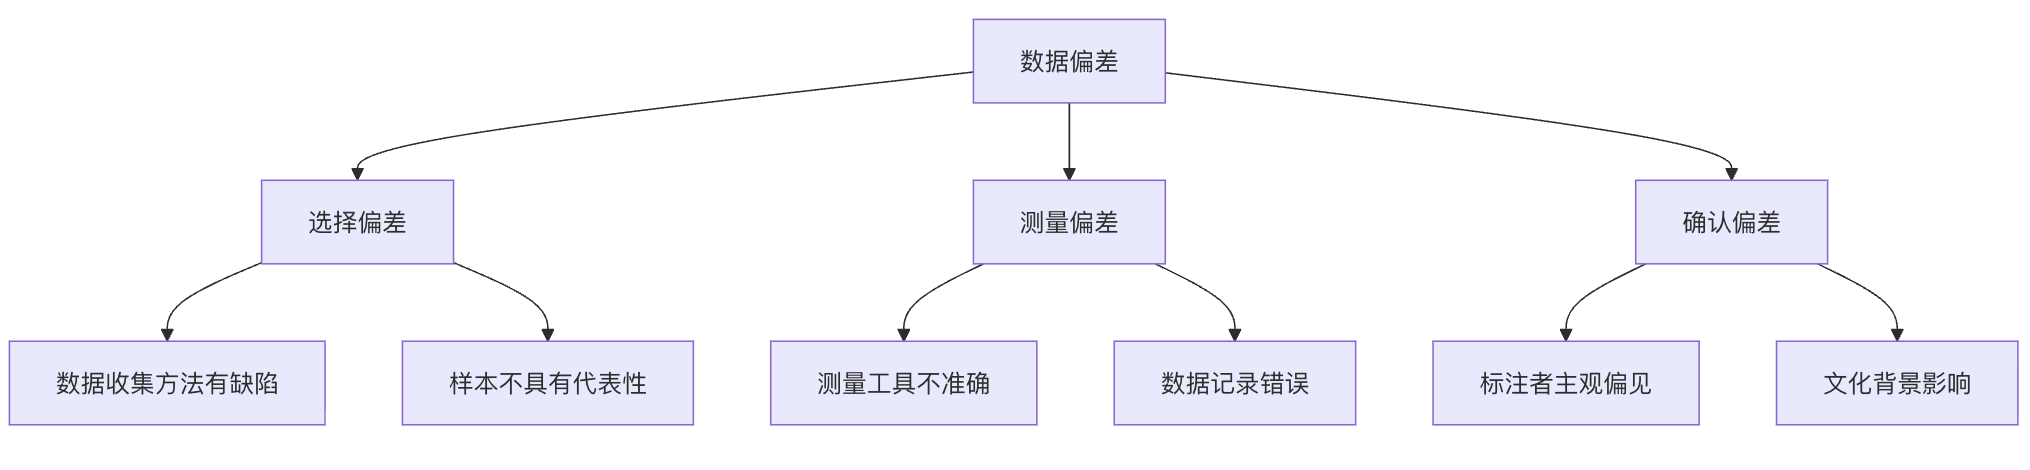
Trois principaux types de biais des données
Biais de sélection :Se produit lorsque le processus de collecte des données présente lui-même un biais systématique. Par exemple, utiliser uniquement les réseaux sociaux pour sonder l'opinion des jeunes sur un produit, en ignorant les groupes plus âgés qui n'utilisent pas les réseaux sociaux.
-
Biais de mesure :Des erreurs surviennent dans les données elles-mêmes lors de la mesure ou de l'enregistrement. Par exemple, un système de reconnaissance faciale développé principalement à partir de photos de personnes à la peau claire donne une précision de reconnaissance plus faible pour les personnes à la peau foncée.
-
Biais de confirmation :Les chercheurs ou les annotateurs de données introduisent leurs propres biais subjectifs dans les données. Par exemple, dans les tâches d'analyse des sentiments, les annotateurs peuvent interpréter le sentiment d'un texte en fonction de leur propre contexte culturel, en ignorant les expressions issues d'autres cultures.
Comment le biais des données affecte-t-il les modèles d'apprentissage automatique ?
Dégradation des performances du modèle
Lorsqu'un modèle obtient de bonnes performances sur les données d'entraînement mais de mauvaises performances sur les données du monde réel, il est probable qu'il y ait un problème de biais des données.
Exemple
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
np.random.seed(42)
n_samples = 1000
# Données du monde réel
X_real = np.random.uniform(-5, 5, n_samples).reshape(-1, 1)
y_real = (X_real.flatten() > 0).astype(int)
# Données biaisées : 90% provenant de X > 0, 10% provenant de X < 0
mask_pos = X_real.flatten() > 0
mask_neg = X_real.flatten() <= 0
X_pos = X_real[mask_pos]
y_pos = y_real[mask_pos]
X_neg = X_real[mask_neg]
y_neg = y_real[mask_neg]
# Échantillonner uniquement un petit nombre d'échantillons négatifs
neg_sample_size = int(0.1 * len(X_pos))
neg_indices = np.random.choice(len(X_neg), neg_sample_size, replace=False)
X_biased = np.vstack([X_pos, X_neg[neg_indices]])
y_biased = np.hstack([y_pos, y_neg[neg_indices]])
# Diviser entraînement / test
X_train, X_test, y_train, y_test = train_test_split(
X_biased, y_biased, test_size=0.2, random_state=42
)
# Entraîner le modèle
model = LogisticRegression()
model.fit(X_train, y_train)
# Évaluation sur l'ensemble d'entraînement
train_pred = model.predict(X_train)
train_acc = accuracy_score(y_train, train_pred)
print(f"Précision d'entraînement : {train_acc:.2%}")
# Évaluation en conditions réelles
real_pred = model.predict(X_real)
real_acc = accuracy_score(y_real, real_pred)
print(f"Précision en conditions réelles : {real_acc:.2%}")
print("Conclusion : L'ensemble d'entraînement fonctionne bien, mais en raison d'un biais de distribution, les performances en conditions réelles diminuent considérablement")
Le résultat de sortie est:
训练准确率: 99.08%
真实世界准确率: 96.00%
结论:训练集表现良好,但由于分布偏差,真实世界性能显著下降
Problèmes d'équité
Le biais des données peut amener les modèles à produire des résultats discriminatoires pour certains groupes. Par exemple, si un algorithme de recrutement est entraîné principalement sur des données historiques d'employés masculins, il peut être biaisé à l'égard des candidates féminines.
Capacité de généralisation insuffisante
Le modèle ne peut pas s'adapter à de nouveaux scénarios de données inédits, car les données d'entraînement ne couvrent pas une gamme suffisamment diversifiée de situations.
Sources courantes de biais des données
Problèmes lors de la phase de collecte des données
| Type de problème | Manifestation spécifique | Exemple |
|---|---|---|
| Biais d'échantillonnage | L'échantillon de données ne peut pas représenter la population | Collecter des données de conduite autonome uniquement en zones urbaines, en ignorant les routes rurales |
| Biais temporel | Les données sont obsolètes ou non sensibles au temps | Utiliser des données e-commerce de 2010 pour prédire les tendances de consommation de 2023 |
| Biais de survie | Se concentrer uniquement sur les points de données "survivants" | Étudier uniquement les données des entreprises qui ont réussi, en ignorant l'expérience des entreprises qui ont échoué |
Problèmes dans la phase d'étiquetage des données
Exemple
import pandas as pd
# Créer un jeu de données simulé
data = {
'text': [
'Ce produit est vraiment génial, je l'aime beaucoup !',
'Je ne suis pas sûr que cela fonctionne bien',
'N'achetez absolument pas ce produit de pacotille',
'C'est correct, juste moyen',
'Fortement recommandé, excellent rapport qualité-prix'
],
# Supposons que les annotateurs ont leur propre biais : les avis positifs sont étiquetés comme 1, tout le reste est étiqueté comme 0
'biased_label': [1, 0, 0, 0, 1], # Étiquetage biaisé
'true_label': [1, 0.5, 0, 0.5, 1] # Scores de sentiment continus réels
}
df = pd.DataFrame(data)
print("Exemple de biais d'étiquetage :")
print(df)
print("\nProblème : L'annotateur a incorrectement étiqueté les avis neutres comme négatifs !")
La sortie est :
标注偏差示例:
              text  biased_label  true_label
0  这个产品真的很棒,我非常喜欢!             1         1.0
1       不太确定这个好不好用             0         0.5
2      绝对不要买这个垃圾产品             0         0.0
3          还行吧,一般般             0         0.5
4        超级推荐,物超所值             1         1.0

问题:标注者将中性评价错误地标注为负面!
Problèmes dans la phase de prétraitement des données
- Gestion inappropriée des valeurs aberrantes
- Sélection biaisée des caractéristiques
- Méthodes inappropriées de standardisation des données
Comment détecter les biais dans les données ?
1. Analyse statistique des données
Vérifiez la distribution des différents groupes dans le jeu de données.
Exemple
import matplotlib.pyplot as plt
# -------------------------- Début de configuration de la police chinoise --------------------------
plt.rcParams['font.sans-serif'] = [
# Priorité Windows
'SimHei', 'Microsoft YaHei',
# Priorité macOS
'PingFang SC', 'Heiti TC',
# Priorité Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corriger le problème d'affichage du signe négatif sous forme de carré
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de la configuration de la police chinoise --------------------------
# Simuler des données démographiques
groups = ['Group A', 'Group B', 'Group C', 'Groupe D']
population_percent = [40, 30, 20, 10] # Proportions réelles de la population
dataset_percent = [70, 20, 8, 2] # Proportions dans le jeu de données
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 5))
# Distribution réelle de la population
ax1.pie(population_percent, labels=groups, autopct='%1.1f%%')
ax1.set_title('Distribution de la population réelle')
# Distribution du jeu de données
ax2.pie(dataset_percent, labels=groups, autopct='%1.1f%%')
ax2.set_title('Distribution des groupes dans le jeu de données')
plt.tight_layout()
plt.show()
print("Résultat de la détection : le groupe A est surreprésenté dans le jeu de données, tandis que le groupe D est sous-représenté !")

2. Analyse des différences de performance du modèle
Comparez les performances du modèle entre différents sous-groupes.
3. Calcul de la métrique d'équité
Utilisez des métriques statistiques pour quantifier le degré d'équité du modèle.
Stratégies pour remédier aux biais des données
Solutions au niveau des données
1. Stratégies améliorées de collecte de données
- Échantillonnage actif: Collecter consciemment des données sous-représentées
- Augmentation des données: Augmenter la diversité des données par des moyens techniques
- Sources de données multiples: Intégrer des données provenant de différentes sources
2. Techniques de prétraitement des données
Exemple
import numpy as np
from sklearn.utils import resample
np.random.seed(42)
# 1. Construire des données déséquilibrées (caractéristiques unidimensionnelles + étiquettes)
X_majority = np.random.normal(0, 1, 900).reshape(-1, 1)
y_majority = np.zeros(900, dtype=int)
X_minority = np.random.normal(2, 1, 100).reshape(-1, 1)
y_minority = np.ones(100, dtype=int)
print(f"Avant le rééchantillonnage :")
print(f"Classe majoritaire : {len(X_majority)}")
print(f"Classe minoritaire : {len(X_minority)}")
# 2. Suréchantillonner la classe minoritaire
X_minority_upsampled, y_minority_upsampled = resample(
X_minority,
y_minority,
replace=True,
n_samples=len(X_majority),
random_state=42
)
# 3. Fusionner le jeu de données équilibré
X_balanced = np.vstack([X_majority, X_minority_upsampled])
y_balanced = np.hstack([y_majority, y_minority_upsampled])
print(f"\n"Après rééchantillonnage :")
print(f"Classe majoritaire : {np.sum(y_balanced == 0)}")
print(f"Classe minoritaire : {np.sum(y_balanced == 1)}")
print("\n"Conclusion : Les nombres d'échantillons sont parfaitement équilibrés")
Sortie :
重采样前:
多数类: 900
少数类: 100

重采样后:
多数类: 900
少数类: 900

结论:样本数量已完全平衡
Solutions au niveau de l'algorithme
Contraintes d'équité : Ajouter des contraintes d'équité pendant l'entraînement du modèle.
-
Débiasage adversarial : Utiliser des techniques d'apprentissage adversarial pour réduire les biais du modèle.
-
Méthodes de post-traitement : Ajuster les prédictions du modèle pour améliorer l'équité.
Exercice pratique : construire un classifieur non biaisé
Utilisons un exemple complet pour apprendre à gérer les biais dans les données tout au long du processus, de la collecte des données à l'évaluation du modèle.
Exemple
import numpy as np
import pandas as pd
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, confusion_matrix
from imblearn.over_sampling import SMOTE
import warnings
warnings.filterwarnings("ignore", category=FutureWarning)
# 1. Générer des données simulées déséquilibrées
X, y = make_classification(
n_samples=2000,
n_features=10,
n_informative=8,
n_redundant=2,
n_clusters_per_class=1,
weights=[0.9, 0.1], # Créer délibérément un biais de classe
flip_y=0,
random_state=42
)
# Convertir en DataFrame pour l'analyse
feature_names = [f'feature_{i}' for i in range(X.shape[1])]
df = pd.DataFrame(X, columns=feature_names)
df['target'] = y
print("=== Analyse des biais des données ===")
print(f"Dimensions du jeu de données : {df.shape}")
print("Répartition des classes :")
print(df['target'].value_counts())
print(f"Proportion de la classe minoritaire : {df['target'].value_counts(normalize=True))
# 2. Division des données (préserver les proportions de classes pour éviter un biais secondaire)
X_train, X_test, y_train, y_test = train_test_split(
X,
y,
test_size=0.3,
random_state=42,
stratify=y
)
print("\n"=== Répartition des ensembles d'entraînement et de test ===")
print("Ensemble d'entraînement :", np.bincount(y_train))
print("Ensemble de test :", np.bincount(y_test))
# 3. Utiliser SMOTE pour gérer le biais de l'ensemble d'entraînement
print("\n"=== Gestion du biais des données (SMOTE) ===")
smote = SMOTE(random_state=42)
X_train_balanced, y_train_balanced = smote.fit_resample(X_train, y_train)
print("Avant SMOTE :", np.bincount(y_train))
print("Après SMOTE :", np.bincount(y_train_balanced))
# 4. Entraînement du modèle
print("\n"=== Entraînement du modèle ===")
# Modèle de référence : aucune gestion du biais
model_imbalanced = RandomForestClassifier(
n_estimators=200,
random_state=42
)
model_imbalanced.fit(X_train, y_train)
# Modèle avec biais traité : entraîné après SMOTE
model_balanced = RandomForestClassifier(
n_estimators=200,
random_state=42
)
model_balanced.fit(X_train_balanced, y_train_balanced)
# 5. Évaluation du modèle
print("\n"=== Évaluation du modèle (ensemble de test) ===")
print("\n"【Biais non traité】Rapport de classification")
y_pred_imbalanced = model_imbalanced.predict(X_test)
print(classification_report(y_test, y_pred_imbalanced, digits=4))
print("Matrice de confusion :")
print(confusion_matrix(y_test, y_pred_imbalanced))
print("\n"【Après traitement SMOTE】Rapport de classification")
y_pred_balanced = model_balanced.predict(X_test)
print(classification_report(y_test, y_pred_balanced, digits=4))
print("Matrice de confusion :")
print(confusion_matrix(y_test, y_pred_balanced))
print(
"\nConclusion :\n"
"1. Sans gestion du biais, le modèle a un rappel extrêmement faible sur la classe minoritaire\n"
"2. SMOTE améliore considérablement le rappel et le F1 pour la classe minoritaire\n"
"3. L'exactitude n'est pas une métrique fiable pour les données déséquilibrées"
)
Résultats de sortie :
=== 数据偏差分析 ===
数据集形状: (2000, 11)
类别分布:
target
0    1800
1     200
Name: count, dtype: int64
少数类占比: 10.00%

=== 训练 / 测试集分布 ===
训练集: [1260  140]
测试集: [540  60]

=== 处理数据偏差(SMOTE)===
SMOTE 前: [1260  140]
SMOTE 后: [1260 1260]

=== 模型训练 ===

=== 模型评估(测试集)===

【未处理偏差】分类报告
              precision    recall  f1-score   support

           0     0.9872    1.0000    0.9936       540
           1     1.0000    0.8833    0.9381        60

    accuracy                         0.9883       600
   macro avg     0.9936    0.9417    0.9658       600
weighted avg     0.9885    0.9883    0.9880       600

混淆矩阵:
[[540   0]
 [  7  53]]

【SMOTE 处理后】分类报告
              precision    recall  f1-score   support

           0     0.9944    0.9944    0.9944       540
           1     0.9500    0.9500    0.9500        60

    accuracy                         0.9900       600
   macro avg     0.9722    0.9722    0.9722       600
weighted avg     0.9900    0.9900    0.9900       600

混淆矩阵:
[[537   3]
 [  3  57]]

结论:
1. 不处理偏差时,模型对少数类 Recall 极低
2. SMOTE 显著提升少数类 Recall 与 F1
3. Accuracy 不是不平衡数据的可靠指标
Meilleures pratiques de l'industrie pour la gestion des biais dans les données
1. Établir un cadre de gouvernance des données
- Élaborer des processus standardisés pour la collecte et l'annotation des données
- Auditer régulièrement la qualité des données
- Établir des mécanismes de détection des biais dans les données
2. Constituer une équipe diversifiée
- Assurer la diversité au sein de l’équipe de science des données
- Inclure des experts du domaine et des éthiciens
- Organiser régulièrement des formations de sensibilisation aux biais
3. Transparence et interprétabilité
- Consigner les sources de données et les procédures de traitement
- Fournir des explications pour les décisions du modèle
- Divulguer les performances du modèle selon les différents groupes
4. Surveillance et mise à jour continues
- Évaluer régulièrement les performances du modèle dans le monde réel
- Mettre en place des mécanismes de retour d'information pour recueillir les signalements des utilisateurs
- Mettre à jour les modèles rapidement pour s'adapter aux changements
Résumé et perspectives
Le biais des données est un défi inévitable en apprentissage automatique, mais grâce à des méthodes systématiques de détection et de traitement, nous pouvons considérablement atténuer son impact. L'essentiel est de reconnaître :
- Le biais des données est partout: Presque tous les ensembles de données du monde réel contiennent une certaine forme de biais
- La détection précoce est cruciale: Traiter le biais dès les premières étapes d'un projet est le moins coûteux
- Combiner la technologie avec les processus: Les solutions techniques seules ne suffisent pas ; elles doivent être combinées avec des processus et de la gestion
- Processus d'amélioration continue: Le traitement du biais des données est un processus continu, et non une tâche ponctuelle
À mesure que les exigences d'équité et de responsabilité en apprentissage automatique augmentent, la gestion efficace du biais des données deviendra une compétence essentielle pour chaque data scientist et ingénieur en apprentissage automatique. Rappelez-vous, un bon système d'apprentissage automatique ne doit pas seulement avoir une grande précision, mais aussi une grande équité et fiabilité.
Autres extensions