Смещение данных
Машинное обучение меняет мир — от рекомендательных систем до беспилотных автомобилей; его применения повсюду.
Однако эти интеллектуальные системы не идеальны; у них есть общая«ахиллесова пята» (Achilles' Heel)— смещение данных.
Сегодня мы углубимся в этот ключевой вопрос, который влияет на справедливость и точность моделей машинного обучения.
Что такое смещение данных?
Смещение данных — это обучающие данные, которые не могут точно отражать реальные условия, из-за чего модели машинного обучения усваивают неверные закономерности или делают предвзятые прогнозы. Проще говоря, это «мусор на входе — мусор на выходе»: если входные данные имеют проблемы, выходные результаты также будут ошибочными.
Три основных типа смещения данных
Смещение отбора:Возникает, когда сам процесс сбора данных имеет систематическое смещение. Например, использование только социальных сетей для опроса мнений молодых людей о продукте, при этом игнорируются старшие группы, которые не пользуются социальными сетями.
-
Смещение измерения:Ошибки возникают в самих данных во время измерения или записи. Например, система распознавания лиц, разработанная в основном с использованием фотографий людей со светлой кожей, приводит к более низкой точности распознавания для людей с темной кожей.
-
Предвзятость подтверждения:Исследователи или аннотаторы данных привносят в данные собственные субъективные предубеждения. Например, в задачах анализа тональности аннотаторы могут интерпретировать тональность текста исходя из собственного культурного фона, игнорируя выражения из других культур.
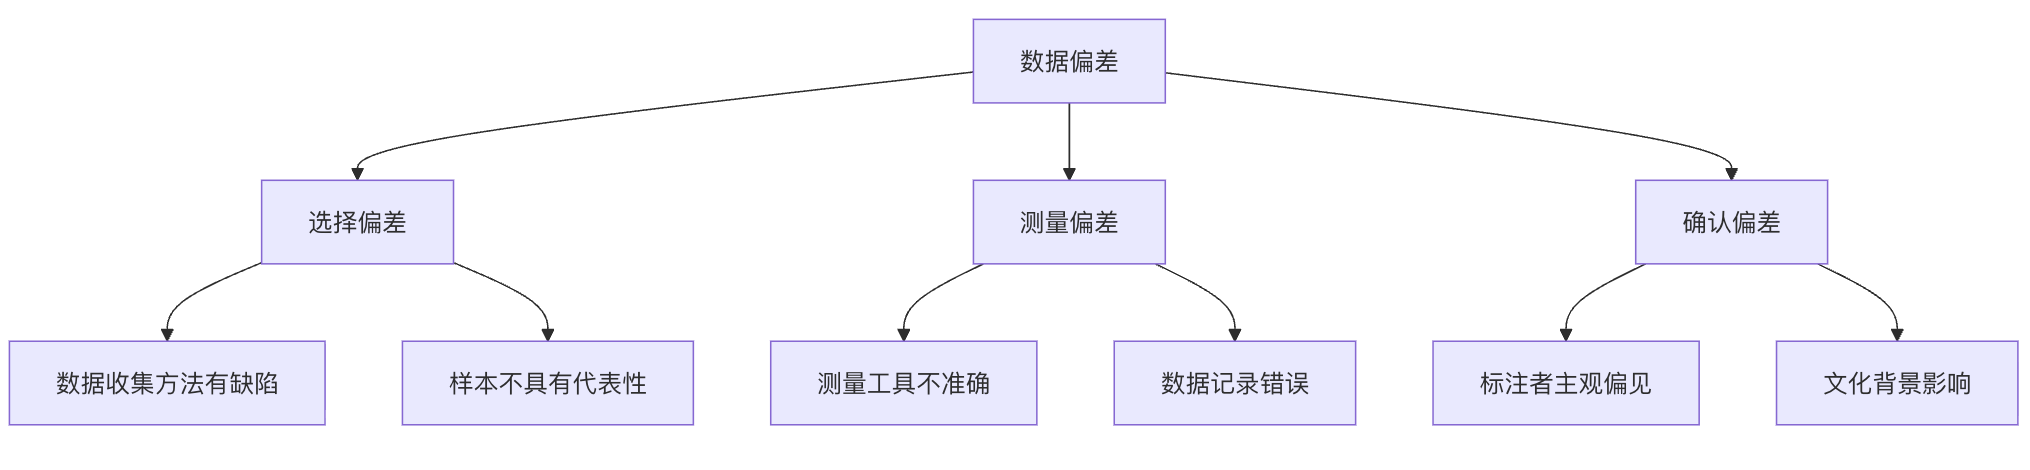
Как смещение данных влияет на модели машинного обучения?
Ухудшение производительности модели
Когда модель хорошо работает на обучающих данных, но плохо — на реальных данных, вероятно, существует проблема смещения данных.
Пример
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
np.random.seed(42)
n_samples = 1000
# Реальные данные
X_real = np.random.uniform(-5, 5, n_samples).reshape(-1, 1)
y_real = (X_real.flatten() > 0).astype(int)
# Смещённые данные: 90% из X > 0, 10% из X < 0
mask_pos = X_real.flatten() > 0
mask_neg = X_real.flatten() <= 0
X_pos = X_real[mask_pos]
y_pos = y_real[mask_pos]
X_neg = X_real[mask_neg]
y_neg = y_real[mask_neg]
# Выбираем только небольшое количество отрицательных примеров
neg_sample_size = int(0.1 * len(X_pos))
neg_indices = np.random.choice(len(X_neg), neg_sample_size, replace=False)
X_biased = np.vstack([X_pos, X_neg[neg_indices]])
y_biased = np.hstack([y_pos, y_neg[neg_indices]])
# Разделение на обучающую / тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(
X_biased, y_biased, test_size=0.2, random_state=42
)
# Обучаем модель
model = LogisticRegression()
model.fit(X_train, y_train)
# Оценка на обучающей выборке
train_pred = model.predict(X_train)
train_acc = accuracy_score(y_train, train_pred)
print(f"Точность на обучающей выборке: {train_acc:.2%}")
# Оценка на реальных данных
real_pred = model.predict(X_real)
real_acc = accuracy_score(y_real, real_pred)
print(f"Точность на реальных данных: {real_acc:.2%}")
print("Вывод: на обучающей выборке модель показывает хорошие результаты, но из-за смещения распределения качество на реальных данных значительно снижается")
Результат вывода:
训练准确率: 99.08%
真实世界准确率: 96.00%
结论:训练集表现良好,但由于分布偏差,真实世界性能显著下降
Проблемы справедливости
Смещение данных может приводить к тому, что модели будут выдавать дискриминационные результаты для определённых групп. Например, если алгоритм найма обучен в основном на исторических данных о сотрудниках-мужчинах, он может быть предвзятым по отношению к женщинам-соискательницам.
Недостаточная способность к обобщению
Модель не может адаптироваться к новым, не встречавшимся ранее данным, поскольку обучающие данные не охватывают достаточно разнообразный диапазон ситуаций.
Распространённые источники смещения данных
Проблемы на этапе сбора данных
| Тип проблемы | Конкретное проявление | Пример |
|---|---|---|
| Смещение выборки | Выборка данных не может представлять генеральную совокупность | Сбор данных для автономного вождения только в городских районах, игнорируя сельские дороги |
| Временное смещение | Данные устарели или не учитывают временной фактор | Использование данных электронной коммерции за 2010 год для прогнозирования потребительских трендов 2023 года |
| Смещение выживаемости | Фокусировка только на «выживших» точках данных | Изучение только данных успешных компаний, игнорируя опыт неудачных компаний |
Проблемы на этапе разметки данных
Пример
import pandas as pd
# Создать имитационный набор данных
data = {
'text': [
'Этот товар действительно отличный, он мне очень нравится!',
'Не уверен, что это хорошо работает',
'Категорически не покупайте этот хлам',
'Нормально, просто средне',
'Очень рекомендую, отличное соотношение цены и качества'
],
# Предположим, у аннотаторов есть собственное смещение: положительные отзывы помечаются как 1, всё остальное помечается как 0
'biased_label': [1, 0, 0, 0, 1], # Смещённая разметка
'true_label': [1, 0.5, 0, 0.5, 1] # Истинные непрерывные оценки тональности
}
df = pd.DataFrame(data)
print("Пример смещения разметки:")
print(df)
print("\nПроблема: аннотатор ошибочно пометил нейтральные отзывы как негативные!")
Вывод:
标注偏差示例:
              text  biased_label  true_label
0  这个产品真的很棒,我非常喜欢!             1         1.0
1       不太确定这个好不好用             0         0.5
2      绝对不要买这个垃圾产品             0         0.0
3          还行吧,一般般             0         0.5
4        超级推荐,物超所值             1         1.0

问题:标注者将中性评价错误地标注为负面!
Проблемы на этапе предварительной обработки данных
- Некорректная обработка выбросов
- Смещённый отбор признаков
- Неподходящие методы стандартизации данных
Как обнаружить смещение данных?
1. Статистический анализ данных
Проверьте распределение разных групп в наборе данных.
Пример
import matplotlib.pyplot as plt
# -------------------------- Начало настройки китайского шрифта --------------------------
plt.rcParams['font.sans-serif'] = [
# Приоритет Windows
'SimHei', 'Microsoft YaHei',
# Приоритет macOS
'PingFang SC', 'Heiti TC',
# Приоритет Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Исправление проблемы отображения знака минус в виде квадрата
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Конец настройки китайского шрифта --------------------------
# Смоделировать демографические данные
groups = ['Group A', 'Group B', 'Group C', 'Группа D']
population_percent = [40, 30, 20, 10] # Реальные доли населения
dataset_percent = [70, 20, 8, 2] # Доли в наборе данных
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 5))
# Распределение населения в реальном мире
ax1.pie(population_percent, labels=groups, autopct='%1.1f%%')
ax1.set_title('Распределение населения в реальном мире')
# Распределение в наборе данных
ax2.pie(dataset_percent, labels=groups, autopct='%1.1f%%')
ax2.set_title('Распределение групп в наборе данных')
plt.tight_layout()
plt.show()
print("Результат обнаружения: Группа A чрезмерно представлена в наборе данных, а Группа D недостаточно представлена!")

2. Анализ различий в производительности модели
Сравните производительность модели в разных подгруппах.
3. Расчёт метрики справедливости
Используйте статистические метрики для количественной оценки степени справедливости модели.
Стратегии устранения предвзятости данных
Решения на уровне данных
1. Улучшенные стратегии сбора данных
- Активная выборка: Осознанно собирать недостаточно представленные данные
- Аугментация данных: Увеличить разнообразие данных с помощью технических средств
- Несколько источников данных: Интегрировать данные из разных источников
2. Методы предварительной обработки данных
Пример
import numpy as np
from sklearn.utils import resample
np.random.seed(42)
# 1. Создайте несбалансированные данные (одномерные признаки + метки)
X_majority = np.random.normal(0, 1, 900).reshape(-1, 1)
y_majority = np.zeros(900, dtype=int)
X_minority = np.random.normal(2, 1, 100).reshape(-1, 1)
y_minority = np.ones(100, dtype=int)
print(f"До ресемплинга:")
print(f"Класс большинства: {len(X_majority)}")
print(f"Класс меньшинства: {len(X_minority)}")
# 2. Увеличить выборку класса меньшинства
X_minority_upsampled, y_minority_upsampled = resample(
X_minority,
y_minority,
replace=True,
n_samples=len(X_majority),
random_state=42
)
# 3. Объедините сбалансированный набор данных
X_balanced = np.vstack([X_majority, X_minority_upsampled])
y_balanced = np.hstack([y_majority, y_minority_upsampled])
print(f"\n"После пересэмплирования:")
print(f"Класс большинства: {np.sum(y_balanced == 0)}")
print(f"Класс меньшинства: {np.sum(y_balanced == 1)}")
print("\n"Вывод: количество примеров полностью сбалансировано")
Вывод:
重采样前:
多数类: 900
少数类: 100

重采样后:
多数类: 900
少数类: 900

结论:样本数量已完全平衡
Решения на уровне алгоритма
Ограничения справедливости: добавьте ограничения справедливости во время обучения модели.
-
Состязательное устранение предвзятости: используйте методы состязательного обучения, чтобы уменьшить предвзятость в модели.
-
Методы постобработки: корректируйте предсказания модели для повышения справедливости.
Практическое упражнение: построить несмещённый классификатор
Давайте рассмотрим полный пример, чтобы научиться обрабатывать смещение данных на протяжении всего процесса — от сбора данных до оценки модели.
Пример
import numpy as np
import pandas as pd
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, confusion_matrix
from imblearn.over_sampling import SMOTE
import warnings
warnings.filterwarnings("ignore", category=FutureWarning)
# 1. Сгенерировать имитационные несбалансированные данные
X, y = make_classification(
n_samples=2000,
n_features=10,
n_informative=8,
n_redundant=2,
n_clusters_per_class=1,
weights=[0.9, 0.1], # Намеренно создать смещение классов
flip_y=0,
random_state=42
)
# Преобразовать в DataFrame для анализа
feature_names = [f'feature_{i}' for i in range(X.shape[1])]
df = pd.DataFrame(X, columns=feature_names)
df['target'] = y
print("=== Анализ смещения данных ===")
print(f"Размер набора данных: {df.shape}")
print("Распределение классов:")
print(df['target'].value_counts())
print(f"Доля миноритарного класса: {df['target'].value_counts(normalize=True))
# 2. Разделение данных (сохранить пропорции классов для предотвращения вторичного смещения)
X_train, X_test, y_train, y_test = train_test_split(
X,
y,
test_size=0.3,
random_state=42,
stratify=y
)
print("\n"=== Распределение обучающей/тестовой выборки ===")
print("Обучающая выборка:", np.bincount(y_train))
print("Тестовая выборка:", np.bincount(y_test))
# 3. Использование SMOTE для обработки смещения обучающей выборки
print("\n"=== Обработка смещения данных (SMOTE) ===")
smote = SMOTE(random_state=42)
X_train_balanced, y_train_balanced = smote.fit_resample(X_train, y_train)
print("До SMOTE:", np.bincount(y_train))
print("После SMOTE:", np.bincount(y_train_balanced))
# 4. Обучение модели
print("\n"=== Обучение модели ===")
# Базовая модель: без обработки смещения
model_imbalanced = RandomForestClassifier(
n_estimators=200,
random_state=42
)
model_imbalanced.fit(X_train, y_train)
# Модель с обработанным смещением: обучена после SMOTE
model_balanced = RandomForestClassifier(
n_estimators=200,
random_state=42
)
model_balanced.fit(X_train_balanced, y_train_balanced)
# 5. Оценка модели
print("\n"=== Оценка модели (тестовый набор) ===")
print("\n"【Необработанное смещение】Отчёт по классификации")
y_pred_imbalanced = model_imbalanced.predict(X_test)
print(classification_report(y_test, y_pred_imbalanced, digits=4))
print("Матрица ошибок:")
print(confusion_matrix(y_test, y_pred_imbalanced))
print("\n"【После обработки SMOTE】Отчёт о классификации")
y_pred_balanced = model_balanced.predict(X_test)
print(classification_report(y_test, y_pred_balanced, digits=4))
print("Матрица ошибок:")
print(confusion_matrix(y_test, y_pred_balanced))
print(
"\nЗаключение:\n"
"1. Без обработки смещения модель имеет крайне низкий Recall для класса меньшинства\n"
"2. SMOTE значительно улучшает Recall и F1 для класса меньшинства\n"
"3. Accuracy не является надёжной метрикой для несбалансированных данных"
)
Вывод результатов:
=== 数据偏差分析 ===
数据集形状: (2000, 11)
类别分布:
target
0    1800
1     200
Name: count, dtype: int64
少数类占比: 10.00%

=== 训练 / 测试集分布 ===
训练集: [1260  140]
测试集: [540  60]

=== 处理数据偏差(SMOTE)===
SMOTE 前: [1260  140]
SMOTE 后: [1260 1260]

=== 模型训练 ===

=== 模型评估(测试集)===

【未处理偏差】分类报告
              precision    recall  f1-score   support

           0     0.9872    1.0000    0.9936       540
           1     1.0000    0.8833    0.9381        60

    accuracy                         0.9883       600
   macro avg     0.9936    0.9417    0.9658       600
weighted avg     0.9885    0.9883    0.9880       600

混淆矩阵:
[[540   0]
 [  7  53]]

【SMOTE 处理后】分类报告
              precision    recall  f1-score   support

           0     0.9944    0.9944    0.9944       540
           1     0.9500    0.9500    0.9500        60

    accuracy                         0.9900       600
   macro avg     0.9722    0.9722    0.9722       600
weighted avg     0.9900    0.9900    0.9900       600

混淆矩阵:
[[537   3]
 [  3  57]]

结论:
1. 不处理偏差时,模型对少数类 Recall 极低
2. SMOTE 显著提升少数类 Recall 与 F1
3. Accuracy 不是不平衡数据的可靠指标
Лучшие отраслевые практики управления смещением данных
1. Создайте структуру управления данными
- Разработайте стандартные процессы сбора и аннотирования данных
- Регулярно проводите аудит качества данных
- Создайте механизмы обнаружения предвзятости данных
2. Создайте разнообразную команду
- Обеспечьте разнообразие в команде специалистов по данным
- Привлекайте экспертов в предметной области и специалистов по этике
- Проводите регулярные тренинги по осведомленности о предвзятости
3. Прозрачность и интерпретируемость
- Фиксируйте источники данных и процедуры обработки
- Предоставляйте пояснения к решениям модели
- Раскрывайте эффективность модели для разных групп
4. Непрерывный мониторинг и обновление
- Регулярно оценивайте эффективность модели в реальных условиях
- Наладьте обратную связь для сбора сообщений пользователей
- Своевременно обновляйте модели, чтобы адаптироваться к изменениям
Итоги и перспективы
Предвзятость данных — неизбежная проблема в машинном обучении, но благодаря систематическому выявлению и устранению мы можем значительно смягчить её влияние. Ключ — осознать:
- Предвзятость данных повсюду: почти все реальные наборы данных содержат некоторую форму предвзятости
- Раннее выявление имеет решающее значение: решение проблемы предвзятости на ранних этапах проекта требует наименьших затрат
- Сочетайте технологии с процессами: одних технических решений недостаточно; их нужно сочетать с процессами и управлением
- Процесс непрерывного улучшения: работа с предвзятостью данных — это непрерывный процесс, а не разовая задача
По мере роста требований к справедливости и подотчётности в машинном обучении эффективное управление предвзятостью данных станет ключевым навыком для каждого специалиста по данным и инженера машинного обучения. Помните: система машинного обучения должна обладать не только высокой точностью, но и высокой справедливостью и надёжностью.
Другие расширения