データバイアス
機械学習は世界を変えつつあります。レコメンドシステムから自動運転まで、その応用は至る所に存在します。
しかし、これらの知的システムは完璧ではありません。それらには共通の「アキレス腱」(Achilles' Heel)——データバイアスがあります。
今日は、機械学習モデルの公平性と正確性に影響を与えるこの中核的な問題について深く掘り下げます。
データバイアスとは?
データバイアスとは、トレーニングデータが現実世界の状況を正確に代表しておらず、機械学習モデルが誤ったパターンを学習したり、偏った予測を行ったりすることです。簡単に言えば「ガベージイン・ガベージアウト(Garbage In, Garbage Out)」です。入力データに問題があれば、出力結果にも欠陥が生じます。
データバイアスの3つの主要タイプ
選択バイアス:データ収集プロセス自体に系統的な偏りが存在する場合に発生します。例えば、ソーシャルメディアを通じてのみ若者の製品に対する意見を調査し、ソーシャルメディアを利用しない高齢者層を無視する場合です。
-
測定バイアス:データ自体の測定または記録時にエラーが発生するものです。例えば、顔認識システムの開発時に主に浅い肌色の人種の写真が使用され、その結果、深い肌色の人種に対する認識精度が低くなる場合です。
-
確証バイアス:研究者やデータラベラーが自身の主観的な偏見をデータに持ち込むものです。例えば、感情分析タスクにおいて、ラベラーが自身の文化的背景に基づいてテキストの感情を理解し、他の文化の表現方法を無視する可能性があります。
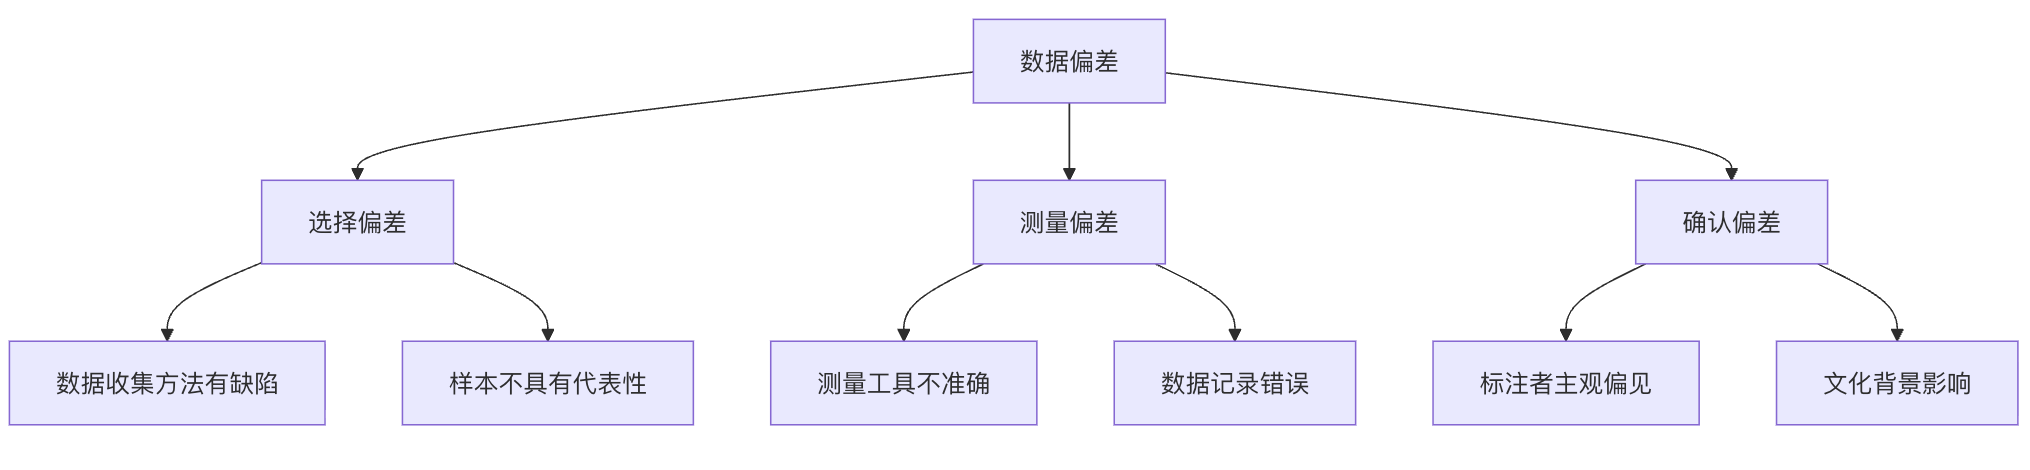
データバイアスは機械学習モデルにどのような影響を与えるのか?
モデル性能の低下
モデルがトレーニングデータでは良い性能を示す一方、実世界のデータでは悪い性能を示す場合、データバイアスの問題が存在する可能性が高いです。
例
import numpy as np
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score
np.random.seed(42)
n_samples = 1000
# 実世界のデータ
X_real = np.random.uniform(-5, 5, n_samples).reshape(-1, 1)
y_real = (X_real.flatten() > 0).astype(int)
# 偏ったデータ:90% は X > 0 から、10% は X < 0 から
mask_pos = X_real.flatten() > 0
mask_neg = X_real.flatten() <= 0
X_pos = X_real[mask_pos]
y_pos = y_real[mask_pos]
X_neg = X_real[mask_neg]
y_neg = y_real[mask_neg]
# 負のサンプルを少量のみ抽出
neg_sample_size = int(0.1 * len(X_pos))
neg_indices = np.random.choice(len(X_neg), neg_sample_size, replace=False)
X_biased = np.vstack([X_pos, X_neg[neg_indices]])
y_biased = np.hstack([y_pos, y_neg[neg_indices]])
# トレーニング / テストに分割
X_train, X_test, y_train, y_test = train_test_split(
X_biased, y_biased, test_size=0.2, random_state=42
)
# モデルを訓練
model = LogisticRegression()
model.fit(X_train, y_train)
# トレーニングセットの評価
train_pred = model.predict(X_train)
train_acc = accuracy_score(y_train, train_pred)
print(f"トレーニング精度: {train_acc:.2%}")
# 実世界の評価
real_pred = model.predict(X_real)
real_acc = accuracy_score(y_real, real_pred)
print(f"実世界の精度: {real_acc:.2%}")
print("結論:トレーニングセットでは良好な性能だが、分布バイアスのため実世界の性能は著しく低下する")
出力結果は次の通りです:
训练准确率: 99.08%
真实世界准确率: 96.00%
结论:训练集表现良好,但由于分布偏差,真实世界性能显著下降
公平性の問題
データバイアスは、モデルが特定の集団に対して差別的な結果を生み出す可能性があります。例えば、採用アルゴリズムが主に男性社員の履歴データを使用して訓練された場合、女性の求職者に対して偏見を持つ可能性があります。
汎化能力の不足
トレーニングデータが十分に多様な状況をカバーしていないため、モデルが新しい未知のデータシナリオに適応できません。
データバイアスの一般的な原因
データ収集段階の問題
| 問題の種類 | 具体的な内容 | 例 |
|---|---|---|
| サンプリングバイアス | データサンプルが母集団を代表していない | 都市部でのみ自動運転データを収集し、地方の道路を無視する |
| 時間バイアス | データが古い、または鮮度がない | 2010年のECデータを使って2023年の消費動向を予測する |
| 生存者バイアス | 「生き残った」データポイントのみに注目する | 成功企業のデータのみを研究し、失敗企業の経験を無視する |
データラベリング(アノテーション)段階の問題
例
import pandas as pd
# シミュレーションデータセットを作成
data = {
'text': [
'この製品は本当に素晴らしい、とても気に入りました!',
'これが使いやすいかどうかあまり確かではない',
'このゴミ製品は絶対に買わないで',
'まあまあかな、普通だ',
'超おすすめ、価格以上の価値がある'
],
# ラベラーに偏見があると仮定:肯定的な評価を1、それ以外をすべて0とラベリング
'biased_label': [1, 0, 0, 0, 1], # 偏ったラベリング
'true_label': [1, 0.5, 0, 0.5, 1] # 実際の連続的な感情スコア
}
df = pd.DataFrame(data)
print("ラベリングバイアスの例:")
print(df)
print("\n"問題:ラベラーが中立の評価を誤ってネガティブにラベリングしました!")
出力は次の通りです:
标注偏差示例:
              text  biased_label  true_label
0  这个产品真的很棒,我非常喜欢!             1         1.0
1       不太确定这个好不好用             0         0.5
2      绝对不要买这个垃圾产品             0         0.0
3          还行吧,一般般             0         0.5
4        超级推荐,物超所值             1         1.0

问题:标注者将中性评价错误地标注为负面!
データ前処理段階の問題
- 外れ値の処理が不適切
- 特徴選択に偏りがある
- データ標準化の方法が適切でない
データバイアスを検出するには?
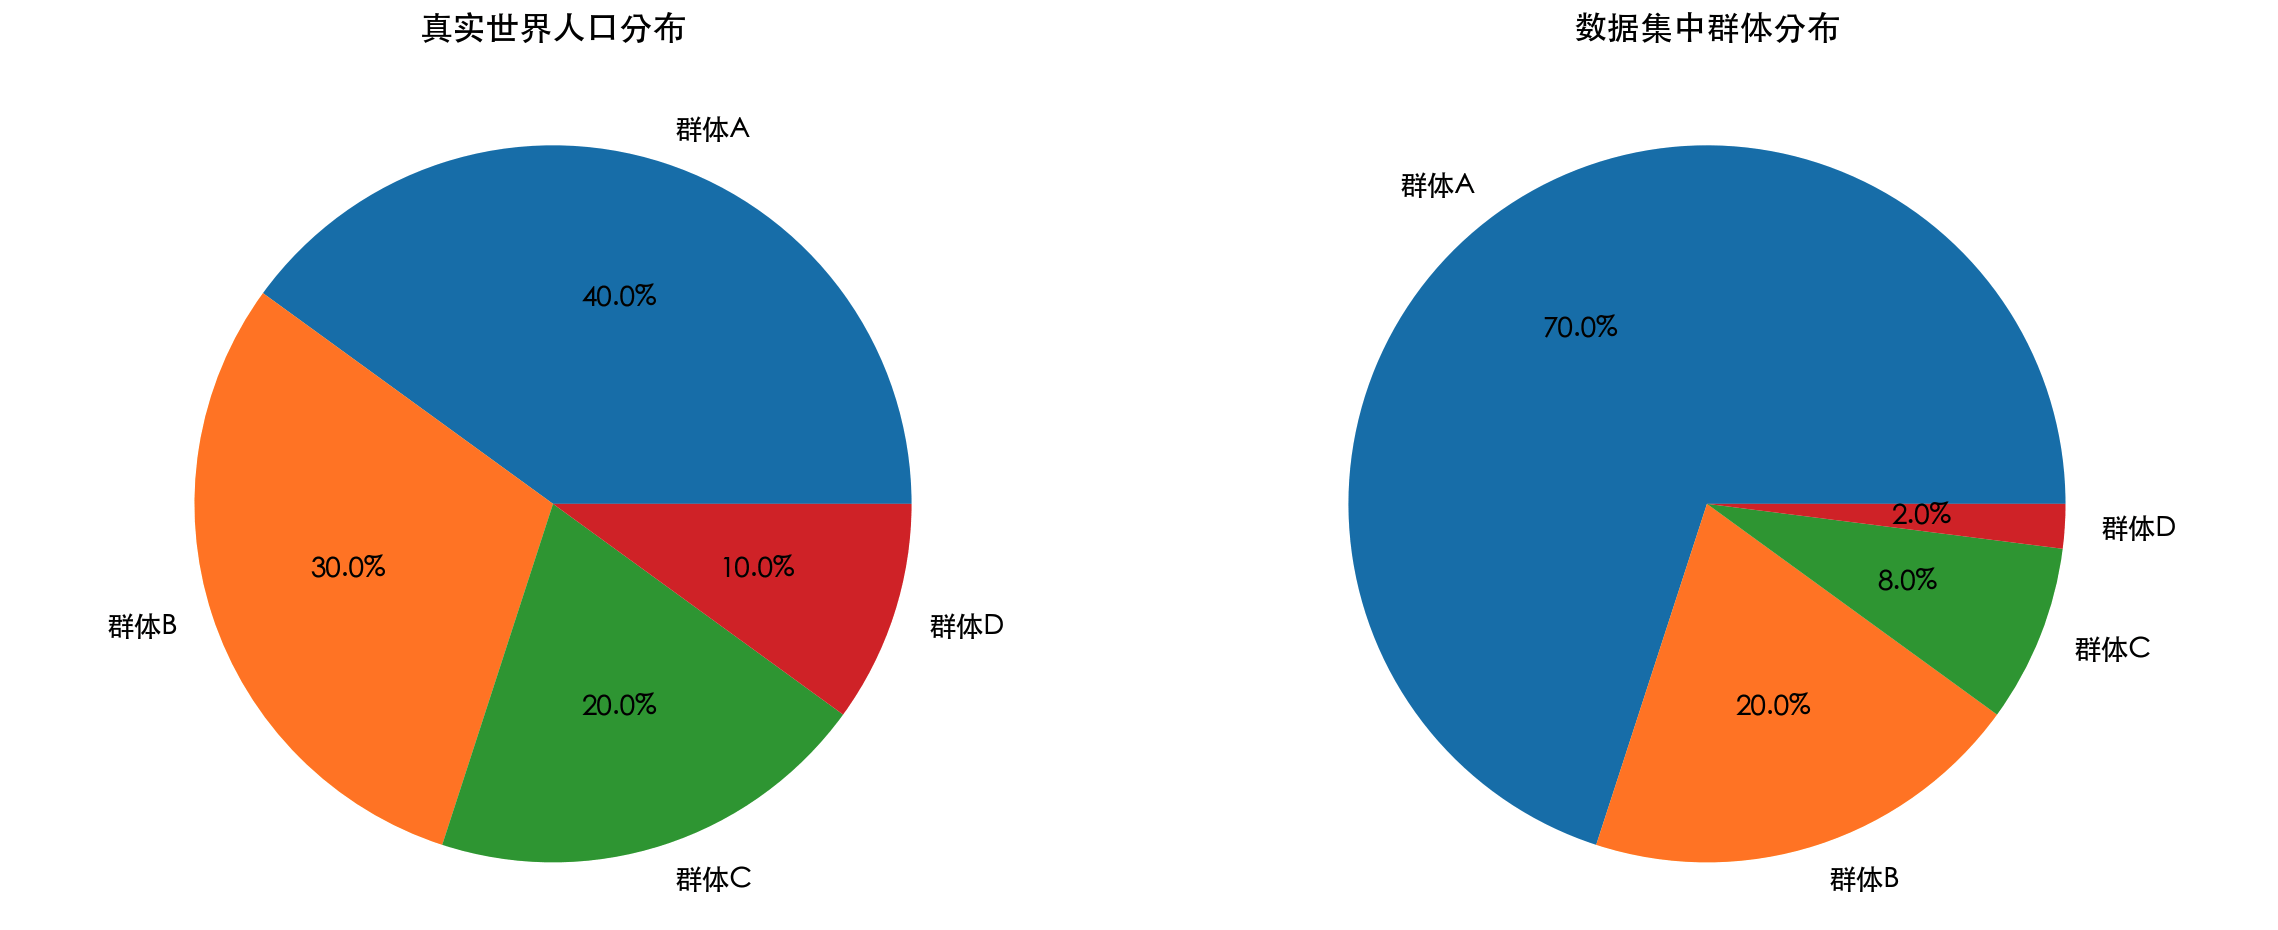
1. データ統計分析
データセット内の異なる集団の分布状況を確認します。
例
import matplotlib.pyplot as plt
# -------------------------- 中国語フォントの設定 start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows 優先
'SimHei', 'Microsoft YaHei',
# macOS 優先
'PingFang SC', 'Heiti TC',
# Linux 優先
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# マイナス記号が四角で表示される問題を修正
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- 中国語フォントの設定 end --------------------------
# 人口統計データをシミュレーション
groups = ['集団A', '集団B', '集団C', '集団D']
population_percent = [40, 30, 20, 10] # 実際の人口割合
dataset_percent = [70, 20, 8, 2] # データセット内の割合
fig, (ax1, ax2) = plt.subplots(1, 2, figsize=(12, 5))
# 実際の人口分布
ax1.pie(population_percent, labels=groups, autopct='%1.1f%%')
ax1.set_title('実世界の人口分布')
# データセットの分布
ax2.pie(dataset_percent, labels=groups, autopct='%1.1f%%')
ax2.set_title('データセット内の集団分布')
plt.tight_layout()
plt.show()
print("検出結果:集団Aはデータセット内で過剰に代表され、集団Dは代表不足です!")
2. モデル性能の差異分析
異なるサブグループに対するモデルの性能を比較します。
3. 公平性指標の計算
統計指標を使用してモデルの公平性の度合いを定量化します。
データバイアスを解決する戦略
データレベルの解決策
1. データ収集戦略の改善
- アクティブサンプリング:代表不足のデータを意図的に収集する
- データ拡張:技術的手段によってデータの多様性を高める
- 複数のデータソース:異なるソースからのデータを統合する
2. データ前処理技術
例
import numpy as np
from sklearn.utils import resample
np.random.seed(42)
# 1. 不均衡データを構築(1次元特徴量 + ラベル)
X_majority = np.random.normal(0, 1, 900).reshape(-1, 1)
y_majority = np.zeros(900, dtype=int)
X_minority = np.random.normal(2, 1, 100).reshape(-1, 1)
y_minority = np.ones(100, dtype=int)
print(f"リサンプリング前:")
print(f"多数派クラス: {len(X_majority)}")
print(f"少数派クラス: {len(X_minority)}")
# 2. 少数派クラスをアップサンプリング
X_minority_upsampled, y_minority_upsampled = resample(
X_minority,
y_minority,
replace=True,
n_samples=len(X_majority),
random_state=42
)
# 3. バランス調整後のデータセットを結合
X_balanced = np.vstack([X_majority, X_minority_upsampled])
y_balanced = np.hstack([y_majority, y_minority_upsampled])
print(f"\n"リサンプリング後:")
print(f"多数派クラス: {np.sum(y_balanced == 0)}")
print(f"少数派クラス: {np.sum(y_balanced == 1)}")
print("\n"結論:サンプル数は完全にバランスが取れています")
出力:
重采样前:
多数类: 900
少数类: 100

重采样后:
多数类: 900
少数类: 900

结论:样本数量已完全平衡
アルゴリズムレベルの解決策
公平性制約:モデルトレーニングのプロセスに公平性の制約条件を追加します。
-
敵対的バイアス除去:敵対的学習技術を使用してモデル内のバイアスを軽減します。
-
後処理方法:モデルの予測結果を調整して公平性を高めます。
実践演習:偏りのない分類器を構築する
完全な例を通して、データ収集からモデル評価までのプロセス全体でデータバイアスをどう扱うかを学びましょう。
例
import numpy as np
import pandas as pd
from sklearn.datasets import make_classification
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import classification_report, confusion_matrix
from imblearn.over_sampling import SMOTE
import warnings
warnings.filterwarnings("ignore", category=FutureWarning)
# 1. シミュレーション不均衡データを生成
X, y = make_classification(
n_samples=2000,
n_features=10,
n_informative=8,
n_redundant=2,
n_clusters_per_class=1,
weights=[0.9, 0.1], # 明示的にカテゴリバイアスを作成
flip_y=0,
random_state=42
)
# DataFrameに変換して分析しやすくする
feature_names = [f'feature_{i}' for i in range(X.shape[1])]
df = pd.DataFrame(X, columns=feature_names)
df['target'] = y
print("=== データバイアス分析 ===")
print(f"データセット形状: {df.shape}")
print("クラス分布:")
print(df['target'].value_counts())
print(f"少数クラス比率: {df['target'].value_counts(normalize=True))
# 2. データ分割(クラス比率を維持し、二次バイアスを防ぐ)
X_train, X_test, y_train, y_test = train_test_split(
X,
y,
test_size=0.3,
random_state=42,
stratify=y
)
print("\n=== 訓練 / テストセット分布 ===)
print("訓練セット:", np.bincount(y_train))
print("テストセット:", np.bincount(y_test))
# 3. SMOTEを使用して訓練セットのバイアスを処理
print("\n=== データバイアスの処理(SMOTE)===)
smote = SMOTE(random_state=42)
X_train_balanced, y_train_balanced = smote.fit_resample(X_train, y_train)
print("SMOTE前:", np.bincount(y_train))
print("SMOTE後:", np.bincount(y_train_balanced))
# 4. モデル学習
print("\n=== モデル学習 ===)
# ベースラインモデル:バイアス処理なし
model_imbalanced = RandomForestClassifier(
n_estimators=200,
random_state=42
)
model_imbalanced.fit(X_train, y_train)
# バイアス処理モデル:SMOTE後の学習
model_balanced = RandomForestClassifier(
n_estimators=200,
random_state=42
)
model_balanced.fit(X_train_balanced, y_train_balanced)
# 5. モデル評価
print("\n=== モデル評価(テストセット)===)
print("\n"【バイアス未処理】分類レポート")
y_pred_imbalanced = model_imbalanced.predict(X_test)
print(classification_report(y_test, y_pred_imbalanced, digits=4))
print("混同行列:")
print(confusion_matrix(y_test, y_pred_imbalanced))
print("\n"【SMOTE処理後】分類レポート")
y_pred_balanced = model_balanced.predict(X_test)
print(classification_report(y_test, y_pred_balanced, digits=4))
print("混同行列:")
print(confusion_matrix(y_test, y_pred_balanced))
print(
"\n結論:\n"
"1. バイアスを処理しない場合、モデルの少数クラスに対するRecallは極めて低い"\n"
"2. SMOTEは少数クラスのRecallとF1を顕著に向上させる"\n"
"3. Accuracyは不均衡データの信頼できる指標ではない"
)
出力結果:
=== 数据偏差分析 ===
数据集形状: (2000, 11)
类别分布:
target
0    1800
1     200
Name: count, dtype: int64
少数类占比: 10.00%

=== 训练 / 测试集分布 ===
训练集: [1260  140]
测试集: [540  60]

=== 处理数据偏差(SMOTE)===
SMOTE 前: [1260  140]
SMOTE 后: [1260 1260]

=== 模型训练 ===

=== 模型评估(测试集)===

【未处理偏差】分类报告
              precision    recall  f1-score   support

           0     0.9872    1.0000    0.9936       540
           1     1.0000    0.8833    0.9381        60

    accuracy                         0.9883       600
   macro avg     0.9936    0.9417    0.9658       600
weighted avg     0.9885    0.9883    0.9880       600

混淆矩阵:
[[540   0]
 [  7  53]]

【SMOTE 处理后】分类报告
              precision    recall  f1-score   support

           0     0.9944    0.9944    0.9944       540
           1     0.9500    0.9500    0.9500        60

    accuracy                         0.9900       600
   macro avg     0.9722    0.9722    0.9722       600
weighted avg     0.9900    0.9900    0.9900       600

混淆矩阵:
[[537   3]
 [  3  57]]

结论:
1. 不处理偏差时,模型对少数类 Recall 极低
2. SMOTE 显著提升少数类 Recall 与 F1
3. Accuracy 不是不平衡数据的可靠指标
データバイアス管理における業界のベストプラクティス
1. データガバナンスフレームワークの構築
- データ収集とアノテーションの標準プロセスを策定する
- データ品質を定期的に監査する
- データバイアス検出メカニズムを構築する
2. 多様性のあるチーム構築
- データサイエンスチームの多様性を確保する
- ドメイン専門家や倫理学者を含める
- バイアス意識トレーニングを定期的に実施する
3. 透明性と説明可能性
- データの出所と処理プロセスを記録する
- モデルの決定に関する説明を提供する
- モデルの異なるグループに対する性能を公開する
4. 継続的なモニタリングと更新
- 実世界におけるモデルのパフォーマンスを定期的に評価する
- ユーザーからの報告を収集するフィードバックメカニズムを構築する
- 変化に適応するためにモデルを迅速に更新する
まとめと展望
データバイアスは機械学習において避けられない課題ですが、体系的な検出と処理方法によって、その影響を大幅に軽減できます。重要なのは以下の点を認識することです:
- データバイアスは至るところに存在する:ほぼすべての実世界データセットには何らかの形のバイアスが存在する
- 早期検出が極めて重要:プロジェクト初期にバイアス問題を考慮することが、コストを最小限に抑える
- 技術+プロセスの結合:技術的な解決策だけでは不十分で、プロセスと管理を組み合わせる必要がある
- 継続的な改善プロセス:データバイアスの処理は継続的なプロセスであり、一度きりのタスクではない
機械学習の公平性と説明責任への要求がますます高まる中、データバイアスを効果的に管理することは、すべてのデータサイエンティストと機械学習エンジニアの中核的スキルになるでしょう。良い機械学習システムは、高い精度だけでなく、高い公平性と信頼性を備える必要があることを忘れないでください。
その他の拡張