Распространённые типы сетей
Представьте, что мы учим ребёнка распознавать кошек и собак.
Сначала мы показываем ему много изображений кошек и собак и говорим ему: «это кошка, это собака». Постепенно мозг ребёнка извлекает закономерности из этих изображений: у кошек обычно заострённые уши и более округлая морда; у собак уши могут свисать, а морды длиннее. По сути, этот процесс —изучение признаковии построение закономерностей.。
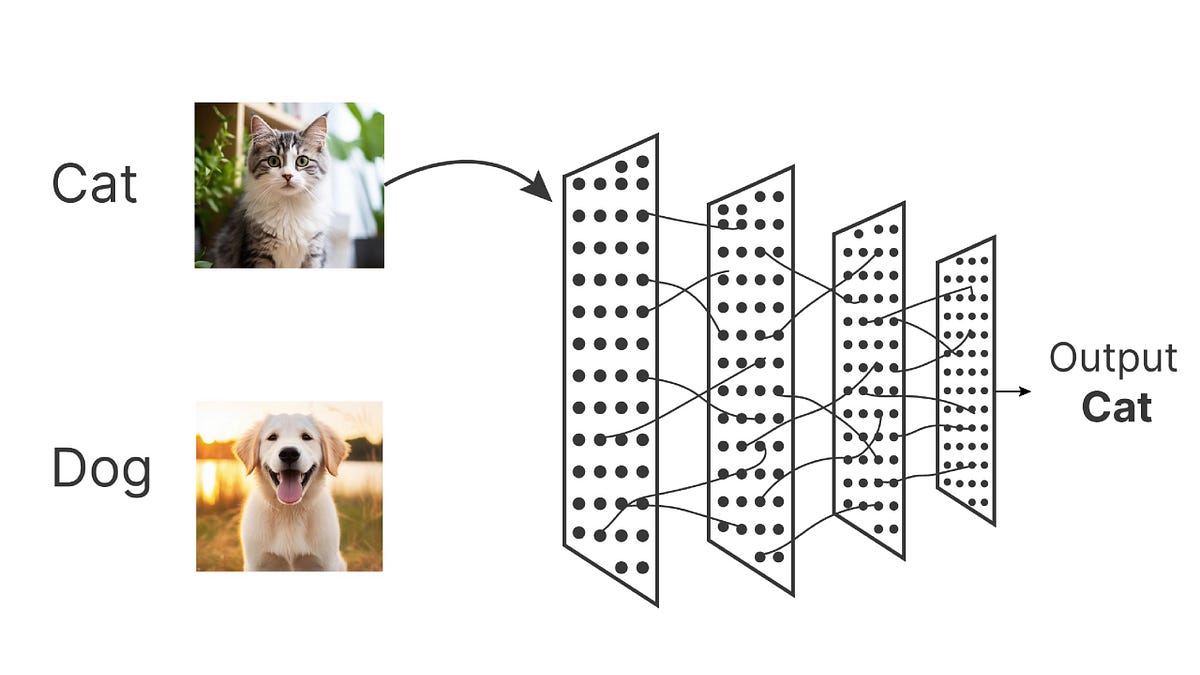
Глубокое обучение — мощная ветвь машинного обучения — сосредоточено на том, чтобы позволить компьютерам имитировать этот процесс. Создавая многослойные нейронные сети, оно позволяет машинам автоматически изучать и извлекать сложные признаки из огромных объёмов данных, в конечном итоге выполняя такие продвинутые задачи, как распознавание изображений, понимание языка и прогнозирование тенденций. Разные задачи требуют сетей с разной архитектурой. В этой статье мы познакомим вас с несколькими основными распространёнными типами сетей глубокого обучения и поможем понять их философию проектирования и типичные применения.
Нейронные сети глубокого обучения
| Полное название на китайском | Полное название на английском | Сокращение |
|---|---|---|
| Искусственная нейронная сеть | Искусственная нейронная сеть | ANN |
| Свёрточная нейронная сеть | Свёрточная нейронная сеть | CNN |
| Рекуррентная нейронная сеть | Рекуррентная нейронная сеть | RNN |
| Сеть долгой краткосрочной памяти | Долгая краткосрочная память | LSTM |
| Рекуррентный блок с вентилями | Рекуррентный блок с вентилями | GRU |
| Генеративная состязательная сеть | Генеративная состязательная сеть | GAN |
| Трансформер | Трансформер | Трансформер |
| Автоэнкодер | Автоэнкодер | AE |
| Вариационный автоэнкодер | Вариационный автоэнкодер | VAE |
| Сеть глубокого доверия | Сеть глубокого доверия | DBN |
| Графовая нейронная сеть | Графовая нейронная сеть | GNN |
Основы нейронных сетей и полносвязные сети
Прежде чем погружаться в различные сети, нужно понять самую базовую модель —полносвязную сеть, также известную какмногослойный перцептрон (MLP)。
Ключевая идея: всё может быть соединено
Полносвязная сеть — самая простая архитектура в глубоком обучении. Как следует из названия,каждый нейронкаждого слоя соединён скаждым нейроном соседнего слоя..
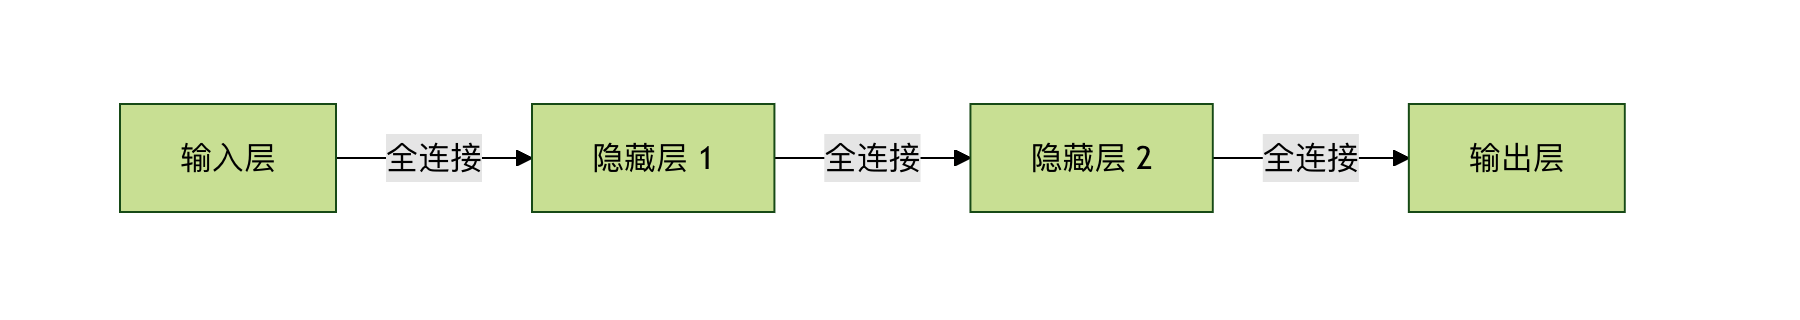
Мы можем представить её как чрезвычайно плотную сеть обработки информации. Данные поступают из входного слоя, проходят преобразования через несколько скрытых слоёв и в конце выдают результаты на выходном слое.
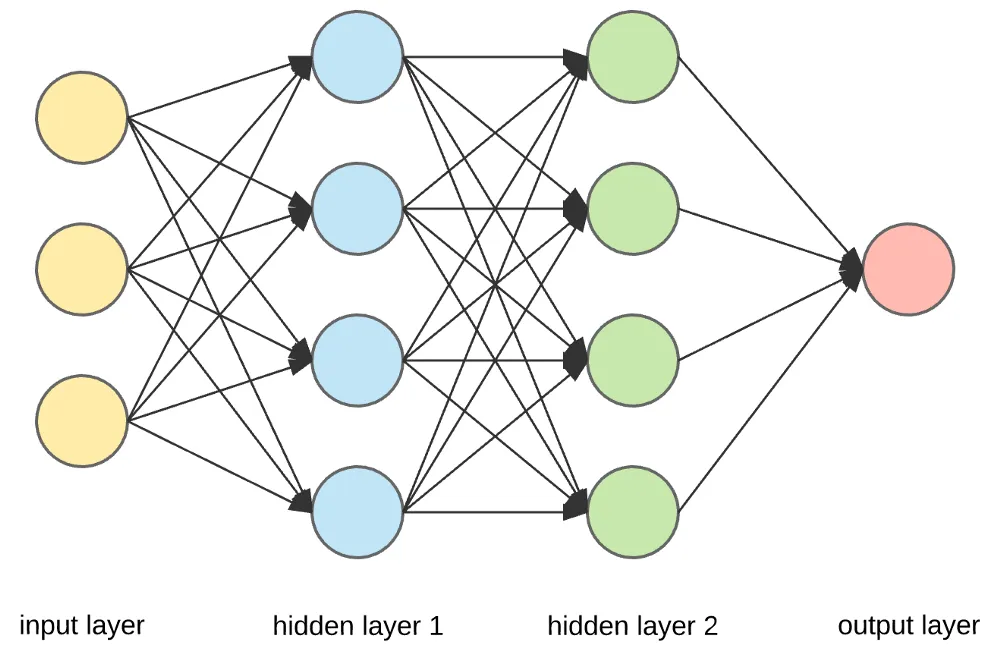
Типичные применения и ограничения
Применение: Благодаря мощной способности к аппроксимации FCN хорошо подходит для структурированных данных (например, табличных данных, таких как площадь дома, местоположение и количество комнат при прогнозировании цены дома).
Пример
import torch.nn as nn
class SimpleFCN(nn.Module):
def __init__(self, input_size, num_classes):
super(SimpleFCN, self).__init__()
# Определить слои сети
self.fc1 = nn.Linear(input_size, 128) # Первый скрытый слой
self.relu = nn.ReLU() # Функция активации
self.fc2 = nn.Linear(128, 64) # Второй скрытый слой
self.fc3 = nn.Linear(64, num_classes) # Выходной слой
def forward(self, x):
x = self.fc1(x)
x = self.relu(x)
x = self.fc2(x)
x = self.relu(x)
x = self.fc3(x)
return x
# Предположим, что вход — это 100-мерный признак для классификации на 10 классов
model = SimpleFCN(input_size=100, num_classes=10)
Ограничения: При работе с данными, подобными сетке, такими как изображения и речь, FCN сталкивается со значительными проблемами. Поскольку пиксели изображения сильно коррелированы в пространстве, FCN игнорирует эту пространственную структуру и преобразует изображение в одномерный вектор для обработки, что приводит к резкому росту числа параметров и сложности изучения эффективных пространственных признаков.
Свёрточные нейронные сети — краеугольный камень компьютерного зрения
Чтобы решить проблему обработки изображений,свёрточные нейронные сети (CNN)появились в ответ на требования времени, полностью преобразив область компьютерного зрения.
Ключевая идея: локальное восприятие и совместное использование параметров
CNN черпает вдохновение для своей конструкции из биологической зрительной коры, и две его ключевые идеи таковы:
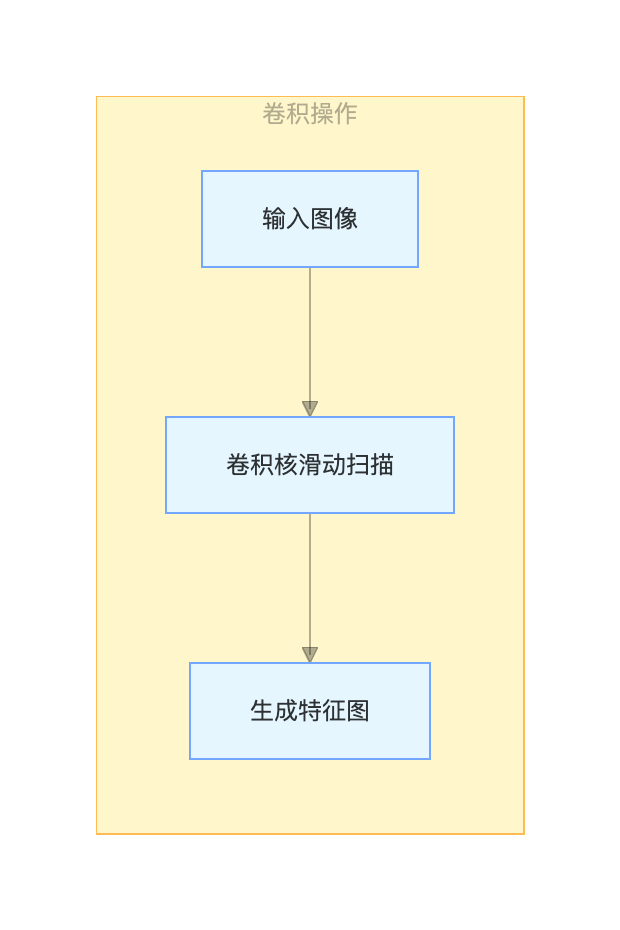
- Локальное восприятие: в отличие от FCN, где нейроны соединяются со всем изображением, каждый нейрон в CNN воспринимает тольконебольшую локальную область(например, фрагмент 3x3 или 5x5 пикселей). Это лучше соответствует свойству, что соседние пиксели изображения сильнее коррелируют между собой.
- Совместное использование параметров: использование одного и того жеядра свёртки(или фильтра) для скольжения и сканирования в разных положениях изображения, извлекая один и тот же тип признаков (например, края, текстуры). Это значительно уменьшает количество параметров сети.
Ключевые компоненты и типичные применения
Типичная CNN состоит из следующих компонентов:
- Свёрточный слой: использует ядра свёртки для извлечения признаков.
- Слой пулинга(например, max pooling): уменьшает размер карт признаков, сокращая объём данных и повышая инвариантность признаков.
- Полносвязный слой: в конце сети отображает изученные распределённые признаки в пространство меток образцов.
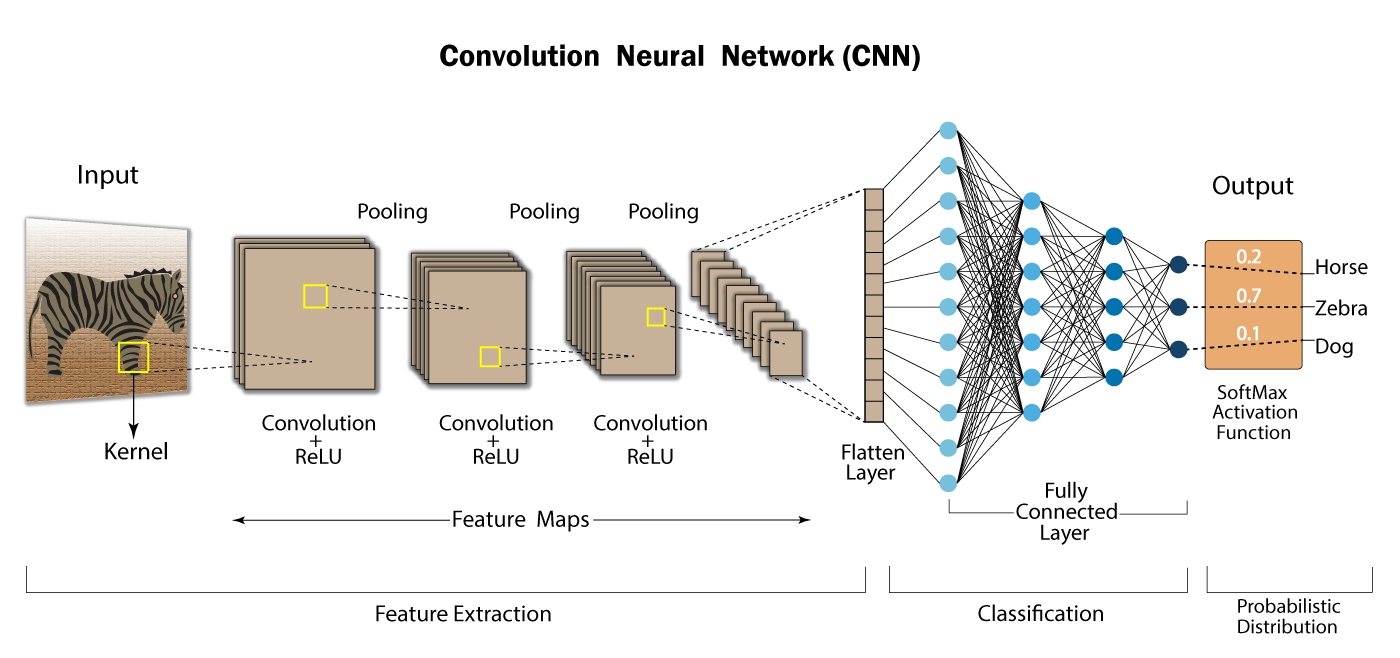
Применение: практически все задачи компьютерного зрения, такие как классификация изображений, обнаружение объектов и распознавание лиц.
Пример
class SimpleCNN(nn.Module):
def __init__(self, num_classes=10):
super(SimpleCNN, self).__init__()
self.conv1 = nn.Conv2d(in_channels=3, out_channels=16, kernel_size=3, padding=1)
self.pool = nn.MaxPool2d(kernel_size=2, stride=2)
self.conv2 = nn.Conv2d(16, 32, 3, padding=1)
self.fc1 = nn.Linear(32 * 8 * 8, 256) # Предполагается, что размер карты признаков составляет 8x8 после двух операций пулинга
self.fc2 = nn.Linear(256, num_classes)
def forward(self, x):
x = self.pool(nn.functional.relu(self.conv1(x))) # Свёртка -> Активация -> Пулинг
x = self.pool(nn.functional.relu(self.conv2(x)))
x = x.view(-1, 32 * 8 * 8) # Развернуть карту признаков в одномерный вектор
x = nn.functional.relu(self.fc1(x))
x = self.fc2(x)
return x
Рекуррентные нейронные сети — эксперты по обработке последовательных данных
Для таких данных, как язык, речь и временные ряды, которые имеютпоследовательные зависимости, нам нужна сеть, способная запоминать историческую информацию. Эторекуррентная нейронная сеть (RNN)。
Ключевая идея: введение механизма памяти
Ядро RNN заключается в его рекуррентной структуре. При обработке текущего входа сеть объединяет текущий вход искрытое состояние с предыдущего временного шага, чтобы совместно определить текущий выход и скрытое состояние, передаваемое на следующий временной шаг. Это похоже на чтение предложения: чтобы понять текущее слово, нужно опираться на ранее прочитанные слова.
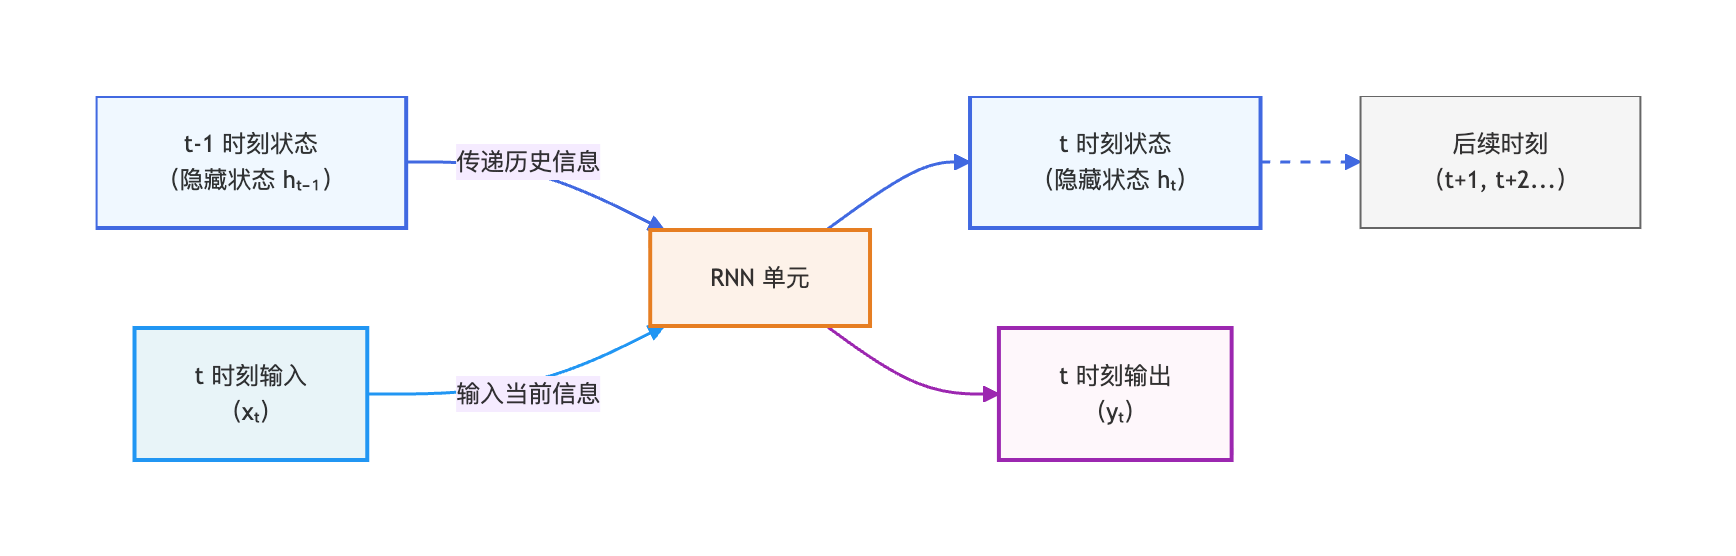
Варианты и типичные применения
Базовая RNN страдает от проблемы долговременных зависимостей, из-за чего ей трудно усваивать информацию в длинных последовательностях. Это привело к появлению двух важных вариантов:
- Сеть долгой краткосрочной памяти (LSTM): Благодаря продуманному механизму вентилей (входной вентиль, вентиль забывания, выходной вентиль) она выборочно запоминает важную информацию и забывает бесполезную, эффективно решая проблему зависимостей в длинных последовательностях.
- Управляемый рекуррентный блок (GRU): Упрощённая версия LSTM с более лаконичной структурой и более высокой вычислительной эффективностью, показывающая сопоставимые результаты во многих задачах.
Применение: машинный перевод, генерация текста, распознавание речи, прогнозирование цен на акции.
Пример
class SimpleRNN(nn.Module):
def __init__(self, vocab_size, embed_size, hidden_size, num_classes):
super(SimpleRNN, self).__init__()
self.embedding = nn.Embedding(vocab_size, embed_size) # Слой встраивания слов
self.rnn = nn.RNN(input_size=embed_size, hidden_size=hidden_size, batch_first=True)
self.fc = nn.Linear(hidden_size, num_classes)
def forward(self, x):
# Форма x: (batch_size, sequence_length)
x = self.embedding(x) # После встраивания: (batch_size, seq_len, embed_size)
_, h_n = self.rnn(x) # h_n — скрытое состояние последнего временного шага
out = self.fc(h_n.squeeze(0)) # Использовать последнее состояние для классификации
return out
Генеративно-состязательные сети — от обучения к созданию
Если предыдущие сети — это дискриминативные модели (обучающиеся различать данные), тоГенеративно-состязательная сеть (GAN)— выдающийся представитель генеративных моделей (обучающихся создавать данные).

Основная идея: эволюция через состязательные игры
GAN черпает вдохновение из теории игр. Она состоит из двух состязательных сетей:
- Генератор: как фальсификатор, его цель — изучить распределение реальных данных и генерировать новые данные, достаточно реалистичные, чтобы сойти за настоящие.
- Дискриминатор: как эксперт по аутентификации, его цель — точно определять, происходят ли входные данные из реального набора данных или из генератора.
Обе сети улучшаются вместе благодаря непрерывному состязательному обучению: генератор стремится создавать более реалистичные данные, чтобы обмануть дискриминатор, а дискриминатор работает над улучшением своей способности различать. В конечном итоге генератор может создавать новые данные высокого качества.
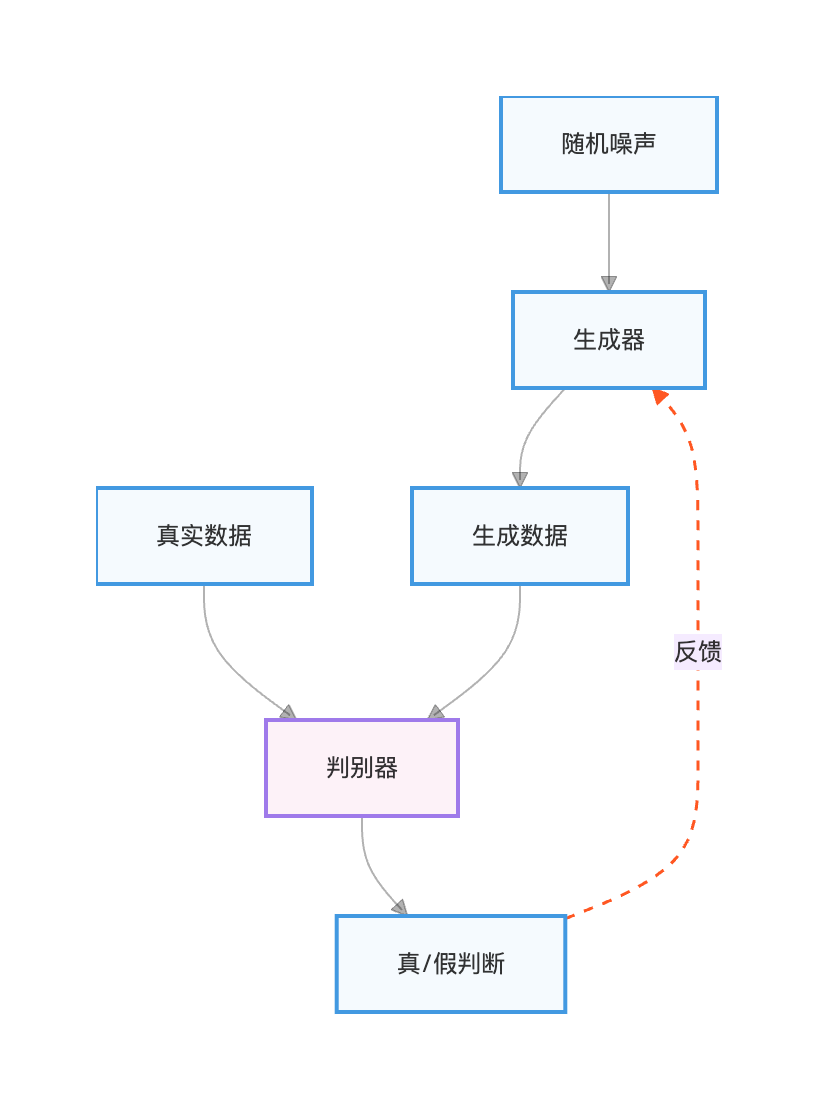
Типичные применения
Применение: генерация изображений, суперразрешение изображений, перенос стиля, аугментация данных.
Пример
for epoch in range(num_epochs):
# 1. Обучить дискриминатор: максимизировать его способность классифицировать реальные данные как реальные, а сгенерированные — как поддельные
real_data = get_real_data()
noise = generate_random_noise()
fake_data = generator(noise).detach() # Обратите внимание на detach, чтобы предотвратить обновление генератора
d_loss_real = criterion(discriminator(real_data), real_labels)
d_loss_fake = criterion(discriminator(fake_data), fake_labels)
d_loss = d_loss_real + d_loss_fake
d_loss.backward()
optimizer_D.step()
# 2. Обучите генератор: минимизируйте способность дискриминатора классифицировать сгенерированные данные как поддельные (т.е. обмануть дискриминатор)
noise = generate_random_noise()
fake_data = generator(noise)
g_loss = criterion(discriminator(fake_data), real_labels) # Заставьте дискриминатор поверить, что сгенерированные данные реальны
g_loss.backward()
optimizer_G.step()
Итоги и сравнение
| Тип сети | Ключевая идея | Типы данных, которые он лучше всего обрабатывает | Типичные применения |
|---|---|---|---|
| Полносвязная сеть | Глобальные связи, плотная подгонка | Структурированные данные (таблицы) | Прогнозирование цен на жилье, кредитный скоринг |
| Свёрточная нейронная сеть | Локальное восприятие, разделение параметров | Данные в виде сетки (изображения) | Классификация изображений, обнаружение объектов |
| Рекуррентная нейронная сеть | Временная зависимость, состояние памяти | Последовательные данные (текст, временные ряды) | Машинный перевод, распознавание речи |
| Генеративная состязательная сеть | Состязательная игра, генерация данных | Используется для генерации данных, похожих на реальные данные | Генерация изображений, перенос стиля |