Tipos de redes comunes
Imaginemos que le enseñamos a un niño a reconocer gatos y perros.
Al principio, le mostramos muchas imágenes de gatos y perros y le decimos esto es un gato, esto es un perro; poco a poco, el cerebro del niño extrae patrones de estas imágenes: las orejas de los gatos suelen ser puntiagudas y la cara redonda; las orejas de los perros pueden caer y la cara es más alargada. Este proceso, en esencia, esaprender característicasyestablecer patrones。
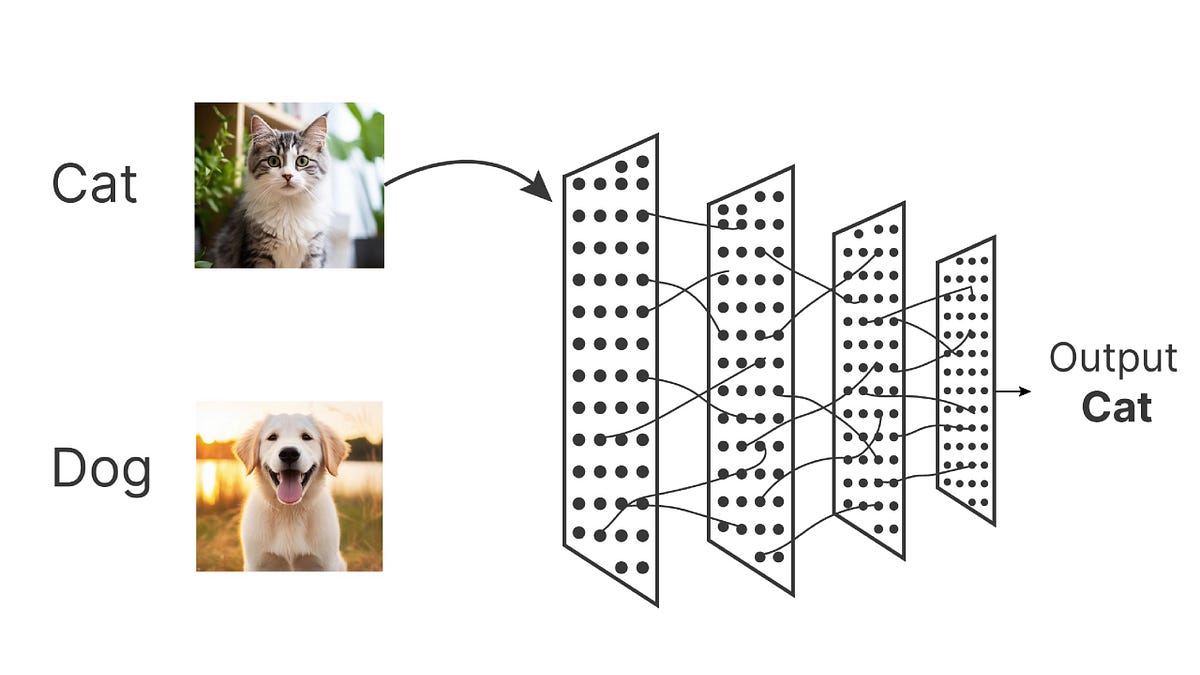
El aprendizaje profundo, una poderosa rama del aprendizaje automático, tiene como núcleo hacer que la computadora simule este proceso. Construye redes neuronales multicapa que permiten a la máquina aprender automáticamente de grandes volúmenes de datos y extraer características complejas, logrando finalmente tareas avanzadas como el reconocimiento de imágenes, la comprensión del lenguaje y la predicción de tendencias. Diferentes tareas requieren redes con diferentes estructuras. Este artículo te presentará varios de los tipos de redes de aprendizaje profundo más importantes y comunes, y te ayudará a comprender sus ideas de diseño y aplicaciones típicas.
Redes de aprendizaje profundo
| Nombre completo en chino | Nombre completo en inglés | Abreviatura |
|---|---|---|
| Red neuronal artificial | Artificial Neural Network | ANN |
| Red neuronal convolucional | Convolutional Neural Network | CNN |
| Red neuronal recurrente | Recurrent Neural Network | RNN |
| Red de memoria a largo plazo | Long Short-Term Memory | LSTM |
| Unidad recurrente con compuertas | Gated Recurrent Unit | GRU |
| Red generativa adversaria | Generative Adversarial Network | GAN |
| Transformador | Transformer | Transformer |
| Autoencoder | Autoencoder | AE |
| Autoencoder variacional | Variational Autoencoder | VAE |
| Red de creencias profundas | Deep Belief Network | DBN |
| Red neuronal de grafos | Graph Neural Network | GNN |
Fundamentos de redes neuronales y redes totalmente conectadas
Antes de profundizar en varios tipos de redes, debemos comprender el modelo más básico:red totalmente conectada, también conocida comoperceptrón multicapa。
Idea central: todo se puede conectar
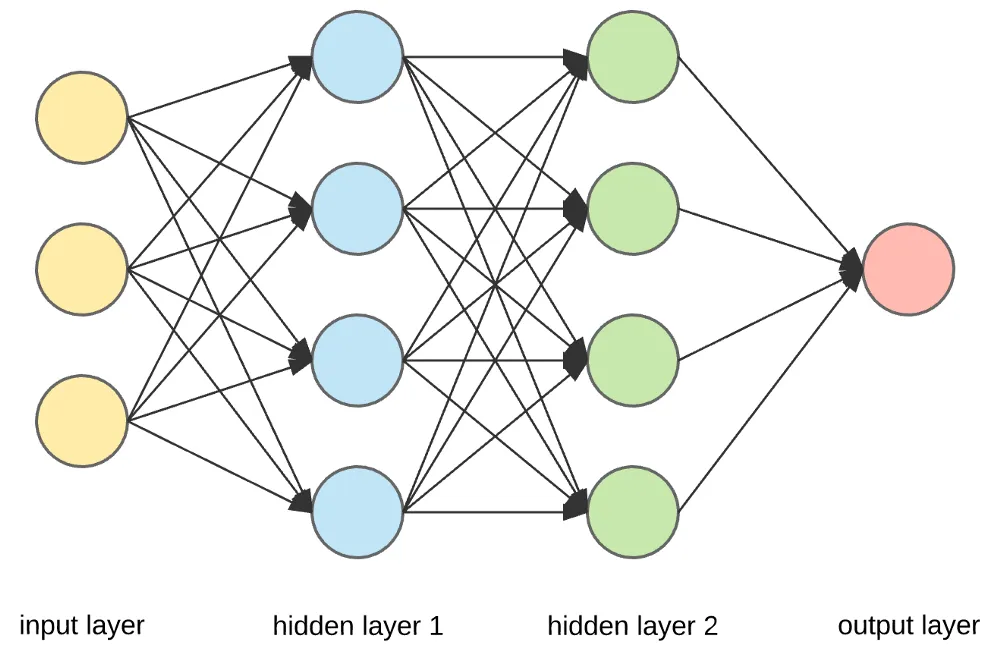
La red totalmente conectada es la arquitectura más directa en el aprendizaje profundo; como su nombre indica, cada capacada neuronaestá conectada concada neuronade la capa adyacente.

Podemos imaginarla como una red de procesamiento de información extremadamente densa: los datos entran por la capa de entrada, pasan por transformaciones en múltiples capas ocultas y, finalmente, se obtiene el resultado en la capa de salida.
Aplicaciones típicas y limitaciones
Aplicaciones: Gracias a su potente capacidad de ajuste, la FCN es muy adecuada para procesar datos estructurados (por ejemplo, datos tabulares como el área, la ubicación, el número de habitaciones en la predicción del precio de la vivienda).
Ejemplo
import torch.nn as nn
class SimpleFCN(nn.Module):
def __init__(self, input_size, num_classes):
super(SimpleFCN, self).__init__()
# Definir las capas de la red
self.fc1 = nn.Linear(input_size, 128) # Primera capa oculta
self.relu = nn.ReLU() # Función de activación
self.fc2 = nn.Linear(128, 64) # Segunda capa oculta
self.fc3 = nn.Linear(64, num_classes) # Capa de salida
def forward(self, x):
x = self.fc1(x)
x = self.relu(x)
x = self.fc2(x)
x = self.relu(x)
x = self.fc3(x)
return x
# Suponiendo que la entrada es un vector de características de 100 dimensiones, clasificación en 10 categorías
model = SimpleFCN(input_size=100, num_classes=10)
Limitaciones: Cuando se procesan datos en forma de cuadrícula como imágenes o voz, la FCN enfrenta enormes desafíos. Esto se debe a que los píxeles en una imagen están altamente correlacionados espacialmente, pero la FCN ignora esta estructura espacial, aplana la imagen en un vector unidimensional para procesarla, lo que provoca una explosión en la cantidad de parámetros y dificulta el aprendizaje de características espaciales efectivas.
Redes neuronales convolucionales: la piedra angular de la visión por computadora
Para resolver los problemas del procesamiento de imágenes,la red neuronal convolucionalsurgió en el momento adecuado, revolucionando por completo el campo de la visión por computadora.
Idea central: percepción local y uso compartido de parámetros
El diseño de las CNN se inspira en la corteza visual biológica, y sus dos ideas centrales son:
- Percepción local: A diferencia de la FCN, donde las neuronas se conectan a toda la imagen, cada neurona de la CNN solo percibeuna pequeña región local(como un bloque de píxeles de 3x3 o 5x5). Esto es más coherente con la característica de que los píxeles adyacentes en una imagen tienen una mayor correlación.
- Uso compartido de parámetros: Se utiliza el mismonúcleo de convolución(o filtro) para escanear deslizándose por diferentes posiciones de la imagen y extraer el mismo tipo de características (como bordes, texturas). Esto reduce enormemente los parámetros de la red.

Componentes principales y aplicaciones típicas
Una CNN típica se compone apilando los siguientes componentes:
- Capa convolucional: Usa núcleos de convolución para extraer características.
- Capa de agrupación(como max pooling): reduce la resolución del mapa de características, disminuye la cantidad de datos y mejora la invarianza de características.
- Capa totalmente conectada: Al final de la red, mapea las características distribuidas aprendidas al espacio de etiquetas de las muestras.
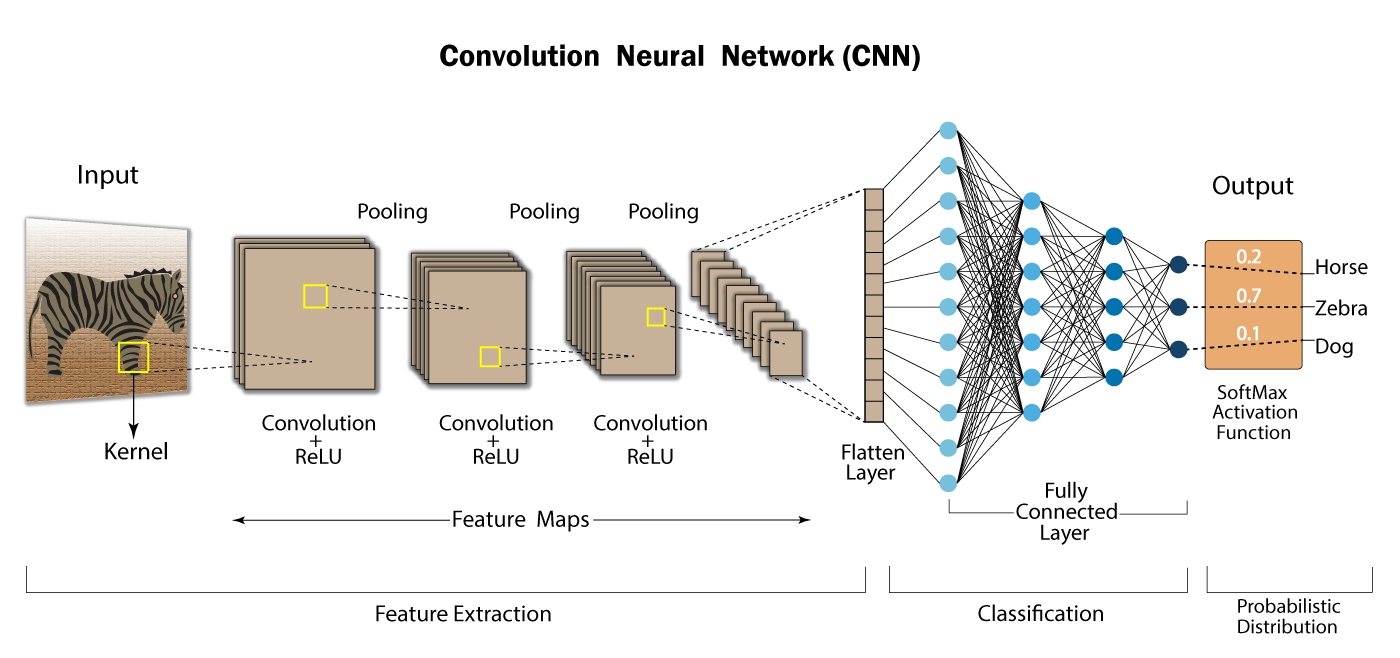
Aplicaciones: Clasificación de imágenes, detección de objetos, reconocimiento facial y casi todas las tareas de visión por computadora.
Ejemplo
class SimpleCNN(nn.Module):
def __init__(self, num_classes=10):
super(SimpleCNN, self).__init__()
self.conv1 = nn.Conv2d(in_channels=3, out_channels=16, kernel_size=3, padding=1)
self.pool = nn.MaxPool2d(kernel_size=2, stride=2)
self.conv2 = nn.Conv2d(16, 32, 3, padding=1)
self.fc1 = nn.Linear(32 * 8 * 8, 256) # Suponiendo que después de dos operaciones de agrupación el mapa de características es de 8x8
self.fc2 = nn.Linear(256, num_classes)
def forward(self, x):
x = self.pool(nn.functional.relu(self.conv1(x))) # Convolución -> Activación -> Agrupación
x = self.pool(nn.functional.relu(self.conv2(x)))
x = x.view(-1, 32 * 8 * 8) # Aplana el mapa de características en un vector unidimensional
x = nn.functional.relu(self.fc1(x))
x = self.fc2(x)
return x
Redes neuronales recurrentes: expertas en procesar datos secuenciales
Para datos como lenguaje, voz o series temporales, que tienendependencias de orden secuencial, necesitamos una red que pueda recordar información histórica, y esa es lared neuronal recurrente。
Idea central: introducir un mecanismo de memoria
El núcleo de la RNN reside en su estructura recurrente. Al procesar la entrada actual, la red combina la entrada actual conel estado oculto del momento anterior, para determinar conjuntamente la salida actual y el estado oculto que se transmitirá al siguiente momento. Es como cuando lees una oración: para comprender el significado de la palabra actual, necesitas apoyarte en las palabras leídas anteriormente.

Variantes y aplicaciones típicas
La RNN básica tiene el problema de las dependencias a largo plazo, lo que dificulta aprender información en secuencias largas. Por ello, surgieron dos variantes importantes:
- Red de memoria a largo plazo: Mediante un ingenioso mecanismo de compuertas (compuerta de entrada, compuerta de olvido, compuerta de salida), recuerda selectivamente información importante y olvida información inútil, resolviendo eficazmente el problema de las dependencias en secuencias largas.
- Unidad recurrente con compuertas: Una versión simplificada de LSTM, con una estructura más concisa y mayor eficiencia computacional, con un rendimiento comparable en muchas tareas.
Aplicaciones: Traducción automática, generación de texto, reconocimiento de voz, predicción del precio de acciones.
Ejemplo
class SimpleRNN(nn.Module):
def __init__(self, vocab_size, embed_size, hidden_size, num_classes):
super(SimpleRNN, self).__init__()
self.embedding = nn.Embedding(vocab_size, embed_size) # Capa de incrustación de palabras
self.rnn = nn.RNN(input_size=embed_size, hidden_size=hidden_size, batch_first=True)
self.fc = nn.Linear(hidden_size, num_classes)
def forward(self, x):
# Forma de x: (batch_size, sequence_length)
x = self.embedding(x) # Después de la incrustación: (batch_size, seq_len, embed_size)
_, h_n = self.rnn(x) # h_n es el estado oculto del último paso de tiempo
out = self.fc(h_n.squeeze(0)) # Usar el último estado para la clasificación
return out
Redes generativas adversarias: del aprendizaje a la creación
Si los tipos de red anteriores son modelos discriminativos (aprenden a distinguir datos), entonces lared generativa adversariaes un representante destacado de los modelos generativos (aprenden a crear datos).

Idea central: evolucionar en el juego
La inspiración de las GAN proviene de la teoría de juegos. Se compone de dos redes que se enfrentan entre sí:
- Generador: Como un falsificador, su objetivo es aprender la distribución de los datos reales y generar nuevos datos lo suficientemente realistas como para engañar.
- Discriminador: Como un experto tasador, su objetivo es distinguir con precisión si los datos de entrada provienen del conjunto de datos real o del generador.
Ambos mejoran conjuntamente mediante un entrenamiento adversarial continuo: el generador se esfuerza por crear datos más realistas para engañar al discriminador, mientras que el discriminador mejora su capacidad de discernimiento. Finalmente, el generador puede crear datos nuevos de alta calidad.

Aplicaciones típicas
Aplicaciones: Generación de imágenes, superresolución de imágenes, transferencia de estilo, aumento de datos.
Ejemplo
for epoch in range(num_epochs):
# 1. Entrenar al discriminador: maximizar su capacidad para clasificar los datos reales como verdaderos y los datos generados como falsos
real_data = get_real_data()
noise = generate_random_noise()
fake_data = generator(noise).detach() # Nota: usar detach para evitar que el generador se actualice
d_loss_real = criterion(discriminator(real_data), real_labels)
d_loss_fake = criterion(discriminator(fake_data), fake_labels)
d_loss = d_loss_real + d_loss_fake
d_loss.backward()
optimizer_D.step()
# 2. Entrenar al generador: minimizar la capacidad del discriminador para clasificar los datos generados como falsos (es decir, engañar al discriminador)
noise = generate_random_noise()
fake_data = generator(noise)
g_loss = criterion(discriminator(fake_data), real_labels) # Hacer que el discriminador crea que lo generado es real
g_loss.backward()
optimizer_G.step()
Resumen y comparación
| Tipo de red | Idea central | Tipos de datos que maneja bien | Aplicaciones típicas |
|---|---|---|---|
| Red totalmente conectada | Conexión global, ajuste denso | Datos estructurados (tablas) | Predicción de precios de vivienda, puntuación de crédito |
| Red neuronal convolucional | Percepción local, compartición de parámetros | Datos de cuadrícula (imágenes) | Clasificación de imágenes, detección de objetos |
| Red neuronal recurrente | Dependencia temporal, estado de memoria | Datos secuenciales (texto, series temporales) | Traducción automática, reconocimiento de voz |
| Red generativa adversarial | Juego adversarial, generación de datos | Se utiliza para generar datos similares a los datos reales | Generación de imágenes, transferencia de estilo |