Types de réseaux courants
Imaginons que nous apprenions à un enfant à reconnaître des chats et des chiens.
Au début, nous leur montrons de nombreuses images de chats et de chiens et leur disons « ceci est un chat, ceci est un chien ». Peu à peu, le cerveau de l'enfant extrait des motifs de ces images : les chats ont généralement des oreilles pointues et un visage plus rond ; les oreilles des chiens peuvent être tombantes et leur museau plus allongé. Ce processus est essentiellementl'apprentissage de caractéristiquesetet la construction de motifs.。
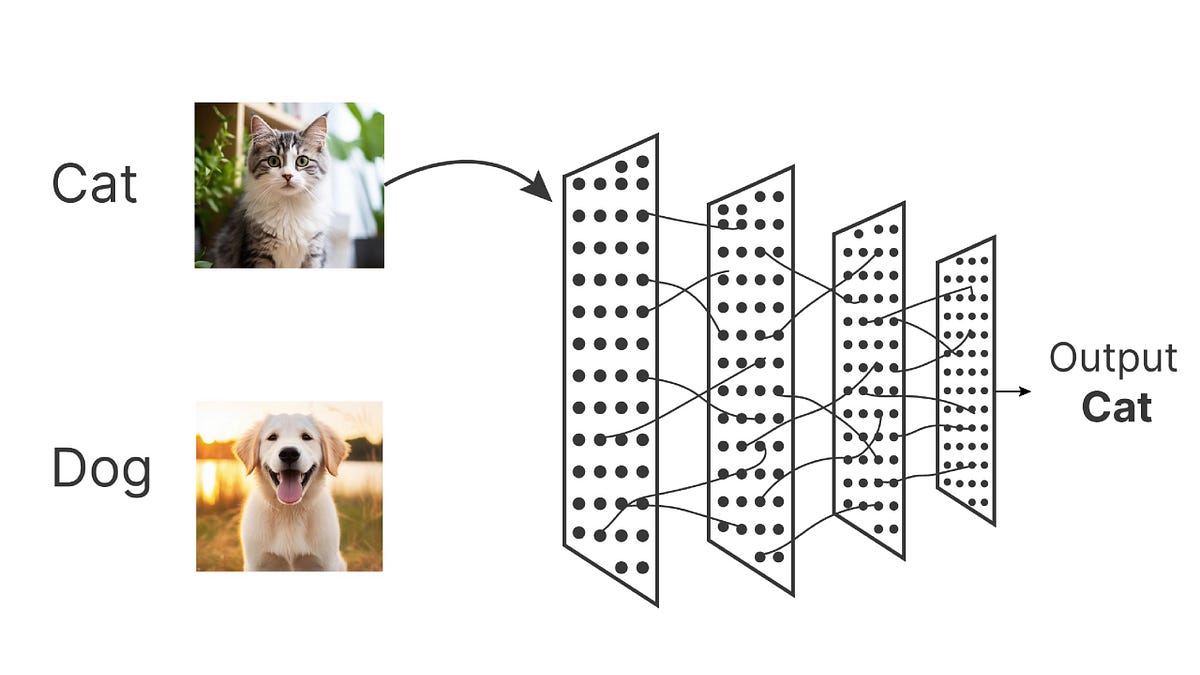
L'apprentissage profond, une branche puissante de l'apprentissage automatique, vise à permettre aux ordinateurs de simuler ce processus. En construisant des réseaux de neurones multicouches, il permet aux machines d'apprendre et d'extraire automatiquement des caractéristiques complexes à partir de données massives, et d'accomplir finalement des tâches avancées telles que la reconnaissance d'images, la compréhension du langage et la prédiction de tendances. Différentes tâches nécessitent des réseaux aux architectures différentes. Cet article vous présentera plusieurs types de réseaux d'apprentissage profond courants et fondamentaux, et vous aidera à comprendre leurs philosophies de conception et leurs applications typiques.
Réseaux d'apprentissage profond
| Nom complet en chinois | Nom complet en anglais | Abréviation |
|---|---|---|
| Réseau de neurones artificiels | Réseau de neurones artificiels | ANN |
| Réseau de neurones convolutif | Réseau de neurones convolutif | CNN |
| Réseau de neurones récurrent | Réseau de neurones récurrent | RNN |
| Réseau de mémoire à long terme et à court terme | Mémoire à long terme et à court terme | LSTM |
| Unité récurrente à portes | Unité récurrente à portes | GRU |
| Réseau antagoniste génératif | Réseau antagoniste génératif | GAN |
| Transformer | Transformer | Transformer |
| Autoencodeur | Autoencodeur | AE |
| Autoencodeur variationnel | Autoencodeur variationnel | VAE |
| Réseau de croyance profonde | Réseau de croyance profonde | DBN |
| Réseau de neurones de graphes | Réseau de neurones de graphes | GNN |
Bases des réseaux de neurones et réseaux entièrement connectés
Avant de plonger dans divers réseaux, nous devons comprendre le modèle le plus élémentaire —réseau entièrement connecté, également appeléperceptron multicouche (MLP)。
Idée clé : Tout peut être connecté
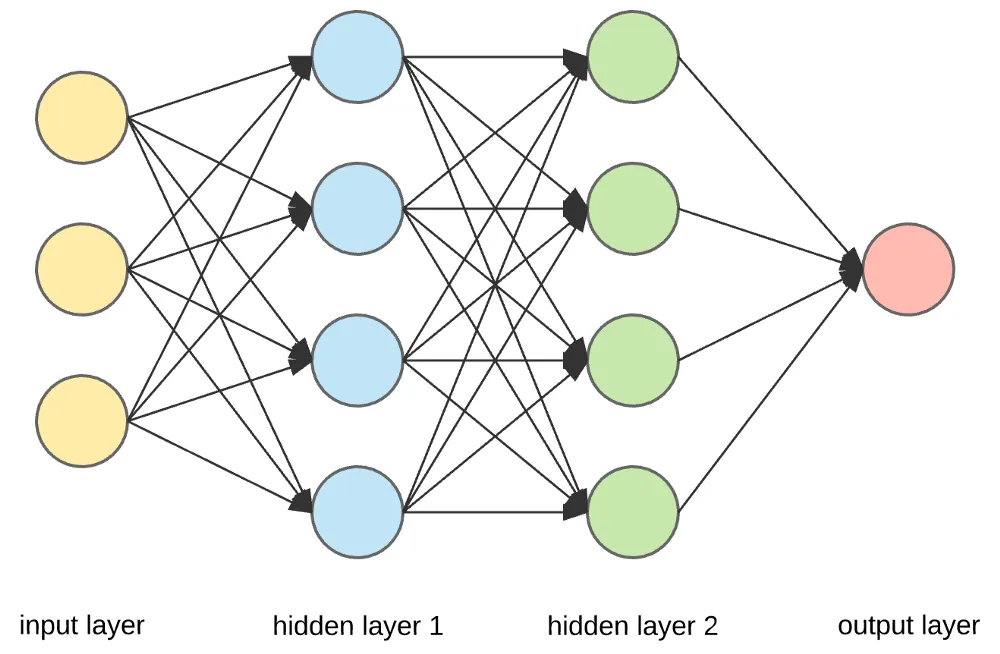
Le réseau entièrement connecté est l'architecture la plus simple en apprentissage profond. Comme son nom l'indique, dans chaque couche,chaque neuroneest connecté àchaque neurone de la couche adjacente.
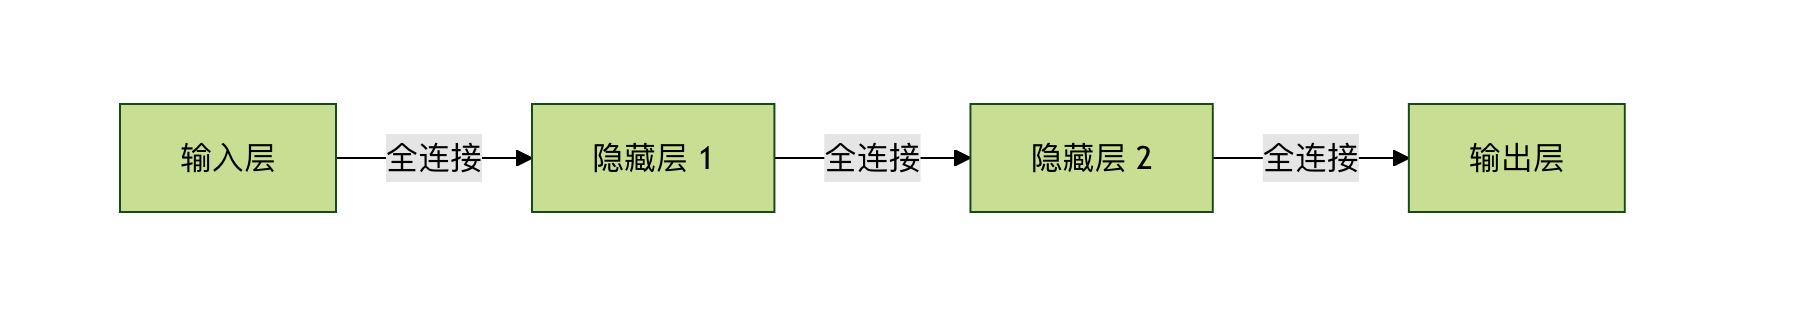
Nous pouvons le considérer comme un réseau de traitement de l'information extrêmement dense. Les données entrent par la couche d'entrée, subissent des transformations à travers plusieurs couches cachées, et produisent finalement des résultats au niveau de la couche de sortie.
Applications typiques et limites
Application: Grâce à sa puissante capacité d'ajustement, FCN est bien adapté aux données structurées (par exemple, des données tabulaires telles que la surface de la maison, l'emplacement et le nombre de pièces dans la prédiction du prix des maisons).
Exemple
import torch.nn as nn
class SimpleFCN(nn.Module):
def __init__(self, input_size, num_classes):
super(SimpleFCN, self).__init__()
# Définir les couches du réseau
self.fc1 = nn.Linear(input_size, 128) # Première couche cachée
self.relu = nn.ReLU() # Fonction d'activation
self.fc2 = nn.Linear(128, 64) # Deuxième couche cachée
self.fc3 = nn.Linear(64, num_classes) # Couche de sortie
def forward(self, x):
x = self.fc1(x)
x = self.relu(x)
x = self.fc2(x)
x = self.relu(x)
x = self.fc3(x)
return x
# Supposons que l'entrée est une caractéristique de dimension 100, pour une classification à 10 classes
model = SimpleFCN(input_size=100, num_classes=10)
Limites: Lorsqu'on traite des données de type grille telles que des images et de la parole, le FCN fait face à des défis significatifs. Parce que les pixels d'une image sont fortement corrélés dans l'espace, le FCN ignore cette structure spatiale et aplatit l'image en un vecteur unidimensionnel pour le traitement, ce qui conduit à une explosion du nombre de paramètres et à une difficulté d'apprentissage de caractéristiques spatiales efficaces.
Réseaux de neurones convolutifs — La pierre angulaire de la vision par ordinateur
Pour résoudre le problème du traitement d'image,les réseaux de neurones convolutifs (CNN)ont vu le jour au moment opportun, transformant complètement le domaine de la vision par ordinateur.
Idée centrale : Perception locale et partage de paramètres
CNN s'inspire du cortex visuel biologique pour sa conception, et ses deux idées centrales sont :
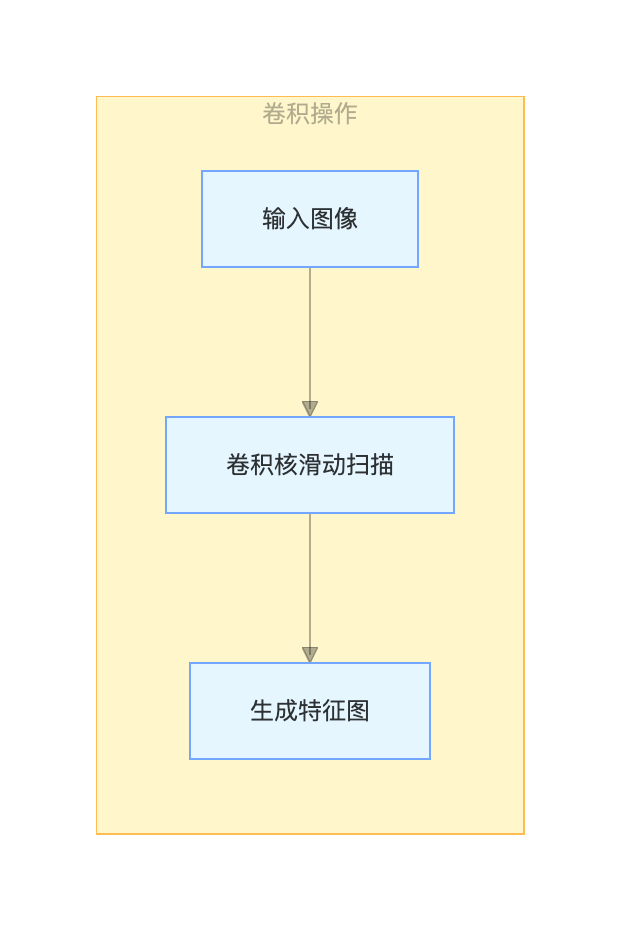
- Perception locale: Contrairement au FCN, où les neurones se connectent à l'image entière, chaque neurone d'un CNN ne perçoit qu'unepetite région locale(par exemple, une parcelle de 3x3 ou 5x5 pixels). Cela correspond mieux à la propriété selon laquelle les pixels adjacents d'une image sont plus fortement corrélés.
- Partage de paramètres: Utiliser le mêmenoyau de convolution(ou filtre) pour glisser et balayer à différentes positions de l'image, en extrayant le même type de caractéristiques (telles que des bords, des textures). Cela réduit considérablement les paramètres du réseau.
Composants principaux et applications typiques
Un CNN typique est empilé à partir des composants suivants :
- Couche de convolution: Utilise des noyaux de convolution pour extraire des caractéristiques.
- Couche de pooling(par exemple, max pooling) : Sous-échantillonne les cartes de caractéristiques, réduisant le volume de données et renforçant l'invariance des caractéristiques.
- Couche entièrement connectée: À la fin du réseau, projette les caractéristiques distribuées apprises vers l'espace des étiquettes d'échantillons.
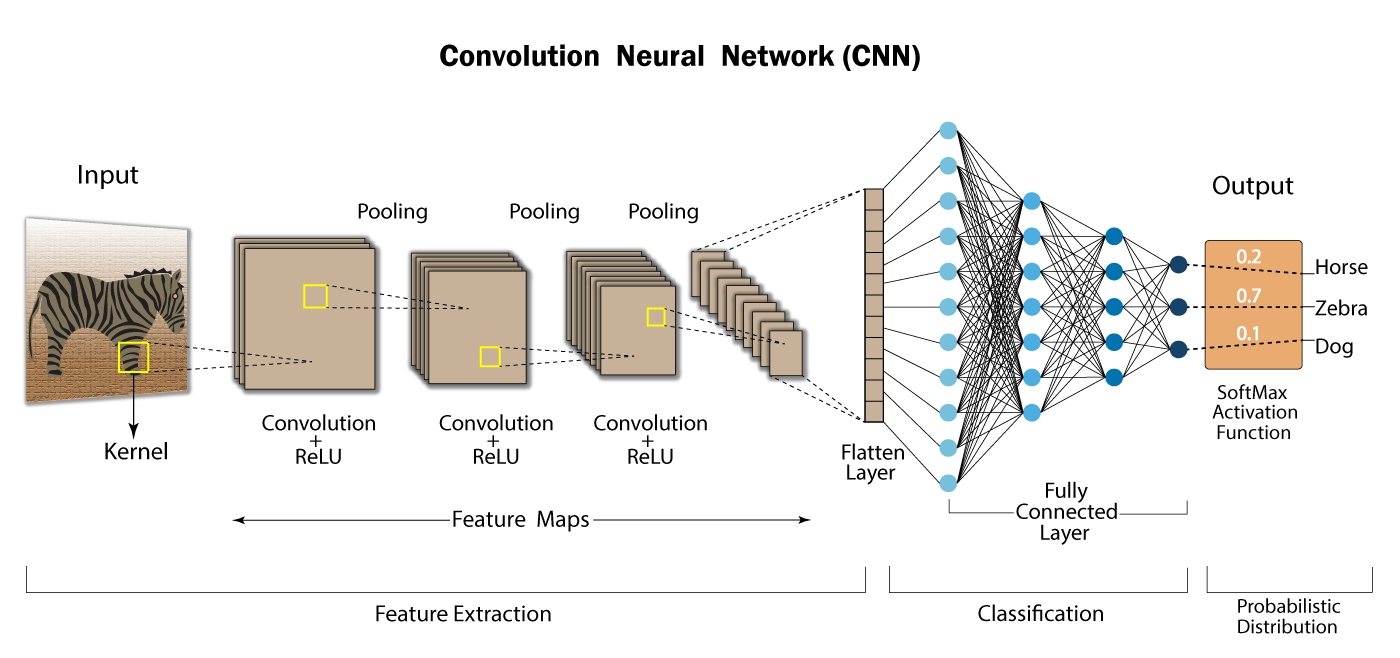
Application: Presque toutes les tâches de vision par ordinateur telles que la classification d'images, la détection d'objets et la reconnaissance faciale.
Exemple
class SimpleCNN(nn.Module):
def __init__(self, num_classes=10):
super(SimpleCNN, self).__init__()
self.conv1 = nn.Conv2d(in_channels=3, out_channels=16, kernel_size=3, padding=1)
self.pool = nn.MaxPool2d(kernel_size=2, stride=2)
self.conv2 = nn.Conv2d(16, 32, 3, padding=1)
self.fc1 = nn.Linear(32 * 8 * 8, 256) # Supposons que la taille de la carte de caractéristiques soit 8x8 après deux opérations de pooling
self.fc2 = nn.Linear(256, num_classes)
def forward(self, x):
x = self.pool(nn.functional.relu(self.conv1(x))) # Convolution -> Activation -> Pooling
x = self.pool(nn.functional.relu(self.conv2(x)))
x = x.view(-1, 32 * 8 * 8) # Aplatir la carte de caractéristiques en un vecteur unidimensionnel
x = nn.functional.relu(self.fc1(x))
x = self.fc2(x)
return x
Réseaux de neurones récurrents — Experts du traitement des données séquentielles
Pour des données telles que le langage, la parole et les séries temporelles qui ontdes relations de dépendance séquentielle, nous avons besoin d’un réseau capable de mémoriser des informations historiques. C’est leréseau de neurones récurrent (RNN)。
Idée centrale : introduire un mécanisme de mémoire
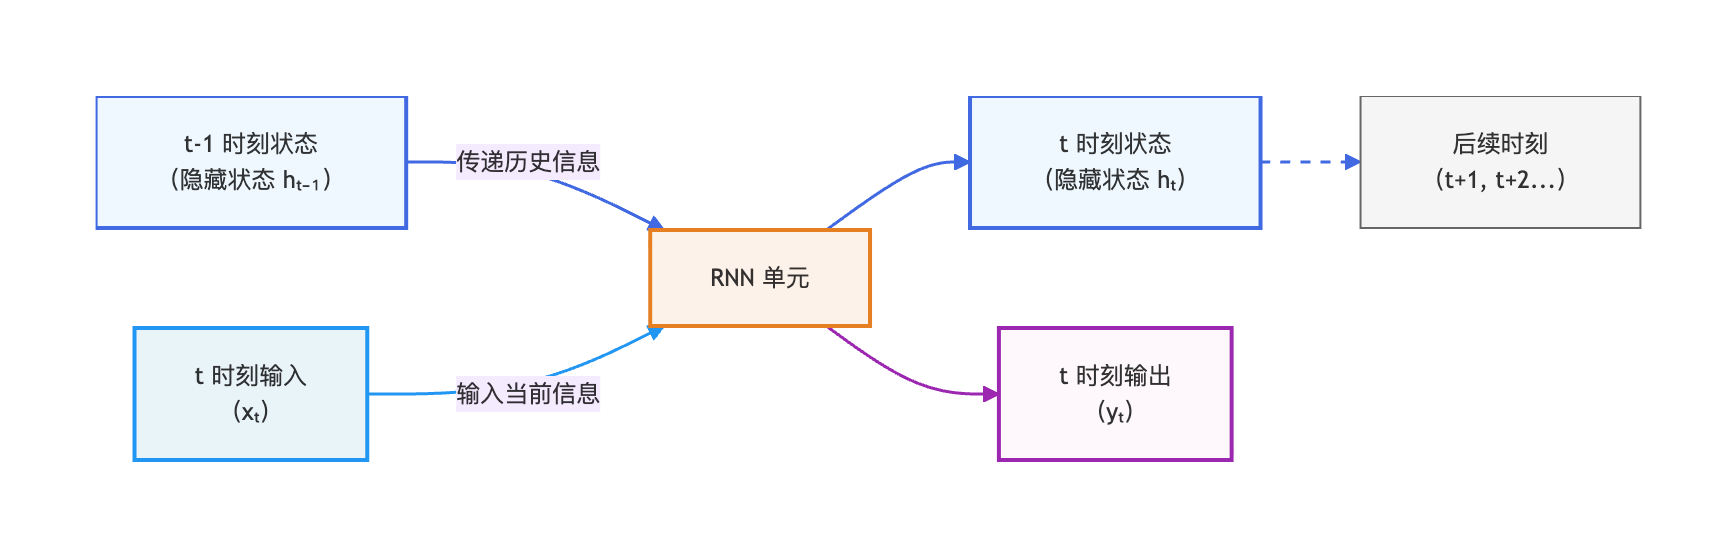
Le cœur des RNN réside dans leur structure récurrente. Lors du traitement de l’entrée actuelle, le réseau combine l’entrée actuelle avec l’état caché de l’étape temporelle précédentepour déterminer conjointement la sortie actuelle et l’état caché transmis à l’étape temporelle suivante. C’est comme lire une phrase : comprendre le mot actuel nécessite de s’appuyer sur les mots lus précédemment.
Variantes et applications typiques
Le RNN de base souffre du problème de dépendance à long terme, ce qui rend difficile l’apprentissage d’informations dans de longues séquences. Cela a conduit à deux variantes importantes :
- Réseau de mémoire à long et court terme (LSTM): Grâce à un mécanisme de portes élaboré (porte d’entrée, porte d’oubli, porte de sortie), il mémorise sélectivement les informations importantes et oublie les informations inutiles, résolvant efficacement le problème de dépendance sur de longues séquences.
- Unité récurrente à portes (GRU): Une version simplifiée du LSTM avec une structure plus concise et une efficacité de calcul supérieure, offrant des performances comparables sur de nombreuses tâches.
Application: Traduction automatique, génération de texte, reconnaissance vocale, prédiction des cours boursiers.
Exemple
class SimpleRNN(nn.Module):
def __init__(self, vocab_size, embed_size, hidden_size, num_classes):
super(SimpleRNN, self).__init__()
self.embedding = nn.Embedding(vocab_size, embed_size) # Couche de plongement de mots
self.rnn = nn.RNN(input_size=embed_size, hidden_size=hidden_size, batch_first=True)
self.fc = nn.Linear(hidden_size, num_classes)
def forward(self, x):
# Forme de x : (batch_size, sequence_length)
x = self.embedding(x) # Après embedding : (batch_size, seq_len, embed_size)
_, h_n = self.rnn(x) # h_n est l'état caché du dernier pas de temps
out = self.fc(h_n.squeeze(0)) # Utiliser l'état final pour la classification
return out
Réseaux antagonistes génératifs — De l'apprentissage à la création
Si les réseaux précédents sont des modèles discriminatifs (apprentissage à distinguer les données), alorsle réseau antagoniste génératif (GAN)est un représentant éminent des modèles génératifs (apprentissage à créer des données).

Idée centrale : L'évolution par des jeux antagonistes
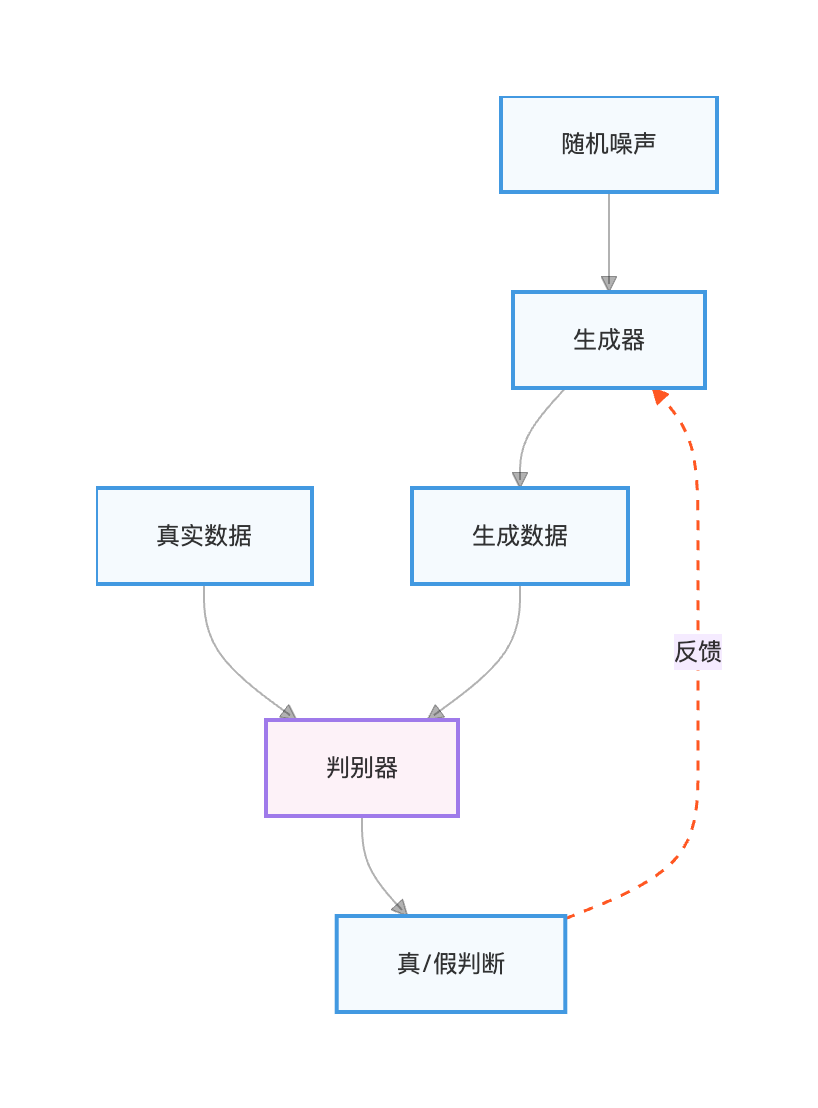
Le GAN s'inspire de la théorie des jeux. Il se compose de deux réseaux antagonistes :
- Générateur: Comme un faussaire, son objectif est d'apprendre la distribution des données réelles et de générer de nouvelles données suffisamment réalistes pour passer pour authentiques.
- Discriminateur: Comme un expert en authentification, son objectif est de distinguer avec précision si les données d'entrée proviennent du jeu de données réel ou du générateur.
Les deux s'améliorent ensemble grâce à un entraînement antagoniste continu : le générateur s'efforce de créer des données plus réalistes pour tromper le discriminateur, tandis que le discriminateur travaille à améliorer sa capacité de distinction. Finalement, le générateur peut produire de nouvelles données de haute qualité.
Applications typiques
Application: Génération d'images, super-résolution d'images, transfert de style, augmentation de données.
Exemple
for epoch in range(num_epochs):
# 1. Entraîner le discriminateur : maximiser sa capacité à classer les données réelles comme réelles et les données générées comme fausses
real_data = get_real_data()
noise = generate_random_noise()
fake_data = generator(noise).detach() # Remarque : le detach empêche le générateur d'être mis à jour
d_loss_real = criterion(discriminator(real_data), real_labels)
d_loss_fake = criterion(discriminator(fake_data), fake_labels)
d_loss = d_loss_real + d_loss_fake
d_loss.backward()
optimizer_D.step()
# 2. Entraîner le générateur : minimiser la capacité du discriminateur à classer les données générées comme fausses (c'est-à-dire tromper le discriminateur)
noise = generate_random_noise()
fake_data = generator(noise)
g_loss = criterion(discriminator(fake_data), real_labels) # Faire croire au discriminateur que les données générées sont réelles
g_loss.backward()
optimizer_G.step()
Résumé et comparaison
| Type de réseau | Idée centrale | Types de données qu'il excelle à traiter | Applications typiques |
|---|---|---|---|
| Réseau entièrement connecté | Connexion globale, ajustement dense | Données structurées (tableaux) | Prédiction des prix immobiliers, scoring de crédit |
| Réseau de neurones convolutif | Perception locale, partage de paramètres | Données en grille (images) | Classification d'images, détection d'objets |
| Réseau de neurones récurrent | Dépendance temporelle, état de mémoire | Données séquentielles (texte, séries temporelles) | Traduction automatique, reconnaissance vocale |
| Réseau antagoniste génératif | Jeu adversarial, génération de données | Utilisé pour générer des données similaires à des données réelles | Génération d'images, transfert de style |