Tutoriel d'apprentissage automatique
L'apprentissage automatique est une branche de l'intelligence artificielle (IA) qui permet aux systèmes informatiques d'apprendre automatiquement et d'améliorer leurs performances à l'aide de données et d'algorithmes.
L'apprentissage automatique permet aux machines de prendre des décisions et de faire des prédictions grâce à l'expérience (données).
L'apprentissage automatique a été largement appliqué dans de nombreux domaines, notamment les systèmes de recommandation, la reconnaissance d'images, la reconnaissance vocale, l'analyse financière, etc.
Par exemple, grâce à l'apprentissage automatique, les voitures peuvent apprendre à reconnaître les panneaux de signalisation, les piétons et les obstacles pour parvenir à la conduite autonome.
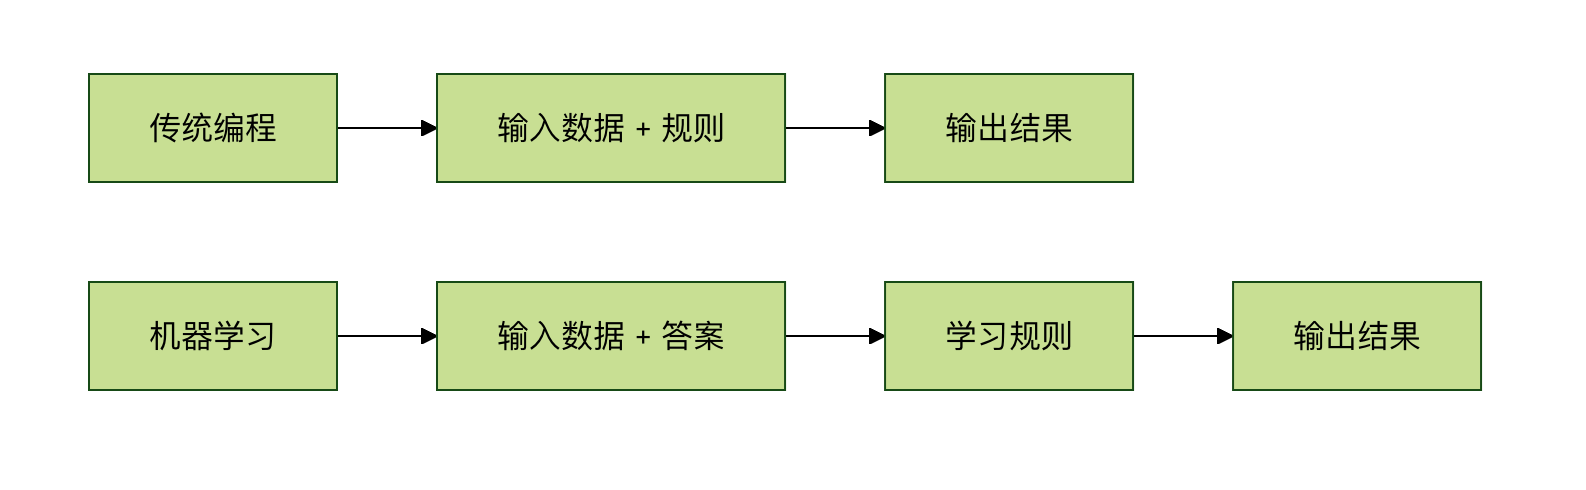
Différences entre l'apprentissage automatique et la programmation traditionnelle
| Programmation traditionnelle | Apprentissage automatique |
|---|---|
| Les programmeurs écrivent des règles explicites | Les ordinateurs apprennent les règles à partir des données |
| Convient aux situations où les problèmes sont bien définis et les règles sont claires | Adapté aux situations complexes où les règles sont difficiles à définir |
| Exemple : écrire un programme de calculatrice | Exemple : écrire un programme de reconnaissance des courriels indésirables |
Trois éléments essentiels de l'apprentissage automatique
L'apprentissage automatique se compose de trois éléments de base :
1. Données
Les données sont le carburant de l'apprentissage automatique. Plus la qualité est élevée et plus la quantité de données est grande, mieux le modèle peut généralement apprendre.
- Données d'entraînement: données utilisées pour enseigner le modèle
- Données de test: Données utilisées pour évaluer l'efficacité de l'apprentissage du modèle
- Données du monde réel: Nouvelles données que le modèle rencontre dans des applications du monde réel
2. Algorithme
Les algorithmes sont les méthodes d'apprentissage de l'apprentissage automatique ; différents algorithmes conviennent à différents types de problèmes.
- Apprentissage supervisé: apprentissage avec des réponses étiquetées
- Apprentissage non supervisé: Pas de réponses étiquetées ; trouver des motifs par lui-même
- Apprentissage par renforcement: apprentissage par essais et erreurs et récompenses
3. Modèle
Le modèle est le résultat de l'apprentissage, tout comme les connaissances qu'un étudiant acquiert.
- Processus d'entraînement: L'algorithme apprend des motifs à partir des données
- Processus d'inférence: Utiliser les motifs appris pour faire des prédictions
Exemple
Ensuite, nous utiliserons un exemple simple pour comprendre le flux de travail de base de l'apprentissage automatique.
Nous utiliserons Python pour créer un modèle simple de régression linéaire afin de prédire les prix des maisons.
Exemple
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
import seaborn as sns
# Définir le style du graphique pour le rendre plus esthétique
sns.set_style("whitegrid")
# -------------------------- Début de configuration de la police chinoise --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows en premier
'SimHei', 'Microsoft YaHei',
# macOS en premier
'PingFang SC', 'Heiti TC',
# Linux d'abord
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corriger le problème d'affichage des signes négatifs sous forme de carrés
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de la configuration de la police chinoise --------------------------
# 1. Préparer les données
# Supposons que nous ayons des données sur la surface des maisons et les prix correspondants
# Surface de la maison (mètres carrés)
house_sizes = np.array([50, 60, 70, 80, 90, 100, 110, 120]).reshape(-1, 1)
# Prix de la maison (dix mille yuan)
house_prices = np.array([150, 180, 210, 240, 270, 300, 330, 360])
# 2. Créer et entraîner le modèle
# Créer un modèle de régression linéaire
model = LinearRegression()
# Entraîner le modèle avec les données (apprendre la relation entre la surface et le prix)
model.fit(house_sizes, house_prices)
# 3. Utiliser le modèle pour faire des prédictions
# Prédire le prix d'une maison de 85 mètres carrés
predicted_price = model.predict([[85]])
print(f"Prix prédit pour une maison de 85 mètres carrés : {predicted_price)
# 4. Visualiser les résultats
plt.scatter(house_sizes, house_prices, color='blue', label='Données réelles')
plt.plot(house_sizes, model.predict(house_sizes), color='red', label='Ligne de prédiction')
plt.scatter([85], predicted_price, color='green', s=100, label='Point de prédiction')
plt.xlabel('Superficie de la maison (mètres carrés)')
plt.ylabel('Prix de la maison (dix mille yuans)')
plt.title('EXEMPLE Test d'apprentissage automatique -- Relation entre la superficie et le prix de la maison')
plt.legend()
plt.grid(True)
plt.show()
Résultat de l'exécution:
85 平方米的房屋预测价格:255.00 万元
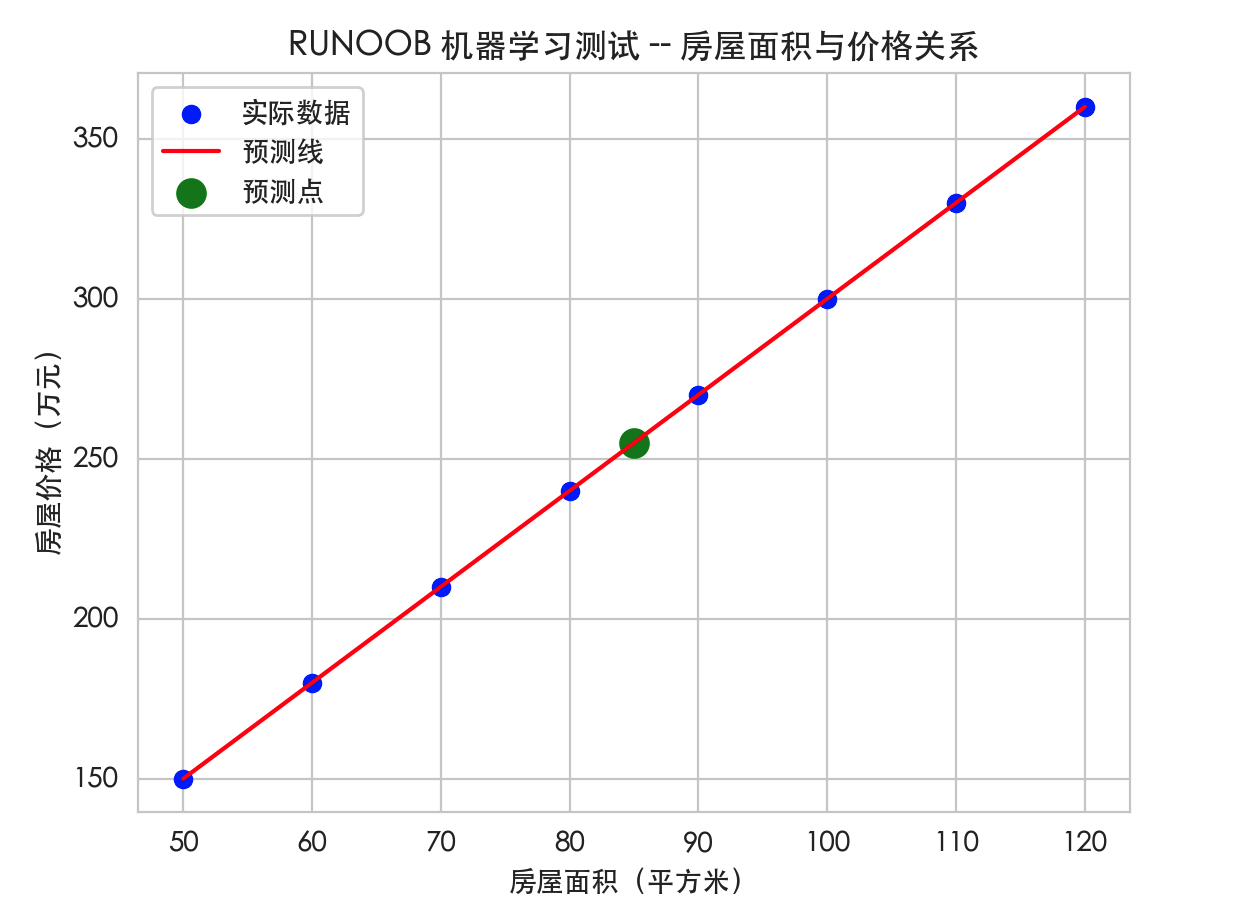
Cet exemple illustre le flux de travail de base de l'apprentissage automatique :
- Préparer les données (superficie et prix de la maison)
- Choisir un algorithme (régression linéaire)
- Entraîner le modèle (laisser l'ordinateur apprendre la relation entre la superficie et le prix)
- Utiliser le modèle pour prédire (prédire le prix d'une nouvelle superficie)
Le graphique de sortie est le suivant :