機械学習チュートリアル
機械学習(Machine Learning)は人工知能(AI)の一分野であり、コンピュータシステムがデータとアルゴリズムを利用して自動的に学習し、その性能を向上させることを可能にします。
機械学習は、機械が経験(データ)を通じて意思決定や予測を行うようにするものです。
機械学習は、レコメンドシステム、画像認識、音声認識、金融分析など、多くの分野で広く応用されています。
例えば、機械学習によって、自動車は交通標識や歩行者、障害物を認識する方法を学習し、自動運転を実現できます。
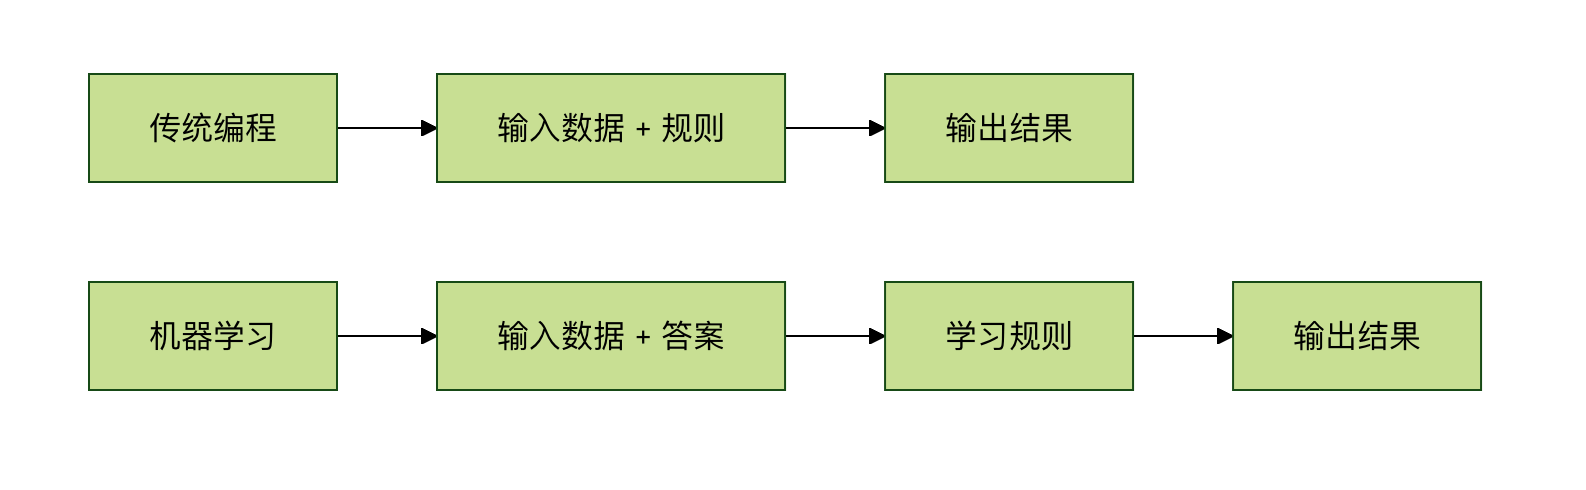
機械学習と従来のプログラミングの違い
| 従来のプログラミング | 機械学習 |
|---|---|
| プログラマーが明確なルールを書く | コンピュータがデータからルールを学習する |
| 問題が明確でルールがはっきりしている場合に適する | 複雑でルールを明確にしにくい場合に適する |
| 例:電卓プログラムを作成する | 例:スパムメールを識別するプログラムを作成する |
機械学習の三大要素
機械学習には3つの基本要素があります:
1. データ
データは機械学習の燃料です。品質が高く、量が多いデータほど、通常モデルはより良く学習できます。
- トレーニングデータ:モデルに教えるためのデータ
- テストデータ:モデルの学習効果を検証するためのデータ
- 実データ:モデルが実際の応用で遭遇する新しいデータ
2. アルゴリズム
アルゴリズムは機械学習の学習方法であり、異なるアルゴリズムは異なるタイプの問題に適しています。
- 教師あり学習:正解のある学習
- 教師なし学習:正解がなく、自分で規則性を見つける
- 強化学習:試行錯誤と報酬によって学習する
3. モデル
モデルは学習の結果であり、学生が学んだ知識のようなものです。
- トレーニング(学習)プロセス:アルゴリズムがデータから規則性を学習する
- 推論プロセス:学習した規則性を使って予測する
例
次に、簡単な例を通して機械学習の基本的な流れを理解しましょう。
Python を使用して簡単な線形回帰モデルを作成し、住宅価格を予測します。
例
# 必要なライブラリをインポートする
import numpy as np
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
import seaborn as sns
# グラフのスタイルを設定して、グラフを見やすくする
sns.set_style("whitegrid")
# -------------------------- 中国語フォントの設定 start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows 優先
'SimHei', 'Microsoft YaHei',
# macOS 優先
'PingFang SC', 'Heiti TC',
# Linux 優先
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# マイナス記号が四角く表示される問題を修正する
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- 中国語フォントの設定 end --------------------------
# 1. データの準備
# 住宅面積と対応する価格データがあると仮定する
# 住宅面積(平方メートル)
house_sizes = np.array([50, 60, 70, 80, 90, 100, 110, 120]).reshape(-1, 1)
# 住宅価格(万元)
house_prices = np.array([150, 180, 210, 240, 270, 300, 330, 360])
# 2. モデルの作成とトレーニング
# 線形回帰モデルを作成する
model = LinearRegression()
# データでモデルをトレーニングする(面積と価格の関係を学習する)
model.fit(house_sizes, house_prices)
# 3. モデルを使って予測する
# 85平方メートルの住宅価格を予測する
predicted_price = model.predict([[85]])
print(f"85平方メートルの住宅の予測価格:{predicted_price)
# 4. 結果の可視化
plt.scatter(house_sizes, house_prices, color='blue', label='実データ')
plt.plot(house_sizes, model.predict(house_sizes), color='red', label='予測線')
plt.scatter([85], predicted_price, color='green', s=100, label='予測点')
plt.xlabel('住宅面積(平方メートル)')
plt.ylabel('住宅価格(万元)')
plt.title('サンプル 機械学習テスト -- 住宅面積と価格の関係')
plt.legend()
plt.grid(True)
plt.show()
実行結果:
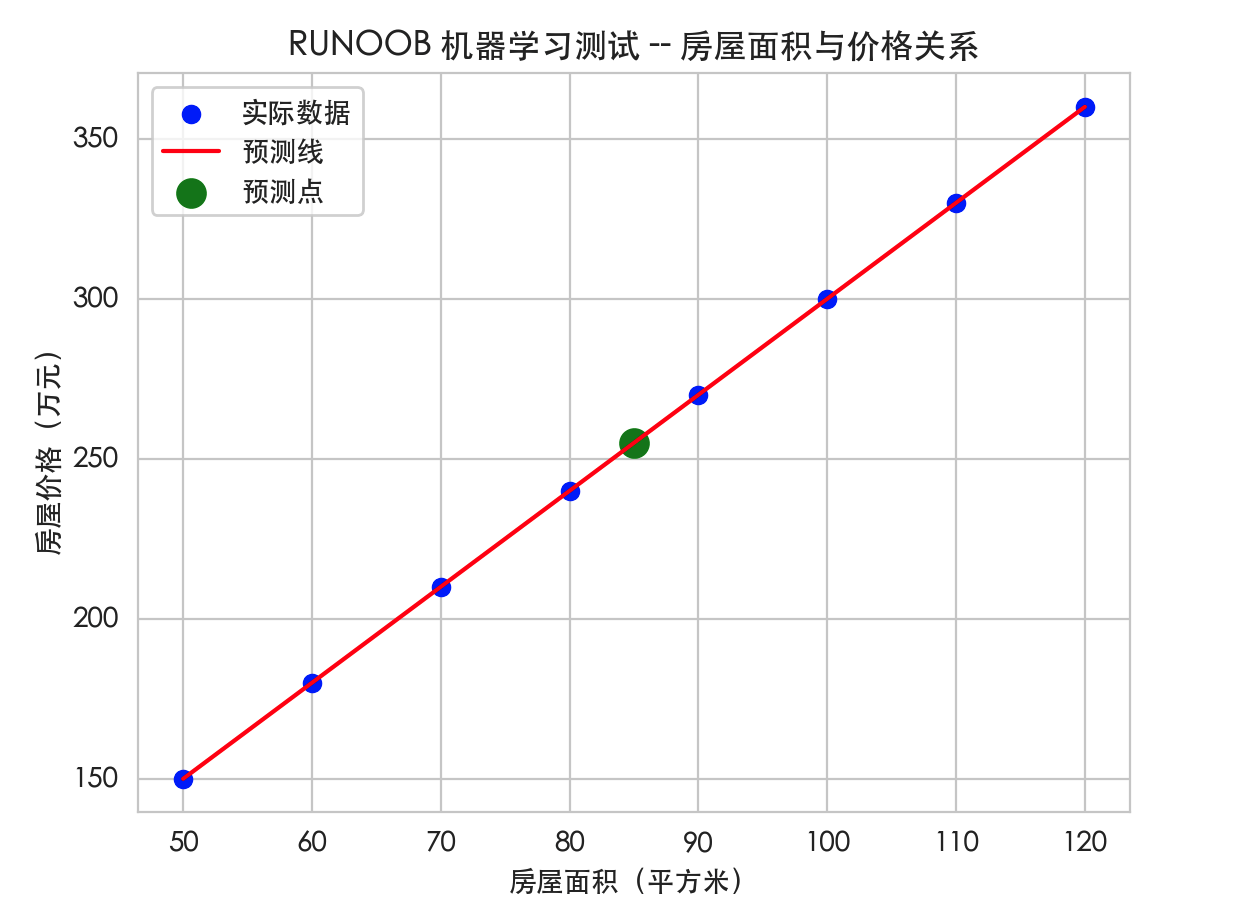
85 平方米的房屋预测价格:255.00 万元
この例は機械学習の基本的な流れを示しています:
- データの準備(住宅面積と価格)
- アルゴリズムの選択(線形回帰)
- モデルのトレーニング(コンピュータに面積と価格の関係を学習させる)
- モデルを使った予測(新しい面積の価格を予測する)
出力された図は以下の通りです: