Обучение с подкреплением: Q-learning и SARSA
В области искусственного интеллекта обучение с подкреплением — это метод, позволяющий агенту научиться достигать целей путём взаимодействия с окружающей средой.
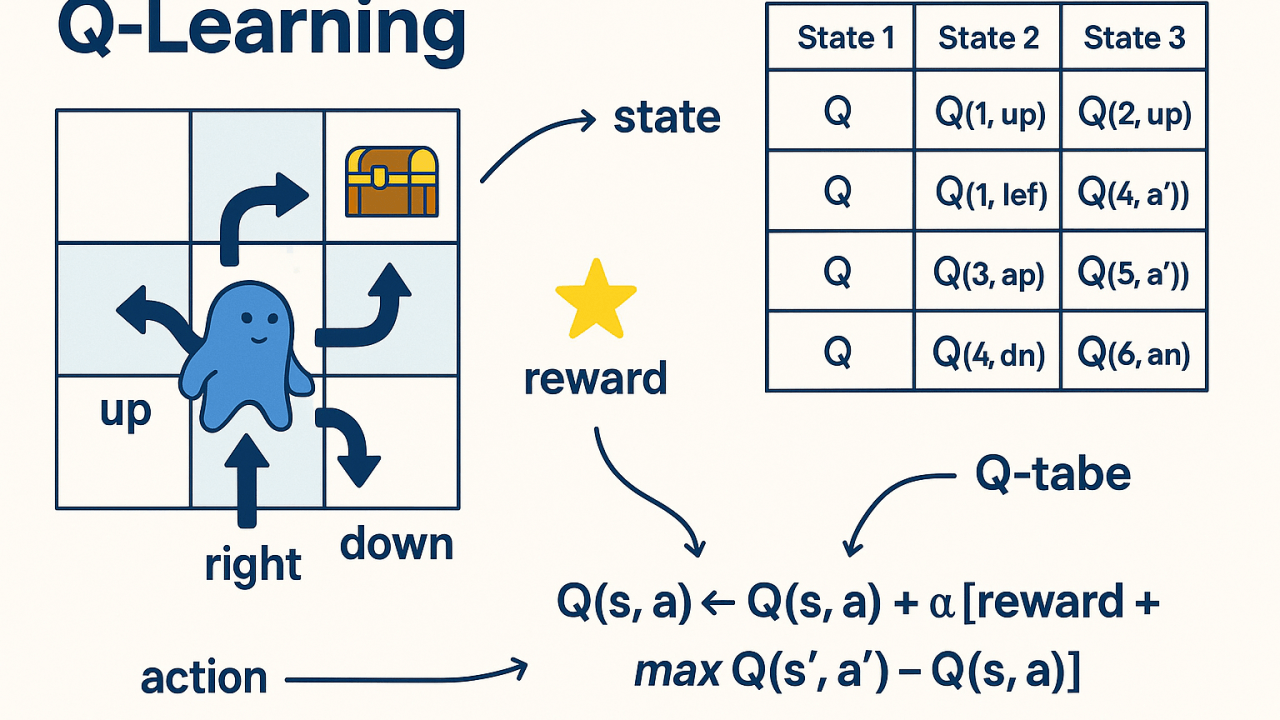
Представьте, что вы учите щенка новой команде: когда он выполняет действие (например, садится), вы даёте ему награду (лакомство), и он постепенно учится правильно реагировать, когда слышит команду. Q-learning и SARSA — два классических и важнейших алгоритма в обучении с подкреплением; они являются основными инструментами, позволяющими агенту научитьсякакое действие лучше в каком состоянииосновные инструменты.
Основы обучения с подкреплением и марковского процесса принятия решений
Прежде чем углубляться в Q-learning и SARSA, нам нужно понять общую теоретическую основу, которую они разделяют.
Основные концепции
Задачи обучения с подкреплением обычно моделируются какмарковский процесс принятия решений. Он содержит следующие ключевые элементы:
- Агент: сущность, которая принимает решения и учится.
- Среда: внешний мир, с которым взаимодействует агент.
- Состояние: описание среды в определённый момент.
- Действие: операция, которую агент может выполнить в заданном состоянии.
- Награда: Немедленный сигнал вознаграждения, возвращаемый средой после выполнения агентом действия.
- Политика: Правило, по которому агент выбирает действия в заданном состоянии; это цель обучения.
Цели и функции ценности
Конечная цель агента — максимизировать долгосрочное суммарное вознаграждение, а не только немедленное вознаграждение. Для этого мы вводимфункции ценности.。
- Функция ценности состояния V(s): Представляет, начиная с состояния
s, ожидаемое суммарное вознаграждение, которое можно получить, следуя определённой политике. - Функция ценности действия Q(s, a): Представляет, находясь в состоянии
sвыполнения действияa, а затем следования определённой политике, ожидаемое суммарное вознаграждение, которое можно получить.Суть Q-learning и SARSA — изучить эту Q-функцию.
Чтобы сбалансировать немедленные и будущие вознаграждения, мы используемкоэффициент дисконтирования γ(обычно в диапазоне [0, 1]). Вознаграждение на будущем шаге k умножается на γ^k, что означает, что агент придаёт большее значение ближайшим вознаграждениям.
Q-learning: off-policy обучение с временными разностями
Q-learning — этоoff-policyалгоритм, предложенный Уоткинсом в 1989 году. Его основная идея состоит в том, что агент косвенно находит оптимальную политику, изучая оптимальную таблицу Q-значений.
Ядро алгоритма: формула обновления Q-значения
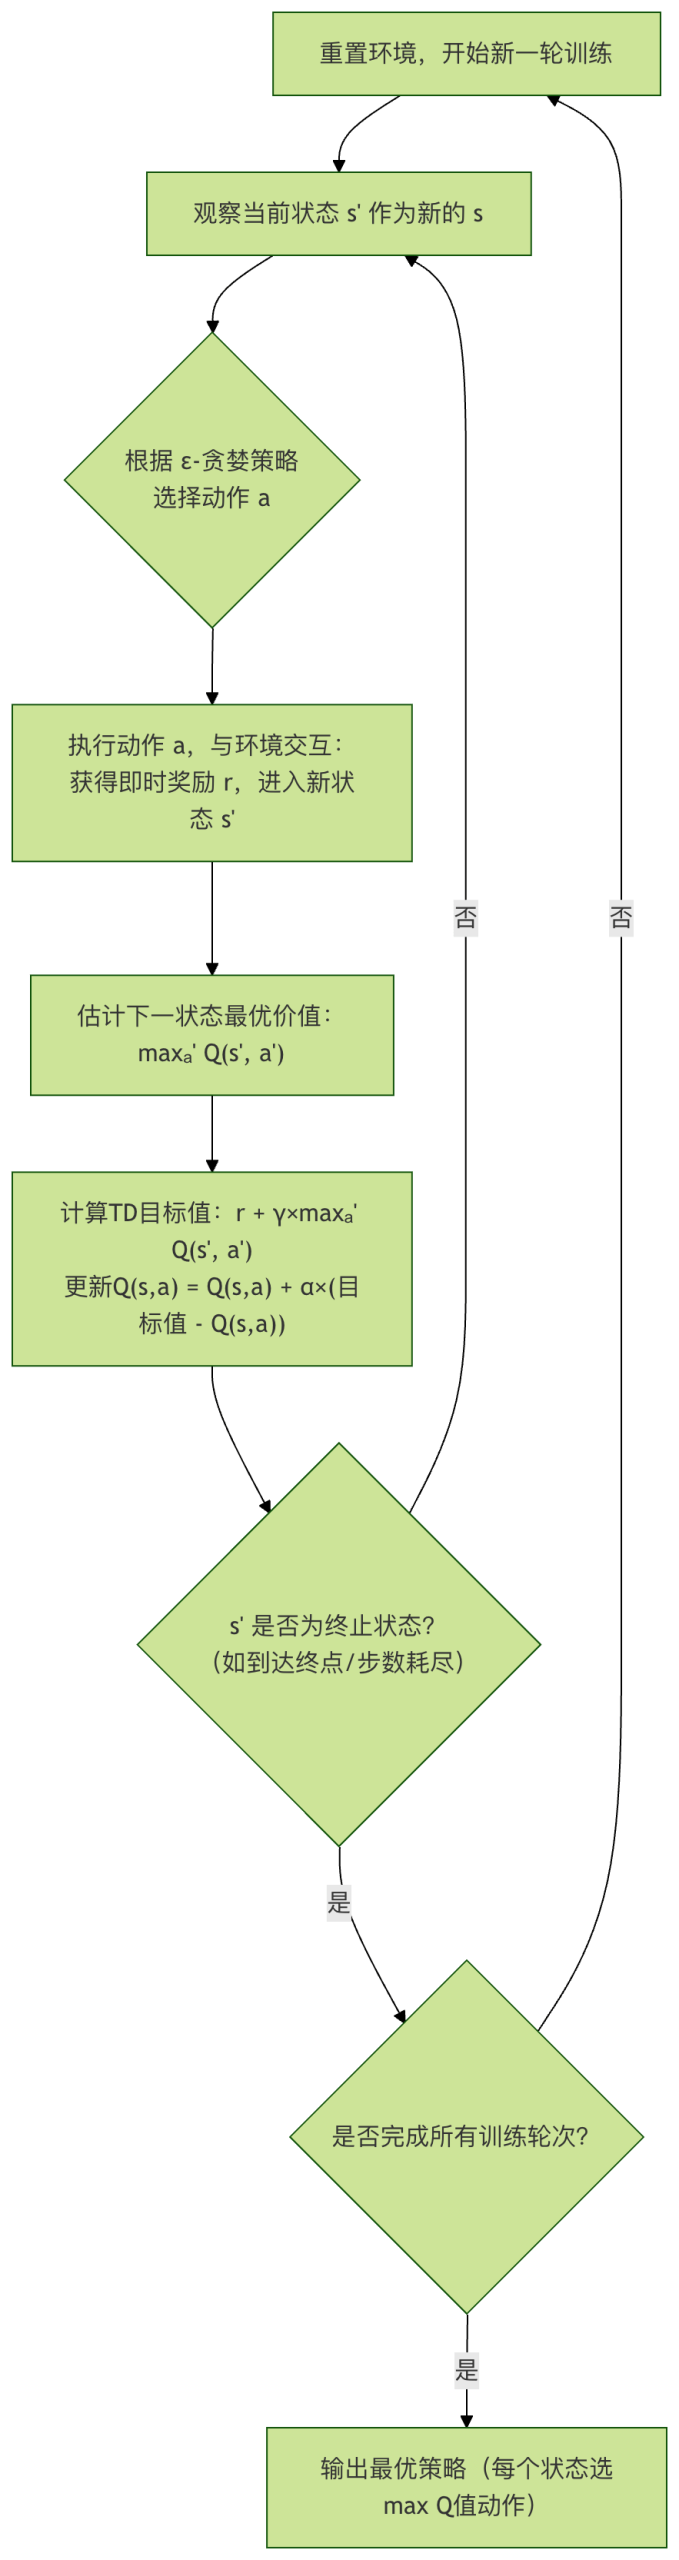
Процесс обучения Q-learning управляется следующей формулой:Q(s_t, a_t) ← Q(s_t, a_t) + α * [ r_{t+1} + γ * max_{a} Q(s_{t+1}, a) - Q(s_t, a_t) ]
Разберём эту формулу:
Q(s_t, a_t)Q(s, a): в момент времени tt, в состоянии ss_tсовершая действие aa_t, текущая оценка.α: Скорость обучения α, управляет степенью, в которой новая информация заменяет старую (0 < α ≤ 1).r_{t+1}r: после выполнения действияa_t, полученная немедленная награда.γ: Коэффициент дисконтирования γ, измеряет важность будущих наград.max_{a} Q(s_{t+1}, a)max Q(s', a'): вследующем состоянииs_{t+1}, наибольшее значение Q среди всех возможных действий. Оно представляет наилучшую возможную будущую доходность, оценённую на основе текущей Q-таблицы.[ r_{t+1} + γ * max_{a} Q(s_{t+1}, a) - Q(s_t, a_t) ]TD-ошибка: называетсяошибкой временных различий. Это разница между «целевым значением» (немедленная награда плюс наилучшая будущая оценка) и «текущей оценкой». Алгоритм обновляет Q, уменьшая эту ошибку.
Смысл off-policy
Q-learning называетсяoff-policy, потому что при обновлении значений Q действие, используемое для оценки будущей ценности (max_{a} Q(s_{t+1}, a)) и действие, которое агент фактически выполняет для исследования,разделены.。
- Поведенческая политика: политика, используемая для выбора фактически выполняемых действий (например, ε-greedy, которая исследует случайно с определённой вероятностью).
- Целевая политика: политика, используемая для обновления Q-значений; это полностью жадная политика (всегда выбирает действие с наибольшим текущим Q-значением).
Это разделение позволяет Q-learning смело учиться, используя свою оценку оптимального пути, даже когда он в данный момент выполняет случайное исследование.
Процедура алгоритма
SARSA: обучение с временными различиями по политике (on-policy)
Название SARSA происходит от последовательности состояний-действий, участвующей в его процессе обновления:(S_t, A_t, R_{t+1}, S_{t+1}, A_{t+1}). Этоon-policyалгоритм.
Ядро алгоритма: формула обновления Q-значения
Формула обновления SARSA очень похожа на формулу Q-learning, но есть одно ключевое отличие:Q(s_t, a_t) ← Q(s_t, a_t) + α * [ r_{t+1} + γ * Q(s_{t+1}, a_{t+1}) - Q(s_t, a_t) ]
Обратите внимание на вторую часть:
- Q-learning использует max_{a'} Q(s', a'):
γ * max_{a} Q(s_{t+1}, a) - SARSA использует Q(s', a'):
γ * Q(s_{t+1}, a_{t+1})
В SARSA агент вследующем состоянииs_{t+1}действительно предпримет действиеa_{t+1}Q-значение которого используется для оценки будущей ценности.
Смысл понятия on-policy
SARSA называетсяon-policy, потому что политика, которую она использует для обновления Q-значений (целевая политика), и политика, которую она использует для выбора действий (поведенческая политика),совпадают, и обе обычно являются ε-жадной политикой.
- Она оценивает и оптимизирует политику, которую онавыполняет в текущий момент.
- То, что она изучает, — это политика, которая учитывает риск будущего исследования, поэтому она обычно более «консервативна».
Сравнение Q-learning и SARSA
Понимание разницы между ними — ключ к их освоению. Таблица ниже наглядно обобщает основные различия:
| Характеристика | Q-learning | SARSA |
|---|---|---|
| Тип политики | Вне политики | По политике |
| Цель обновления | На основе оптимального действия:r + γ * max Q(s', a') |
На основе фактического действия:r + γ * Q(s', a_{t+1}) |
| Цель обучения | ИзучитьQ-функциюоптимальной политики. | ИзучитьQ-функциюповеденческой политики (например, ε-greedy). |
| Склонность к риску | Более «смелый», предполагает, что в будущем будут предприняты оптимальные действия | Более «консервативный», учитывает риск, который может принести будущее исследование |
| Момент обновления | В(s, a, r, s')можно обновлять сразу после (S, A, R, S') |
требует(s, a, r, s', a')пятерку (S, A, R, S', A') для обновления. |
| Типичные области применения | Дискретные среды, поиск глобального оптимального решения | Среды с высокими требованиями к безопасности, где нужно избегать опасных состояний |
Классический пример Cliff Walking
Этот пример наглядно иллюстрирует разницу между ними. Предположим, есть сеточный мир, в котором агент идёт от старта S к цели G; ниже находится обрыв. Падение даёт большую отрицательную награду и возвращает в начало.
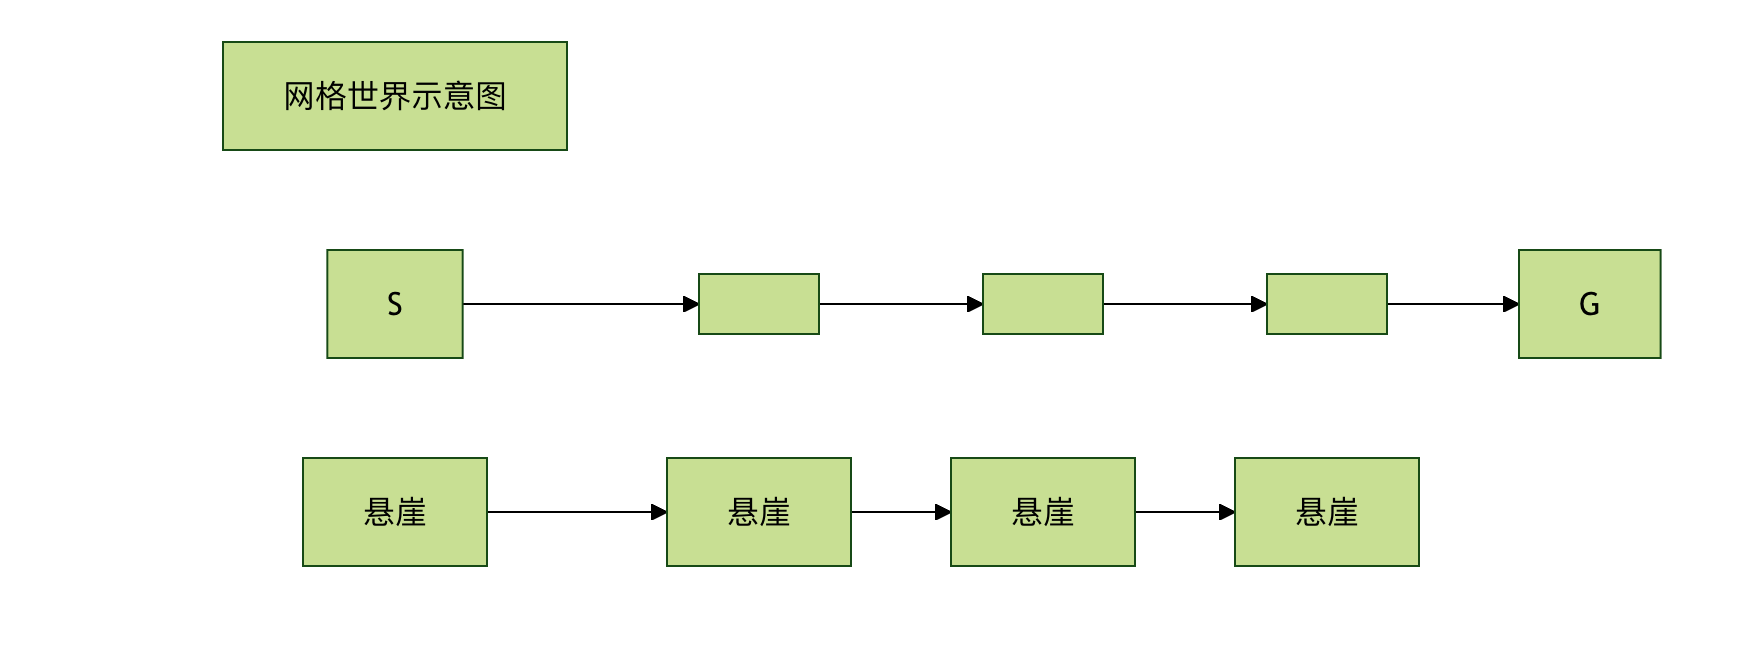
- Q-learningQ-learning: Поскольку он предполагает, что в будущем всегда будет выбран оптимальный (самый безопасный) путь, он быстро выучивает кратчайший путь вдоль края обрыва (Путь 1), потому что «верит», что не упадёт.
- SARSASARSA: Поскольку он учитывает, что в будущем всё ещё существует вероятность ε случайного исследования, он может упасть с обрыва. Поэтому он выучивает более безопасный путь дальше от края (Путь 2). Хотя он длиннее, его долгосрочная ожидаемая отдача выше.
Заключение: В средах, где необходимо балансировать исследование и использование, а ошибки дорого обходятся, SARSA обычно обучается более безопасной и устойчивой политике.
Практика программирования: реализация Q-learning и SARSA на Python
Мы будем использовать простой4x4сеточный мир, чтобы продемонстрировать оба алгоритма. Цель — чтобы агент переместился из левого верхнего угла(0,0)в правый нижний угол(3,3)。
Настройка окружения
Пример
import random
class GridWorld:
def __init__(self, size=4):
self.size = size
self.state = (0, 0) # Начальная точка
self.goal = (size-1, size-1) # Конечная точка
self.actions = ['up', 'down', 'left', 'right']
self.action_map = {'up': (-1, 0), 'down': (1, 0), 'left': (0, -1), 'right': (0, 1)}
def reset(self):
"""Сбросить среду в начальную точку"""
self.state = (0, 0)
return self.state
def step(self, action):
"""Выполнить действие, вернуть (следующее состояние, награда, завершено)"""
move = self.action_map[action]
next_state = (self.state[0] + move[0], self.state[1] + move[1])
# Проверка границ: если вне границ, остаться на месте
if not (0 <= next_state[0] < self.size and 0 <= next_state[1] < self.size):
next_state = self.state
self.state = next_state
# Настройка награды: награда 10 за достижение цели, -1 за другие ходы (поощряет быстрое достижение)
if next_state == self.goal:
reward = 10
done = True
else:
reward = -1
done = False
return next_state, reward, done
def get_actions(self):
return self.actions
Реализация алгоритма Q-learning
Пример
"""
Реализовать алгоритм Q-learning
env: объект среды
episodes: количество эпизодов обучения
alpha: скорость обучения
gamma: коэффициент дисконтирования
epsilon: вероятность исследования в ε-жадной политике
"""
# Инициализировать Q-таблицу с формой [строки сетки, столбцы сетки, количество действий]
q_table = np.zeros((env.size, env.size, len(env.actions)))
for episode in range(episodes):
state = env.reset()
done = False
while not done:
# 1. Выбрать действие с помощью ε-жадной стратегии
if random.uniform(0, 1) < epsilon:
action_idx = random.randint(0, len(env.actions)-1) # Исследование: выбрать случайно
else:
action_idx = np.argmax(q_table[state[0], state[1], :]) # Эксплуатация: выбрать действие с максимальным значением Q
action = env.actions[action_idx]
# 2. Выполнить действие, получить обратную связь
next_state, reward, done = env.step(action)
# 3. Основное обновление Q-learning
# Q-значение текущей пары состояние-действие
current_q = q_table[state[0], state[1], action_idx]
# Максимальное Q-значение следующего состояния (ключ для off-policy)
next_max_q = np.max(q_table[next_state[0], next_state[1], :])
# Вычислить целевое Q-значение
target_q = reward + gamma * next_max_q
# Обновить Q-таблицу
q_table[state[0], state[1], action_idx] = current_q + alpha * (target_q - current_q)
# Переход к следующему состоянию
state = next_state
return q_table
Реализация алгоритма SARSA
Пример
"""
Реализовать алгоритм SARSA
Значения параметров такие же, как в Q-learning
"""
q_table = np.zeros((env.size, env.size, len(env.actions)))
for episode in range(episodes):
state = env.reset()
done = False
# SARSA требует сначала выбрать действие для начального состояния
if random.uniform(0, 1) < epsilon:
action_idx = random.randint(0, len(env.actions)-1)
else:
action_idx = np.argmax(q_table[state[0], state[1], :])
action = env.actions[action_idx]
while not done:
# 1. Выполнить действие, выбранное на предыдущем шаге
next_state, reward, done = env.step(action)
# 2. Выбрать действие для следующего состояния (on-policy, по-прежнему используя ε-greedy)
if random.uniform(0, 1) < epsilon:
next_action_idx = random.randint(0, len(env.actions)-1)
else:
next_action_idx = np.argmax(q_table[next_state[0], next_state[1], :])
next_action = env.actions[next_action_idx]
# 3. Основное обновление SARSA
current_q = q_table[state[0], state[1], action_idx]
# Ключевое отличие: используйте Q-значение **фактического действия, которое будет выполнено** в следующем состоянии
next_q = q_table[next_state[0], next_state[1], next_action_idx]
target_q = reward + gamma * next_q
q_table[state[0], state[1], action_idx] = current_q + alpha * (target_q - current_q)
# 4. Обновить состояние и действие для следующей итерации
state = next_state
action_idx = next_action_idx
action = next_action
return q_table
Тестирование и визуализация политики
Пример
"""Проверить изученную политику"""
total_rewards = []
for _ in range(episodes):
state = env.reset()
done = False
total_reward = 0
steps = []
while not done:
# Использовать жадную политику во время тестирования (без исследования)
action_idx = np.argmax(q_table[state[0], state[1], :])
action = env.actions[action_idx]
next_state, reward, done = env.step(action)
steps.append(action[0].upper()) # Записать первую букву каждого действия
total_reward += reward
state = next_state
total_rewards.append(total_reward)
print(f"Шагов в эпизоде: {steps}, Общая награда: {total_reward}")
print(f"Средняя награда: {np.mean(total_rewards):.2f}")
# Создаём среду
env = GridWorld(size=4)
print("=== Обучение и тестирование Q-learning ===")
q_table_ql = q_learning(env, episodes=1000)
test_policy(env, q_table_ql)
print("\n"=== Обучение и тестирование SARSA ===")
env.reset() # Сбросить состояние среды
q_table_sarsa = sarsa(env, episodes=1000)
test_policy(env, q_table_sarsa)
# Просто сравните итоговые политики
print("\n=== Сравнение политик (действия из начальной точки (0,0)) ===)
start_q_values = q_table_ql[0, 0, :]
start_sarsa_values = q_table_sarsa[0, 0, :]
print(f"Q-learning Q-значения: {dict(zip(env.actions, start_q_values))}")
print(f"Рекомендуемое действие: {env.actions[np.argmax(start_q_values)]}")
print(f"SARSA Q-значения: {dict(zip(env.actions, start_sarsa_values))}")
print(f"Рекомендуемое действие: {env.actions[np.argmax(start_sarsa_values)]}")