Aprendizaje por refuerzo: Q-learning y SARSA
En el campo de la inteligencia artificial, el aprendizaje por refuerzo es un método que permite a un agente aprender a alcanzar sus objetivos mediante la interacción con el entorno.
Imagina que enseñas a un cachorro una nueva orden: cuando realiza una acción (como sentarse), le das una recompensa (una golosina), y así poco a poco aprende a responder correctamente al oír la orden. Q-learning y SARSA son dos algoritmos clásicos y cruciales del aprendizaje por refuerzo; son las herramientas centrales que permiten al agente aprenderqué acción es mejor en cada estado.En este artículo te explicaremos con claridad los principios, las diferencias y la implementación de estos dos algoritmos.
Fundamentos del aprendizaje por refuerzo y los procesos de decisión de Markov
Antes de profundizar en Q-learning y SARSA, necesitamos entender el marco teórico que comparten.
Conceptos clave
Los problemas de aprendizaje por refuerzo suelen modelarse comoun proceso de decisión de Markov (MDP).Este contiene los siguientes elementos clave:
- Agente: el sujeto que toma decisiones y aprende.
- Entorno: el mundo externo con el que interactúa el agente.
- Estado: la descripción del entorno en un momento específico.
- Acción: la operación que el agente puede ejecutar en un estado dado.
- Recompensa: la señal de recompensa inmediata que el entorno devuelve después de que el agente ejecuta una acción.
- Política: la regla según la cual el agente elige acciones en un estado dado; es el objetivo del aprendizaje.
Objetivos y funciones de valor
El objetivo final del agente es maximizar la recompensa acumulada a largo plazo, no solo la recompensa inmediata. Para ello, introducimos lasfunciones de valor.。
- Función de valor de estado V(s): representa la recompensa acumulada esperada que se puede obtener comenzando en el estado
sy siguiendo una política determinada. - Función de valor de acción Q(s, a): representa la recompensa acumulada esperada que se obtiene al ejecutar la acción
sen el estadoay luego seguir una política determinada.El núcleo de Q-learning y SARSA es aprender esta función Q.
Para equilibrar la recompensa inmediata y la recompensa futura, utilizamos elfactor de descuento γ(cuyo rango de valores suele ser [0, 1]). La recompensa del k-ésimo paso futuro se multiplica por γ^k, lo que significa que el agente valora más las recompensas cercanas.
Q-learning: aprendizaje por diferencias temporales off-policy (fuera de política)
Q-learning es un algoritmooff-policy (fuera de política), propuesto por Watkins en 1989. Su idea central es que el agente aprende una tabla de valores Q óptima para encontrar indirectamente la política óptima.
Núcleo del algoritmo: fórmula de actualización del valor Q
El proceso de aprendizaje de Q-learning se impulsa mediante la siguiente fórmula:Q(s_t, a_t) ← Q(s_t, a_t) + α * [ r_{t+1} + γ * max_{a} Q(s_{t+1}, a) - Q(s_t, a_t) ]
Vamos a desglosar esta fórmula:
Q(s_t, a_t)Q(s_t, a_t): en el tiempo tt, en el estado ss_tse toma la acción a,a_ty este es el valor estimado actual.α: Tasa de aprendizaje, que controla el grado en que la información nueva reemplaza a la información anterior (0 < α ≤ 1).r_{t+1}r: la recompensa inmediata obtenida después de ejecutar la accióna_t.γ: Factor de descuento, mide la importancia de las recompensas futuras.max_{a} Q(s_{t+1}, a)max_{a'} Q(s_{t+1}, a'): en elsiguiente estados_{t+1}, el valor Q máximo entre todas las acciones posibles. Esto representa la mejor ganancia futura estimada según la tabla Q actual.[ r_{t+1} + γ * max_{a} Q(s_{t+1}, a) - Q(s_t, a_t) ]δ: se denominaerror de diferencia temporal (TD).Es la diferencia entre el "valor objetivo" (recompensa inmediata más la mejor estimación futura) y el "valor estimado actual". El algoritmo actualiza el valor Q reduciendo este error.
Significado de off-policy (fuera de política)
Q-learning se denominaoff-policy (fuera de política), porque al actualizar el valor Q, la acción utilizada para evaluar el valor futuro (max_{a} Q(s_{t+1}, a)) y la acción que el agente realmente ejecuta para explorarestán separadas.。
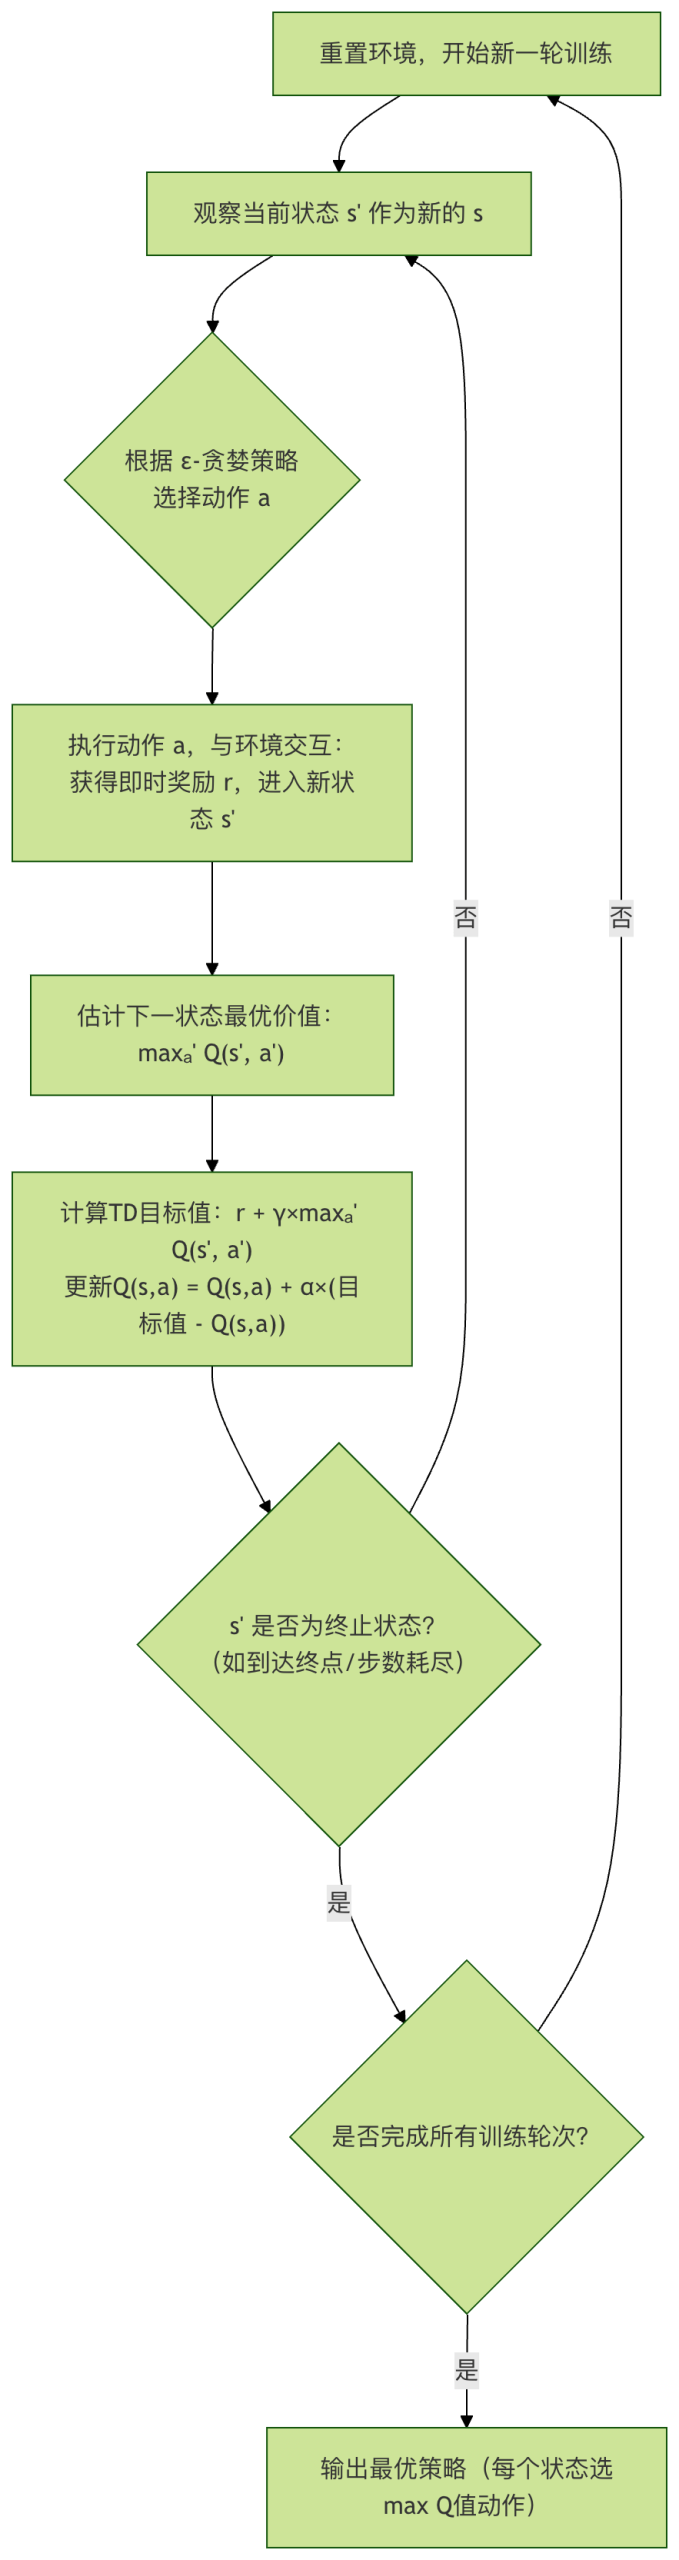
- Política de comportamiento: la política utilizada para seleccionar la acción que se ejecuta realmente (por ejemplo, ε-greedy, que explora aleatoriamente con cierta probabilidad).
- Política objetivo: la política utilizada para actualizar el valor Q; es una política completamente codiciosa (siempre elige la acción con el mayor valor Q actual).
Esta separación permite que Q-learning aprenda aprovechando con audacia su estimación del camino óptimo, incluso mientras está realizando exploración aleatoria.
Flujo del algoritmo
SARSA: aprendizaje por diferencias temporales on-policy
El nombre SARSA proviene de la secuencia estado-acción (S, A, R, S', A') involucrada en su proceso de actualización:(S_t, A_t, R_{t+1}, S_{t+1}, A_{t+1})Es un algoritmoon-policy (misma política).Núcleo del algoritmo: fórmula de actualización del valor Q
Núcleo del algoritmo: fórmula de actualización del valor Q
Presta atención a la segunda parte:Q(s_t, a_t) ← Q(s_t, a_t) + α * [ r_{t+1} + γ * Q(s_{t+1}, a_{t+1}) - Q(s_t, a_t) ]
Q-learning usa max_{a'} Q(s', a')
- SARSA usa Q(s', a'):
γ * max_{a} Q(s_{t+1}, a) - En SARSA, para estimar el valor futuro se usa el valor Q de la acción que el agente ejecutará realmente en el:
γ * Q(s_{t+1}, a_{t+1})
siguiente estadosegún su política actuals_{t+1}.a_{t+1}Significado de on-policy
Significado de on-policy (misma política)
on-policy (misma política), porque la política utilizada para actualizar el valor Q (política objetivo) y la utilizada para seleccionar acciones (política de comportamiento)son la misma, normalmente una política ε-greedy.Lo que evalúa y optimiza es la política que está
- ejecutando.Aprende la política teniendo en cuenta el riesgo de la exploración futura, por lo que suele ser más "conservadora".
- Comparación entre Q-learning y SARSA
Comparación entre Q-learning y SARSA
Característica
| Tipo de política | Q-learning | SARSA |
|---|---|---|
| off-policy (fuera de política) | on-policy (misma política) | Objetivo de actualización |
| Basado en la acción óptima: | Basado en la acción real:r + γ * max Q(s', a') |
Objetivo de aprendizajer + γ * Q(s', a_{t+1}) |
| Aprender la función Q de la | política óptima.Aprender la función Q de la | política de ejecución(por ejemplo, ε-greedy).Propensión al riesgo |
| Más "audaz": asume que en el futuro se tomará la acción óptima. | Más "conservador": considera el riesgo que la exploración futura puede traer. | Momento de actualización |
| Se puede actualizar después de (s, a, r, s'). | En(s, a, r, s')Necesita la |
quíntupla (S, A, R, S', A') para actualizar.(s, a, r, s', a')Aplicaciones típicas |
| Entornos discretos, búsqueda de la solución óptima global. | Entornos con altos requisitos de seguridad, donde se deben evitar estados peligrosos. | Ejemplo clásico: el problema del acantilado (Cliff Walking) |
Ejemplo clásico: el problema del acantilado (Cliff Walking)
Q-learning: como asume que en el futuro siempre tomará el camino óptimo (el más seguro), aprenderá rápidamente el camino más corto junto al borde del acantilado (camino 1), porque "cree" que no caerá.
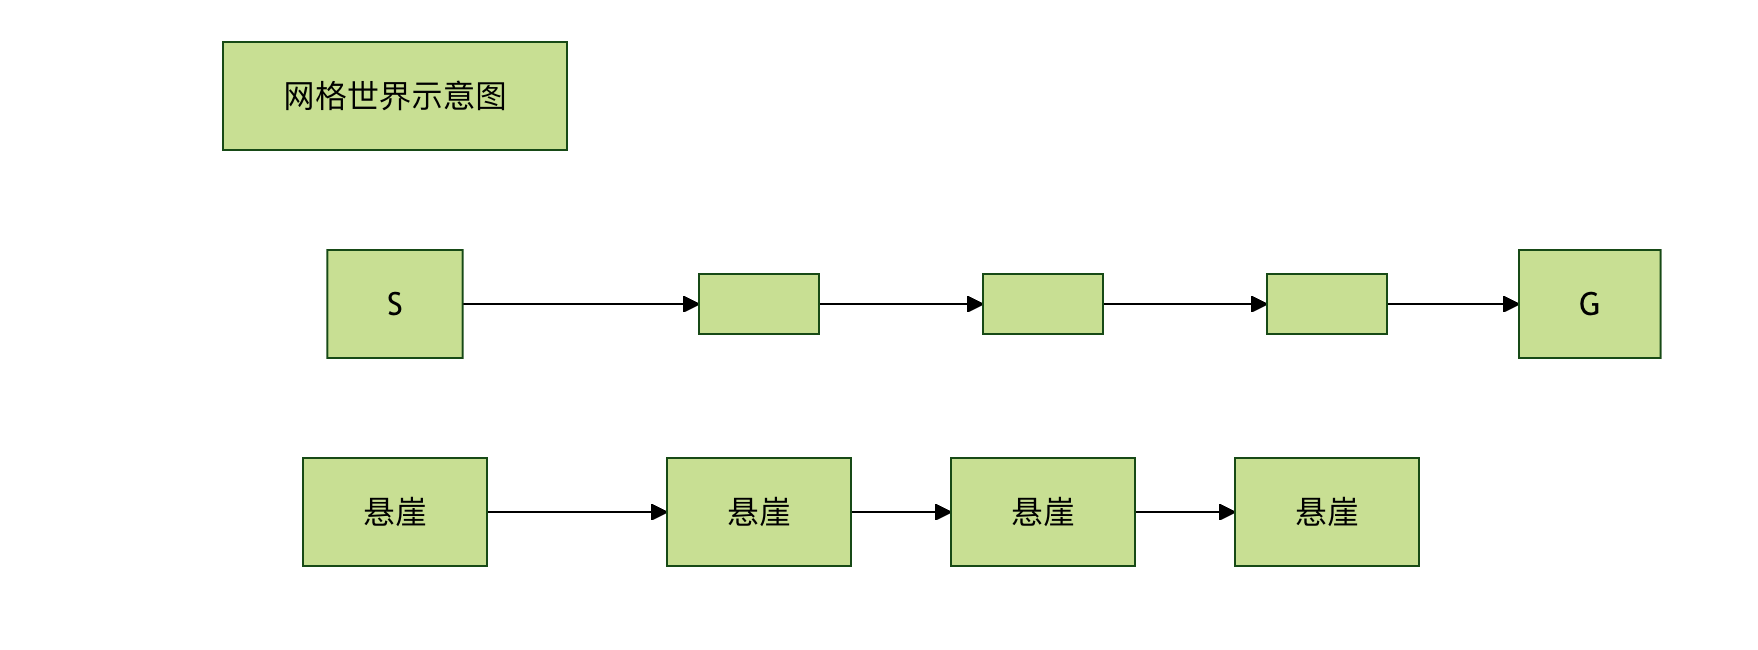
- Q-learningSARSA: como considera que en el futuro todavía hay una probabilidad ε de explorar aleatoriamente y podría caer al acantilado, aprenderá un camino seguro más arriba (camino 2). Aunque es más largo, la recompensa esperada a largo plazo es mayor.
- SARSAConclusión
: en entornos donde se requiere equilibrar exploración y explotación, y donde las acciones erróneas tienen un costo alto, SARSA suele aprender una política más segura y robusta.: En entornos donde se necesita equilibrar la exploración y la explotación, y donde el costo de las acciones erróneas es alto, SARSA normalmente puede aprender políticas más seguras y robustas.
Práctica de código: implementación de Q-learning y SARSA en Python
Usaremos un simple4x4mundo de cuadrícula para demostrar los dos algoritmos. El objetivo es que el agente desde la esquina superior izquierda(0,0)camine hasta la esquina inferior derecha.(3,3)。
Configuración del entorno
Ejemplo
import random
class GridWorld:
def __init__(self, size=4):
self.size = size
self.state = (0, 0) # Punto de inicio
self.goal = (size-1, size-1) # Meta
self.actions = ['up', 'down', 'left', 'right']
self.action_map = {'up': (-1, 0), 'down': (1, 0), 'left': (0, -1), 'right': (0, 1)}
def reset(self):
"""Restablecer el entorno al punto de inicio"""
self.state = (0, 0)
return self.state
def step(self, action):
"""Ejecutar la acción, devolver (siguiente estado, recompensa, si es terminal)"""
move = self.action_map[action]
next_state = (self.state[0] + move[0], self.state[1] + move[1])
# Comprobación de límites: si está fuera de los límites, permanece en su lugar
if not (0 <= next_state[0] < self.size and 0 <= next_state[1] < self.size):
next_state = self.state
self.state = next_state
# Configuración de recompensa: llegar a la meta recompensa 10, otros movimientos recompensa -1 (fomenta llegar lo antes posible)
if next_state == self.goal:
reward = 10
done = True
else:
reward = -1
done = False
return next_state, reward, done
def get_actions(self):
return self.actions
Implementación del algoritmo Q-learning
Ejemplo
"""
Implementar el algoritmo Q-learning
env: objeto del entorno
episodes: número de episodios de entrenamiento
alpha: tasa de aprendizaje
gamma: factor de descuento
epsilon: probabilidad de exploración en la estrategia ε-greedy
"""
# Inicializar la tabla Q, dimensiones [filas de la cuadrícula, columnas de la cuadrícula, número de acciones]
q_table = np.zeros((env.size, env.size, len(env.actions)))
for episode in range(episodes):
state = env.reset()
done = False
while not done:
# 1. Selección de acción con la estrategia ε-greedy
if random.uniform(0, 1) < epsilon:
action_idx = random.randint(0, len(env.actions)-1) # Exploración: elegir aleatoriamente
else:
action_idx = np.argmax(q_table[state[0], state[1], :]) # Explotación: elegir el de mayor valor Q
action = env.actions[action_idx]
# 2. Ejecutar la acción, obtener retroalimentación
next_state, reward, done = env.step(action)
# 3. Actualización central de Q-learning
# Valor Q del par estado-acción actual
current_q = q_table[state[0], state[1], action_idx]
# Valor Q máximo del siguiente estado (clave del off-policy)
next_max_q = np.max(q_table[next_state[0], next_state[1], :])
# Calcular el valor Q objetivo
target_q = reward + gamma * next_max_q
# Actualizar la tabla Q
q_table[state[0], state[1], action_idx] = current_q + alpha * (target_q - current_q)
# Pasar al siguiente estado
state = next_state
return q_table
Implementación del algoritmo SARSA
Ejemplo
"""
Implementar el algoritmo SARSA
Parámetros con el mismo significado que en Q-learning
"""
q_table = np.zeros((env.size, env.size, len(env.actions)))
for episode in range(episodes):
state = env.reset()
done = False
# SARSA requiere primero elegir una acción para el estado inicial
if random.uniform(0, 1) < epsilon:
action_idx = random.randint(0, len(env.actions)-1)
else:
action_idx = np.argmax(q_table[state[0], state[1], :])
action = env.actions[action_idx]
while not done:
# 1. Ejecutar la acción seleccionada en el paso anterior
next_state, reward, done = env.step(action)
# 2. Elegir la acción para el siguiente estado (on-policy, todavía usando ε-greedy)
if random.uniform(0, 1) < epsilon:
next_action_idx = random.randint(0, len(env.actions)-1)
else:
next_action_idx = np.argmax(q_table[next_state[0], next_state[1], :])
next_action = env.actions[next_action_idx]
# 3. Actualización central de SARSA
current_q = q_table[state[0], state[1], action_idx]
# Diferencia clave: se usa el valor Q de la **acción que realmente se ejecutará** en el siguiente estado
next_q = q_table[next_state[0], next_state[1], next_action_idx]
target_q = reward + gamma * next_q
q_table[state[0], state[1], action_idx] = current_q + alpha * (target_q - current_q)
# 4. Actualizar el estado y la acción para la siguiente iteración
state = next_state
action_idx = next_action_idx
action = next_action
return q_table
Pruebas y visualización de la política
Ejemplo
"""Probar la política aprendida"""
total_rewards = []
for _ in range(episodes):
state = env.reset()
done = False
total_reward = 0
steps = []
while not done:
# Al probar, usar la política greedy (sin exploración)
action_idx = np.argmax(q_table[state[0], state[1], :])
action = env.actions[action_idx]
next_state, reward, done = env.step(action)
steps.append(action[0].upper()) # Registrar las iniciales de las acciones
total_reward += reward
state = next_state
total_rewards.append(total_reward)
print(f"Episode steps: {steps}, Total reward: {total_reward}")
print(f"Recompensa promedio: {np.mean(total_rewards):.2f}")
# Crear el entorno
env = GridWorld(size=4)
print("=== Entrenar y probar Q-learning ===")
q_table_ql = q_learning(env, episodes=1000)
test_policy(env, q_table_ql)
print("\n=== Entrenar y probar SARSA ===")
env.reset() # Restablecer el estado del entorno
q_table_sarsa = sarsa(env, episodes=1000)
test_policy(env, q_table_sarsa)
# Comparación simple de las políticas finales
print("\n=== Comparación de políticas (acción desde el punto de inicio (0,0)) ===)
start_q_values = q_table_ql[0, 0, :]
start_sarsa_values = q_table_sarsa[0, 0, :]
print(f"Q-learning valor Q: {dict(zip(env.actions, start_q_values))}")
print(f"Acción recomendada: {env.actions[np.argmax(start_q_values)]}")
print(f"SARSA valor Q: {dict(zip(env.actions, start_sarsa_values))}")
print(f"Acción recomendada: {env.actions[np.argmax(start_sarsa_values)]}")