Библиотеки машинного обучения Python
В этой главе вы познакомитесь с четырьмя основными библиотеками Python для машинного обучения: NumPy, Pandas, Matplotlib и Scikit-learn.
Библиотеки машинного обучения похожи на профессиональный набор инструментов, и каждая библиотека имеет своё назначение; при совместном использовании они могут решать сложные задачи машинного обучения.
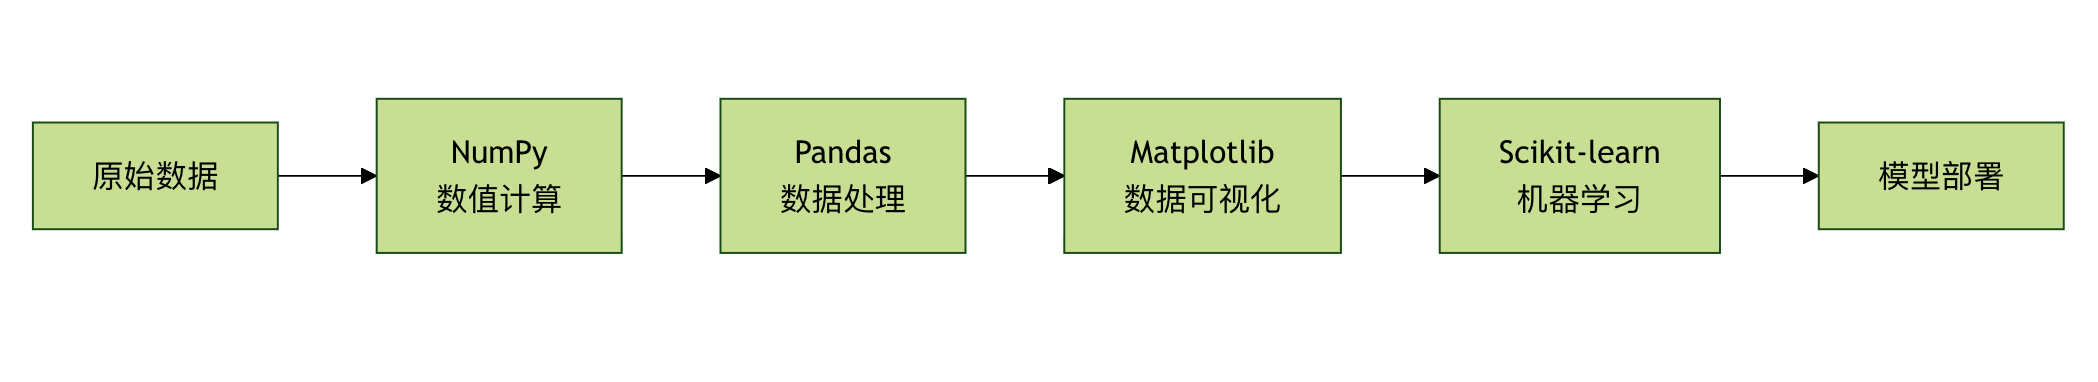
Роли четырёх основных библиотек
- Numpy: основа численных вычислений, обеспечивающая эффективные операции с массивами
- Pandas: острый инструмент для обработки данных, предоставляющий структуры данных и инструменты анализа
- Matplotlib: кисть для визуализации данных, создающая различные графики
- scikit-learn: швейцарский армейский нож машинного обучения, предоставляющий полный инструментарий ML
NumPy: Основа численных вычислений
Что такое NumPy?
NumPy похож на калькулятор для математических вычислений, но он во много раз мощнее. Это основополагающая библиотека для научных вычислений на Python, предоставляющая эффективные объекты многомерных массивов.
Основные концепции NumPy
1. Массив
Пример
import numpy as np
# Различные способы создания массивов
print("=== Создание массива NumPy ===")
# Создать из списка
arr1 = np.array([1, 2, 3, 4, 5])
print(f"Создан из списка: {arr1}")
# Создать массив арифметической последовательности
arr2 = np.arange(0, 10, 2) # от 0 до 10, шаг 2
print(f"Массив арифметической последовательности: {arr2}")
# Создать равномерно распределённый массив
arr3 = np.linspace(0, 1, 5) # от 0 до 1, 5 точек
print(f"Равномерно распределённый массив: {arr3}")
# Создать специальные массивы
zeros_arr = np.zeros((2, 3)) # массив 2x3 из нулей
ones_arr = np.ones((2, 3)) # массив 2x3 из единиц
identity_arr = np.eye(3) # единичная матрица 3x3
print(f"Массив нулей:\n{zeros_arr}")
print(f"Массив единиц:\n{ones_arr}")
print(f"Единичная матрица:\n{identity_arr}")
2. Операции с массивами
Пример
print("\n=== Базовые операции с массивами ===)
# Атрибуты массива
arr = np.array([[1, 2, 3], [4, 5, 6]])
print(f"Массив:"\n{arr}")
print(f"Форма: {arr.shape}")
print(f"Размерность: {arr.ndim}")
print(f"Количество элементов: {arr.size}")
print(f"Тип данных: {arr.dtype}")
# Индексация и срезы массивов
print(f"Первая строка: {arr)
print(f"Первый столбец: {arr[:, 0]}")
print(f"Элемент [1,2]: {arr[1, 2]}")
# Операции с массивами
arr1 = np.array([1, 2, 3])
arr2 = np.array([4, 5, 6])
print(f"Сложение: {arr1 + arr2}")
print(f"Умножение: {arr1 * arr2}")
print(f"Скалярное произведение: {np.dot(arr1, arr2)}")
# Статистические функции
data = np.array([1, 2, 3, 4, 5, 6, 7, 8, 9, 10])
print(f"Среднее: {np.mean(data)}")
print(f"Стандартное отклонение: {np.std(data)}")
print(f"Максимум: {np.max(data)}")
print(f"Минимум: {np.min(data)}")
print(f"Медиана: {np.median(data)}")
Пример практического применения NumPy
Пример
def numpy_linear_regression():
"""Реализовать простую линейную регрессию с помощью NumPy"""
# Сгенерировать пример данных
np.random.seed(42)
X = 2 * np.random.rand(100, 1) # Признаки
y = 4 + 3 * X + np.random.randn(100, 1) # Метки + шум
# Добавить x0 = 1 к X
X_b = np.c_[np.ones((100, 1)), X] # Добавить член смещения
# Решить с помощью нормального уравнения: θ = (X^T * X)^(-1) * X^T * y
theta_best = np.linalg.inv(X_b.T.dot(X_b)).dot(X_b.T).dot(y)
print("=== Пример линейной регрессии с NumPy ===")
print(f"Обученные параметры: свободный член={theta_best)
# Предсказание
X_new = np.array([[0], [2]])
X_new_b = np.c_[np.ones((2, 1)), X_new]
y_predict = X_new_b.dot(theta_best)
print(f"Результаты прогноза: y={y_predict)
return theta_best, X, y
# Запуск примера
theta, X, y = numpy_linear_regression()
Pandas: мощный инструмент для обработки данных
Что такое Pandas?
Pandas — как швейцарский армейский нож для обработки данных, предоставляющий мощные структуры данных и инструменты анализа данных, особенно подходящие для работы с табличными данными.
Основные структуры данных Pandas
1. Series (одномерные данные)
Пример
import pandas as pd
print("=== Pandas Series ===")
# Создать Series из списка
s1 = pd.Series([1, 2, 3, 4, 5])
print(f"Создан из списка:\n{s1}")
# Series с индексом
s2 = pd.Series([10, 20, 30], index=['a', 'b', 'c'])
print(f"\nSeries с индексом:\n{s2}")
# Создать Series из словаря
s3 = pd.Series({'Математика': 90, 'Английский': 85, 'Физика': 88})
print(f"\nСоздан из словаря:\n{s3}")
# Операции с Series
print(f"\nДоступ к элементу: s2['b'] = {s2['b']}")
print(f"Срез: s2[0:2] =\n{s2[0:2]}")
print(f"Статистическая информация:\n{s2.describe()}")
2. DataFrame (Двумерные данные)
Пример
print("\n=== Pandas DataFrame ===")
# Создать DataFrame
data = {
'Имя': ['Чжан Сань', 'Ли Сы', 'Ван У', 'Чжао Лю'],
'Age': [25, 30, 35, 28],
'Город': ['Пекин', 'Шанхай', 'Гуанчжоу', 'Shenzhen'],
'Зарплата': [15000, 20000, 18000, 22000]
}
df = pd.DataFrame(data)
print("Исходный DataFrame:")
print(df)
# Основные операции с DataFrame
print(f"\nРазмер DataFrame: {df.shape}")
print(f"\nИмена столбцов: {list(df.columns)}")
print(f"\nТипы данных:\n{df.dtypes}")
# Выбор данных
print(f"\nВыбрать столбец 'Name':\n{df['Name']}")
print(f"\nВыбрать первые две строки:\n{df.head(2)}")
print(f"\nВыбрать строки, в которых возраст больше 28:\n{df[df['Age'] > 28]}")
# Статистическая информация
print(f"\nСтатистическая информация по числовым столбцам:\n{df.describe()}")
# Добавить новый столбец
df['Annual Salary'] = df['Salary'] * 12
print(f"\nПосле добавления столбца годовой зарплаты:\n{df}")
Пример обработки данных в Pandas
Пример
def pandas_data_processing():
"""Продемонстрировать полный рабочий процесс обработки данных в Pandas"""
print("=== Пример обработки данных Pandas ===")
# 1. Создание образца данных
np.random.seed(42)
n_samples = 1000
data = {
'Student ID': range(1, n_samples + 1),
'Name': [f'Student {i}' for i in range(1, n_samples + 1)],
'Возраст': np.random.randint(18, 25, n_samples),
'Пол': np.random.choice(['Мужской', 'Женский'], n_samples),
'Math Score': np.random.normal(75, 15, n_samples),
'English Score': np.random.normal(80, 12, n_samples),
'Physics Score': np.random.normal(72, 18, n_samples),
'Class': np.random.choice(['Class 1', 'Class 2', 'Class 3'], n_samples)
}
df = pd.DataFrame(data)
# 2. Очистка данных
print("Размер исходных данных:", df.shape)
# Обработка выбросов (оценки должны быть в диапазоне 0-100)
score_columns = ['Math Score', 'English Score', 'Physics Score']
for col in score_columns:
df[col] = df[col].clip(0, 100)
# 3. Конструирование признаков
# Вычислить общий балл и средний балл
df['Total Score'] = df[score_columns].sum(axis=1)
df['Average Score'] = df[score_columns].mean(axis=1)
# Добавить оценку
def get_grade(score):
if score >= 90:
return 'A'
elif score >= 80:
return 'B'
elif score >= 70:
return 'C'
elif score >= 60:
return 'D'
else:
return 'F'
df['Grade'] = df['Average Score'].apply(get_grade)
# 4. Анализ данных
print("\n=== Результаты анализа данных ===)
# Базовая статистика
print("Средние баллы по предметам:")
print(df[score_columns].mean())
# Анализ по классам
print("\nСредний балл по классам:")
class_avg = df.groupby('Class')['Average Score'].mean()
print(class_avg)
# Анализ по полу
print("\nРаспределение по полу:")
gender_count = df['Gender'].value_counts()
print(gender_count)
# Распределение оценок
print("\nРаспределение оценок:")
grade_dist = df['Grade'].value_counts().sort_index()
print(grade_dist)
# 5. Фильтрация данных
print("\n=== Фильтрация конкретных данных ===)
# Отличники (средний балл > 85)
excellent_students = df[df['Average Score'] > 85].head(5)
print("Отличники (Топ 5):")
print(excellent_students[['Name', 'Average Score', 'Grade']])
# Ученик с лучшим баллом в каждом классе
print("\nУченик с лучшим баллом в каждом классе:")
top_students = df.loc[df.groupby('Class')['Average Score'].idxmax()]
print(top_students[['Class', 'Name', 'Average Score']])
return df
# Пример запуска
student_df = pandas_data_processing()
Matplotlib: Кисть для визуализации данных
Что такое Matplotlib?
Matplotlib — это как кисть художника по данным, которая может превращать скучные данные в интуитивно понятные графики, помогая нам понимать закономерности и взаимосвязи в данных.
Базовые графики в Matplotlib
Пример
import matplotlib.pyplot as plt
import numpy as np
# Установить китайский шрифт (предотвратить отображение китайских иероглифов в виде квадратов)
plt.rcParams['font.sans-serif'] = ['SimHei', 'Arial Unicode MS']
plt.rcParams['axes.unicode_minus'] = False
def matplotlib_basic_charts():
"""Демонстрация базовых графиков Matplotlib"""
print("=== Пример базового графика Matplotlib ===")
# 1. Линейный график
plt.figure(figsize=(12, 8))
plt.subplot(2, 3, 1)
x = np.linspace(0, 10, 100)
y1 = np.sin(x)
y2 = np.cos(x)
plt.plot(x, y1, label='sin(x)')
plt.plot(x, y2, label='cos(x)')
plt.title('Тригонометрические функции')
plt.xlabel('x')
plt.ylabel('y')
plt.legend()
plt.grid(True)
# 2. Диаграмма рассеяния
plt.subplot(2, 3, 2)
np.random.seed(42)
x = np.random.randn(100)
y = 2 * x + np.random.randn(100) * 0.5
plt.scatter(x, y, alpha=0.6, c='blue')
plt.title('Диаграмма рассеяния')
plt.xlabel('X')
plt.ylabel('Y')
# 3. Столбчатая диаграмма
plt.subplot(2, 3, 3)
categories = ['A', 'B', 'C', 'D', 'E']
values = [23, 45, 56, 78, 32]
plt.bar(categories, values, color=['red', 'green', 'blue', 'orange', 'purple'])
plt.title('Столбчатая диаграмма')
plt.xlabel('Категория')
plt.ylabel('Значение')
# 4. Гистограмма
plt.subplot(2, 3, 4)
data = np.random.normal(100, 15, 1000)
plt.hist(data, bins=30, alpha=0.7, color='skyblue', edgecolor='black')
plt.title('Гистограмма')
plt.xlabel('Значение')
plt.ylabel('Частота')
# 5. Круговая диаграмма
plt.subplot(2, 3, 5)
sizes = [30, 25, 20, 15, 10]
labels = ['A', 'B', 'C', 'D', 'E']
colors = ['gold', 'lightcoral', 'lightskyblue', 'lightgreen', 'plum']
plt.pie(sizes, labels=labels, colors=colors, autopct='%1.1f%%', startangle=90)
plt.title('Круговая диаграмма')
# 6. Ящичная диаграмма
plt.subplot(2, 3, 6)
data1 = np.random.normal(0, 1, 100)
data2 = np.random.normal(2, 1, 100)
data3 = np.random.normal(-2, 1, 100)
plt.boxplot([data1, data2, data3], labels=['Группа 1', 'Группа 2', 'Группа 3'])
plt.title('Ящичная диаграмма')
plt.ylabel('Значение')
plt.tight_layout()
plt.show()
print("Диаграмма отображена!")
# Пример запуска
matplotlib_basic_charts()
Пример расширенной визуализации
Пример
def advanced_visualization():
"""Демонстрация продвинутых методов визуализации"""
print("=== Пример продвинутой визуализации ===")
# Создать более сложные данные
np.random.seed(42)
n_points = 200
# Генерация коррелированных данных
x = np.random.randn(n_points)
y = 2 * x + np.random.randn(n_points) * 0.5
colors = np.random.rand(n_points)
sizes = 1000 * np.random.rand(n_points)
# 1. Пузырьковая диаграмма
plt.figure(figsize=(15, 5))
plt.subplot(1, 3, 1)
scatter = plt.scatter(x, y, c=colors, s=sizes, alpha=0.6, cmap='viridis')
plt.colorbar(scatter, label='Значение цвета')
plt.title('Пузырьковая диаграмма')
plt.xlabel('X')
plt.ylabel('Y')
# 2. Тепловая карта
plt.subplot(1, 3, 2)
data = np.random.randn(10, 10)
im = plt.imshow(data, cmap='coolwarm', aspect='auto')
plt.colorbar(im, label='Значение')
plt.title('Тепловая карта')
# 3. Комбинирование подграфиков
plt.subplot(1, 3, 3)
# Создать подграфики
gs = plt.GridSpec(2, 2, subplot_kw={'projection': 'polar'})
ax1 = plt.subplot(gs[0, 0])
theta = np.linspace(0, 2*np.pi, 100)
r = np.sin(3*theta)
ax1.plot(theta, r)
ax1.set_title('Полярная диаграмма')
ax2 = plt.subplot(gs[0, 1])
categories = ['A', 'B', 'C', 'D']
values = [15, 30, 45, 10]
ax2.bar(categories, values)
ax2.set_title('Столбчатая диаграмма')
ax3 = plt.subplot(gs[1, :])
x_line = np.linspace(0, 10, 100)
y_line1 = np.sin(x_line)
y_line2 = np.cos(x_line)
ax3.plot(x_line, y_line1, label='sin')
ax3.plot(x_line, y_line2, label='cos')
ax3.set_title('Комбинированная диаграмма')
ax3.legend()
plt.tight_layout()
plt.show()
print("Расширенная диаграмма отображена!")
# Пример запуска
advanced_visualization()
Scikit-learn: швейцарский армейский нож машинного обучения
Что такое Scikit-learn?
Scikit-learn — это как инструментарий для машинного обучения, предоставляющий полную цепочку инструментов от предварительной обработки данных до обучения и оценки моделей, и является де-факто стандартом для машинного обучения на Python.
Основные возможности Scikit-learn
Пример
from sklearn.datasets import make_classification, load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler, LabelEncoder
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.svm import SVC
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
def scikit_learn_basics():
"""Демонстрация основных возможностей Scikit-learn"""
print("=== Пример основных возможностей Scikit-learn ===")
# 1. Генерация данных
X, y = make_classification(
n_samples=1000,
n_features=20,
n_classes=3,
n_informative=15,
random_state=42
)
print(f"Форма данных: X={X.shape}, y={y.shape}")
print(f"Распределение классов: {np.bincount(y)}")
# 2. Разделение данных
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Ilinniaqtitsinirmut katit angini: {X_train.shape)
print(f"Размер тестовой выборки: {X_test.shape)
# 3. Предобработка данных
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
print("Стандартизация данных завершена")
# 4. Обучение и сравнение моделей
models = {
'Логистическая регрессия': LogisticRegression(random_state=42),
'Случайный лес': RandomForestClassifier(n_estimators=100, random_state=42),
'Метод опорных векторов': SVC(random_state=42)
}
results = {}
for name, model in models.items():
print(f"\nОбучение {name}...")
# Обучите модель
model.fit(X_train_scaled, y_train)
# Прогнозирование
y_pred = model.predict(X_test_scaled)
# Оценить
accuracy = accuracy_score(y_test, y_pred)
results[name] = accuracy
print(f"{name} Точность: {accuracy:.4f}")
print(f"Отчёт о классификации:\n{classification_report(y_test, y_pred)}")
# 5. Сравнение результатов
print("\n=== Сравнение моделей === ")
for name, accuracy in results.items():
print(f"{name}: {accuracy:.4f}")
best_model = max(results, key=results.get)
print(f"\nЛучшая модель: {best_model}")
return models[best_model]
# Пример запуска
best_model = scikit_learn_basics()
Полный рабочий процесс машинного обучения
Пример
def complete_ml_pipeline():
"""Демонстрация полного рабочего процесса машинного обучения"""
print("=== Полный рабочий процесс машинного обучения ===")
# 1. Загрузить данные
iris = load_iris()
X = iris.data
y = iris.target
feature_names = iris.feature_names
target_names = iris.target_names
print(f"Набор данных: {iris.DESCR.split('\n')[0]}")
print(f"Количество признаков: {len(feature_names)}")
print(f"Количество классов: {len(target_names)}")
# 2. Исследование данных
df = pd.DataFrame(X, columns=feature_names)
df['target'] = y
print("\nПредварительный просмотр данных:")
print(df.head())
print("\nСтатистика данных:")
print(df.describe())
# 3. Визуализация данных
plt.figure(figsize=(12, 4))
plt.subplot(1, 2, 1)
for i, target_name in enumerate(target_names):
plt.scatter(
df[df['target'] == i]['sepal length (cm)'],
df[df['target'] == i]['sepal width (cm)'],
label=target_name
)
plt.xlabel('Длина чашелистика')
plt.ylabel('Ширина чашелистика')
plt.title('Распределение размеров чашелистиков')
plt.legend()
plt.subplot(1, 2, 2)
for i, target_name in enumerate(target_names):
plt.scatter(
df[df['target'] == i]['petal length (cm)'],
df[df['target'] == i]['petal width (cm)'],
label=target_name
)
plt.xlabel('Длина лепестка')
plt.ylabel('Ширина лепестка')
plt.title('Распределение размеров лепестков')
plt.legend()
plt.tight_layout()
plt.show()
# 4. Подготовка данных
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.3, random_state=42, stratify=y
)
# 5. Обучение модели
from sklearn.ensemble import RandomForestClassifier
model = RandomForestClassifier(n_estimators=100, random_state=42)
model.fit(X_train, y_train)
# 6. Оценка модели
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f"\nТочность модели: {accuracy:.4f}")
print("\nМатрица ошибок:")
print(confusion_matrix(y_test, y_pred))
print("\nОтчёт по классификации:")
print(classification_report(y_test, y_pred, target_names=target_names))
# 7. Важность признаков
feature_importance = model.feature_importances_
feature_df = pd.DataFrame({
'Feature': feature_names,
'Importance': feature_importance
}).sort_values('Importance', ascending=False)
print("\nВажность признаков:")
print(feature_df)
# 8. Визуализация важности признаков
plt.figure(figsize=(8, 4))
plt.bar(feature_df['Feature'], feature_df['Importance'])
plt.title('Важность признаков')
plt.xlabel('Признак')
plt.ylabel('Важность')
plt.xticks(rotation=45)
plt.tight_layout()
plt.show()
return model, feature_df
# Пример запуска
trained_model, feature_importance = complete_ml_pipeline()
Пример совместной работы четырёх библиотек
Пример
def four_libraries_integration():
"""Демонстрация совместной работы NumPy, Pandas, Matplotlib и Scikit-learn"""
print("=== Пример совместной работы четырёх библиотек ===")
# 1. NumPy: Генерация смоделированных данных
np.random.seed(42)
n_samples = 500
# Генерация признаков
study_hours = np.random.uniform(1, 10, n_samples) # Время учёбы
sleep_hours = np.random.uniform(5, 9, n_samples) # Время сна
practice_tests = np.random.randint(0, 20, n_samples) # Количество практических вопросов
# Генерация меток (баллов за экзамен) на основе линейной комбинации признаков плюс шум
exam_scores = (
5 * study_hours +
3 * sleep_hours +
2 * practice_tests +
np.random.normal(0, 10, n_samples)
)
# Убедитесь, что баллы находятся в диапазоне 0-100
exam_scores = np.clip(exam_scores, 0, 100)
# 2. Pandas: Создайте DataFrame и выполните обработку данных
df = pd.DataFrame({
'Study Time': study_hours,
'Sleep Time': sleep_hours,
'Number of Practice Questions': practice_tests,
'Exam Score': exam_scores
})
# Добавьте столбец с оценкой
df['Grade'] = pd.cut(df['Exam Score'],
bins=[0, 60, 70, 80, 90, 100],
labels=['F', 'D', 'C', 'B', 'A'])
print("Предварительный просмотр данных:")
print(df.head())
print(f"\nФорма данных: {df.shape}")
print(f"\nРаспределение оценок:")
print(df['Grade'].value_counts().sort_index())
# 3. Matplotlib: Визуализация данных
plt.figure(figsize=(15, 10))
# Подграфик 1: Распределение признака
plt.subplot(2, 3, 1)
df[['Study Time', 'Sleep Duration', 'Number of Practice Problems']].hist(bins=20, ax=plt.gca())
plt.title('Распределение признака')
# Подграфик 2: Распределение баллов
plt.subplot(2, 3, 2)
plt.hist(df['Exam Score'], bins=20, alpha=0.7, color='skyblue')
plt.title('Распределение баллов за экзамен')
plt.xlabel('Баллы')
plt.ylabel('Частота')
# Подграфик 3: Время учёбы и баллы
plt.subplot(2, 3, 3)
plt.scatter(df['Время учёбы'], df['Балл за экзамен'], альфа=0.6)
plt.xlabel('Время учёбы')
plt.ylabel('Балл за экзамен')
plt.title('Связь между временем учёбы и баллами')
# Подграфик 4: Продолжительность сна и баллы
plt.subplot(2, 3, 4)
plt.scatter(df['Продолжительность сна'], df['Балл за экзамен'], alpha=0.6, color='orange')
plt.xlabel('Продолжительность сна')
plt.ylabel('Балл за экзамен')
plt.title('Связь между продолжительностью сна и баллами')
# Подграфик 5: Количество практических задач и баллы
plt.subplot(2, 3, 5)
plt.scatter(df['Number of Practice Problems'], df['Exam Score'], alpha=0.6, color='green')
plt.xlabel('Количество практических задач')
plt.ylabel('Балл за экзамен')
plt.title('Связь между количеством практических задач и баллом')
# Подграфик 6: круговая диаграмма распределения оценок
plt.subplot(2, 3, 6)
grade_counts = df['Grade'].value_counts()
plt.pie(grade_counts.values, labels=grade_counts.index, autopct='%1.1f%%')
plt.title('Распределение оценок')
plt.tight_layout()
plt.show()
# 4. Scikit-learn: моделирование машинного обучения
from sklearn.linear_model import LinearRegression
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_squared_error, r2_score
# Подготовка данных
X = df[['Study Time', 'Sleep Duration', 'Number of Practice Problems']]
y = df['Exam Score']
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42
)
# Обучение модели линейной регрессии
lr_model = LinearRegression()
lr_model.fit(X_train, y_train)
lr_pred = lr_model.predict(X_test)
lr_mse = mean_squared_error(y_test, lr_pred)
lr_r2 = r2_score(y_test, lr_pred)
# Обучение модели случайного леса
rf_model = RandomForestRegressor(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)
rf_pred = rf_model.predict(X_test)
rf_mse = mean_squared_error(y_test, rf_pred)
rf_r2 = r2_score(y_test, rf_pred)
# Сравнение моделей
print("\n=== Сравнение моделей ===")
print(f"Линейная регрессия: MSE={lr_mse:.2f}, R²={lr_r2:.4f}")
print(f"Случайный лес: MSE={rf_mse:.2f}, R²={rf_r2:.4f}")
# Коэффициенты линейной регрессии
print(f"\nКоэффициенты линейной регрессии:")
for feature, coef in zip(X.columns, lr_model.coef_):
print(f"{feature}: {coef:.2f}")
# Важность признаков случайного леса
print(f"\nВажность признаков случайного леса:")
for feature, importance in zip(X.columns, rf_model.feature_importances_):
print(f"{feature}: {importance:.4f}")
# Визуализация результатов прогнозирования
plt.figure(figsize=(12, 5))
plt.subplot(1, 2, 1)
plt.scatter(y_test, lr_pred, alpha=0.6)
plt.plot([y_test.min(), y_test.max()], [y_test.min(), y_test.max()], 'r--')
plt.xlabel('Истинное значение')
plt.ylabel('Предсказанное значение')
plt.title('Результаты прогнозирования линейной регрессии')
plt.subplot(1, 2, 2)
plt.scatter(y_test, rf_pred, alpha=0.6)
plt.plot([y_test.min(), y_test.max()], [y_test.min(), y_test.max()], 'r--')
plt.xlabel('Истинное значение')
plt.ylabel('Предсказанное значение')
plt.title('Результаты прогнозирования случайного леса')
plt.tight_layout()
plt.show()
return {
'data': df,
'linear_model': lr_model,
'rf_model': rf_model,
'linear_metrics': {'mse': lr_mse, 'r2': lr_r2},
'rf_metrics': {'mse': rf_mse, 'r2': rf_r2}
}
# Запуск полного примера
results = four_libraries_integration()