Bibliothèques Python d'apprentissage automatique
Ce chapitre vous présentera les quatre bibliothèques Python essentielles en apprentissage automatique : NumPy, Pandas, Matplotlib et Scikit-learn.
Les bibliothèques d'apprentissage automatique sont comme une boîte à outils professionnelle, et chaque bibliothèque a un objectif spécifique ; utilisées ensemble, elles peuvent accomplir des tâches complexes d'apprentissage automatique.
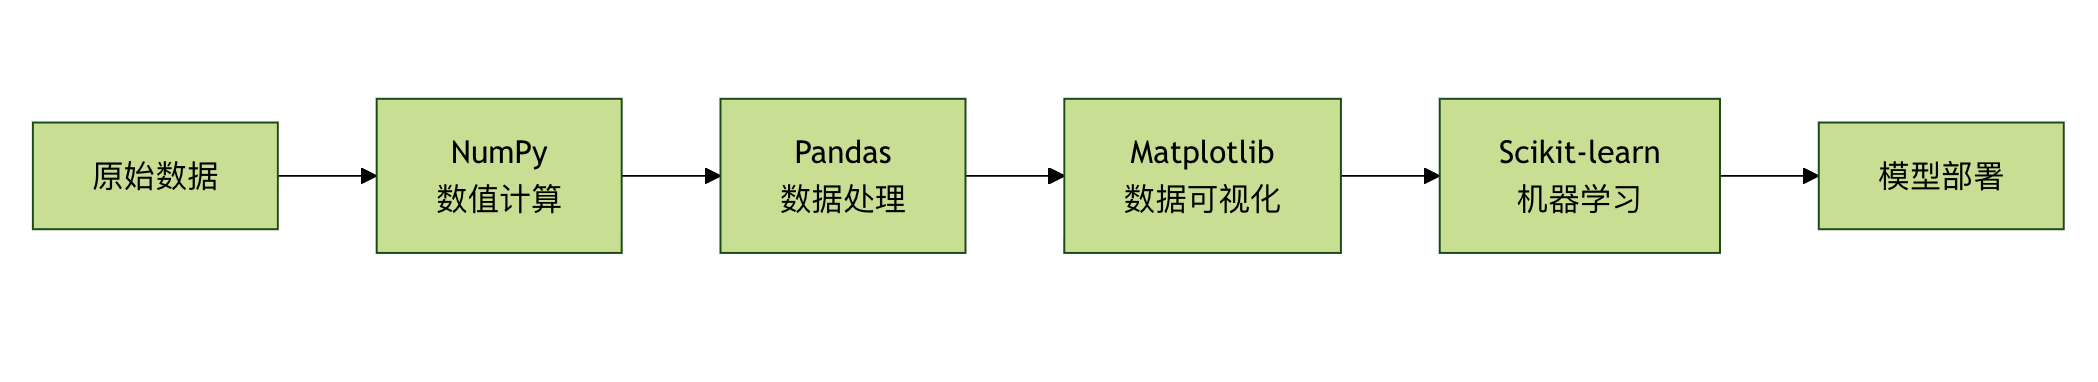
Rôles des quatre bibliothèques principales
- Numpy: le fondement du calcul numérique, fournissant des opérations efficaces sur les tableaux
- Pandas: l'outil affûté pour le traitement des données, fournissant des structures de données et des outils d'analyse
- Matplotlib: le pinceau de la visualisation de données, créant divers graphiques
- scikit-learn: le couteau suisse de l'apprentissage automatique, fournissant une chaîne d'outils ML complète
NumPy : le fondement du calcul numérique
Qu'est-ce que NumPy ?
NumPy est comme une calculatrice pour le calcul mathématique, mais il est infiniment plus puissant. Il s'agit de la bibliothèque fondamentale pour le calcul scientifique en Python, offrant des objets tableaux multidimensionnels efficaces.
Concepts fondamentaux de NumPy
1. Tableau
Exemple
import numpy as np
# Différentes façons de créer des tableaux
print("=== Création de tableau NumPy ===")
# Créer à partir d'une liste
arr1 = np.array([1, 2, 3, 4, 5])
print(f"Créé à partir de la liste : {arr1}")
# Créer un tableau de suite arithmétique
arr2 = np.arange(0, 10, 2) # 0 à 10, pas de 2
print(f"Tableau de suite arithmétique : {arr2}")
# Créer un tableau régulièrement espacé
arr3 = np.linspace(0, 1, 5) # 0 à 1, 5 points
print(f"Tableau régulièrement espacé : {arr3}")
# Créer des tableaux spéciaux
zeros_arr = np.zeros((2, 3)) # tableau 2x3 de zéros
ones_arr = np.ones((2, 3)) # tableau 2x3 de uns
identity_arr = np.eye(3) # matrice identité 3x3
print(f"Tableau de zéros :\n{zeros_arr}")
print(f"Tableau de uns :\n{ones_arr}")
print(f"Matrice identité :\n{identity_arr}")
2. Opérations sur les tableaux
Exemple
print("\n=== Opérations de base sur les tableaux ===)
# Attributs du tableau
arr = np.array([[1, 2, 3], [4, 5, 6]])
print(f"Tableau :"\n{arr}")
print(f"Forme : {arr.shape}")
print(f"Dimension : {arr.ndim}")
print(f"Nombre d'éléments : {arr.size}")
print(f"Type de données : {arr.dtype}")
# Indexation et découpage du tableau
print(f"Première ligne : {arr)
print(f"Première colonne : {arr[:, 0]}")
print(f"Élément [1,2] : {arr[1, 2]}")
# Opérations sur les tableaux
arr1 = np.array([1, 2, 3])
arr2 = np.array([4, 5, 6])
print(f"Addition : {arr1 + arr2}")
print(f"Multiplication : {arr1 * arr2}")
print(f"Produit scalaire : {np.dot(arr1, arr2)}")
# Fonctions statistiques
data = np.array([1, 2, 3, 4, 5, 6, 7, 8, 9, 10])
print(f"Moyenne : {np.mean(data)}")
print(f"Écart-type : {np.std(data)}")
print(f"Maximum : {np.max(data)}")
print(f"Minimum : {np.min(data)}")
print(f"Médiane : {np.median(data)}")
Exemple d'application pratique de NumPy
Exemple
def numpy_linear_regression():
"""Implémenter une régression linéaire simple avec NumPy"""
# Générer des données d'exemple
np.random.seed(42)
X = 2 * np.random.rand(100, 1) # Caractéristiques
y = 4 + 3 * X + np.random.randn(100, 1) # Étiquettes + bruit
# Ajouter x0 = 1 à X
X_b = np.c_[np.ones((100, 1)), X] # Ajouter le terme de biais
# Résoudre à l'aide de l'équation normale : θ = (X^T * X)^(-1) * X^T * y
theta_best = np.linalg.inv(X_b.T.dot(X_b)).dot(X_b.T).dot(y)
print("=== Exemple de régression linéaire avec NumPy ===")
print(f"Paramètres appris : ordonnée à l'origine={theta_best)
# Prédiction
X_new = np.array([[0], [2]])
X_new_b = np.c_[np.ones((2, 1)), X_new]
y_predict = X_new_b.dot(theta_best)
print(f"Prediction results: y={y_predict)
return theta_best, X, y
# Exécuter l'exemple
theta, X, y = numpy_linear_regression()
Pandas : L'outil tranchant pour le traitement des données
Qu'est-ce que Pandas ?
Pandas est comme le couteau suisse du traitement des données, fournissant des structures de données puissantes et des outils d'analyse de données, particulièrement adapté au traitement des données tabulaires.
Structures de données fondamentales de Pandas
1. Series (Données unidimensionnelles)
Exemple
import pandas as pd
print("=== Pandas Series ===")
# Créer une Series à partir d'une liste
s1 = pd.Series([1, 2, 3, 4, 5])
print(f"Créé à partir de la liste :\n{s1}")
# Series avec index
s2 = pd.Series([10, 20, 30], index=['a', 'b', 'c'])
print(f"\nSeries avec index :\n{s2}")
# Créer une Series à partir d'un dictionnaire
s3 = pd.Series({'Maths': 90, 'Anglais': 85, 'Physique': 88})
print(f"\nCréé à partir du dictionnaire :\n{s3}")
# Opérations sur les Series
print(f"\nAccès à l'élément : s2['b'] = {s2['b']}")
print(f"Découpage : s2[0:2] =\n{s2[0:2]}")
print(f"Informations statistiques :\n{s2.describe()}")
2. DataFrame (Données bidimensionnelles)
Exemple
print("\n=== Pandas DataFrame ===)
# Créer un DataFrame
data = {
'Name': ['Zhang San', 'Li Si', 'Wang Wu', 'Zhao Liu'],
'Age': [25, 30, 35, 28],
'Ville': ['Pékin', 'Shanghai', 'Canton', 'Shenzhen'],
'Salary': [15000, 20000, 18000, 22000]
}
df = pd.DataFrame(data)
print("DataFrame d'origine :")
print(df)
# Opérations de base sur DataFrame
print(f"\nDimensions du DataFrame : {df.shape}")
print(f"\nNoms des colonnes : {list(df.columns)}")
print(f"\nTypes de données :\n{df.dtypes}")
# Sélectionner les données
print(f"\nSélectionnez la colonne 'Name' :\n{df['Name']}")
print(f"\nSélectionnez les deux premières lignes :\n{df.head(2)}")
print(f"\nSélectionnez les lignes où l'âge est supérieur à 28 :\n{df[df['Age'] > 28]}")
# Informations statistiques
print(f"\nInformations statistiques pour les colonnes numériques :\n{df.describe()}")
# Ajouter une nouvelle colonne
df['Annual Salary'] = df['Salary'] * 12
print(f"\nAprès avoir ajouté la colonne du salaire annuel :\n{df}")
Exemple de traitement des données avec Pandas
Exemple
def pandas_data_processing():
"""Démontrer le flux de travail complet de traitement des données avec Pandas"""
print("=== Exemple de traitement de données avec Pandas ===")
# 1. Créer des données d'exemple
np.random.seed(42)
n_samples = 1000
data = {
'Student ID': range(1, n_samples + 1),
'Name': [f'Student {i}' for i in range(1, n_samples + 1)],
'Age': np.random.randint(18, 25, n_samples),
'Genre': np.random.choice(['Homme', 'Femme'], n_samples),
'Math Score': np.random.normal(75, 15, n_samples),
'English Score': np.random.normal(80, 12, n_samples),
'Physics Score': np.random.normal(72, 18, n_samples),
'Class': np.random.choice(['Class 1', 'Class 2', 'Class 3'], n_samples)
}
df = pd.DataFrame(data)
# 2. Nettoyage des données
print("Dimensions des données d'origine :", df.shape)
# Gérer les valeurs aberrantes (les scores doivent être compris entre 0 et 100)
score_columns = ['Math Score', 'English Score', 'Physics Score']
for col in score_columns:
df[col] = df[col].clip(0, 100)
# 3. Ingénierie des fonctionnalités
# Calculer le score total et le score moyen
df['Total Score'] = df[score_columns].sum(axis=1)
df['Average Score'] = df[score_columns].mean(axis=1)
# Ajouter la note
def get_grade(score):
if score >= 90:
return 'A'
elif score >= 80:
return 'B'
elif score >= 70:
return 'C'
elif score >= 60:
return 'D'
else:
return 'F'
df['Grade'] = df['Average Score'].apply(get_grade)
# 4. Analyse des données
print("\n=== Résultats de l'analyse des données ===)
# Statistiques de base
print("Scores moyens par matière :")
print(df[score_columns].mean())
# Analyser par classe
print("\nScore moyen par classe :")
class_avg = df.groupby('Class')['Average Score'].mean()
print(class_avg)
# Analyser par genre
print("\nRépartition par genre:")
gender_count = df['Gender'].value_counts()
print(gender_count)
# Répartition des notes
print("\nRépartition des notes:")
grade_dist = df['Grade'].value_counts().sort_index()
print(grade_dist)
# 5. Filtrage des données
print("\n=== Filtrage spécifique des données ===)
# Étudiants excellents (score moyen > 85)
excellent_students = df[df['Average Score'] > 85].head(5)
print("Étudiants excellents (Top 5):")
print(excellent_students[['Name', 'Average Score', 'Grade']])
# Étudiant avec la meilleure moyenne dans chaque classe
print("\nÉtudiant avec la meilleure moyenne dans chaque classe :")
top_students = df.loc[df.groupby('Class')['Average Score'].idxmax()]
print(top_students[['Class', 'Name', 'Average Score']])
return df
# Exemple d'exécution
student_df = pandas_data_processing()
Matplotlib : Le pinceau de la visualisation de données
Qu'est-ce que Matplotlib ?
Matplotlib est comme le pinceau d'un artiste des données, qui peut convertir des données ternes en graphiques intuitifs, nous aidant à comprendre les motifs et les relations dans les données.
Graphiques de base dans Matplotlib
Exemple
import matplotlib.pyplot as plt
import numpy as np
# Définir la police chinoise (empêcher les caractères chinois de s'afficher sous forme de carrés)
plt.rcParams['font.sans-serif'] = ['SimHei', 'Arial Unicode MS']
plt.rcParams['axes.unicode_minus'] = False
def matplotlib_basic_charts():
"""Démontrer les graphiques de base de Matplotlib"""
print("=== Exemple de graphique de base Matplotlib ===")
# 1. Graphique en courbes
plt.figure(figsize=(12, 8))
plt.subplot(2, 3, 1)
x = np.linspace(0, 10, 100)
y1 = np.sin(x)
y2 = np.cos(x)
plt.plot(x, y1, label='sin(x)')
plt.plot(x, y2, label='cos(x)')
plt.title('Fonctions trigonométriques')
plt.xlabel('x')
plt.ylabel('y')
plt.legend()
plt.grid(True)
# 2. Nuage de points
plt.subplot(2, 3, 2)
np.random.seed(42)
x = np.random.randn(100)
y = 2 * x + np.random.randn(100) * 0.5
plt.scatter(x, y, alpha=0.6, c='blue')
plt.title('Nuage de points')
plt.xlabel('X')
plt.ylabel('Y')
# 3. Diagramme à barres
plt.subplot(2, 3, 3)
categories = ['A', 'B', 'C', 'D', 'E']
values = [23, 45, 56, 78, 32]
plt.bar(categories, values, color=['red', 'green', 'blue', 'orange', 'purple'])
plt.title('Diagramme à barres')
plt.xlabel('Catégorie')
plt.ylabel('Valeur')
# 4. Histogramme
plt.subplot(2, 3, 4)
data = np.random.normal(100, 15, 1000)
plt.hist(data, bins=30, alpha=0.7, color='skyblue', edgecolor='black')
plt.title('Histogramme')
plt.xlabel('Valeur')
plt.ylabel('Fréquence')
# 5. Diagramme circulaire
plt.subplot(2, 3, 5)
sizes = [30, 25, 20, 15, 10]
labels = ['A', 'B', 'C', 'D', 'E']
colors = ['gold', 'lightcoral', 'lightskyblue', 'lightgreen', 'plum']
plt.pie(sizes, labels=labels, colors=colors, autopct='%1.1f%%', startangle=90)
plt.title('Diagramme circulaire')
# 6. Boîte à moustaches
plt.subplot(2, 3, 6)
data1 = np.random.normal(0, 1, 100)
data2 = np.random.normal(2, 1, 100)
data3 = np.random.normal(-2, 1, 100)
plt.boxplot([data1, data2, data3], labels=['Groupe 1', 'Groupe 2', 'Groupe 3'])
plt.title('Boîte à moustaches')
plt.ylabel('Valeur')
plt.tight_layout()
plt.show()
print("Graphique affiché !")
# Exemple d'exécution
matplotlib_basic_charts()
Exemple de visualisation avancée
Exemple
def advanced_visualization():
"""Démontrer des techniques de visualisation avancées"""
print("=== Exemple de visualisation avancée ===")
# Créer des données plus complexes
np.random.seed(42)
n_points = 200
# Générer des données corrélées
x = np.random.randn(n_points)
y = 2 * x + np.random.randn(n_points) * 0.5
colors = np.random.rand(n_points)
sizes = 1000 * np.random.rand(n_points)
# 1. Diagramme à bulles
plt.figure(figsize=(15, 5))
plt.subplot(1, 3, 1)
scatter = plt.scatter(x, y, c=colors, s=sizes, alpha=0.6, cmap='viridis')
plt.colorbar(scatter, label='Valeur de couleur')
plt.title('Diagramme à bulles')
plt.xlabel('X')
plt.ylabel('Y')
# 2. Carte de chaleur
plt.subplot(1, 3, 2)
data = np.random.randn(10, 10)
im = plt.imshow(data, cmap='coolwarm', aspect='auto')
plt.colorbar(im, label='Valeur')
plt.title('Carte de chaleur')
# 3. Combinaison de sous-graphiques
plt.subplot(1, 3, 3)
# Créer des sous-graphiques
gs = plt.GridSpec(2, 2, subplot_kw={'projection': 'polar'})
ax1 = plt.subplot(gs[0, 0])
theta = np.linspace(0, 2*np.pi, 100)
r = np.sin(3*theta)
ax1.plot(theta, r)
ax1.set_title('Graphique polaire')
ax2 = plt.subplot(gs[0, 1])
categories = ['A', 'B', 'C', 'D']
values = [15, 30, 45, 10]
ax2.bar(categories, values)
ax2.set_title('Diagramme à barres')
ax3 = plt.subplot(gs[1, :])
x_line = np.linspace(0, 10, 100)
y_line1 = np.sin(x_line)
y_line2 = np.cos(x_line)
ax3.plot(x_line, y_line1, label='sin')
ax3.plot(x_line, y_line2, label='cos')
ax3.set_title('Graphique combiné')
ax3.legend()
plt.tight_layout()
plt.show()
print("Graphique avancé affiché !")
# Exemple d'exécution
advanced_visualization()
Scikit-learn : le couteau suisse de l'apprentissage automatique
Qu'est-ce que Scikit-learn ?
Scikit-learn est comme une boîte à outils pour l'apprentissage automatique, offrant une chaîne d'outils complète du prétraitement des données à l'entraînement et à l'évaluation des modèles, et constitue la norme de facto pour l'apprentissage automatique en Python.
Fonctionnalités principales de Scikit-learn
Exemple
from sklearn.datasets import make_classification, load_iris
from sklearn.model_selection import train_test_split
from sklearn.preprocessing import StandardScaler, LabelEncoder
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.svm import SVC
from sklearn.metrics import accuracy_score, classification_report, confusion_matrix
def scikit_learn_basics():
"""Démontrer les fonctionnalités essentielles de Scikit-learn"""
print("=== Exemple des fonctionnalités essentielles de Scikit-learn ===")
# 1. Génération des données
X, y = make_classification(
n_samples=1000,
n_features=20,
n_classes=3,
n_informative=15,
random_state=42
)
print(f"Forme des données : X={X.shape}, y={y.shape}")
print(f"Distribution des classes : {np.bincount(y)}")
# 2. Division des données
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42, stratify=y
)
print(f"Taille de l'ensemble d'entraînement : {X_train.shape)
print(f"Taille de l'ensemble de test : {X_test.shape)
# 3. Prétraitement des données
scaler = StandardScaler()
X_train_scaled = scaler.fit_transform(X_train)
X_test_scaled = scaler.transform(X_test)
print("Standardisation des données terminée")
# 4. Entraînement et comparaison de modèles
models = {
'Régression logistique': LogisticRegression(random_state=42),
'Forêt aléatoire': RandomForestClassifier(n_estimators=100, random_state=42),
'Machine à vecteurs de support': SVC(random_state=42)
}
results = {}
for name, model in models.items():
print(f"\nEntraînement de {name}...")
# Entraîner le modèle
model.fit(X_train_scaled, y_train)
# Prédire
y_pred = model.predict(X_test_scaled)
# Évaluer
accuracy = accuracy_score(y_test, y_pred)
results[name] = accuracy
print(f"{name} Exactitude : {accuracy:.4f}")
print(f"Rapport de classification :\n{classification_report(y_test, y_pred)}")
# 5. Comparaison des résultats
print("\n=== Comparaison des modèles === ")
for name, accuracy in results.items():
print(f"{name}: {accuracy:.4f}")
best_model = max(results, key=results.get)
print(f"\nMeilleur modèle : {best_model}")
return models[best_model]
# Exemple d'exécution
best_model = scikit_learn_basics()
Flux de travail complet d'apprentissage automatique
Exemple
def complete_ml_pipeline():
"""Démontrer le flux de travail complet d'apprentissage automatique"""
print("=== Flux de travail complet d'apprentissage automatique ===")
# 1. Charger les données
iris = load_iris()
X = iris.data
y = iris.target
feature_names = iris.feature_names
target_names = iris.target_names
print(f"Jeu de données : {iris.DESCR.split('\n')[0]}")
print(f"Nombre de caractéristiques : {len(feature_names)}")
print(f"Nombre de classes : {len(target_names)}")
# 2. Exploration des données
df = pd.DataFrame(X, columns=feature_names)
df['target'] = y
print("\nAperçu des données :")
print(df.head())
print("\nStatistiques des données :")
print(df.describe())
# 3. Visualisation des données
plt.figure(figsize=(12, 4))
plt.subplot(1, 2, 1)
for i, target_name in enumerate(target_names):
plt.scatter(
df[df['target'] == i]['sepal length (cm)'],
df[df['target'] == i]['sepal width (cm)'],
label=target_name
)
plt.xlabel('Longueur du sépale')
plt.ylabel('Largeur du sépale')
plt.title('Distribution de la taille des sépales')
plt.legend()
plt.subplot(1, 2, 2)
for i, target_name in enumerate(target_names):
plt.scatter(
df[df['target'] == i]['petal length (cm)'],
df[df['target'] == i]['petal width (cm)'],
label=target_name
)
plt.xlabel('Longueur des pétales')
plt.ylabel('Largeur des pétales')
plt.title('Distribution de la taille des pétales')
plt.legend()
plt.tight_layout()
plt.show()
# 4. Préparation des données
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.3, random_state=42, stratify=y
)
# 5. Entraînement du modèle
from sklearn.ensemble import RandomForestClassifier
model = RandomForestClassifier(n_estimators=100, random_state=42)
model.fit(X_train, y_train)
# 6. Évaluation du modèle
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f"\nExactitude du modèle : {accuracy:.4f}")
print("\nMatrice de confusion :")
print(confusion_matrix(y_test, y_pred))
print("\nRapport de classification :")
print(classification_report(y_test, y_pred, target_names=target_names))
# 7. Importance des variables
feature_importance = model.feature_importances_
feature_df = pd.DataFrame({
'Variable': feature_names,
'Importance': feature_importance
}).sort_values('Importance', ascending=False)
print("\nImportance des variables :")
print(feature_df)
# 8. Visualisation de l'importance des caractéristiques
plt.figure(figsize=(8, 4))
plt.bar(feature_df['Feature'], feature_df['Importance'])
plt.title('Importance des caractéristiques')
plt.xlabel('Caractéristique')
plt.ylabel('Importance')
plt.xticks(rotation=45)
plt.tight_layout()
plt.show()
return model, feature_df
# Exemple d'exécution
trained_model, feature_importance = complete_ml_pipeline()
Exemple de collaboration des quatre bibliothèques
Exemple
def four_libraries_integration():
"""Démontrer la collaboration de NumPy, Pandas, Matplotlib et Scikit-learn"""
print("=== Exemple de collaboration entre quatre bibliothèques ===")
# 1. NumPy : Générer des données simulées
np.random.seed(42)
n_samples = 500
# Générer des caractéristiques
study_hours = np.random.uniform(1, 10, n_samples) # Temps d'étude
sleep_hours = np.random.uniform(5, 9, n_samples) # Temps de sommeil
practice_tests = np.random.randint(0, 20, n_samples) # Nombre de questions d'entraînement
# Générer les étiquettes (notes d'examen), à partir d'une combinaison linéaire des caractéristiques plus du bruit
exam_scores = (
5 * study_hours +
3 * sleep_hours +
2 * practice_tests +
np.random.normal(0, 10, n_samples)
)
# S'assurer que les scores sont dans la plage 0-100
exam_scores = np.clip(exam_scores, 0, 100)
# 2. Pandas : Créer un DataFrame et effectuer le traitement des données
df = pd.DataFrame({
'Study Time': study_hours,
'Sleep Time': sleep_hours,
'Number of Practice Questions': practice_tests,
'Exam Score': exam_scores
})
# Ajouter une colonne de note
df['Grade'] = pd.cut(df['Exam Score'],
bins=[0, 60, 70, 80, 90, 100],
labels=['F', 'D', 'C', 'B', 'A'])
print("Aperçu des données :")
print(df.head())
print(f"\nDimensions des données : {df.shape}")
print(f"\nDistribution des notes :")
print(df['Grade'].value_counts().sort_index())
# 3. Matplotlib : Visualisation de données
plt.figure(figsize=(15, 10))
# Sous-graphique 1 : Distribution des caractéristiques
plt.subplot(2, 3, 1)
df[['Study Time', 'Sleep Duration', 'Number of Practice Problems']].hist(bins=20, ax=plt.gca())
plt.title('Distribution des caractéristiques')
# Sous-graphique 2 : Distribution des scores
plt.subplot(2, 3, 2)
plt.hist(df['Exam Score'], bins=20, alpha=0.7, color='skyblue')
plt.title('Distribution des scores d'examen')
plt.xlabel('Note')
plt.ylabel('Fréquence')
# Sous-graphique 3 : Temps d'étude vs note
plt.subplot(2, 3, 3)
plt.scatter(df['Temps d'étude'], df['Note d'examen'], alpha=0.6)
plt.xlabel('Temps d'étude')
plt.ylabel('Note d'examen')
plt.title('Relation entre le temps d'étude et la note')
# Sous-graphique 4 : Durée de sommeil vs note
plt.subplot(2, 3, 4)
plt.scatter(df['Durée de sommeil'], df['Note d'examen'], alpha=0.6, color='orange')
plt.xlabel('Durée de sommeil')
plt.ylabel('Note d'examen')
plt.title('Relation entre la durée de sommeil et la note')
# Sous-graphique 5 : Nombre d'exercices pratiques vs note
plt.subplot(2, 3, 5)
plt.scatter(df['Nombre d'exercices pratiques'], df['Score d'examen'], alpha=0.6, color='green')
plt.xlabel('Nombre d'exercices pratiques')
plt.ylabel('Note d'examen')
plt.title('Relation entre les exercices pratiques et le score')
# Sous-graphique 6 : Diagramme circulaire de répartition des notes
plt.subplot(2, 3, 6)
grade_counts = df['Note'].value_counts()
plt.pie(grade_counts.values, labels=grade_counts.index, autopct='%1.1f%%')
plt.title('Répartition des notes')
plt.tight_layout()
plt.show()
# 4. Scikit-learn : Modélisation d'apprentissage automatique
from sklearn.linear_model import LinearRegression
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_squared_error, r2_score
# Préparer les données
X = df[['Study Time', 'Sleep Duration', 'Number of Practice Problems']]
y = df['Score d'examen']
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.2, random_state=42
)
# Entraîner le modèle de régression linéaire
lr_model = LinearRegression()
lr_model.fit(X_train, y_train)
lr_pred = lr_model.predict(X_test)
lr_mse = mean_squared_error(y_test, lr_pred)
lr_r2 = r2_score(y_test, lr_pred)
# Entraîner le modèle de forêt aléatoire
rf_model = RandomForestRegressor(n_estimators=100, random_state=42)
rf_model.fit(X_train, y_train)
rf_pred = rf_model.predict(X_test)
rf_mse = mean_squared_error(y_test, rf_pred)
rf_r2 = r2_score(y_test, rf_pred)
# Comparaison de modèles
print("\n=== Comparaison de modèles ===")
print(f"Régression linéaire: MSE={lr_mse:.2f}, R²={lr_r2:.4f}")
print(f"Forêt aléatoire: MSE={rf_mse:.2f}, R²={rf_r2:.4f}")
# Coefficients de régression linéaire
print(f"\nCoefficients de régression linéaire:")
for feature, coef in zip(X.columns, lr_model.coef_):
print(f"{feature}: {coef:.2f}")
# Importance des caractéristiques de la forêt aléatoire
print(f"\nImportance des caractéristiques de la forêt aléatoire:")
for feature, importance in zip(X.columns, rf_model.feature_importances_):
print(f"{feature}: {importance:.4f}")
# Visualisation des résultats de prédiction
plt.figure(figsize=(12, 5))
plt.subplot(1, 2, 1)
plt.scatter(y_test, lr_pred, alpha=0.6)
plt.plot([y_test.min(), y_test.max()], [y_test.min(), y_test.max()], 'r--')
plt.xlabel('Score réel')
plt.ylabel('Score prédit')
plt.title('Résultats de prédiction de la régression linéaire')
plt.subplot(1, 2, 2)
plt.scatter(y_test, rf_pred, alpha=0.6)
plt.plot([y_test.min(), y_test.max()], [y_test.min(), y_test.max()], 'r--')
plt.xlabel('Score réel')
plt.ylabel('Score prédit')
plt.title('Résultats de prédiction de la forêt aléatoire')
plt.tight_layout()
plt.show()
return {
'data': df,
'linear_model': lr_model,
'rf_model': rf_model,
'linear_metrics': {'mse': lr_mse, 'r2': lr_r2},
'rf_metrics': {'mse': rf_mse, 'r2': rf_r2}
}
# Exécuter un exemple complet
results = four_libraries_integration()