Régression logistique
La régression logistique est une méthode d'apprentissage statistique largement utilisée pour les problèmes de classification. Malgré la présence de "régression" dans son nom, il s'agit en réalité d'un algorithme pour les problèmes de classification binaire ou multiclasse.
La régression logistique utilise une fonction logistique (également appelée fonction sigmoïde) pour mapper la sortie de la régression linéaire entre 0 et 1, prédisant ainsi la probabilité qu'un certain événement se produise.
La régression logistique est largement utilisée dans divers problèmes de classification, tels que :
- Détection de spam (spam / non spam)
- Prédiction de maladie (maladie / pas de maladie)
- Prédiction de l'attrition client (attrition / pas d'attrition)
Modèle de régression logistique

Fonction de perte
La fonction de perte de la régression logistique est la Log Loss, dont la forme est la suivante :

Résolution par descente de gradient
Comme la régression linéaire, la régression logistique utilise généralement aussi la descente de gradient pour optimiser la fonction de perte et déterminer les paramètres w et b. Les règles de mise à jour du gradient pour la régression logistique sont les suivantes :

En mettant continuellement à jour w et b jusqu’à ce que la fonction de perte converge.
Implémentation de la régression logistique avec Python
Ensuite, nous allons utiliser Python et la bibliothèque Scikit-learn pour implémenter un modèle de régression logistique simple.
1. Importer les bibliothèques nécessaires
Exemple
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
2. Charger le jeu de données
Nous allons utiliser le jeu de données Iris fourni avec Scikit-learn. Le jeu de données Iris contient 150 échantillons, chacun avec 4 caractéristiques, et l’objectif est de classer les échantillons en 3 classes. Pour simplifier le problème, nous utilisons uniquement les deux premières caractéristiques et transformons le problème en un problème de classification binaire.
Exemple
iris = load_iris()
X = iris.data[:, :2] # Utiliser uniquement les deux premières caractéristiques
y = (iris.target != 0) * 1 # Convertir la cible en problème de classification binaire
# Diviser les ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
3. Entraîner le modèle de régression logistique
Exemple
model = LogisticRegression()
# Entraîner le modèle
model.fit(X_train, y_train)
4. Évaluation du modèle
Exemple
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
# Charger le jeu de données
iris = load_iris()
X = iris.data[:, :2] # Utiliser uniquement les deux premières caractéristiques
y = (iris.target != 0) * 1 # Convertir la cible en problème de classification binaire
# Diviser les ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Créer le modèle de régression logistique
model = LogisticRegression()
# Entraîner le modèle
model.fit(X_train, y_train)
# Prédire l'ensemble de test
y_pred = model.predict(X_test)
# Calculer la précision
accuracy = accuracy_score(y_test, y_pred)
print(f"Exactitude du modèle : {accuracy:.2f}")
# Matrice de confusion
conf_matrix = confusion_matrix(y_test, y_pred)
print("Matrice de confusion :")
print(conf_matrix)
# Rapport de classification
class_report = classification_report(y_test, y_pred)
print("Rapport de classification :")
print(class_report)
La sortie est :
模型准确率: 1.00
混淆矩阵:
[[19  0]
 [ 0 26]]
分类报告:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00        19
           1       1.00      1.00      1.00        26

    accuracy                           1.00        45
   macro avg       1.00      1.00      1.00        45
weighted avg       1.00      1.00      1.00        45
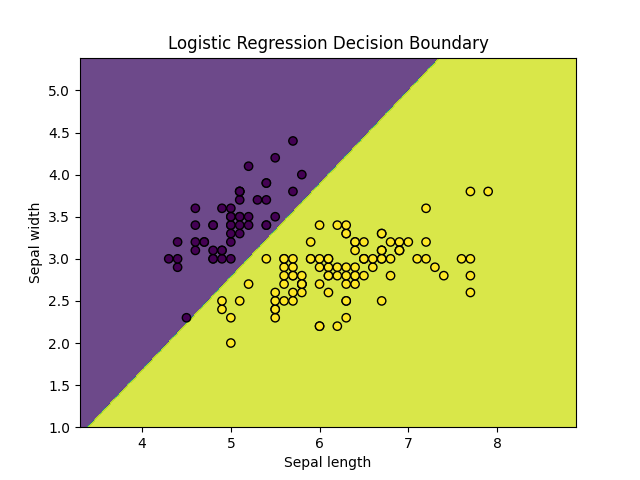
5. Visualiser la frontière de décision
Exemple
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
# Charger le jeu de données
iris = load_iris()
X = iris.data[:, :2] # Utiliser uniquement les deux premières caractéristiques
y = (iris.target != 0) * 1 # Convertir la cible en problème de classification binaire
# Diviser les ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Créer le modèle de régression logistique
model = LogisticRegression()
# Entraîner le modèle
model.fit(X_train, y_train)
# Prédire l'ensemble de test
y_pred = model.predict(X_test)
# Visualiser la frontière de décision
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, 0.01),
np.arange(y_min, y_max, 0.01))
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
plt.contourf(xx, yy, Z, alpha=0.8)
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o')
plt.xlabel('Longueur du sépale')
plt.ylabel('Largeur du sépale')
plt.title('Frontière de décision de la régression logistique')
plt.show()
Affiché comme suit :
Résumé
- La régression logistique utilise la fonction sigmoïde pour convertir la sortie de la régression linéaire en valeurs de probabilité, et est utilisée pour résoudre des problèmes de classification binaire.
- Le processus d'entraînement de la régression logistique optimise les paramètres du modèle en minimisant la fonction de perte logarithmique.
- La descente de gradient est une méthode d'optimisation couramment utilisée pour mettre à jour les paramètres du modèle.et。
- En Python, la
scikit-learnbibliothèque fournit une interface simple et facile à utiliser pour implémenter la régression logistique, et facilite l'entraînement, l'évaluation et la visualisation des modèles.