Логистическая регрессия
Логистическая регрессия — это метод статистического обучения, широко используемый для задач классификации. Несмотря на наличие "регрессии" в названии, на самом деле это алгоритм для задач бинарной или многоклассовой классификации.
Логистическая регрессия использует логистическую функцию (также называемую сигмоидной функцией) для отображения выхода линейной регрессии в диапазон от 0 до 1, тем самым предсказывая вероятность наступления определённого события.
Логистическая регрессия широко используется в различных задачах классификации, таких как:
- Обнаружение спама (спам / не спам)
- Прогнозирование заболеваний (заболевание / нет заболевания)
- Прогнозирование оттока клиентов (отток / нет оттока)
Модель логистической регрессии

Функция потерь
Функция потерь логистической регрессии — это Log Loss, которая имеет следующий вид:

Решение с помощью градиентного спуска
Как и линейная регрессия, логистическая регрессия обычно также использует градиентный спуск для оптимизации функции потерь и нахождения параметров w и b. Правила обновления градиента для логистической регрессии следующие:

Путём непрерывного обновления w и b до сходимости функции потерь.
Реализация логистической регрессии на Python
Далее мы будем использовать Python и библиотеку Scikit-learn для реализации простой модели логистической регрессии.
1. Импорт необходимых библиотек
Пример
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
2. Загрузка набора данных
Мы будем использовать набор данных Iris, входящий в Scikit-learn. Набор данных Iris содержит 150 образцов, каждый с 4 признаками, и цель состоит в том, чтобы классифицировать образцы по 3 классам. Чтобы упростить задачу, мы используем только первые два признака и преобразуем задачу в задачу бинарной классификации.
Пример
iris = load_iris()
X = iris.data[:, :2] # Использовать только первые два признака
y = (iris.target != 0) * 1 # Преобразовать target в задачу бинарной классификации
# Разделить обучающую и тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
3. Обучение модели логистической регрессии
Пример
model = LogisticRegression()
# Обучите модель
model.fit(X_train, y_train)
4. Оценка модели
Пример
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
# Загрузить набор данных
iris = load_iris()
X = iris.data[:, :2] # Использовать только первые два признака
y = (iris.target != 0) * 1 # Преобразовать target в задачу бинарной классификации
# Разделить обучающую и тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Создать модель логистической регрессии
model = LogisticRegression()
# Обучите модель
model.fit(X_train, y_train)
# Предсказание на тестовом наборе
y_pred = model.predict(X_test)
# Вычислите точность
accuracy = accuracy_score(y_test, y_pred)
print(f"Точность модели: {accuracy:.2f}")
# Матрица ошибок
conf_matrix = confusion_matrix(y_test, y_pred)
print("Матрица ошибок:")
print(conf_matrix)
# Отчёт о классификации
class_report = classification_report(y_test, y_pred)
print("Отчёт о классификации:")
print(class_report)
Вывод:
模型准确率: 1.00
混淆矩阵:
[[19  0]
 [ 0 26]]
分类报告:
              precision    recall  f1-score   support

           0       1.00      1.00      1.00        19
           1       1.00      1.00      1.00        26

    accuracy                           1.00        45
   macro avg       1.00      1.00      1.00        45
weighted avg       1.00      1.00      1.00        45
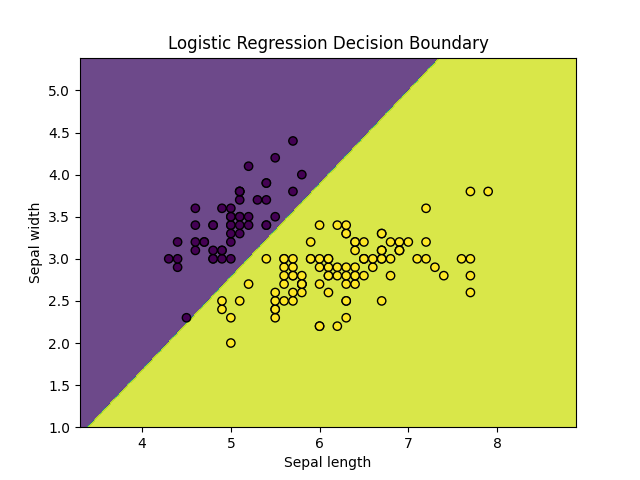
5. Визуализация границы решения
Пример
import matplotlib.pyplot as plt
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import accuracy_score, confusion_matrix, classification_report
# Загрузить набор данных
iris = load_iris()
X = iris.data[:, :2] # Использовать только первые два признака
y = (iris.target != 0) * 1 # Преобразовать target в задачу бинарной классификации
# Разделить обучающую и тестовую выборки
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Создать модель логистической регрессии
model = LogisticRegression()
# Обучите модель
model.fit(X_train, y_train)
# Предсказание на тестовом наборе
y_pred = model.predict(X_test)
# Визуализация границы решения
x_min, x_max = X[:, 0].min() - 1, X[:, 0].max() + 1
y_min, y_max = X[:, 1].min() - 1, X[:, 1].max() + 1
xx, yy = np.meshgrid(np.arange(x_min, x_max, 0.01),
np.arange(y_min, y_max, 0.01))
Z = model.predict(np.c_[xx.ravel(), yy.ravel()])
Z = Z.reshape(xx.shape)
plt.contourf(xx, yy, Z, alpha=0.8)
plt.scatter(X[:, 0], X[:, 1], c=y, edgecolors='k', marker='o')
plt.xlabel('Длина чашелистика')
plt.ylabel('Ширина чашелистика')
plt.title('Граница решения логистической регрессии')
plt.show()
Отображается следующим образом:
Итог
- Логистическая регрессия использует сигмоидную функцию для преобразования выхода линейной регрессии в значения вероятности и применяется для решения задач бинарной классификации.
- Процесс обучения логистической регрессии оптимизирует параметры модели путем минимизации функции логарифмических потерь.
- Градиентный спуск — часто используемый метод оптимизации для обновления параметров модели.и。
- В Python,
scikit-learnбиблиотека предоставляет простой и удобный в использовании интерфейс для реализации логистической регрессии и позволяет легко обучать, оценивать и визуализировать модели.