Aprendizaje por refuerzo profundo
El aprendizaje por refuerzo profundo es un campo interdisciplinario emocionante en inteligencia artificial; podemos descomponerlo en dos partes para entenderlo:
Aprendizaje por refuerzoEs la idea central; simula el proceso de aprendizaje de humanos o animales mediante 'prueba y error'. Imaginemos enseñar a un cachorro una nueva orden: cuando lo hace bien, le das una golosina como recompensa; cuando lo hace mal, no hay recompensa o incluso puede haber un leve castigo. Después de muchos intentos, el cachorro aprende a realizar la acción correcta en una situación particular para obtener una recompensa. El agente en el aprendizaje por refuerzo es como este cachorro; interactúa con el entorno y ajusta su política de comportamiento según las recompensas obtenidas.
Aprendizaje profundoEs una herramienta poderosa. Cuando el entorno al que se enfrenta el aprendizaje por refuerzo es muy complejo (como imágenes de videojuegos o datos de sensores de robots), los métodos matemáticos tradicionales tienen dificultades para extraer directamente características útiles para tomar decisiones. El aprendizaje profundo, especialmente las redes neuronales profundas, es hábil para procesar estos datos originales de alta dimensión y complejos (como imágenes y sonido), y puede aprender automáticamente representaciones de características jerárquicas de los datos.
Por lo tanto,Aprendizaje por refuerzo profundo = marco de decisión del aprendizaje por refuerzo + capacidad de percepción y representación del aprendizaje profundoPermite que el agente aprenda directamente de entradas originales complejas (como píxeles) cómo tomar las acciones óptimas para lograr objetivos a largo plazo.
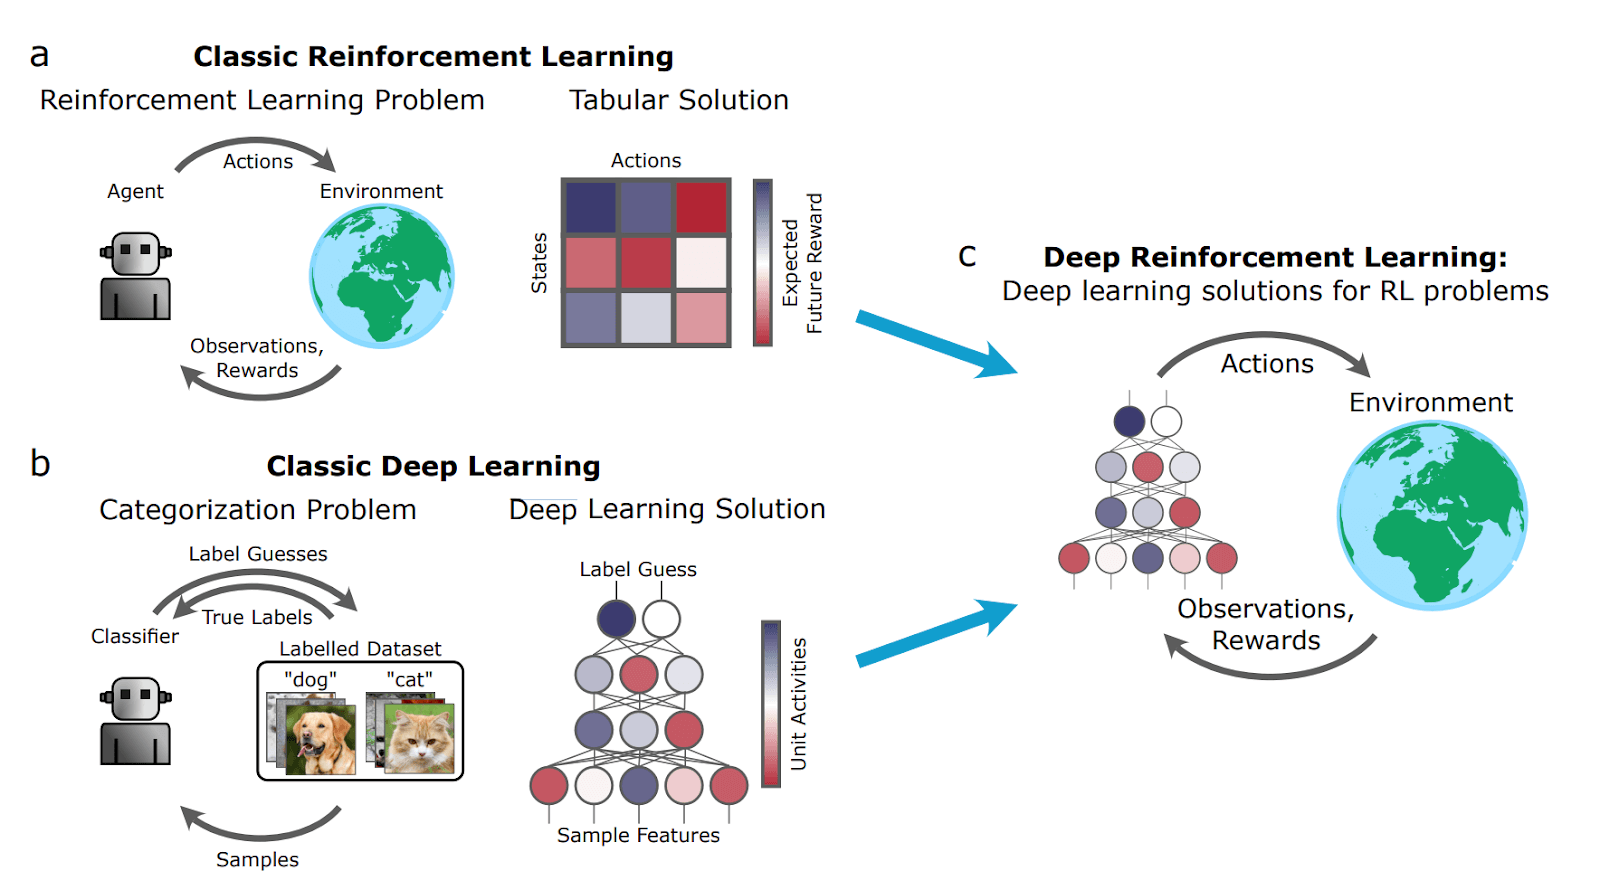
Conceptos clave y marco básico
Para entender el aprendizaje por refuerzo profundo, primero es necesario dominar los roles clave en su marco básico y las relaciones entre ellos.
Elementos básicos del aprendizaje por refuerzo
Agente (Agent)
- RolAprendiz y tomador de decisiones.
- ResponsabilidadObserva el estado del entorno, selecciona acciones según la política aprendida, ejecuta las acciones y recibe retroalimentación del entorno (nuevo estado y recompensa).
Entorno (Environment)
- RolTodo lo externo con lo que interactúa el agente.
- ResponsabilidadRecibe las acciones del agente, actualiza su propio estado y otorga las recompensas correspondientes.
Estado (State, s)
- DefiniciónLa descripción de la situación específica del entorno en un momento dado. En el aprendizaje por refuerzo profundo, el estado suele ser de alta dimensión, como un fotograma de un juego.
Acción (Action, a)
- DefiniciónLas opciones que el agente puede tomar en un estado dado. Por ejemplo, en un juego pueden ser 'arriba', 'izquierda', 'disparar', etc.
Recompensa (Reward, r)
- DefiniciónLa señal de retroalimentación inmediata del entorno a las acciones del agente, un valor escalar. La recompensa es la 'brújula' del aprendizaje del agente; su objetivo es maximizar la recompensa acumulada a largo plazo.
Política (Policy, π)
- DefiniciónEs la regla de comportamiento del agente, una función de mapeo del estado a la acción. Indica al agente qué acción debe tomar en qué estado. La política puede ser determinista (
a = π(s)), o estocástica (a ~ π(a|s))。
- DefiniciónEs la regla de comportamiento del agente, una función de mapeo del estado a la acción. Indica al agente qué acción debe tomar en qué estado. La política puede ser determinista (
Función de valor
- DefiniciónSe utiliza para evaluar la calidad de un estado o de un par estado-acción. Representa lo que se puede obtener en el futuro a partir del estado actual (o después de ejecutar la acción actual),recompensa acumulada esperada。
- Función de valor de estado V(s)En el estado
ssiguiendo la política actual, se puede obtener la recompensa esperada. - Función de valor de acción Q(s, a)En el estado
sejecutar la accióna, luego, siguiendo la política actual, se puede obtener la recompensa esperada.
Proceso de interacción
La interacción entre el agente y el entorno es un proceso cíclico continuo, que se puede representar claramente con el siguiente diagrama de flujo:
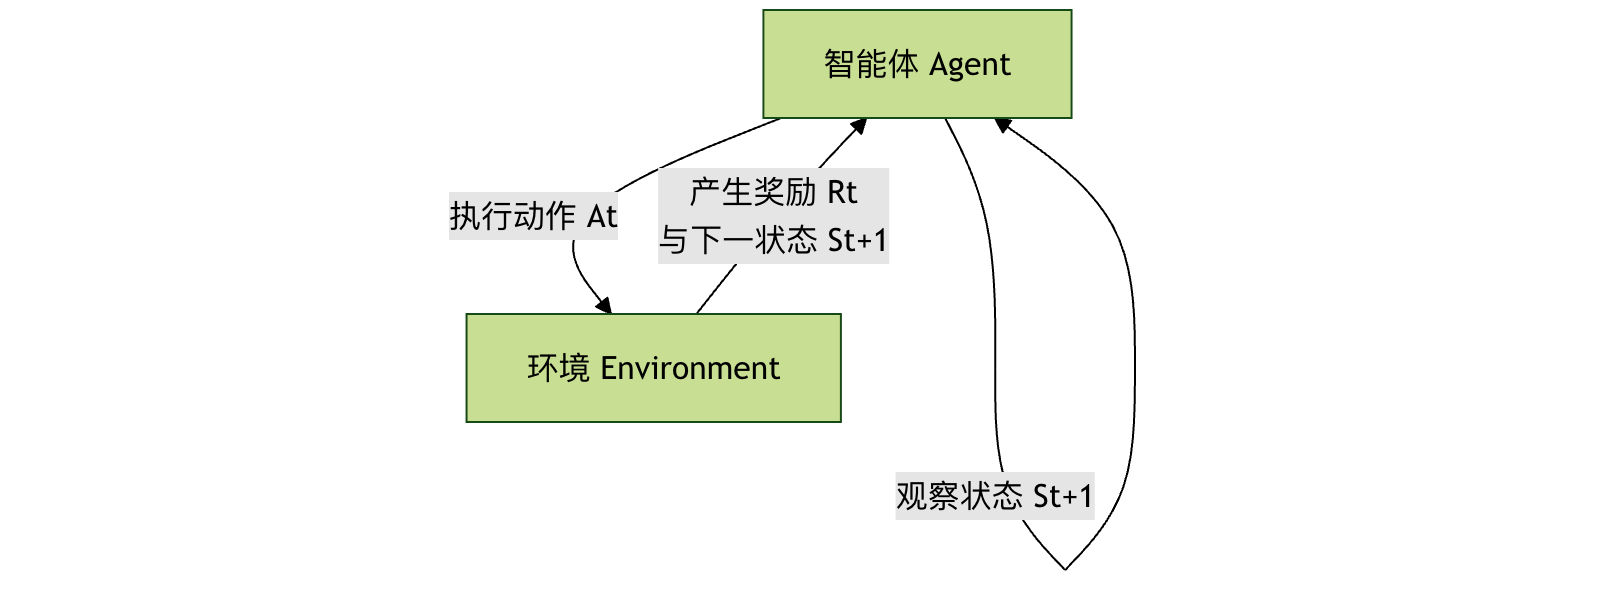
Este ciclo se repite continuamente; el agente recopila una gran cantidad de datos de interacción (s, a, r, s'), y utiliza estos datos para mejorar su propia política.
Algoritmos principales del aprendizaje por refuerzo profundo
La familia de algoritmos del aprendizaje por refuerzo profundo se divide principalmente en dos grandes categorías:Basados en el valor (Value-Based)yBasados en la política (Policy-Based), y la que combina las ventajas de ambosActor-Crítico (Actor-Critic)métodos.
1. Red Q profunda basada en el valor
El núcleo de estos algoritmos es aprender la óptimafunción de valor de acción Q(s, a). Una vez aprendida la función Q precisa, la política óptima es muy simple: en cada estadosse elige la acción que hace queQ(s, a)el valor Q sea máximoa。
Red Q profunda (DQN)Es un trabajo pionero. Utiliza redes neuronales profundas para aproximar funciones Q complejas.
Innovaciones técnicas clave de DQN:
- Reproducción de experiencias (Experience Replay)El agente almacena las experiencias de interacción
(s, a, r, s')en un búfer de memoria. Durante el entrenamiento, se extrae aleatoriamente un lote de experiencias del búfer para aprender. Esto rompe la correlación entre los datos, haciendo que el entrenamiento sea más estable y eficiente. - Red objetivo (Target Network)Se utiliza una 'red objetivo' con la misma estructura pero con parámetros que se actualizan más lentamente para calcular el objetivo de aprendizaje (valor Q objetivo), mientras que otra 'red en línea' se utiliza para la selección de acciones y la actualización en tiempo real. Esto resuelve el problema del valor objetivo en constante movimiento durante el entrenamiento, mejorando en gran medida la estabilidad.
Un proceso de entrenamiento simplificado de DQN:
- Inicializar la red en línea
Qy la red objetivoQ_target(con los mismos parámetros), y vaciar el búfer de reproducción de experiencias. - El agente, según el estado actual
s, con cierta probabilidad aleatoriamente o segúnQla red selecciona la accióna。 - Ejecuta la acción, el entorno devuelve la recompensa
ry el nuevo estados', y almacena la experiencia(s, a, r, s')en el búfer de reproducción. - Muestrear aleatoriamente un lote de experiencias del búfer de reproducción.
- Para cada muestra, calcular el valor Q objetivo:
y = r + γ * max_a' Q_target(s', a'). Dondeγes el factor de descuento, utilizado para equilibrar las recompensas inmediatas y las futuras. - con
(y - Q(s, a))^2Como pérdida, actualizar mediante el descenso de gradienteQlos parámetros de la red en línea. - Cada cierto número de pasos, copiar los parámetros de la red en línea a la red objetivo.
- Repetir los pasos 2-7.
Ventajas y limitaciones:
- VentajasEficiencia de muestra relativamente alta, entrenamiento relativamente estable.
- LimitacionesNaturalmente es difícil manejar espacios de acciones continuos (porque se necesita calcular
max_a Q(s,a)), y normalmente solo se puede aprender una política determinista.
2. Métodos de gradiente de políticas
Estos métodos parametrizan directamente la políticaπ(a|s; θ)(por ejemplo, representada por una red neuronal) y optimizan los parámetros de la políticaθpara maximizar directamente la recompensa esperada.
Idea principalCalculando el gradiente de la recompensa esperadaJ(θ)con respecto a los parámetros de la políticaθ(es decir, el gradiente de la política), y luego actualizando los parámetros en la dirección del gradiente para que la política sea cada vez mejor.
Algoritmo REINFORCEEs un algoritmo clásico de gradiente de políticas. Su fórmula de actualización es:θ ← θ + α * ∇_θ log π(a|s; θ) * G_tDondeG_tes la recompensa acumulada desde el momento actual hasta el final del episodio,αes la tasa de aprendizaje.
Ventajas y limitaciones:
- VentajasPuede aprender directamente políticas estocásticas, naturalmente adecuado para espacios de acciones continuos.
- LimitacionesSe actualiza en función de episodios completos, con gran varianza, lo que provoca un entrenamiento inestable y una baja eficiencia de muestra.
3. Métodos actor-crítico
El marco actor-crítico combina hábilmente los métodos basados en el valor y basados en la política, aprovechando las fortalezas de ambos.
- Actor (Actor)Es una red de política, responsable de generar acciones según el estado. Es como un actor que mejora su 'actuación' (política) bajo la guía del crítico.
- Crítico (Critic): Una red de valor (normalmente una red Q o una red V), que se encarga de evaluar el valor de las acciones que realiza el actor en un estado determinado. Actúa como un crítico que puntúa el desempeño del actor.
Flujo de trabajo:
- El actor, basándose en el estado actual
sy su propia política, selecciona y ejecuta una accióna。 - El entorno devuelve una recompensa
ry un nuevo estados'。 - El crítico, basándose en
(s, a, r, s')calcula el error TD (Temporal-Difference Error, una señal que mide la diferencia entre el valor predicho y el valor real). - El crítico utiliza este error para actualizar su red de evaluación de valor, haciendo que sus puntuaciones sean más precisas.
- El actor utiliza la "puntuación" proporcionada por el crítico (como el error TD o la función de ventaja) para actualizar su red de política, volviéndose más propenso a elegir acciones que obtengan puntuaciones altas.
Ventajas: Los métodos actor-crítico suelen tener menor varianza y ser más estables que los métodos de gradiente de política puros (como REINFORCE), y a su vez son mejores que los métodos de valor puro (como DQN) para manejar acciones continuas y políticas estocásticas.A3C, A2C, PPO, SACetc. son algoritmos actor-crítico muy exitosos.
Práctica: jugando al juego CartPole con DQN
Veamos a través de un problema de control clásicoCartPole(péndulo invertido) para entender DQN de forma intuitiva. En este entorno, el carrito puede moverse a izquierda y derecha, y el objetivo es mantener el poste sobre el carrito en posición vertical sin que se caiga.
Configuración del entorno
Usamos OpenAI Gym, el kit de herramientas de aprendizaje por refuerzo.
Ejemplo
# !pip install gym numpy torch
import gym
import numpy as np
import random
import torch
import torch.nn as nn
import torch.optim as optim
import collections
# Crear el entorno
env = gym.make('CartPole-v1')
state_dim = env.observation_space.shape[0] # Dimensión del estado: 4 (posición del carrito, velocidad, ángulo del poste, velocidad angular)
action_dim = env.action_space.n # Dimensión de la acción: 2 (izquierda, derecha)
print(f"Dimensión del espacio de estados: {state_dim}, tamaño del espacio de acciones: {action_dim}")
Definir la red Q
Esta es una red neuronal totalmente conectada simple, cuya entrada es el estado y cuya salida es el valor Q correspondiente a cada acción.
Ejemplo
def __init__(self, state_dim, action_dim):
super(DQN, self).__init__()
self.fc1 = nn.Linear(state_dim, 128) # Primera capa totalmente conectada
self.fc2 = nn.Linear(128, 128) # Segunda capa totalmente conectada
self.fc3 = nn.Linear(128, action_dim) # Capa de salida, un valor Q por acción
def forward(self, x):
x = torch.relu(self.fc1(x)) # Usar función de activación ReLU para introducir no linealidad
x = torch.relu(self.fc2(x))
return self.fc3(x) # Salida del valor Q, sin función de activación
Definir el búfer de reproducción de experiencias
Se utiliza para almacenar y muestrear experiencias pasadas.
Ejemplo
def __init__(self, capacity):
self.buffer = collections.deque(maxlen=capacity) # Cola doblemente terminada (deque), elimina automáticamente experiencias antiguas
def add(self, state, action, reward, next_state, done):
self.buffer.append((state, action, reward, next_state, done))
def sample(self, batch_size):
transitions = random.sample(self.buffer, batch_size)
# Organizar los datos en tensores apilados por columnas para facilitar el procesamiento por lotes de la red neuronal
state, action, reward, next_state, done = zip(*transitions)
return (np.array(state), action, reward, np.array(next_state), done)
def size(self):
return len(self.buffer)
Definir el agente DQN
Integra la red, la reproducción de experiencias y la lógica de entrenamiento.
Ejemplo
def __init__(self, state_dim, action_dim, lr=1e-3, gamma=0.98, epsilon=0.01,
target_update_freq=10, buffer_size=10000, batch_size=64):
self.action_dim = action_dim
self.q_net = DQN(state_dim, action_dim) # Red en línea
self.target_q_net = DQN(state_dim, action_dim) # Red objetivo
self.target_q_net.load_state_dict(self.q_net.state_dict()) # Parámetros iniciales idénticos
self.optimizer = optim.Adam(self.q_net.parameters(), lr=lr) # Optimizador
self.gamma = gamma # Factor de descuento
self.epsilon = epsilon # Tasa de exploración (final)
self.target_update_freq = target_update_freq # Frecuencia de actualización de la red objetivo
self.batch_size = batch_size
self.buffer = ReplayBuffer(buffer_size)
self.count = 0 # Registrar el número de pasos de actualización
def take_action(self, state, epsilon=None):
"""Seleccionar acción según la política epsilon-greedy"""
if epsilon is None:
epsilon = self.epsilon
if np.random.random() < epsilon:
return np.random.randint(self.action_dim) # Exploración: selección aleatoria
else:
state = torch.tensor(state, dtype=torch.float).unsqueeze(0) # Añadir dimensión de lote
with torch.no_grad():
q_values = self.q_net(state)
return q_values.argmax().item() # Explotación: elegir la acción con el mayor valor Q
def update(self):
"""Muestrear del buffer de reproducción de experiencias y actualizar la red"""
if self.buffer.size() < self.batch_size:
return
# 1. Muestreo
states, actions, rewards, next_states, dones = self.buffer.sample(self.batch_size)
# Convertir a tensor de PyTorch
states = torch.tensor(states, dtype=torch.float)
actions = torch.tensor(actions).unsqueeze(1) # La forma cambia a [batch_size, 1], lo que facilita la operación gather
rewards = torch.tensor(rewards, dtype=torch.float).unsqueeze(1)
next_states = torch.tensor(next_states, dtype=torch.float)
dones = torch.tensor(dones, dtype=torch.float).unsqueeze(1)
# 2. Calcular el valor Q actual (Q(s, a))
current_q_values = self.q_net(states).gather(1, actions) # Extraer solo el valor Q correspondiente a la acción ejecutada a
# 3. Calcular el valor Q objetivo (r + γ * max_a' Q_target(s', a'))
with torch.no_grad():
next_q_values = self.target_q_net(next_states).max(1)[0].unsqueeze(1) # Tomar el valor Q máximo del siguiente estado
target_q_values = rewards + self.gamma * next_q_values * (1 - dones) # Si el episodio termina (done=1), no hay recompensa futura
# 4. Calcular la pérdida (error cuadrático medio)
loss = nn.MSELoss()(current_q_values, target_q_values)
# 5. Descenso de gradiente para actualizar la red en línea
self.optimizer.zero_grad()
loss.backward()
# Opcional: recorte de gradiente para evitar la explosión del gradiente
# torch.nn.utils.clip_grad_norm_(self.q_net.parameters(), max_norm=10)
self.optimizer.step()
self.count += 1
# 6. Actualizar periódicamente la red objetivo
if self.count % self.target_update_freq == 0:
self.target_q_net.load_state_dict(self.q_net.state_dict())
Bucle de entrenamiento
Ejemplo
"""Entrenar al agente"""
return_list = [] # Registrar la recompensa total de cada episodio
epsilon = initial_epsilon
for i_episode in range(num_episodes):
state, _ = env.reset()
episode_return = 0
done = False
for step in range(max_steps):
# 1. Seleccionar y ejecutar la acción
action = agent.take_action(state, epsilon) # Usar una tasa de exploración con decaimiento
next_state, reward, done, truncated, _ = env.step(action)
# 2. Almacenar la experiencia
agent.buffer.add(state, action, reward, next_state, done)
state = next_state
episode_return += reward
# 3. Actualizar la red
agent.update()
if done or truncated:
break
# Decaimiento de la tasa de exploración
epsilon = max(agent.epsilon, epsilon * epsilon_decay)
return_list.append(episode_return)
if (i_episode + 1) % 50 == 0:
print(f"Episodio: {i_episode+1}, Recompensa promedio (últimos 50 episodios): {np.mean(return_list[-50:]):.1f}, Tasa de exploración: {epsilon:.3f}")
print("¡Entrenamiento completado!")
return return_list
# Crear el agente y comenzar el entrenamiento
agent = DQNAgent(state_dim, action_dim, lr=1e-3, gamma=0.99, epsilon=0.01)
returns = train_agent(env, agent, num_episodes=300)
Probar el agente entrenado
Ejemplo
"""Probar el desempeño del agente"""
total_rewards = []
for i in range(num_episodes):
state, _ = env.reset()
episode_return = 0
done = False
while not done:
if render:
env.render() # Visualizar el entorno; al ejecutarlo localmente se puede ver el carrito equilibrando el poste
action = agent.take_action(state) # Al probar, usar la tasa de exploración mínima (es decir, explotación pura)
next_state, reward, done, truncated, _ = env.step(action)
state = next_state
episode_return += reward
if done or truncated:
break
total_rewards.append(episode_return)
print(f"Episodio de prueba {i+1}: Recompensa total = {episode_return}")
env.close()
print(f"Recompensa promedio de prueba: {np.mean(total_rewards):.1f}")
# Probar al agente
test_agent(env, agent, num_episodes=3, render=False) # En entornos sin GUI, establecer render=False
Desafíos y direcciones futuras del aprendizaje por refuerzo profundo
A pesar de su gran éxito, el aprendizaje por refuerzo profundo aún enfrenta muchos desafíos:
- Baja eficiencia de muestreo: Por lo general, se necesitan muchos más datos de interacción que los que requieren los humanos o los métodos tradicionales para aprender una tarea.
- Entrenamiento inestable: Es muy sensible a los hiperparámetros (tasa de aprendizaje, estructura de la red, etc.), y el proceso de entrenamiento tiende a divergir fácilmente.
- Dificultad en el diseño de la recompensa: Diseñar una función de recompensa que guíe correctamente al agente para alcanzar el objetivo final es, en sí mismo, un problema difícil.
- Seguridad y explicabilidad: Cómo garantizar que el comportamiento del agente sea seguro, confiable y acorde con lo esperado, y comprender su proceso de toma de decisiones.
La investigación futura avanza hacia algoritmos más eficientes (como el aprendizaje por refuerzo basado en modelos), un aprendizaje de representaciones más potente, el aprendizaje multitarea y el meta-aprendizaje, así como la alineación segura con el mundo real.
Resumen y ejercicios
El aprendizaje por refuerzo profundo combina la capacidad de percepción del aprendizaje profundo con el marco de toma de decisiones del aprendizaje por refuerzo, lo que permite a las máquinas aprender a realizar tareas avanzadas en entornos complejos. Ya has conocido sus conceptos centrales, las principales familias de algoritmos y has tenido una experiencia intuitiva con el código práctico de DQN.
Ejercicios y reflexión:
- Modificar el código: Intenta ajustar
DQNAgentlos hiperparámetros en (comolr,gamma,batch_size), y observa su efecto en la velocidad de entrenamiento y el rendimiento final. - Cambiar el entorno: Intenta aplicar el código a otros entornos de Gym, como
MountainCar-v0oLunarLander-v2. Ten en cuenta ajustar las dimensiones del estado y la acción. - Comparación de algoritmos: Lee e intenta implementar un algoritmo de gradiente de política simple (como REINFORCE) para resolver el problema de CartPole, y compara sus diferencias con DQN en estabilidad de entrenamiento y eficiencia de muestreo.
- Exploración en profundidad: Elige un algoritmo moderno y avanzado (como PPO o SAC), lee su artículo o implementación de código abierto, y comprende cómo resuelve los problemas presentes en DQN o en el gradiente de política.