Глубокое обучение с подкреплением
Глубокое обучение с подкреплением — это захватывающее междисциплинарное направление в области искусственного интеллекта. Мы можем разбить его на две части, чтобы понять:
Обучение с подкреплением— это основная идея, которая моделирует процесс обучения людей или животных методом «проб и ошибок». Представьте, что вы учите щенка новой команде: когда он выполняет её правильно, вы даёте ему лакомство в качестве награды; когда он ошибается, награды нет или даже следует небольшое наказание. После многих попыток щенок может научиться совершать правильное действие в конкретной ситуации, чтобы получать награды. Агент в обучении с подкреплением похож на этого щенка; он взаимодействует с окружающей средой и корректирует свою поведенческую политику на основе получаемых наград.
Глубокое обучение— это мощный инструмент. Когда среда, с которой имеет дело обучение с подкреплением, очень сложна (например, экраны видеоигр, данные с датчиков робота), традиционными математическими методами трудно напрямую извлекать из неё полезные признаки для принятия решений. Глубокое обучение, особенно глубокие нейронные сети, отлично справляется с обработкой таких многомерных, сложных исходных данных (например, изображений, звука) и может автоматически изучать иерархические представления признаков данных.
Следовательно,глубокое обучение с подкреплением = структура принятия решений обучения с подкреплением + возможности восприятия и представления глубокого обучения. Оно позволяет агентам напрямую учиться тому, как выбирать оптимальные действия из сложных необработанных входных данных (таких как пиксели) для достижения долгосрочных целей.
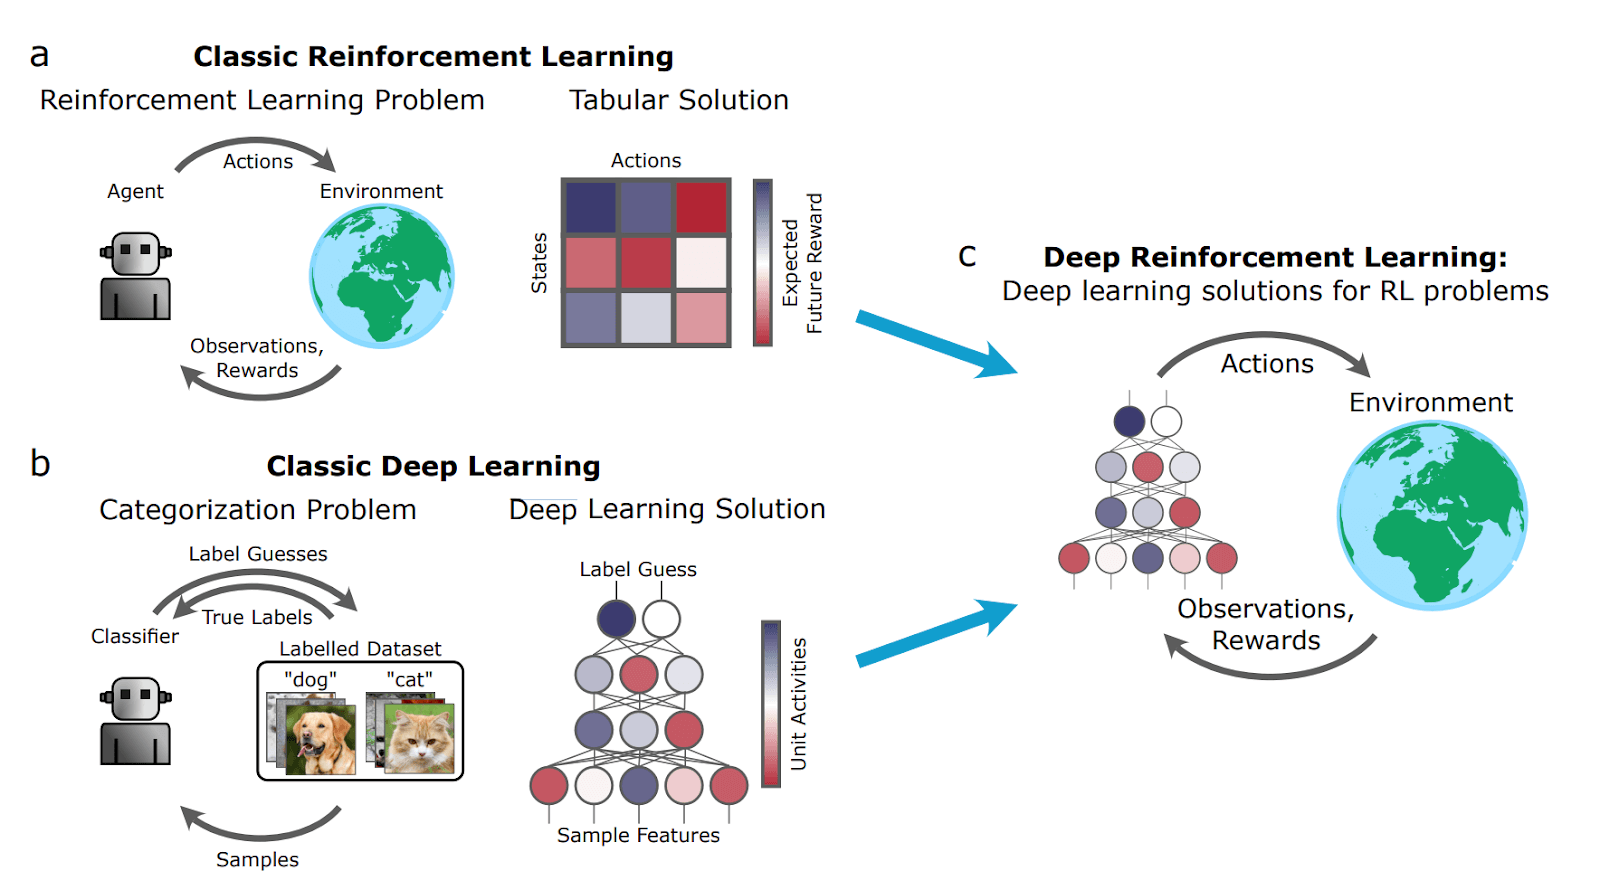
Основные концепции и базовый фреймворк
Чтобы понять глубокое обучение с подкреплением, сначала нужно усвоить несколько ключевых ролей в его базовом фреймворке и связи между ними.
Базовые элементы обучения с подкреплением
Агент
- Роль: обучающийся и принимающий решения.
- Ответственность: Наблюдать за состоянием среды, выбирать действия в соответствии с изученной политикой, выполнять действия и получать обратную связь (новое состояние и награду) от среды.
Окружение
- Роль: Всё внешнее, с чем взаимодействует агент.
- Ответственность: Принимать действие агента, обновлять собственное состояние и предоставлять соответствующую награду.
Состояние (s)
- Определение: Описание конкретной ситуации среды в определённый момент. В глубоком обучении с подкреплением состояния обычно имеют высокую размерность, например кадр игрового изображения.
Действие (a)
- Определение: Варианты выбора, которые агент может сделать в данном состоянии. Например, в игре это могут быть «вверх», «влево», «огонь» и т. д.
Награда (r)
- Определение: Немедленный сигнал обратной связи от среды на действие агента, скалярное значение. Награда — это "компас" для обучения агента, и её цель — максимизировать долгосрочную суммарную награду.
Политика (π)
- Определение: Руководство поведения агента, функция отображения состояний в действия. Она говорит агенту, какое действие предпринять в заданном состоянии. Политика может быть детерминированной (
a = π(s)), или стохастической (a ~ π(a|s))。
- Определение: Руководство поведения агента, функция отображения состояний в действия. Она говорит агенту, какое действие предпринять в заданном состоянии. Политика может быть детерминированной (
Функция ценности
- Определение: Используется для оценки того, насколько хорошим является состояние или пара состояние-действие. Оно представляет то, что можно получить в будущем, начиная с текущего состояния (или после выполнения текущего действия).Ожидаемая суммарная награда。
- Функция ценности состояния V(s): В состоянии
s, ожидаемая доходность, которую можно получить, следуя текущей политике. - Функция ценности действия Q(s, a): В состоянии
s, выполняя действиеa, а затем ожидаемая доходность, которую можно получить, следуя текущей политике.
Процесс взаимодействия
Взаимодействие между агентом и средой — это непрерывный циклический процесс, который можно наглядно представить следующей блок-схемой:
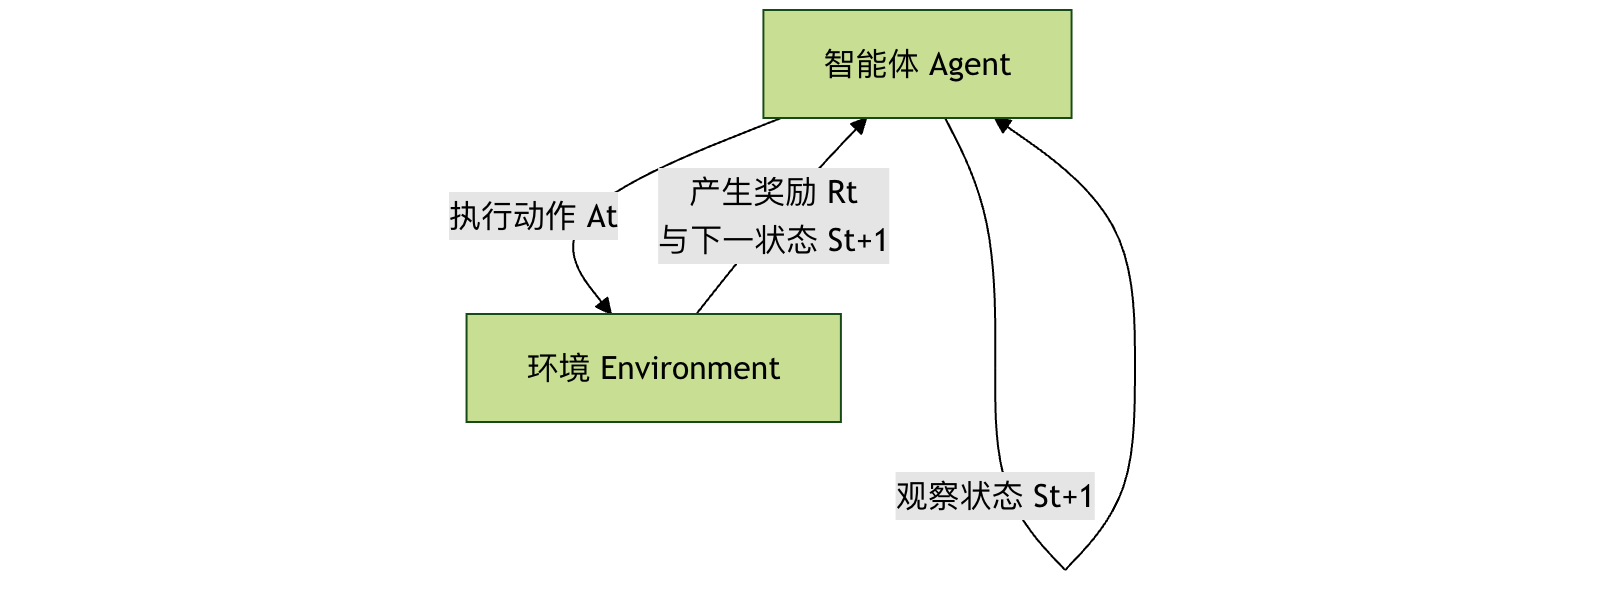
Этот цикл повторяется непрерывно, и агент собирает большой объём данных взаимодействия (s, a, r, s') и использует эти данные для улучшения своей политики.
Основные алгоритмы глубокого обучения с подкреплением
Семейство алгоритмов глубокого обучения с подкреплением в основном делится на две большие категории:основанные на ценностииоснованные на политике, иActor-Criticметод, объединяющий преимущества обоих.
1. Deep Q-Network на основе ценности
Суть этого типа алгоритмов — изучить оптимальнуюфункцию ценности действия Q(s, a). Как только точная Q-функция изучена, оптимальная политика проста: в каждом состоянииs, выберите действие, которое может сделатьQ(s, a)действие с максимальнымa。
Deep Q-Network (DQN)— это знаковая работа. В ней используются глубокие нейронные сети для аппроксимации сложных Q-функций.
Ключевые технические инновации DQN:
- Воспроизведение опыта: Агент сохраняет опыт взаимодействия
(s, a, r, s')в буфер памяти. Во время обучения из буфера случайным образом выбирается пакет примеров опыта для обучения. Это разрывает корреляцию между данными, делая обучение более стабильным и эффективным. - Целевая сеть: «целевая сеть» с той же структурой, но более медленным обновлением параметров используется для вычисления целей обучения (целевых значений Q), тогда как другая «онлайн-сеть» используется для выбора действий и обновлений в реальном времени. Это решает проблему постоянного изменения целевых значений во время обучения и значительно повышает стабильность.
Упрощённый процесс обучения DQN:
- Инициализировать онлайн-сеть
Qи целевую сетьQ_target(с теми же параметрами) и очистить буфер воспроизведения опыта. - Агент на основе текущего состояния
s, с некоторой вероятностью случайно или в соответствии сQсетью выбирает действиеa。 - Выполнить действие, среда возвращает награду
rи новое состояниеs', и сохранить опыт(s, a, r, s')в буфер воспроизведения. - Случайным образом извлечь пакет опытов из буфера воспроизведения.
- Для каждого образца вычислить целевое Q-значение:
y = r + γ * max_a' Q_target(s', a'). Здесь,γ— коэффициент дисконтирования, используемый для баланса между немедленными и будущими наградами. - with
(y - Q(s, a))^2в качестве функции потерь обновитеQпараметры онлайн-сети с помощью градиентного спуска. - Каждые несколько шагов копируйте параметры онлайн-сети в целевую сеть.
- Повторите шаги 2-7.
Преимущества и ограничения:
- Преимущества: Относительно высокая эффективность использования выборки и относительно стабильное обучение.
- Ограничения: по своей сути сложно обрабатывать непрерывные пространства действий (потому что требуется вычислять
max_a Q(s,a)), и обычно он может изучать только политики.
2. Методы, основанные на политике
Эти методы напрямую параметризуют политикуπ(a|s; θ)(например, представленную нейронной сетью) и оптимизируют параметры политикиθчтобы напрямую максимизировать ожидаемую доходность.
Основная идея: вычисляя градиент ожидаемой доходностиJ(θ)по параметрам политикиθ(т. е. градиент политики), а затем обновляя параметры в направлении градиента, политика становится всё лучше и лучше.
Алгоритм REINFORCE— классический алгоритм градиента политики. Его формула обновления:θ ← θ + α * ∇_θ log π(a|s; θ) * G_tгдеG_t— это суммарная награда с текущего момента до конца эпизода,α— это скорость обучения.
Преимущества и ограничения:
- Преимущества: могут напрямую обучаться стохастическим политикам и естественно подходят для непрерывных пространств действий.
- Ограничения: обновления основаны на всём эпизоде, что приводит к высокой дисперсии, нестабильному обучению и низкой эффективности использования выборки.
3. Методы актора-критика
Архитектура «актор-критик» умело объединяет методы, основанные на ценности, и методы, основанные на политике, дополняя сильные стороны друг друга.
- Актор: сеть политики, отвечающая за генерацию действий на основе состояния. Он подобен актёру, который улучшает свою «игру» (политику) под руководством критика.
- КритикСеть ценности (обычно Q-сеть или V-сеть), которая оценивает ценность действий, предпринятых актором в заданном состоянии. Она действует как критик, оценивая игру актора.
Рабочий процесс:
- Актор, основываясь на текущем состоянии
sи собственной политике, выбирает и выполняет действиеa。 - Среда возвращает награду
rи новое состояниеs'。 - Критик, основываясь на
(s, a, r, s')вычисляет TD-ошибку (Temporal-Difference Error — сигнал, который измеряет разницу между предсказанной ценностью и фактической ценностью). - Критик использует эту ошибку для обновления своей сети оценки ценности, делая свою оценку более точной.
- Актор использует «оценки», предоставляемые критиком (например, TD-ошибку или функцию преимущества), чтобы обновлять свою сеть политики, делая её более склонной выбирать действия, получающие высокие оценки.
ПреимуществаМетоды актор-критик обычно имеют меньшую дисперсию и более стабильны, чем чисто градиентные методы политики (такие как REINFORCE), при этом лучше справляются с непрерывными действиями и стохастическими политиками, чем чисто ценностные методы (такие как DQN).A3C, A2C, PPO, SACи т. д. — все это очень успешные алгоритмы актор-критик.
Практика: играем в CartPole с DQN
Давайте воспользуемся классической задачей управленияCartPole(удержание шеста в равновесии), чтобы интуитивно почувствовать DQN. В этой среде тележка может двигаться влево и вправо, а цель — удерживать шест на тележке в вертикальном положении.
Настройка окружения
Мы используем набор инструментов для обучения с подкреплением OpenAI Gym.
Пример
# !pip install gym numpy torch
import gym
import numpy as np
import random
import torch
import torch.nn as nn
import torch.optim as optim
import collections
# Создаём среду
env = gym.make('CartPole-v1')
state_dim = env.observation_space.shape[0] # Размерность состояния: 4 (позиция тележки, скорость, угол шеста, угловая скорость)
action_dim = env.action_space.n # Размерность действий: 2 (влево, вправо)
print(f"Размерность пространства состояний: {state_dim}, размер пространства действий: {action_dim}")
Определить Q-сеть
Это простая полносвязная нейронная сеть, на вход которой подаётся состояние, а на выход — Q-значение для каждого действия.
Пример
def __init__(self, state_dim, action_dim):
super(DQN, self).__init__()
self.fc1 = nn.Linear(state_dim, 128) # Первый полносвязный слой
self.fc2 = nn.Linear(128, 128) # Второй полносвязный слой
self.fc3 = nn.Linear(128, action_dim) # Выходной слой, одно Q-значение на действие
def forward(self, x):
x = torch.relu(self.fc1(x)) # Использовать функцию активации ReLU для внесения нелинейности
x = torch.relu(self.fc2(x))
return self.fc3(x) # Вывод Q-значений без функции активации
Определить буфер воспроизведения опыта
Используется для хранения и выборки прошлого опыта.
Пример
def __init__(self, capacity):
self.buffer = collections.deque(maxlen=capacity) # Двусторонняя очередь, автоматически отбрасывает старый опыт
def add(self, state, action, reward, next_state, done):
self.buffer.append((state, action, reward, next_state, done))
def sample(self, batch_size):
transitions = random.sample(self.buffer, batch_size)
# Организовать данные в тензоры, сгруппированные по столбцам, для эффективной пакетной обработки нейронной сетью
state, action, reward, next_state, done = zip(*transitions)
return (np.array(state), action, reward, np.array(next_state), done)
def size(self):
return len(self.buffer)
Определить агента DQN
Интегрирует сеть, воспроизведение опыта и логику обучения.
Пример
def __init__(self, state_dim, action_dim, lr=1e-3, gamma=0.98, epsilon=0.01,
target_update_freq=10, buffer_size=10000, batch_size=64):
self.action_dim = action_dim
self.q_net = DQN(state_dim, action_dim) # Онлайн-сеть
self.target_q_net = DQN(state_dim, action_dim) # Целевая сеть
self.target_q_net.load_state_dict(self.q_net.state_dict()) # Одинаковые начальные параметры
self.optimizer = optim.Adam(self.q_net.parameters(), lr=lr) # Оптимизатор
self.gamma = gamma # Коэффициент дисконтирования
self.epsilon = epsilon # Скорость исследования (конечная)
self.target_update_freq = target_update_freq # Частота обновления целевой сети
self.batch_size = batch_size
self.buffer = ReplayBuffer(buffer_size)
self.count = 0 # Записывать шаги обновления
def take_action(self, state, epsilon=None):
"""Выбрать действие согласно эпсилон-жадной политике"""
if epsilon is None:
epsilon = self.epsilon
if np.random.random() < epsilon:
return np.randint.self(action_dim.action_dim) # Исследование: случайный выбор
else:
state = torch.tensor(state, dtype=torch.float).unsqueeze(0) # Добавить размерность батча
with torch.no_grad():
q_values = self.q_net(state)
return q_values.argmax().item() # Эксплуатация: выбрать действие с наибольшим значением Q
def update(self):
"""Выбрать образец из буфера воспроизведения опыта и обновить сеть"""
if self.buffer.size() < self.batch_size:
return
# 1. Выборка
states, actions, rewards, next_states, dones = self.buffer.sample(self.batch_size)
# Преобразовать в тензоры PyTorch
states = torch.tensor(states, dtype=torch.float)
actions = torch.tensor(actions).unsqueeze(1) # Форма становится [batch_size, 1], удобно для операции gather
rewards = torch.tensor(rewards, dtype=torch.float).unsqueeze(1)
next_states = torch.tensor(next_states, dtype=torch.float)
dones = torch.tensor(dones, dtype=torch.float).unsqueeze(1)
# 2. Вычислить текущее Q-значение (Q(s, a))
current_q_values = self.q_net(states).gather(1, actions) # Извлечь только Q-значение, соответствующее выполненному действию a
# 3. Вычислить целевое Q-значение (r + γ * max_a' Q_target(s', a'))
with torch.no_grad():
next_q_values = self.target_q_net(next_states).max(1)[0].unsqueeze(1) # Взять максимальное Q-значение следующего состояния
target_q_values = rewards + self.gamma * next_q_values * (1 - dones) # Если эпизод заканчивается (done=1), будущей награды нет
# 4. Вычислить потери (среднеквадратичная ошибка)
loss = nn.MSELoss()(current_q_values, target_q_values)
# 5. Обновите онлайн-сеть с помощью градиентного спуска
self.optimizer.zero_grad()
loss.backward()
# Необязательно: отсечение градиентов для предотвращения взрыва градиентов
# torch.nn.utils.clip_grad_norm_(self.q_net.parameters(), max_norm=10)
self.optimizer.step()
self.count += 1
# 6. Периодически обновляйте целевую сеть
if self.count % self.target_update_freq == 0:
self.target_q_net.load_state_dict(self.q_net.state_dict())
Цикл обучения
Пример
"""Обучить агента"""
return_list = [] # Записать суммарную награду за каждый эпизод
epsilon = initial_epsilon
for i_episode in range(num_episodes):
state, _ = env.reset()
episode_return = 0
done = False
for step in range(max_steps):
# 1. Выбрать и выполнить действие
action = agent.take_action(state, epsilon) # Использовать затухающий коэффициент исследования
next_state, reward, done, truncated, _ = env.step(action)
# 2. Сохранить опыт
agent.buffer.add(state, action, reward, next_state, done)
state = next_state
episode_return += reward
# 3. Обновление сети
agent.update()
if done or truncated:
break
# Затухание скорости исследования
epsilon = max(agent.epsilon, epsilon * epsilon_decay)
return_list.append(episode_return)
if (i_episode + 1) % 50 == 0:
print(f"Эпизод: {i_episode+1}, Средняя награда (последние 50 эпизодов): {np.mean(return_list[-50:]):.1f}, Скорость исследования: {epsilon:.3f}")
print("Обучение завершено!")
return return_list
# Создать агента и начать обучение
agent = DQNAgent(state_dim, action_dim, lr=1e-3, gamma=0.99, эпсилон=0.01)
returns = train_agent(env, agent, num_episodes=300)
Тестирование обученного агента
Пример
"""Проверка производительности агента"""
total_rewards = []
for i in range(num_episodes):
state, _ = env.reset()
episode_return = 0
done = False
while not done:
if render:
env.render() # Визуализируйте среду; при локальном запуске вы увидите, как тележка удерживает шест в равновесии
action = agent.take_action(state) # Используйте минимальный коэффициент исследования при тестировании (т. е. чистая эксплуатация)
next_state, reward, done, truncated, _ = env.step(action)
state = next_state
episode_return += reward
if done or truncated:
break
total_rewards.append(episode_return)
print(f"Тестовый эпизод {i+1}: Общая награда = {episode_return}")
env.close()
print(f"Средняя награда при тестировании: {np.mean(total_rewards):.1f}")
# Тестирование агента
test_agent(env, agent, num_episodes=3, render=False) # Установите render=False в средах без GUI
Проблемы и будущие направления глубокого обучения с подкреплением
Несмотря на большой успех, глубокое обучение с подкреплением по-прежнему сталкивается со многими проблемами:
- Низкая эффективность выборки: Обычно для изучения задачи требуется гораздо больше интерактивных данных, чем людям или традиционным методам.
- Нестабильное обучение: Очень чувствительно к гиперпараметрам (скорость обучения, структура сети и т. д.), и процесс обучения может легко расходиться.
- Разработка награды сложна: Создание функции награды, которая правильно направляет агента к достижению конечной цели, само по себе является проблемой.
- Безопасность и интерпретируемость: Как гарантировать, что поведение агента безопасно, надёжно и соответствует ожиданиям, а также понимать процесс принятия им решений.
Будущие исследования движутся в сторону более эффективных алгоритмов (таких как обучение с подкреплением на основе моделей), более сильного обучения представлениям, многозадачного обучения и метаобучения, а также безопасного согласования с реальным миром.
Итоги и упражнения
Глубокое обучение с подкреплением объединяет возможности восприятия глубокого обучения с фреймворком принятия решений обучения с подкреплением, позволяя машинам учиться выполнять продвинутые задачи в сложных средах. Вы изучили его ключевые концепции, основные семейства алгоритмов и получили практический опыт работы с практическим кодом DQN.
Упражнения и размышление:
- Измените код: Попробуйте настроить гиперпараметры в
DQNAgent(напримерlr,gamma,batch_size), и наблюдайте их влияние на скорость обучения и итоговую производительность. - Смените среду: Попробуйте применить код к другим средам Gym, таким как
MountainCar-v0илиLunarLander-v2. Обязательно скорректируйте размерности состояний и действий. - Сравнение алгоритмов: Прочитайте и попробуйте реализовать простой алгоритм градиента политики (например, REINFORCE) для решения задачи CartPole и сравните его отличия от DQN в стабильности обучения и эффективности использования выборки.
- Дальнейшее исследование: Выберите современный продвинутый алгоритм (например, PPO или SAC), прочитайте его статью или открытую реализацию и поймите, как он решает проблемы, присущие DQN или градиентам политики.