Глубокое обучение против традиционного машинного обучения
Представьте, что вы учите ребёнка распознавать кошек и собак. Традиционный подход может быть таким: вы достаёте книжку с картинками, указываете на изображения и говорите: это кошка, у неё острые уши, усы и длинный хвост; это собака, её уши могут свисать, а нос длиннее. Вы явно сообщаете ребёнку отличительныеправила и признаки。
Другой подход таков: вы показываете ребёнку тысячи изображений кошек и собак, просто сообщая ему или ей, кошка это или собака на каждом изображении. После достаточного количества наблюдений мозг ребёнка сам обобщит невыразимые, сложные отличительные признаки кошек и собак, такие как текстура шерсти, выражение глаз и контур тела. Этот подход ближе ктому, чтобы позволить данным говорить за себя。
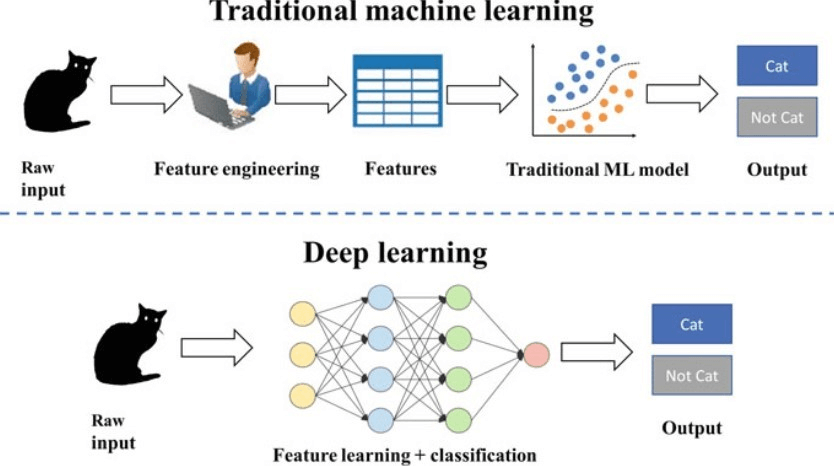
Эти два метода обучения точно соответствуют двум важным парадигмам в области машинного обучения:традиционное машинное обучениеиглубокое обучение. В этой статье для новичков будет ясно разобрано: основные идеи, принципы работы, преимущества и недостатки, а также применимые сценарии обоих, что поможет вам сформировать макроуровневое понимание и выбрать направление для последующего обучения.
Часть 1: Традиционное машинное обучение — аналитик, опирающийся на правила и признаки
Традиционное машинное обучение можно рассматривать как аналитика, которому нужны чёткие инструкции и структурированные данные.
Что такое традиционное машинное обучение?
Традиционное машинное обучение — это совокупность алгоритмов, основная идея которых такова:изучать закономерности (модели) из данных и использовать эти закономерности для прогнозирования или принятия решений на новых данных. Его успех во многом зависит от предварительного и критически важного шага:разработка признаков。
Основной рабочий процесс
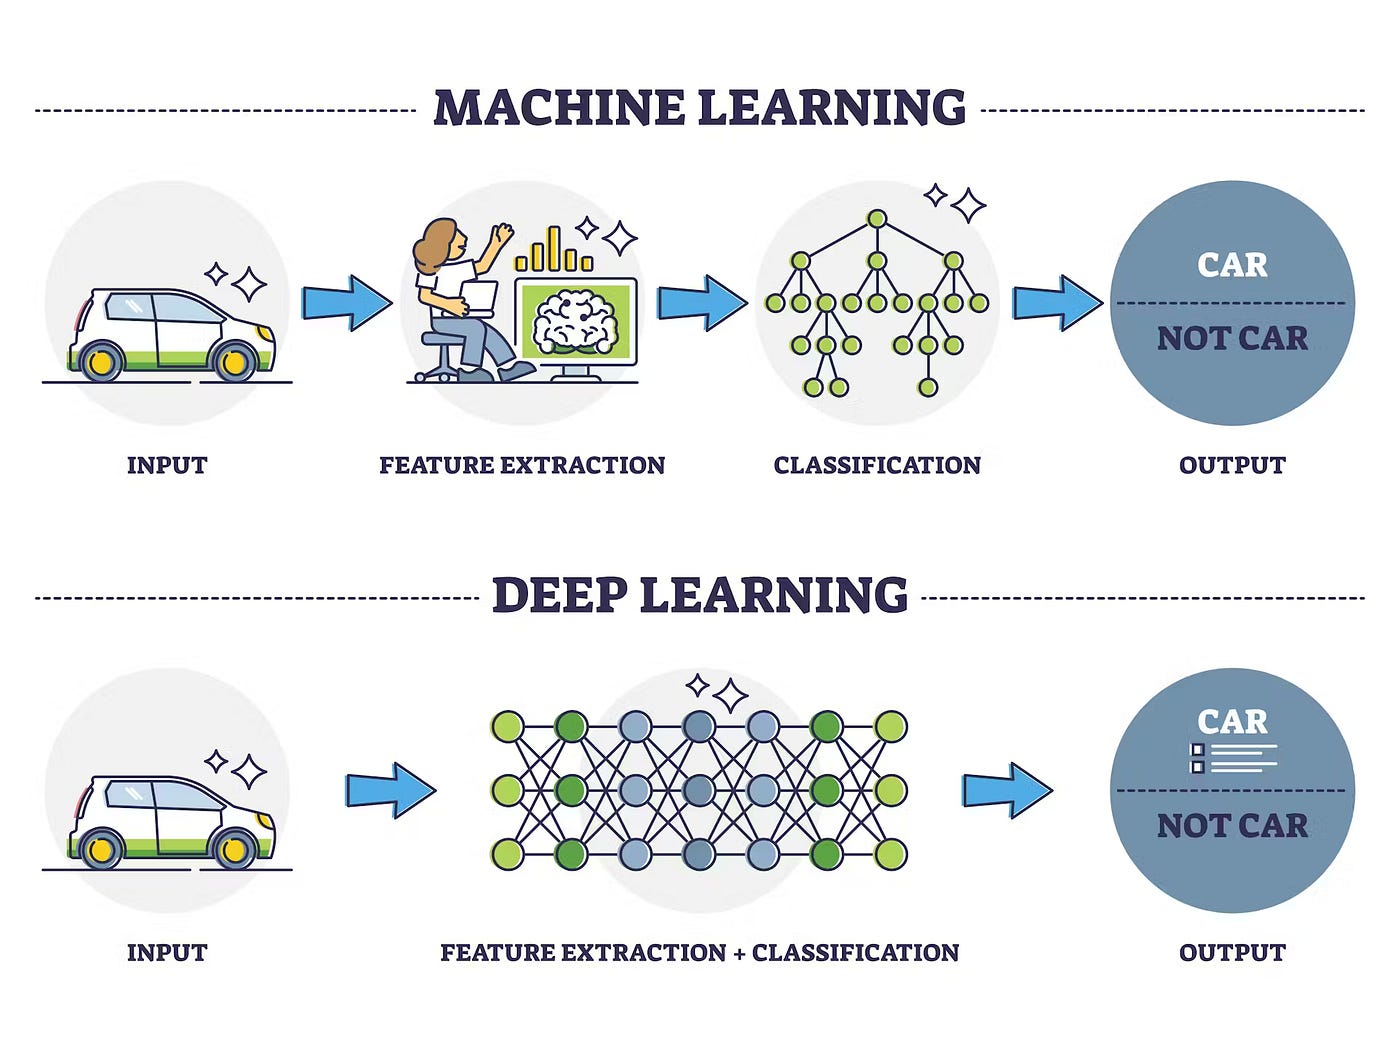
Давайте интуитивно разберём процесс работы традиционного машинного обучения с помощью блок-схемы:
Анализ процесса:
- Разработка признаков: Это ключевой этап, в наибольшей степени зависящий от экспертных знаний человека. Вам нужно извлекать из необработанных данных (например, пикселей изображения, слов текста) количественно измеримые признаки, полезные для решения задачи. Например, при обнаружении спама признаками могут быть наличие слова «free» или наличие адреса отправителя в списке контактов.
- Выбор и обучение алгоритма: Подайте обработанные данные признаков на вход выбранного алгоритма (например, машины опорных векторов, SVM или решающего дерева). Алгоритм попытается найти функцию или правило, которые лучше всего предсказывают результат (например, спам или не спам) на основе этих признаков.
- Предсказание: Когда приходит новое письмо, система сначала извлекает те же признаки, а затем передаёт их обученной модели для принятия решения.
Основные характеристики, преимущества и недостатки
| Характеристика | Описание | Преимущества | Недостатки |
|---|---|---|---|
| Сильная зависимость от разработки признаков | Верхний предел эффективности модели определяется качеством признаков. | Высокая интерпретируемость и возможность интеграции знаний экспертов-людей. | Требуется много предметных знаний и времени для разработки и извлечения признаков; высокие затраты. |
| Относительно простые модели | Обычно используются линейные модели, древовидные модели и т. д. | Высокая скорость обучения, требующая меньших вычислительных ресурсов. | Обработканеструктурированных данных(изображения, аудио, естественный язык) ограничена, что затрудняет улавливание глубоких и сложных закономерностей. |
| Хорошая интерпретируемость | Вы можете понять, как модель принимает решения (например, путь правил решающего дерева). | Критически важно в областях, требующих объяснения решений, таких как финансы и здравоохранение. | Иногда часть точности предсказаний приносится в жертву ради интерпретируемости. |
Простая аналогия: традиционное машинное обучение похоже нааналитика, у которого есть мощные формулы и статистические инструменты, но для которого вы должны самостоятельно подготовить все материалы для анализа.。
Часть 2: Глубокое обучение — воспринимающее устройство, которое учится автоматически
Глубокое обучение — это подобласть машинного обучения, которая пытается имитировать работу нейронов человеческого мозга, позволяя машинам автоматически изучать многоуровневые представления признаков из необработанных данных.
Что такое глубокое обучение?
Ядро глубокого обучения — этоискусственные нейронные сети, особенно глубокие нейронные сети со многими слоями. Его величайшая особенность в том, что оно может обучатьсясквозным образом: вы подаете самые необработанные данные (например, исходные пиксели изображения), а оно может выдать конечный результат (например, категорию изображения). Сложный процесс извлечения признаков между ними автоматически выполняется сетью.
Основная рабочая архитектура
Глубокое обучение, особенно свёрточные нейронные сети для распознавания изображений, имеет иерархический процесс обучения, идущий от поверхностного к глубокому:

Анализ архитектуры:
- Иерархическое обучение признакам: Первый слой сети может научиться распознавать толькокрая и углы. Второй слой объединяет эти края и учится распознаватьпростые текстуры и формы(например, круги, полосы). Более глубокие слои затем объединяют эти простые формы всложные части и объекты(например, глаза, автомобильные двери). Последние слои объединяют эти части в полныеконцепции объектов(например, кошки, машины).
- Сквозное обучение: Вам не нужно объяснять сети, что такое края или текстуры. Нужно лишь предоставить большое количество размеченных исходных данных (изображения и соответствующие метки «кошка/собака»). С помощью алгоритмаобратного распространения ошибкисеть автоматически настраивает свои внутренние миллионы или даже миллиарды параметров и сама учится, какие комбинации пикселей соответствуют кошкам, а какие — собакам.
Основные характеристики, преимущества и недостатки
| Характеристика | Описание | Преимущества | Недостатки |
|---|---|---|---|
| Автоматическое конструирование признаков | Может автоматически изучать многоуровневые абстрактные признаки из исходных данных. | Устраняет утомительное ручное конструирование признаков; особенно хорошо проявляет себя при обработке изображений, речи и текста. | Как «чёрный ящик», внутренний процесс принятия решений трудно объяснить. |
| Сильная способность обрабатывать неструктурированные данные | Естественно подходит для обработки сложных данных, таких как пиксели, звуковые волны и последовательности слов. | Достигает или даже превосходит человеческий уровень производительности в таких областях, как компьютерное зрение, обработка естественного языка и распознавание речи. | Требуетогромных объемов данныхдля обучения; при недостатке данных оно, как правило, показывает плохие результаты. |
| Сложные модели с множеством параметров | Глубокие сетевые слои, содержащие большое количество нейронов и связей. | Способно моделировать чрезвычайно сложные и нелинейные зависимости, обладая огромным потенциалом. | Обучение занимает чрезвычайно много времени и требует мощных вычислительных ресурсов (например, GPU), а развертывание модели также требует определенной вычислительной мощности. |
| Плохая интерпретируемость | Трудно понять, почему модель вынесла то или иное суждение. | - | Применение ограничено в областях, требующих строгого объяснения (например, одобрение кредитов и диагностика заболеваний). |
Простая аналогия: Глубокое обучение похоже навоспринимающее устройство с многослойной сетью обработки информации, которое может развиваться благодаря обширному наблюдению, но процесс, посредством которого оно приходит к выводам, не очень прозрачен.
Часть 3: Ключевое сравнение и как выбрать
Теперь давайте поставим их рядом для прямого сравнения и дадим рекомендации по выбору.
Сравнительная таблица ключевых различий
| Критерий сравнения | Традиционное машинное обучение | Глубокое обучение |
|---|---|---|
| Зависимость от данных | Сравнительно низкие требования к объёму данных; подходит для малых и средних наборов данных. | Крайне сильно зависит от больших данных; чем больше данных, тем обычно лучше производительность. |
| Обработка признаков | ВручнуюПроектирование признаков — ключевой момент и основное бремя. | АвтоматическиВыполняет извлечение и абстрагирование признаков. |
| Вычислительные ресурсы | Обычно эффективно работает на CPU; низкие требования. | Требует мощных GPU для обучения; высокие вычислительные затраты. |
| Интерпретируемость модели | Хорошо; процесс принятия решений относительно прозрачен. | Плохо; часто рассматривается как "модель чёрного ящика". |
| Предметная область | Хорошо справляется сструктурированными данными(табличные данные, сценарии с чётко выраженными признаками). | Хорошо справляется снеструктурированными данными(изображения, аудио, текст, видео). |
| Время обучения | Относительно короткое: от минут до часов. | Обычно очень долгое: от часов до недель или даже дольше. |
| Порог входа | Относительно низкий; прототипы легко понять и реализовать. | Относительно высокий; требует понимания сложных знаний, таких как нейронные сети и настройка гиперпараметров. |
Практическое руководство по выбору: что мне использовать?
Можно придерживаться такого подхода к принятию решений:
Какого типа ваши данные?
- Если этоструктурированные табличные данные(например, Excel-таблицы со столбцами вроде возраста, дохода, истории покупок), отдайте предпочтение традиционному машинному обучению (например, градиентному бустингу над деревьями XGBoost, случайным лесам).
- Если этоданные изображений, речи, текста или последовательностей, глубокое обучение (CNN, RNN, Transformer) обычно является лучшим выбором.
Сколько у вас данных?
- Когда объём данных ограничен (от тысяч до десятков тысяч образцов), традиционное машинное обучение обычно оказывается более устойчивым.
- При огромных объёмах данных (сотни тысяч или больше) мощь глубокого обучения может раскрыться в полной мере.
Есть ли у вас требования к интерпретируемости модели?
- В таких сценариях, как финансовый риск-контроль и медицинская диагностика с поддержкой, где вы должны быть способны объяснить, почему кредит был отклонён или почему подозревается это заболевание, традиционное машинное обучение — более безопасный выбор.
- В таких сценариях, как классификация изображений, голосовые ассистенты и рекомендательные системы, где в приоритете производительность и допустимы модели чёрного ящика, преимущество у глубокого обучения.
А что насчёт ваших вычислительных ресурсов?
- Если у вас нет мощного GPU и достаточного времени, начать с традиционного машинного обучения — более практичный выбор.
Резюме в одном предложении:Традиционное машинное обучение — это искусство анализа данных, тогда как глубокое обучение — это наука восприятия и представления.Они не заменяют друг друга, а дополняют: это взаимодополняющие наборы инструментов. Хороший специалист по ИИ должен выбирать наиболее подходящий инструмент из набора в зависимости от конкретной задачи.
Другие расширения