Apprentissage profond vs apprentissage automatique traditionnel
Imaginez que vous enseignez à un enfant à reconnaître des chats et des chiens. L'approche traditionnelle pourrait être : vous sortez un livre d'images, vous pointez les images et dites ceci est un chat, il a des oreilles pointues, des moustaches et une longue queue ; ceci est un chien, ses oreilles peuvent tomber, et son nez est plus long. Vous dites explicitement à l'enfant lesrègles et caractéristiques distinctives。
L'autre approche consiste à : vous montrez à l'enfant des milliers d'images de chats et de chiens, en lui disant simplement si chaque image est un chat ou un chien. Après suffisamment d'observations, le cerveau de l'enfant résumera lui-même les caractéristiques distinctives indicibles et complexes des chats et des chiens, telles que la texture du pelage, l'expression des yeux et la silhouette du corps. Cette approche est plus proche delaisser les données parler d'elles-mêmes。
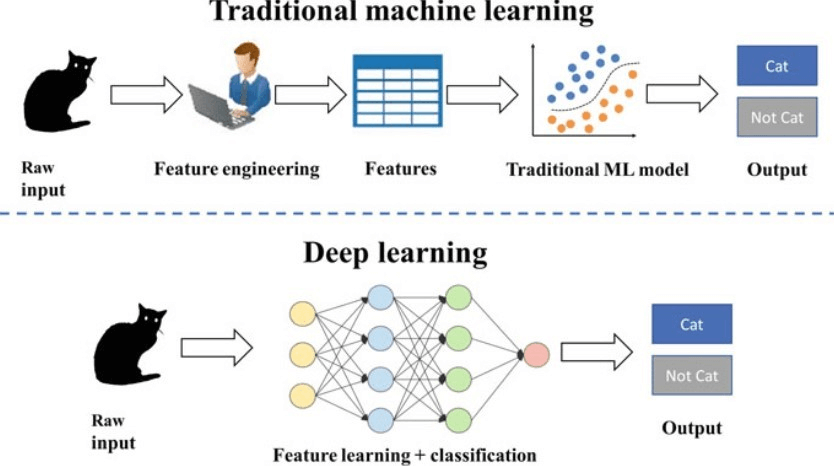
Ces deux méthodes d'enseignement correspondent exactement à deux paradigmes importants du domaine de l'apprentissage automatique :l'apprentissage automatique traditionneletl'apprentissage profond. Cet article analysera clairement les idées fondamentales, les principes de fonctionnement, les avantages et inconvénients, ainsi que les scénarios d'application des deux pour les débutants, vous aidant à acquérir une compréhension globale et à choisir une direction pour la suite de votre apprentissage.
Partie 1 : Apprentissage automatique traditionnel — L'analyste basé sur les règles et les caractéristiques
L'apprentissage automatique traditionnel peut être considéré comme un analyste qui a besoin d'instructions claires et de données structurées.
Qu'est-ce que l'apprentissage automatique traditionnel ?
L'apprentissage automatique traditionnel est un ensemble d'algorithmes dont l'idée centrale est :apprendre des motifs (modèles) à partir de données et utiliser ces motifs pour prédire ou prendre des décisions sur de nouvelles données. Son succès dépend fortement d'une condition préalable et d'une étape critique :ingénierie des caractéristiques。
Flux de travail principal
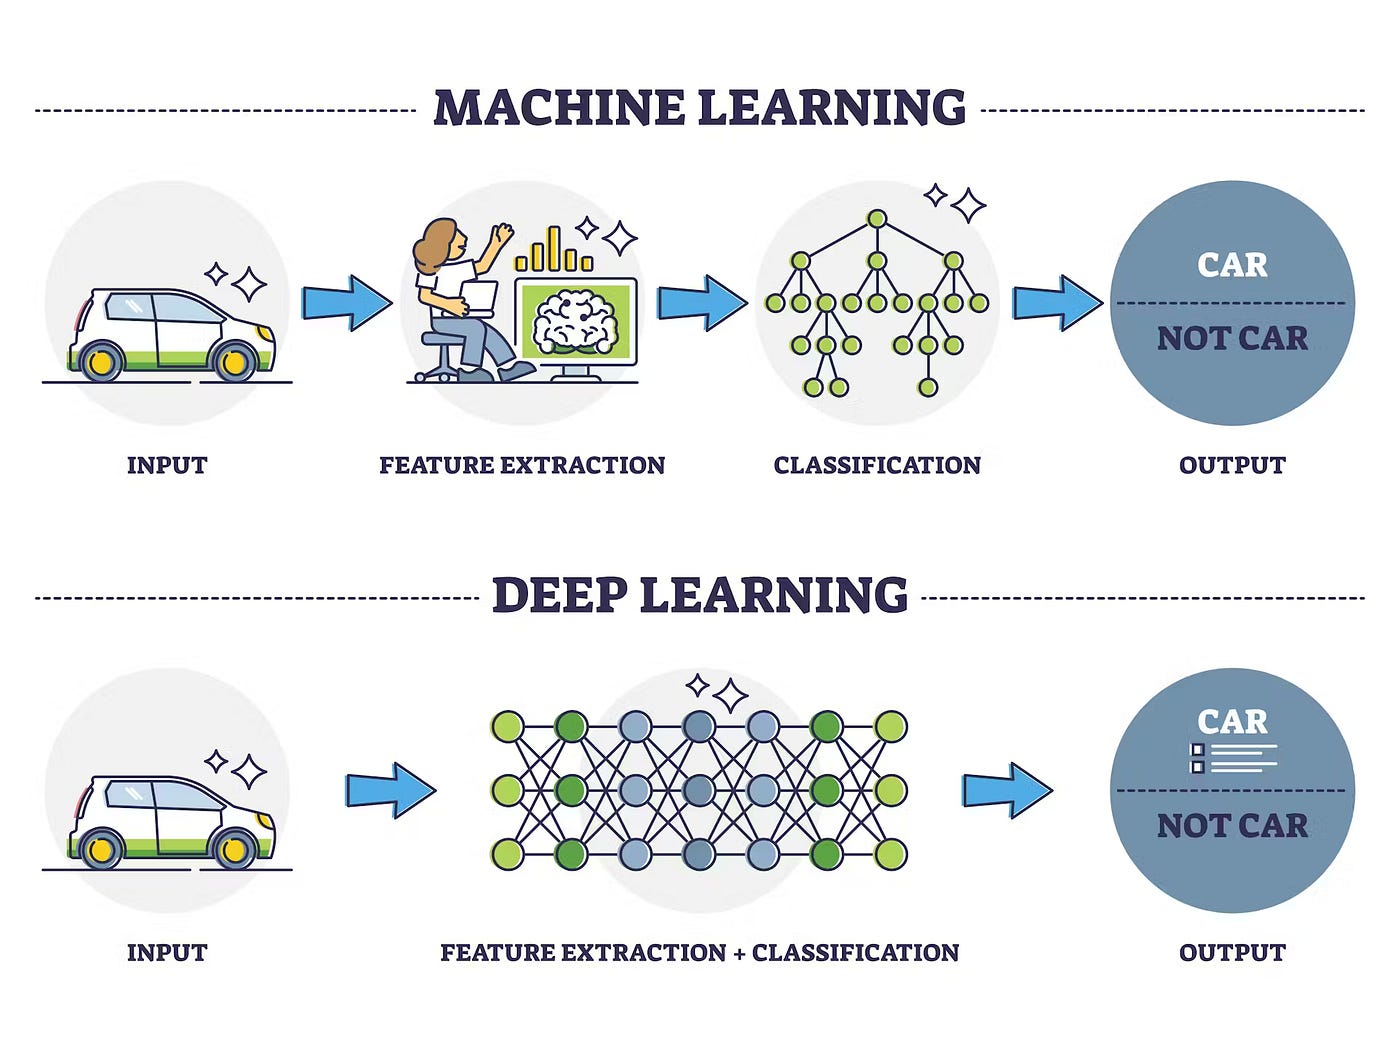
Comprenons intuitivement le processus de fonctionnement de l'apprentissage automatique traditionnel à l'aide d'un diagramme de flux :
Analyse du flux :
- Ingénierie des caractéristiques: C'est l'étape centrale et la plus dépendante de l'expertise humaine. Vous devez extraire des caractéristiques quantifiables utiles à la résolution du problème à partir de données brutes (par exemple, les pixels d'une image, les mots d'un texte). Par exemple, dans la détection de spam, les caractéristiques peuvent inclure la présence du mot « free » ou le fait que l'adresse de l'expéditeur figure dans la liste de contacts.
- Sélection et entraînement de l'algorithme: Alimentez l'algorithme sélectionné avec les données de caractéristiques traitées (par exemple, machine à vecteurs de support, SVM, ou arbre de décision). L'algorithme tentera de trouver une fonction ou une règle qui peut le mieux prédire le résultat (par exemple, spam ou non) en se basant sur ces caractéristiques.
- Prédiction: Lorsqu'un nouvel e-mail arrive, le système extrait d'abord les mêmes caractéristiques, puis les remet au modèle entraîné pour qu'il les juge.
Principales caractéristiques, avantages et inconvénients
| Caractéristique | Description | Avantages | Inconvénients |
|---|---|---|---|
| Forte dépendance à l'ingénierie des caractéristiques | La limite supérieure de la performance du modèle est déterminée par la qualité des caractéristiques. | Forte interprétabilité, et les connaissances d'experts humains peuvent être intégrées. | Nécessite beaucoup de connaissances du domaine et de temps pour la conception et l'extraction des caractéristiques ; coût élevé. |
| Modèles relativement simples | On utilise généralement des modèles linéaires, des modèles arborescents, etc. | Vitesse d'entraînement rapide, nécessitant moins de ressources de calcul. | Le traitement desdonnées non structurées(images, audio, langage naturel) est limité, ce qui rend difficile la capture de motifs profonds et complexes. |
| Bonne interprétabilité | Vous pouvez comprendre comment le modèle prend des décisions (par ex. le chemin de règles d'un arbre de décision). | Crucial dans les domaines qui exigent une explication des décisions, tels que la finance et la santé. | Parfois, une partie de la précision de prédiction est sacrifiée au nom de l'interprétabilité. |
Analogie simple: L'apprentissage automatique traditionnel est comme unanalyste qui dispose de formules puissantes et d'outils statistiques, mais pour qui vous devez préparer vous-même tous les supports d'analyse.。
Partie 2 : Apprentissage profond — Le percepteur qui apprend automatiquement
L'apprentissage profond est un sous-domaine de l'apprentissage automatique qui tente d'imiter le fonctionnement des neurones du cerveau humain, permettant aux machines d'apprendre automatiquement des représentations de caractéristiques à plusieurs niveaux à partir de données brutes.
Qu'est-ce que l'apprentissage profond ?
Le cœur de l'apprentissage profond réside dansles réseaux de neurones artificiels, en particulier les réseaux de neurones profonds à nombreuses couches. Sa plus grande caractéristique est qu'il peut apprendrede bout en bout: vous saisissez les données les plus brutes (par ex. les pixels bruts d'une image), et il peut produire le résultat final (par ex. la catégorie de l'image). Le processus complexe d'extraction de caractéristiques entre les deux est automatiquement réalisé par le réseau.
Architecture centrale de fonctionnement
L'apprentissage profond, en particulier les réseaux neuronaux convolutionnels pour la reconnaissance d'images, suit un processus d'apprentissage hiérarchique qui va du superficiel au profond :

Analyse de l'architecture :
- Apprentissage hiérarchique des caractéristiques: La première couche du réseau peut uniquement apprendre à reconnaîtredes bords et des coins. La deuxième couche combine ces bords et apprend à reconnaîtredes textures et des formes simples(comme des cercles, des rayures). Les couches plus profondes combinent ensuite ces formes simples endes parties et des objets complexes(comme des yeux, des portières de voiture). Les couches finales combinent ces parties enconcepts d'objets complets(comme des chats, des voitures).
- Apprentissage de bout en bout: Vous n'avez pas besoin de dire au réseau ce que sont les bords ou les textures. Il vous suffit de fournir une grande quantité de données brutes étiquetées (images et étiquettes correspondantes chat/chien). Grâce à l'algorithme derétropropagation, le réseau ajuste automatiquement ses millions, voire milliards, de paramètres internes, et apprend par lui-même quels motifs de combinaison de pixels correspondent aux chats et lesquels aux chiens.
Principales caractéristiques, avantages et inconvénients
| Caractéristique | Description | Avantages | Inconvénients |
|---|---|---|---|
| Ingénierie automatique des caractéristiques | Peut apprendre automatiquement des caractéristiques abstraites à plusieurs niveaux à partir de données brutes. | Élimine l'ingénierie manuelle fastidieuse des caractéristiques ; offre des performances exceptionnelles, en particulier dans le traitement des images, de la parole et du texte. | Comme une "boîte noire", le processus interne de prise de décision est difficile à expliquer. |
| Forte capacité à traiter des données non structurées | Naturellement adapté au traitement de données complexes telles que les pixels, les ondes sonores et les séquences de mots. | Atteint ou même dépasse les performances humaines dans des domaines tels que la vision par ordinateur, le traitement du langage naturel et la reconnaissance vocale. | Nécessited'énormes quantités de donnéespour l'entraînement ; lorsque les données sont insuffisantes, il a tendance à obtenir de mauvaises performances. |
| Modèles complexes avec de nombreux paramètres | Couches de réseau profond contenant un grand nombre de neurones et de connexions. | Peut modéliser des relations extrêmement complexes et non linéaires, avec un énorme potentiel. | L'entraînement prend extrêmement longtemps et nécessite de puissantes ressources de calcul (par ex., GPU), et le déploiement du modèle nécessite également une certaine puissance de calcul. |
| Faible interprétabilité | Il est difficile de comprendre pourquoi le modèle rend un jugement particulier. | - | L'application est limitée dans les domaines qui exigent une explication stricte (tels que l'approbation de crédit et le diagnostic de maladie). |
Analogie simple: L'apprentissage profond est comme unperceveur avec un réseau multicouche de traitement de l'information qui peut se développer grâce à une observation approfondie, mais le processus par lequel il parvient à des conclusions n'est pas très transparent.
Partie 3 : Comparaison essentielle et comment choisir
Maintenant, mettons les deux côte à côte pour une comparaison directe et donnons des suggestions de sélection.
Tableau comparatif des différences fondamentales
| Dimension de comparaison | Apprentissage automatique traditionnel | Apprentissage profond |
|---|---|---|
| Dépendance aux données | Exigence relativement faible en volume de données ; adapté aux ensembles de données de petite et moyenne taille. | Extrêmement dépendant des mégadonnées ; plus il y a de données, meilleures sont généralement les performances. |
| Traitement des caractéristiques | ManuelL'ingénierie des caractéristiques est essentielle et constitue le principal fardeau. | AutomatiqueEffectue l'extraction et l'abstraction des caractéristiques. |
| Ressources de calcul | Fonctionne généralement efficacement sur CPU ; besoins faibles. | Nécessite des GPU puissants pour l'entraînement ; coût de calcul élevé. |
| Interprétabilité du modèle | Bon ; le processus de décision est relativement transparent. | Médiocre ; souvent considéré comme un « modèle boîte noire ». |
| Domaine d'application | Bon pour traiter lesdonnées structurées(données tabulaires, scénarios avec des caractéristiques claires). | Bon pour traiter lesdonnées non structurées(images, audio, texte, vidéo). |
| Temps d'entraînement | Relativement court, de quelques minutes à quelques heures. | Généralement très long, de quelques heures à quelques semaines, voire plus. |
| Barrière à l'entrée | Relativement faible ; facile de comprendre et de mettre en œuvre des prototypes. | Relativement élevée ; nécessite de comprendre des connaissances complexes telles que les réseaux de neurones et le réglage des hyperparamètres. |
Guide pratique de sélection : lequel dois-je utiliser ?
Vous pouvez suivre cette approche de prise de décision :
Quel est le type de vos données ?
- S'il s'agit dedonnées tabulaires structurées(comme des feuilles Excel contenant des colonnes telles que l'âge, le revenu, l'historique d'achat), privilégiez l'apprentissage automatique traditionnel (par exemple, les arbres de gradient boosting XGBoost, les forêts aléatoires).
- S'il s'agit dedonnées d'image, de parole, de texte ou de séquence, l'apprentissage profond (CNN, RNN, Transformer) est généralement le meilleur choix.
De combien de données disposez-vous ?
- Lorsque le volume de données est limité (de quelques milliers à quelques dizaines de milliers d'échantillons), l'apprentissage automatique traditionnel a tendance à être plus robuste.
- Avec des quantités massives de données (des centaines de milliers ou plus), la puissance de l'apprentissage profond peut être pleinement libérée.
Avez-vous des exigences concernant l'interprétabilité du modèle ?
- Dans des scénarios tels que le contrôle des risques financiers et le diagnostic médical assisté, où vous devez pouvoir expliquer pourquoi un prêt a été refusé ou pourquoi cette maladie est suspectée, l'apprentissage automatique traditionnel est le choix le plus sûr.
- Dans des scénarios tels que la classification d'images, les assistants vocaux et les systèmes de recommandation, où la performance est prioritaire et où les modèles de type boîte noire sont acceptables, l'apprentissage profond a l'avantage.
Qu'en est-il de vos ressources de calcul ?
- Si vous ne disposez pas d'un GPU puissant et de suffisamment de temps, commencer par l'apprentissage automatique traditionnel est le choix le plus pratique.
Résumé en une phrase:L'apprentissage automatique traditionnel est l'art de l'analyse de données, tandis que l'apprentissage profond est la science de la perception et de la représentation.Ils ne sont pas des substituts l'un à l'autre mais des boîtes à outils complémentaires. Un bon praticien de l'IA devrait choisir l'outil le plus approprié dans la boîte à outils en fonction du problème spécifique.
Autres extensions