Apprentissage ensembliste
Dans le domaine de l’apprentissage automatique, l’apprentissage d’ensemble est une technique qui améliore les performances globales en combinant les résultats de prédiction de plusieurs modèles.
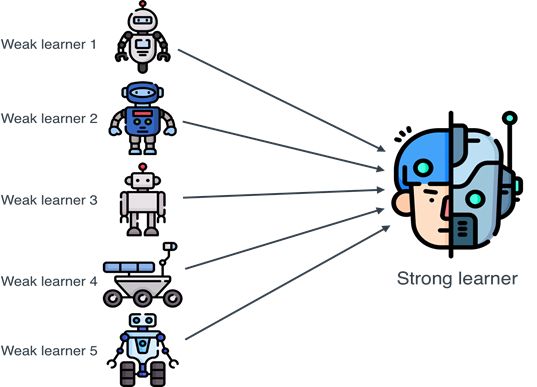
L’idée centrale de l’apprentissage d’ensemble est que « trois cordonniers mettant leurs talents en commun valent Zhuge Liang », c’est-à-dire que combiner plusieurs apprenants faibles peut construire un apprenant fort.
L’objectif principal de l’apprentissage d’ensemble est d’améliorer la précision et la robustesse des prédictions en combinant plusieurs modèles.
Les méthodes courantes d’apprentissage d’ensemble incluent :
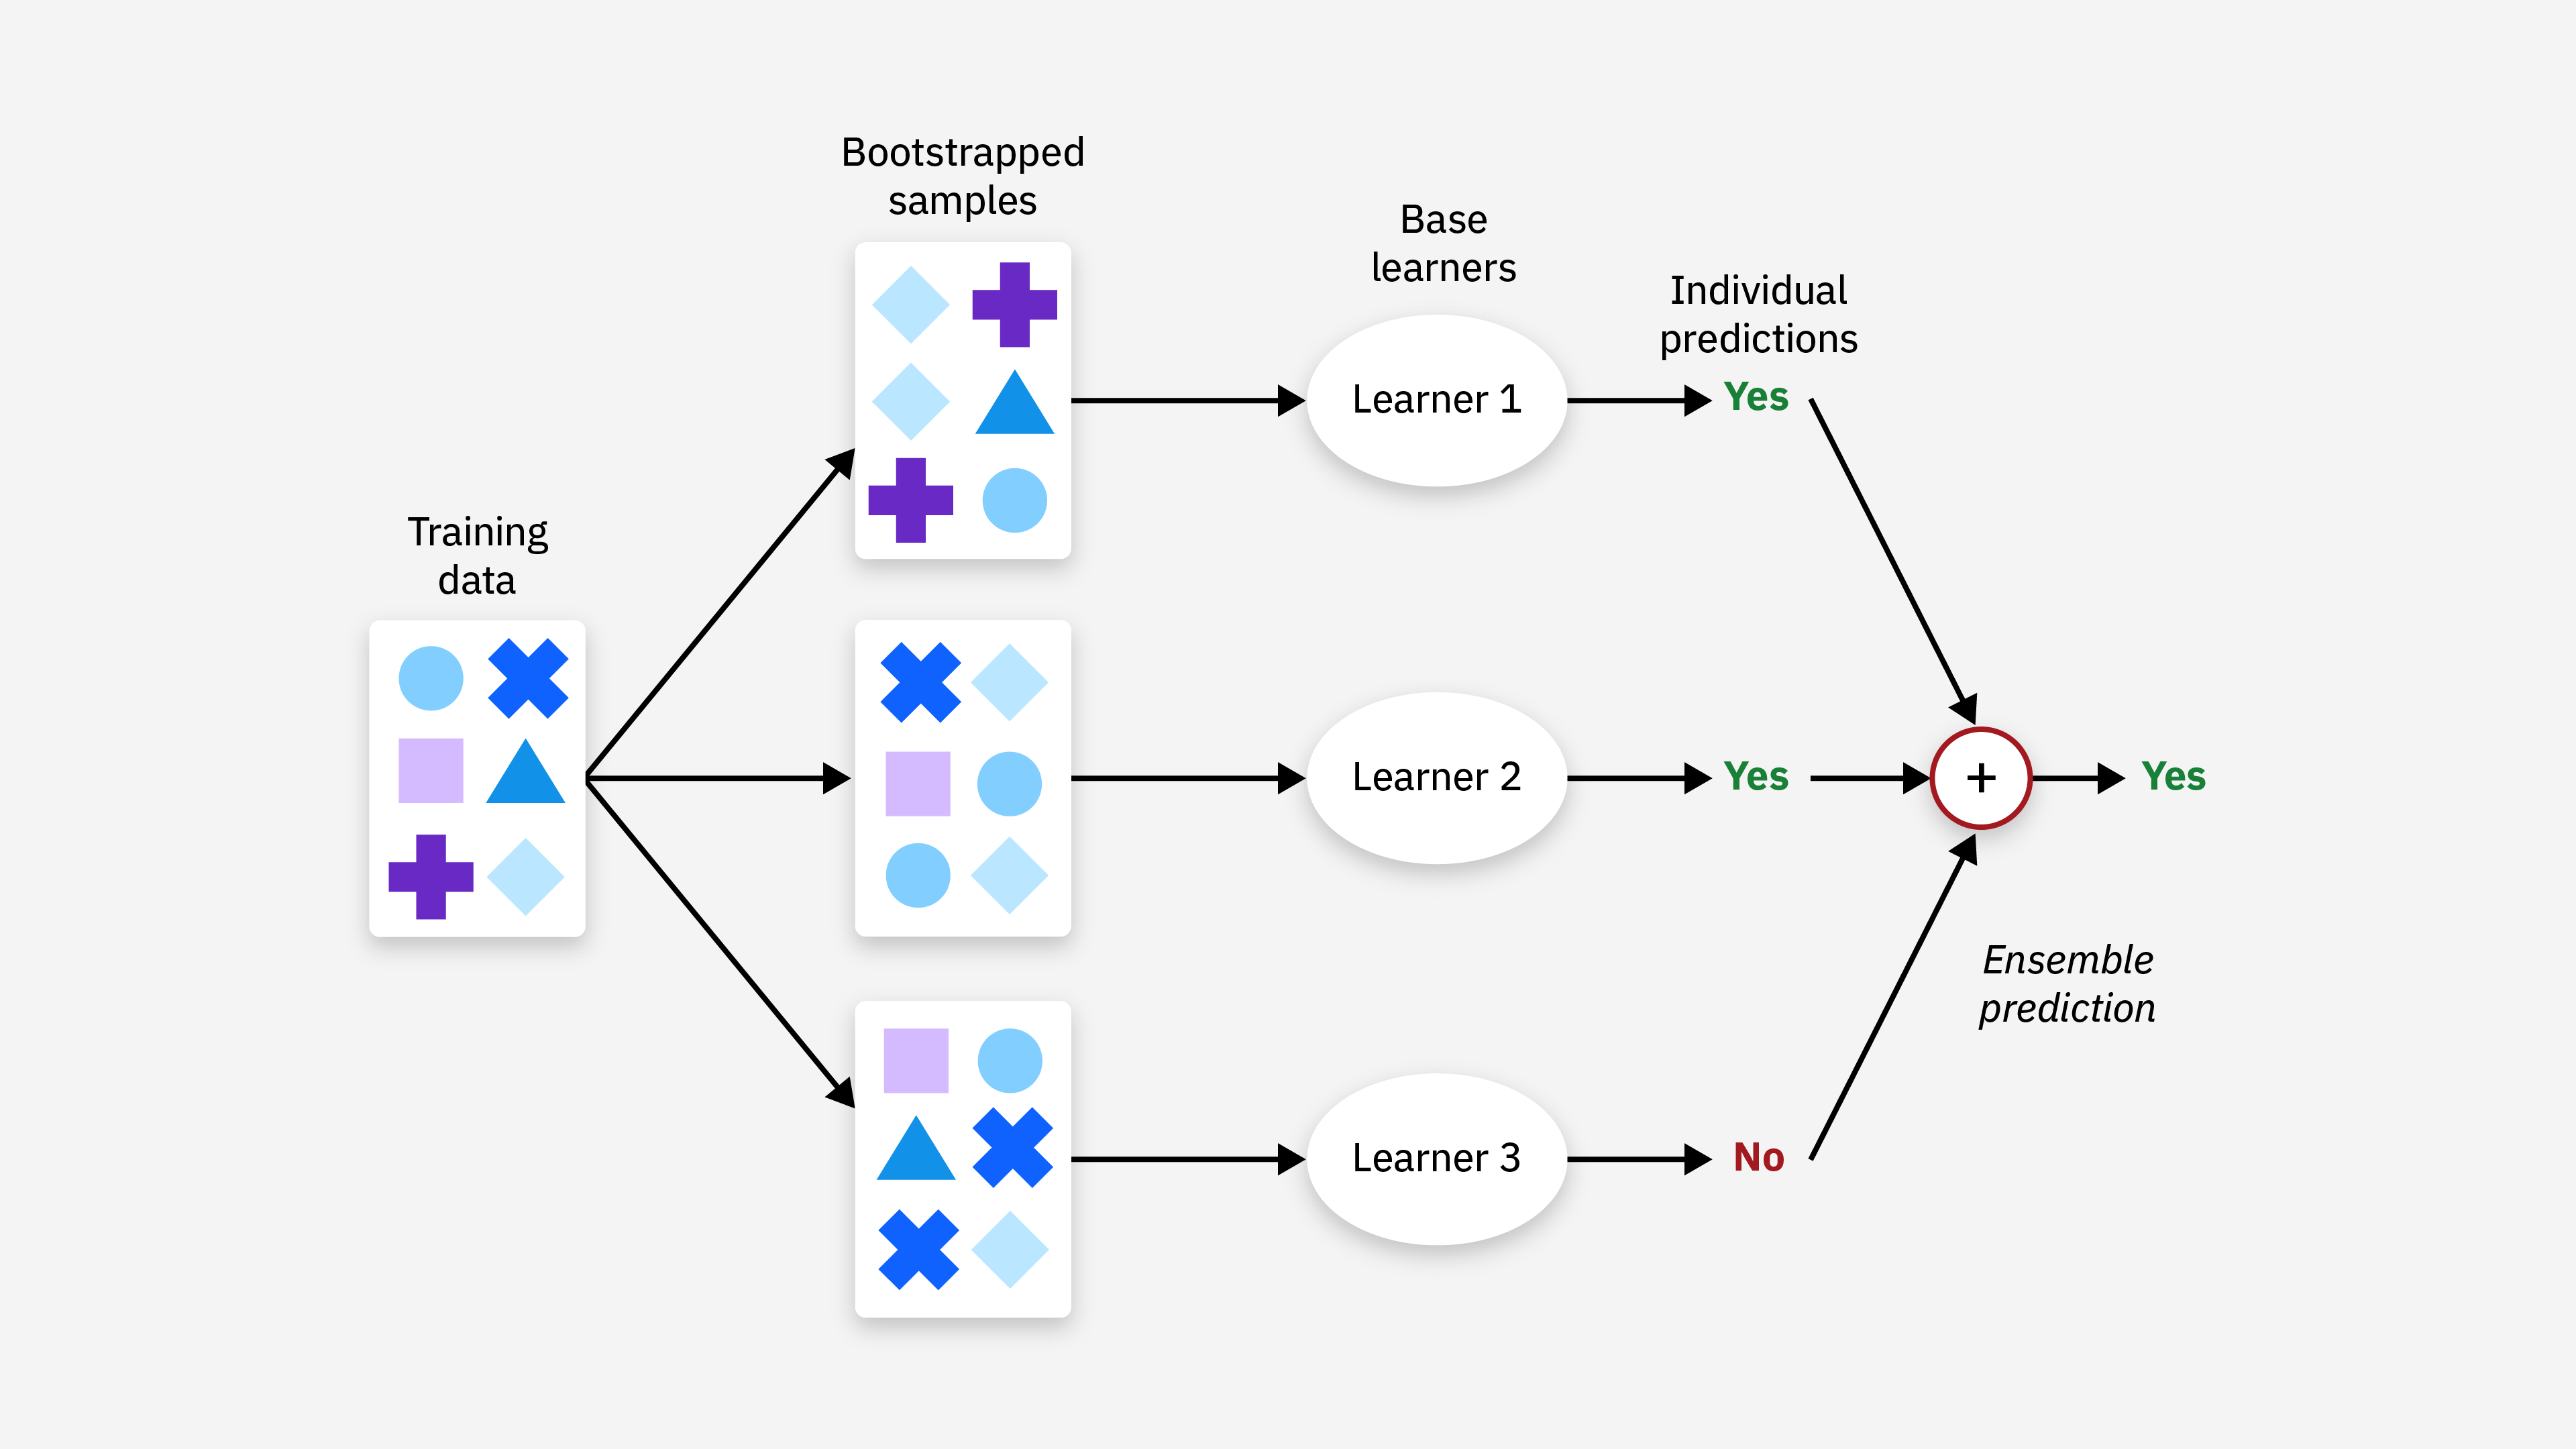
- Bagging: Générer plusieurs ensembles d'entraînement par échantillonnage bootstrap, puis entraîner plusieurs modèles séparément, et enfin obtenir le résultat final par vote ou moyenne.
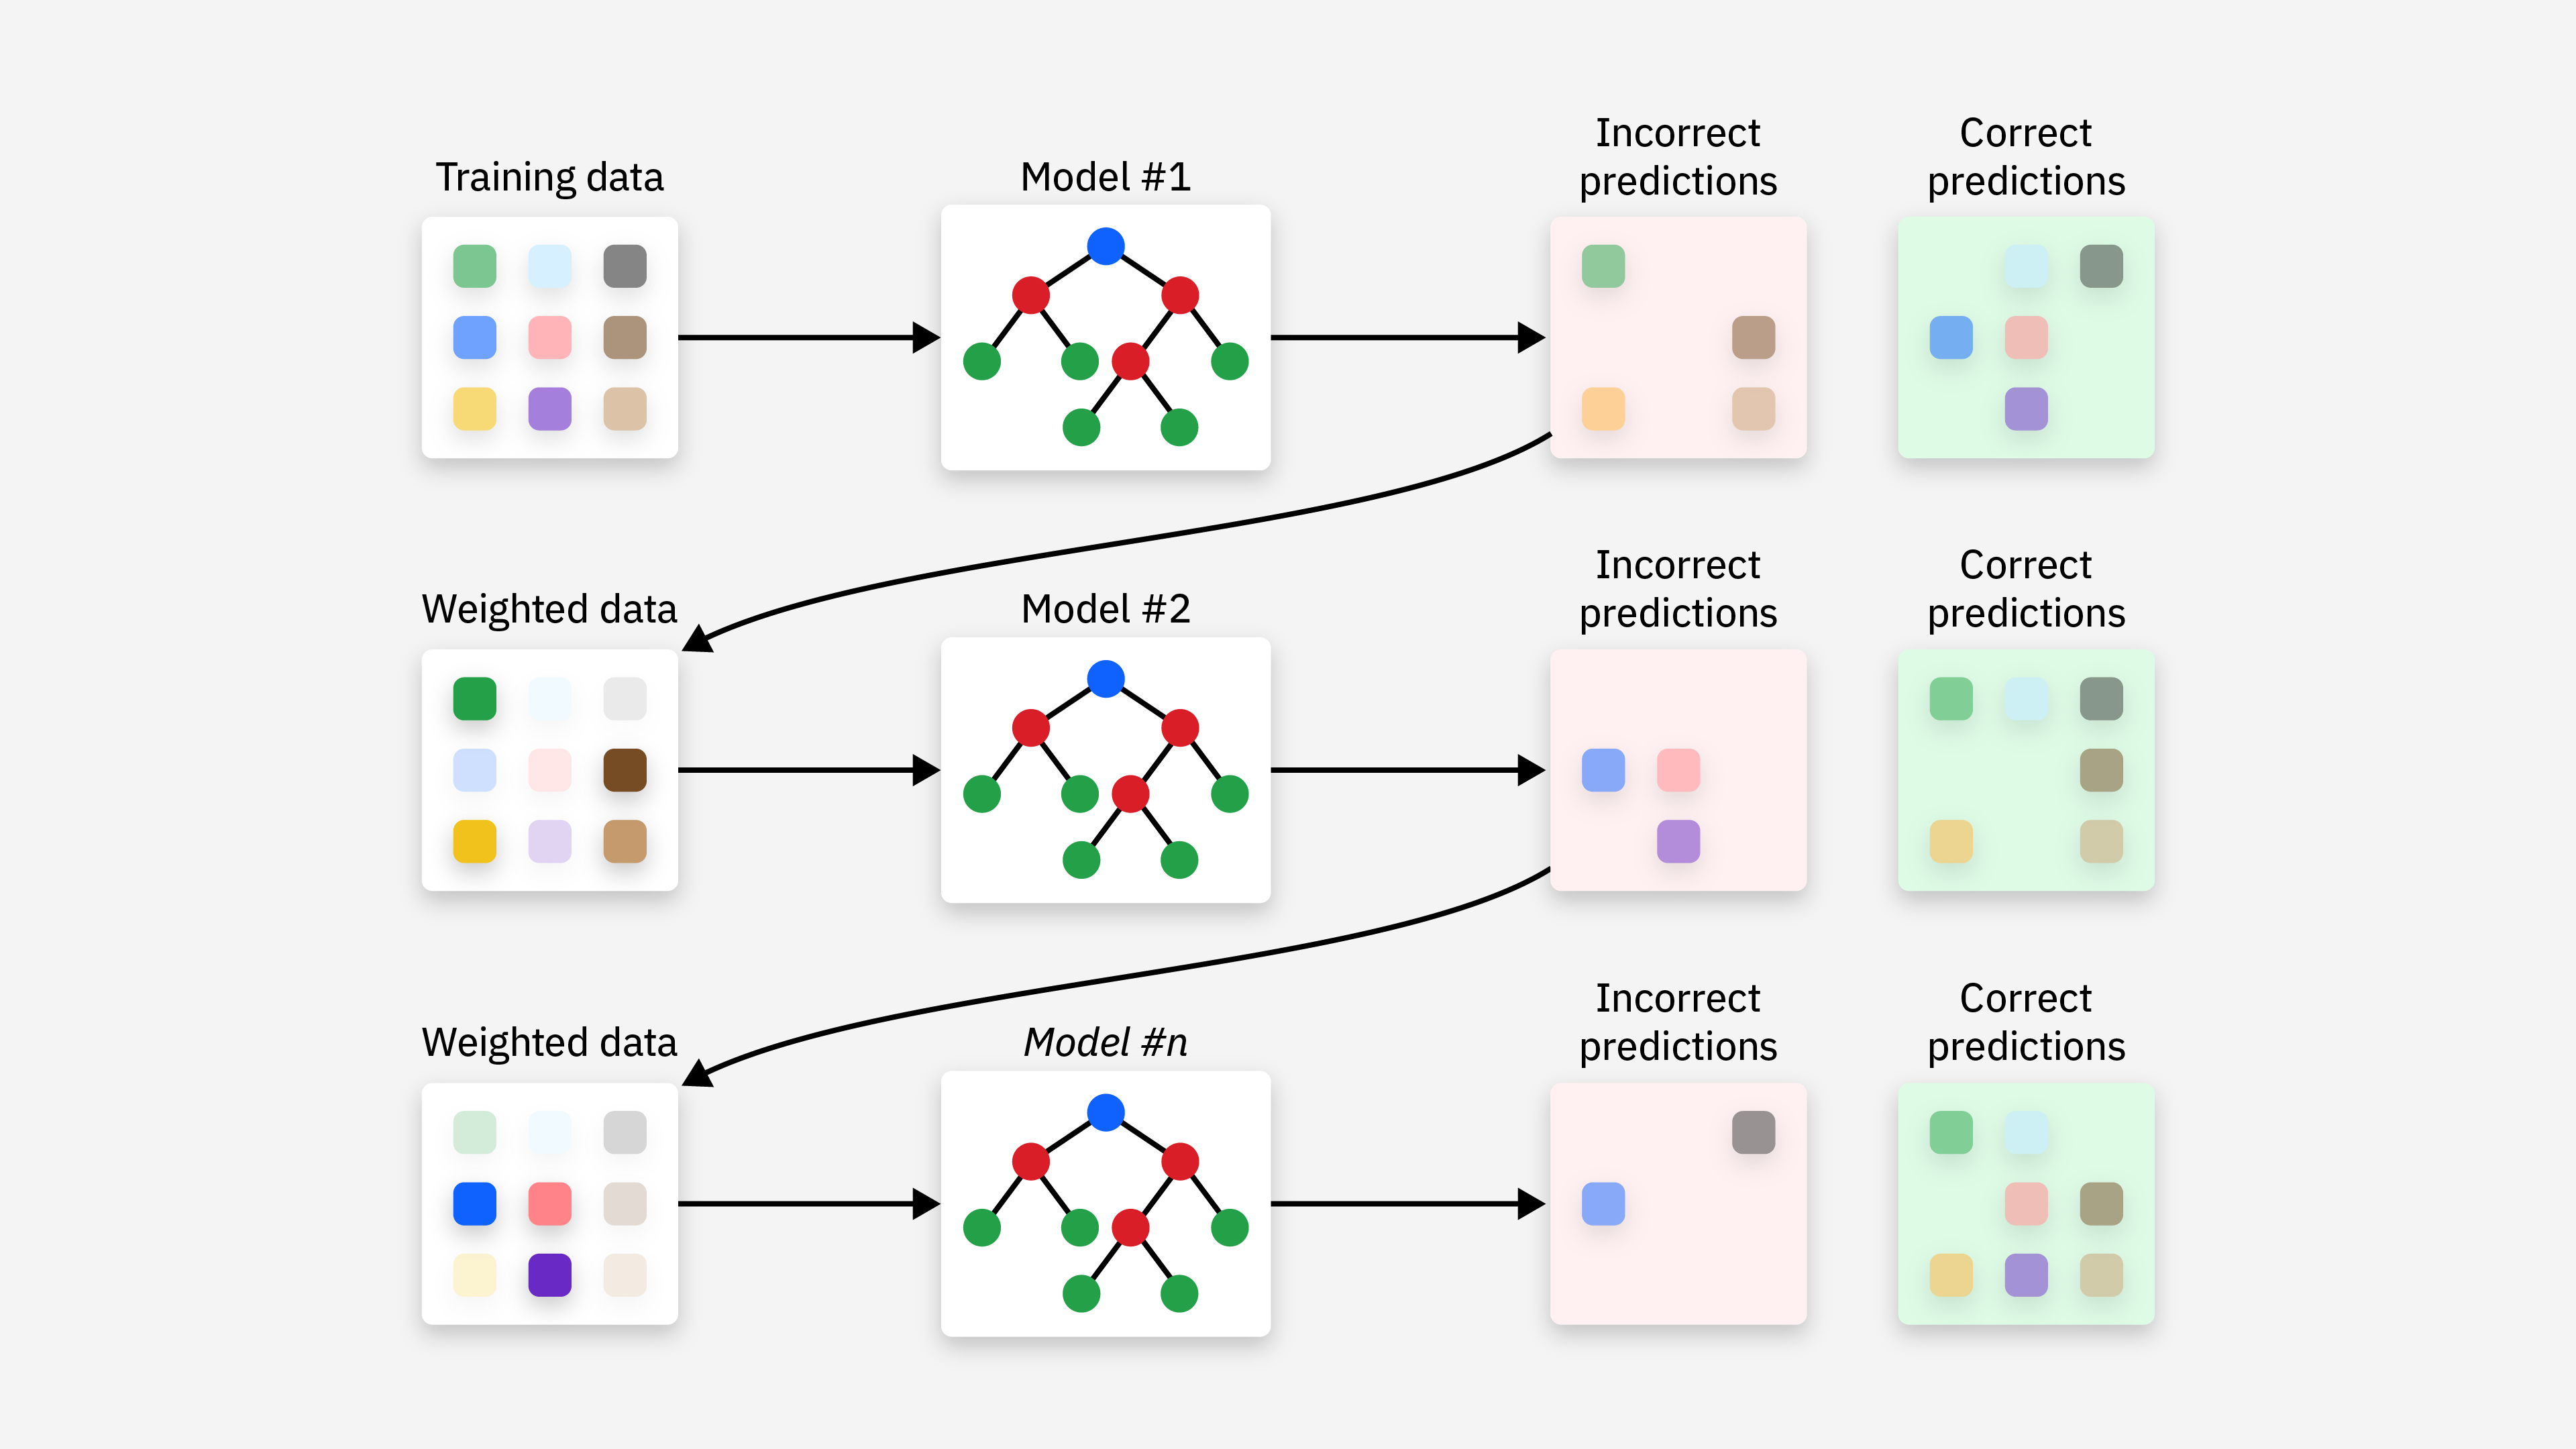
- Boosting: Entraîner plusieurs modèles de manière itérative, chaque modèle tente de corriger les erreurs du modèle précédent, et finalement le résultat est obtenu par vote pondéré.
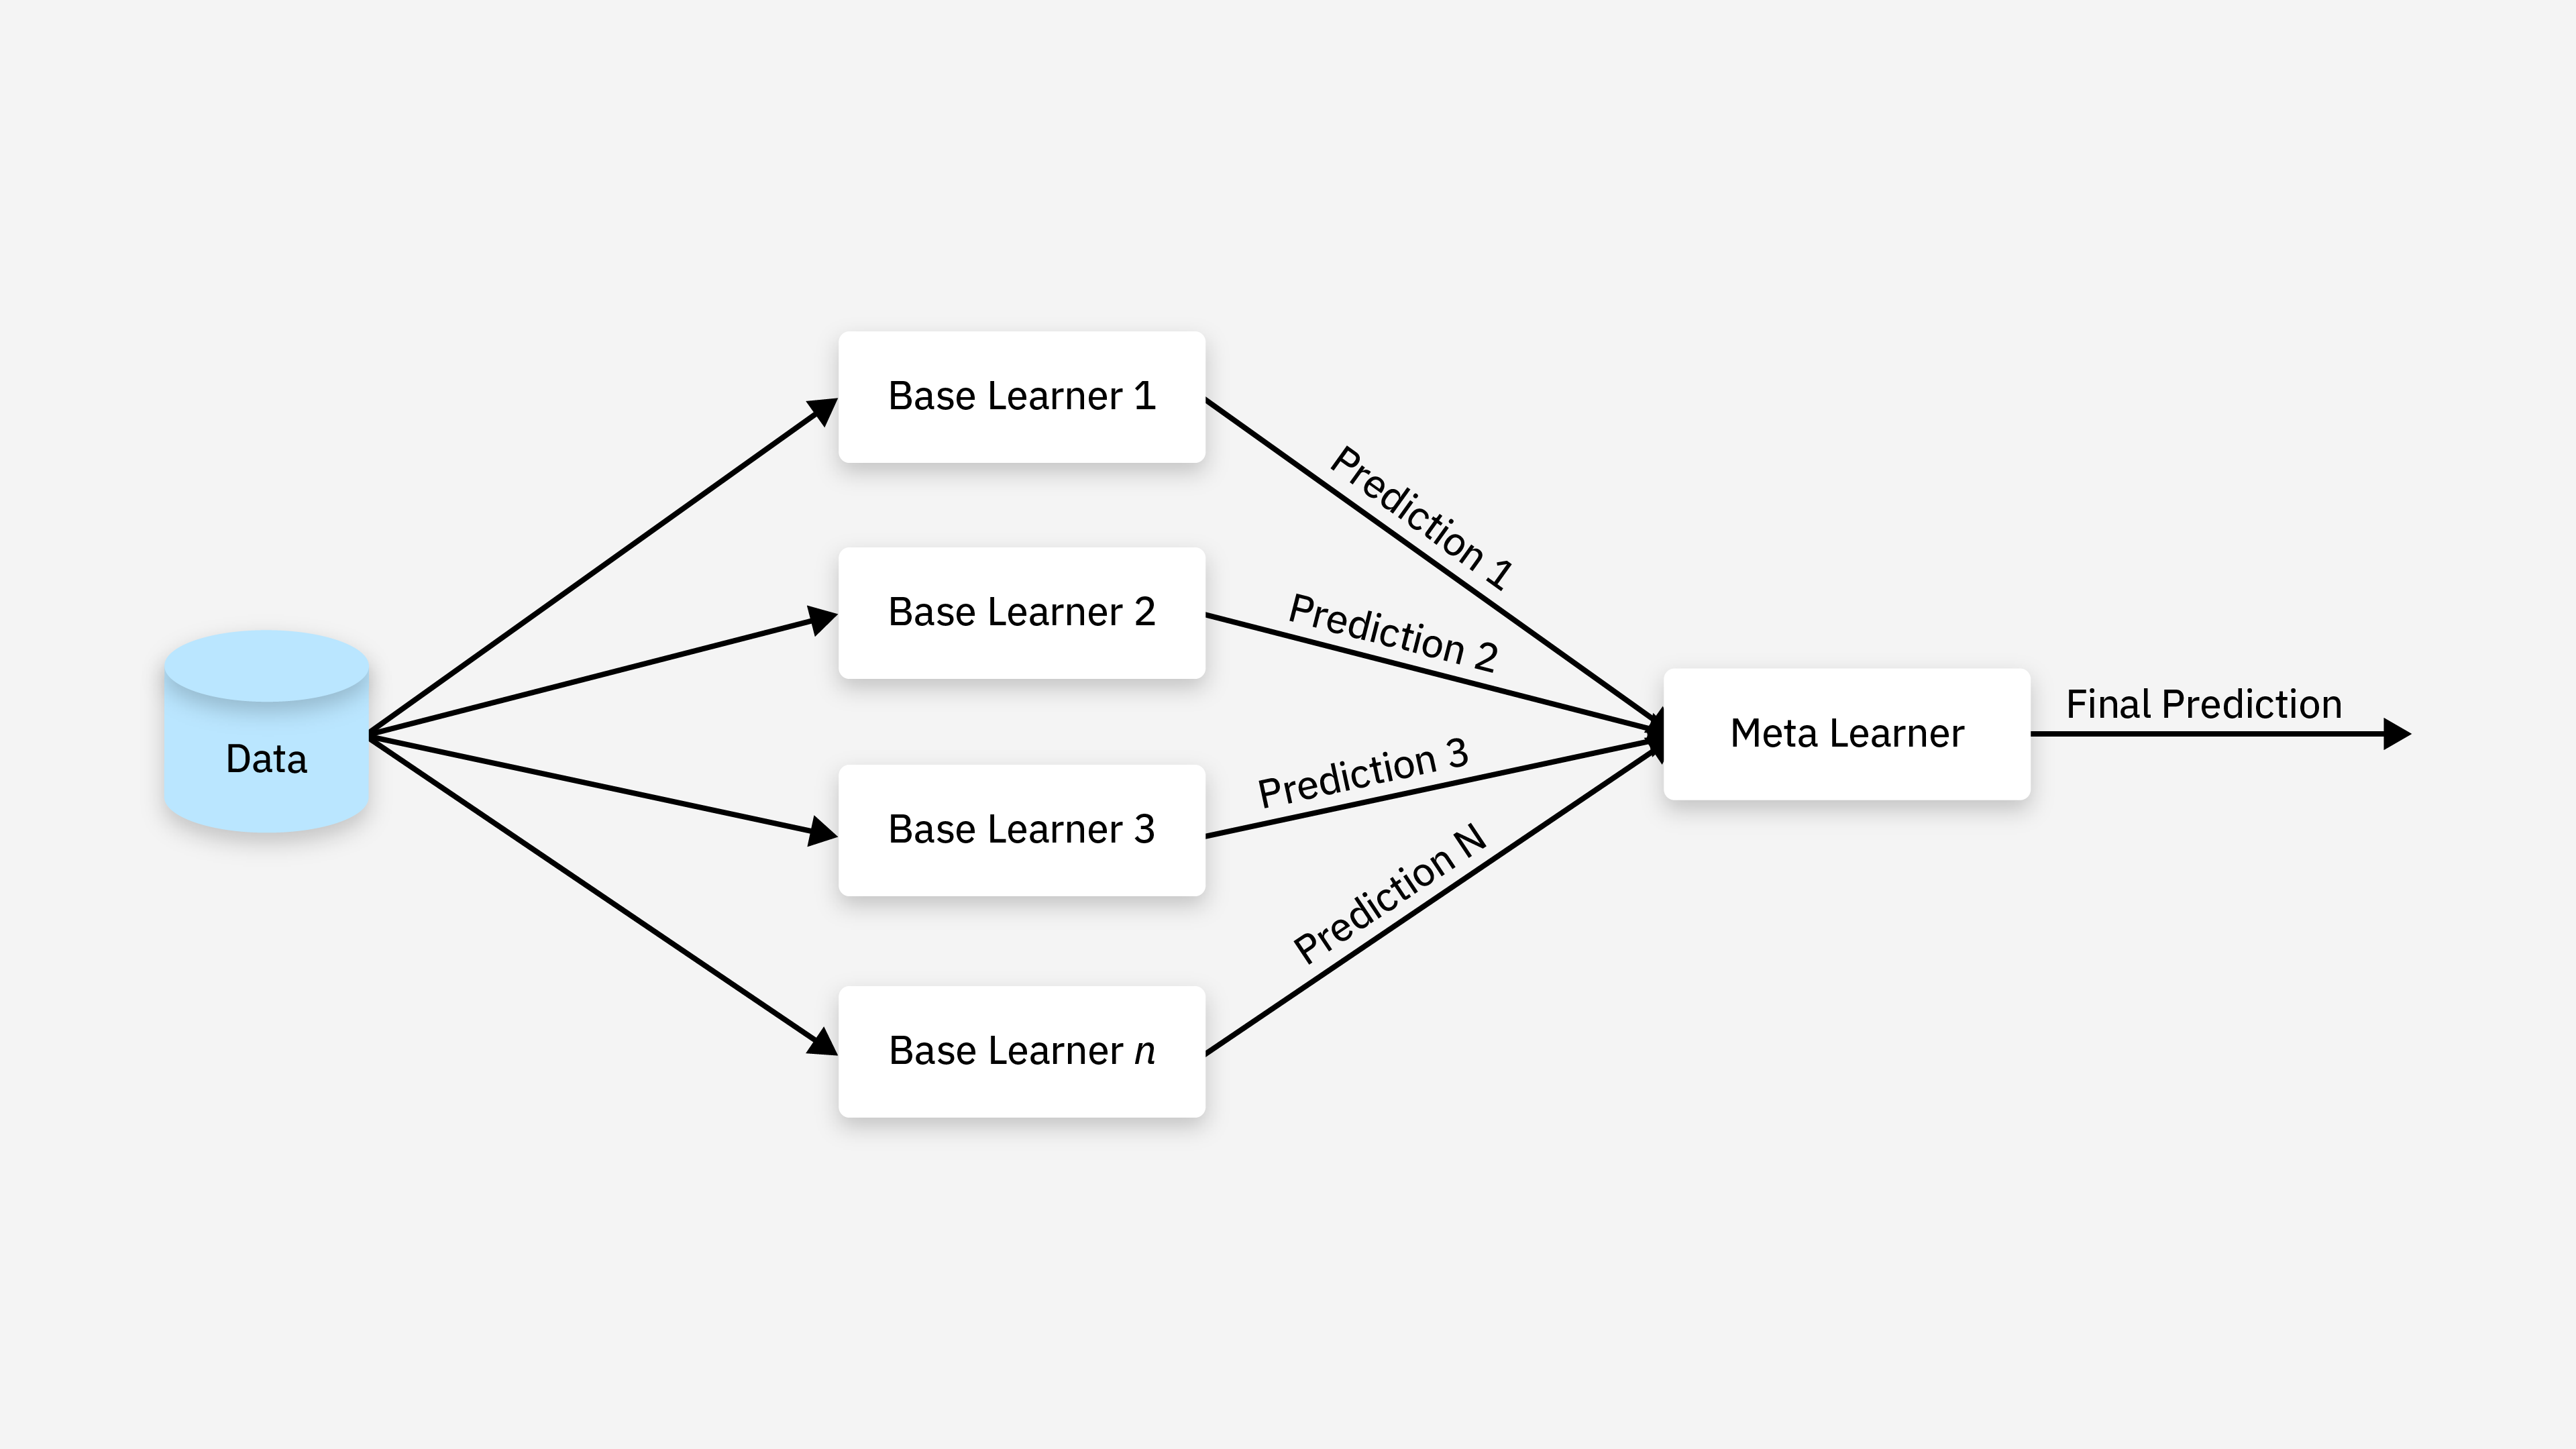
- Stacking: Entraîner plusieurs modèles différents, puis utiliser les sorties de ces modèles comme nouvelles caractéristiques, et entraîner un méta-modèle pour la prédiction finale.
1. Bagging(Bootstrap Aggregating)
L'objectif du Bagging est d'améliorer les performances en réduisant la variance du modèle, et il convient aux modèles à forte variance et sujets au surapprentissage. Il est mis en œuvre via les étapes suivantes :
- Rééchantillonnage du jeu de données: Effectuer plusieurs échantillonnages aléatoires avec remise (bootstrap) sur le jeu de données d'entraînement, chaque échantillonnage produisant un sous-ensemble.
- Entraîner plusieurs modèles: Entraîner un apprenant de base (généralement le même type de modèle) sur chaque sous-ensemble.
- Fusionner les résultats: Combiner les résultats de plusieurs apprenants de base, généralement par vote (pour les problèmes de classification) ou par moyenne (pour les problèmes de régression).
Algorithmes typiques:
- Forêt aléatoire: La forêt aléatoire est une implémentation classique du Bagging. Elle réduit le risque de surapprentissage en construisant plusieurs arbres de décision, chaque arbre sélectionnant aléatoirement des caractéristiques pendant l'entraînement.
Avantages:
- Cela peut réduire efficacement la variance et améliorer la stabilité du modèle.
- Convient aux modèles à forte variance, tels que les arbres de décision.
Inconvénients:
- Le processus d'entraînement prend beaucoup de temps car plusieurs modèles doivent être entraînés.
- Les résultats sont difficiles à interpréter car il n'existe pas de modèle unique.
2. Boosting
L'objectif du Boosting est d'améliorer les performances en réduisant le biais du modèle, et il convient aux apprenants faibles. L'idée centrale du Boosting est d'ajuster progressivement le poids de chaque modèle, en mettant l'accent sur les échantillons qui ont été mal classés par le tour précédent de modèles. Le Boosting est mis en œuvre via les étapes suivantes :
- Entraînement séquentiel: Les modèles sont entraînés l'un après l'autre, et chaque tour d'entraînement est ajusté en fonction des erreurs du tour précédent.
- Vote pondéré: La prédiction finale est la somme pondérée de toutes les prédictions des apprenants faibles, où les échantillons mal classés se voient attribuer des poids plus élevés.
- Combinaison de modèles: Le poids de chaque modèle est déterminé par ses performances au cours du processus d'entraînement.
Algorithmes typiques:
- AdaBoost(Adaptive Boosting): AdaBoost modifie les poids des échantillons, ce qui fait que chaque classifieur suivant accorde plus d'attention aux échantillons mal classés lors du tour précédent.
- Gradient Boosting Trees (GBT): GBT optimise itérativement la fonction objectif pour réduire progressivement le biais.
- XGBoost(Extreme Gradient Boosting): XGBoost est un algorithme efficace de gradient boosting, largement utilisé dans les compétitions de science des données, avec de solides performances et une optimisation poussée.
- LightGBM(Light Gradient Boosting Machine): LightGBM est un framework basé sur les arbres de gradient boosting. Comparé à XGBoost, il offre une vitesse d'entraînement plus rapide et une consommation de mémoire plus faible.
Avantages:
- Adapté aux modèles présentant un biais important, et peut améliorer efficacement la précision des prédictions.
- Performances solides, et il donne d'excellents résultats dans de nombreuses applications réelles.
Inconvénients:
- Il est sensible aux données bruitées et peut facilement conduire à un surapprentissage.
- Le processus d'entraînement est lent, en particulier avec de grands jeux de données.
3. Stacking(généralisation empilée)
Stacking est une méthode qui améliore la précision globale des prédictions en entraînant différents types de modèles et en combinant leurs prédictions. Son idée centrale est :
- Première couche (apprenants de base): Entraîner plusieurs apprenants de base de types différents (par exemple, arbres de décision, SVM, KNN, etc.) pour prédire les données.
- Deuxième couche (méta-apprenant): Utiliser les résultats de prédiction des apprenants de la première couche comme entrée, et entraîner un méta-apprenant (généralement une régression logistique, une régression linéaire, etc.) pour effectuer la prédiction finale.
Avantages:
- Différents types d'apprenants de base peuvent être utilisés pour capturer différents motifs dans les données.
- En théorie, il peut combiner les avantages de plusieurs modèles pour obtenir une capacité de prédiction plus forte.
Inconvénients:
- Le processus d'entraînement est complexe, car il nécessite l'entraînement de plusieurs modèles, et la manière de combiner les modèles doit également être conçue avec soin.
- Il est plus complexe que d'autres méthodes d'ensemble telles que Bagging et Boosting, et est sujet au surapprentissage.
Exemple de démonstration
Exemple
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Charger le jeu de données
iris = load_iris()
X, y = iris.data, iris.target
# Diviser le jeu de données en ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Créer un classifieur de forêt aléatoire
rf = RandomForestClassifier(n_estimators=100, random_state=42)
# Entraîner le modèle
rf.fit(X_train, y_train)
# Prédire
y_pred = rf.predict(X_test)
# Calculer la précision
accuracy = accuracy_score(y_test, y_pred)
print(f"Précision de la forêt aléatoire : {accuracy:.2f}")
Le résultat de sortie est le suivant :
随机森林的准确率: 1.00
Explication du code :
- Charger le jeu de données: Nous utilisons la
load_iris()fonction pour charger le jeu de données Iris classique. - Diviser le jeu de données en ensembles d'entraînement et de test: Utilisez la
train_test_split()fonction pour diviser le jeu de données en ensembles d'entraînement et de test. - Créer un classifieur de forêt aléatoire: Utilisez la
RandomForestClassifierclasse pour créer un classifieur de forêt aléatoire,n_estimators=100ce qui signifie que 100 arbres de décision sont utilisés. - Entraîner le modèle: Utilisez la
fit()méthode pour entraîner le modèle. - Prédire: Utilisez la
predict()méthode pour faire des prédictions sur l'ensemble de test. - Calculer l'exactitude: Utilisez la
accuracy_score()fonction pour calculer l'exactitude du modèle.
Boosting:AdaBoost
Principe de l'algorithme :L'idée centrale du Boosting est d'entraîner plusieurs modèles de manière itérative, chaque modèle tentant de corriger les erreurs du modèle précédent. AdaBoost (Adaptive Boosting) est l'un des algorithmes de Boosting les plus classiques.
Exemple
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
from sklearn.tree import DecisionTreeClassifier
# Charger le jeu de données
iris = load_iris()
X, y = iris.data, iris.target
# Diviser le jeu de données en ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Utiliser l'apprenant faible par défaut (arbre de décision) et spécifier l'algorithme SAMME
ada = AdaBoostClassifier(DecisionTreeClassifier(max_depth=1),
n_estimators=50,
random_state=42,
algorithm='SAMME')
# Entraîner le modèle
ada.fit(X_train, y_train)
# Prédire
y_pred = ada.predict(X_test)
# Calculer la précision
accuracy = accuracy_score(y_test, y_pred)
print(f"Précision d'AdaBoost : {accuracy:.2f}")
Le résultat de sortie est le suivant :
AdaBoost的准确率: 1.00
Explication du code :
- Charger le jeu de données: Utilisez la
load_iris()fonction pour charger le jeu de données Iris, contenant les données de caractéristiquesXet les données d'étiquettes.y。 - Diviser le jeu de données en ensembles d'entraînement et de test: Utilisez la
train_test_split()fonction pour diviser le jeu de données en ensembles d'entraînement et de test, l'ensemble de test représentant 30% et l'ensemble d'entraînement représentant 70%. - Créer un classificateur d'arbre de décision: Utilisez
DecisionTreeClassifier(max_depth=1)pour créer un classificateur d'arbre de décision avec une profondeur de 1, comme apprenant de base d'AdaBoost. - Créer un classificateur AdaBoost: Utilisez la
AdaBoostClassifier()classe pour créer un classificateur AdaBoost,n_estimators=50ce qui signifie que 50 apprenants faibles sont utilisés,algorithm='SAMME'et l'algorithme SAMME est spécifié. - Entraîner le modèle: Utilisez la
fit()méthode pour entraîner le modèle AdaBoost sur les données d'entraînement. - Prédire: Utilisez la
predict()méthode pour faire des prédictions sur l'ensemble de test, générant des étiquettes prédites.y_pred。 - Calculer l'exactitude: Utilisez la
accuracy_score()fonction pour calculer et afficher la précision des prédictions du modèle.
Stacking : empilement de modèles
Principe de l'algorithme :L'idée centrale du Stacking est d'entraîner plusieurs modèles différents, puis d'utiliser les sorties de ces modèles comme nouvelles caractéristiques, et d'entraîner un méta-modèle pour faire la prédiction finale.
Exemple
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.svm import SVC
from sklearn.datasets import load_iris
from sklearn.model_selection import train_test_split
from sklearn.metrics import accuracy_score
# Charger le jeu de données
iris = load_iris()
X, y = iris.data, iris.target
# Diviser le jeu de données en ensembles d'entraînement et de test
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# Définir les apprenants de base
estimators = [
('dt', DecisionTreeClassifier(max_depth=1)),
('svc', SVC(kernel='linear', probability=True))
]
# Créer un classifieur Stacking
stacking = StackingClassifier(estimators=estimators, final_estimator=LogisticRegression())
# Entraîner le modèle
stacking.fit(X_train, y_train)
# Prédire
y_pred = stacking.predict(X_test)
# Calculer la précision
accuracy = accuracy_score(y_test, y_pred)
print(f"Exactitude du Stacking : {accuracy:.2f}")
Le résultat de sortie est le suivant :
tacking的准确率: 1.00
Explication du code :
- Charger le jeu de données: De même, utilisez le
load_iris()La fonction charge le jeu de données Iris. - Diviser l'ensemble d'entraînement et l'ensemble de test: Utilisez
train_test_split()La fonction divise le jeu de données en ensembles d'entraînement et de test. - Définir l'apprenant de base: Utilisez
DecisionTreeClassifieretSVCcomme apprenant de base. - Créer un classifieur Stacking: Utilisez
StackingClassifierclasse pour créer un classifieur Stacking,final_estimator=LogisticRegression()indiquant que la régression logistique est utilisée comme méta-modèle. - Entraîner le modèle: Utiliser
fit()méthode pour entraîner le modèle. - Prédire: Utiliser
predict()méthode pour faire des prédictions sur l'ensemble de test. - Calculer l'exactitude: Utiliser
accuracy_score()fonction pour calculer l'exactitude du modèle.