Aprendizaje automático - Segmentación de clientes
En el mundo empresarial actual impulsado por los datos, comprender al cliente es la clave del éxito.
Sin embargo, cuando tu base de clientes alcanza decenas de miles o incluso millones, analizar manualmente las características y los patrones de comportamiento de cada cliente se vuelve poco práctico.
En este punto, las técnicas de aprendizaje automático, en particularel aprendizaje no supervisadolos algoritmos de agrupamiento se convierten en una herramienta poderosa.
La segmentación de clientes, también conocida como segmentación de clientes (customer segmentation), tiene como objetivo central dividir el amplio grupo de clientes en varios subgrupos con características similares. Es como un dueño de tienda experimentado que ya no ve a los clientes como un todo difuso, sino que puede identificar claramente diferentes grupos: amas de casa que buscan buena relación calidad-precio, entusiastas de la tecnología interesados en novedades y clientes de alto nivel que valoran la experiencia de servicio. Al adoptar estrategias específicas de marketing, servicio y producto para cada grupo, las empresas pueden mejorar significativamente la eficiencia operativa y la satisfacción del cliente.
Este artículo te guiará paso a paso a través de un proyecto práctico completo de segmentación de clientes. Usaremos el clásico algoritmo de agrupamiento K-Means para analizar un conjunto de datos simulado de clientes minoristas, desde la comprensión de los datos hasta la evaluación del modelo, obteniendo finalmente resultados de segmentación con valor comercial.
Comprender el análisis de agrupamiento y el algoritmo K-Means
Antes de comenzar con la práctica, debemos comprender las herramientas principales que vamos a utilizar.
¿Qué es el análisis de agrupamiento?
El análisis de agrupamiento es un método de aprendizaje no supervisado. A diferencia del aprendizaje supervisado (como predecir precios de viviendas o reconocer imágenes de gatos y perros), los algoritmos de agrupamiento no tienen una "respuesta correcta" preetiquetada (es decir, etiquetas). Su tarea es explorar la estructura interna de los datos, agrupando automáticamente los puntos de datos similares en el mismo grupo (denominado "clúster"), mientras que los puntos de datos de diferentes grupos son lo más disímiles posible.
Una analogía sencilla: imagina que tienes una cesta de frutas variadas con manzanas, naranjas y plátanos. La tarea del algoritmo de agrupamiento es, sin que nadie te diga los nombres de las categorías, apilar automáticamente las frutas similares en forma, color y tamaño en grupos separados.
Cómo funciona el algoritmo K-Means
K-Means es uno de los algoritmos de agrupamiento más utilizados e intuitivos. "K" representa el número de clústeres en los que queremos dividir los datos. Su principio de funcionamiento se puede resumir en cuatro pasos:
- Inicialización: seleccionar aleatoriamente K puntos de datos como "centros de clúster" iniciales (centroides).
- Asignación: calcular la distancia de cada punto de datos a cada centroide (generalmente usando distancia euclidiana) y luego asignar cada punto al clúster cuyo centroide esté más cerca.
- Actualización: recalcular el centroide de cada clúster (es decir, el promedio de todos los puntos del clúster).
- Iteración: repetir los pasos 2 y 3 hasta que las posiciones de los centroides ya no cambien significativamente, o hasta alcanzar el número predefinido de iteraciones.
El siguiente diagrama de flujo muestra claramente este proceso:

Puntos clave del algoritmo:
- Medida de distancia: generalmente se usa la distancia euclidiana para medir la similitud entre puntos de datos; cuanto más cercana es la distancia, mayor es la similitud.
- Centroide: representa el "punto promedio" o punto central de un clúster.
- Objetivo: minimizar la suma de los cuadrados de las distancias de los puntos de datos a su centroide dentro de cada clúster (llamada "suma de cuadrados intra-clúster" o Inertia).
Práctica: Segmentación de clientes minoristas
Ahora, pongamos la teoría en práctica. Usaremos Python y su potente ecosistema de librerías de ciencia de datos para completar este proyecto.
Paso 1: Preparación del entorno y carga de datos
Primero, asegúrate de que las librerías necesarias estén instaladas en tu entorno de Python:pandaspara el procesamiento de datos,numpypara el cálculo numérico,matplotlibyseabornpara la visualización,scikit-learnes la librería central de aprendizaje automático.
Ejemplo
import pandas as pd
import numpy as np
import matplotlib.pyplot as plt
import seaborn as sns
from sklearn.cluster import KMeans
from sklearn.preprocessing import StandardScaler
from sklearn.metrics import silhouette_score
import warnings
warnings.filterwarnings('ignore') # Ignorar advertencias no críticas
# Configurar el estilo de visualización
sns.set_style("whitegrid")
# -------------------------- Configurar fuente china start --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows primero
'SimHei', 'Microsoft YaHei',
# Priorizar macOS
'PingFang SC', 'Heiti TC',
# Priorizar Linux
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corregir el problema de que el signo negativo se muestre como un cuadrado
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de configuración de fuente china --------------------------
Usaremos un conjunto de datos simulado de clientescustomer_data.csv, que generalmente contiene las siguientes características:
CustomerID: identificador único del clienteAnnual_Income_(k$): ingreso anual del cliente (miles de dólares)Spending_Score: puntuación de gasto (0-100, derivada de la frecuencia de compra, el monto, etc.)Age: edad
El contenido es el siguiente:
CustomerID,Age,Annual_Income_(k$),Spending_Score
1,19,15,39
2,21,15,81
3,20,16,6
4,23,16,77
5,31,17,40
6,22,17,76
7,35,18,6
8,23,18,94
9,64,19,3
10,30,19,72
11,67,20,14
12,35,20,99
13,58,21,15
14,24,21,77
15,37,22,13
16,22,22,79
17,35,23,35
18,20,23,66
19,52,24,29
20,35,24,98
21,46,25,35
22,25,25,73
23,54,26,5
24,28,26,73
25,45,27,28
26,23,28,82
27,40,28,36
28,35,28,61
29,60,29,4
30,21,30,87
31,62,30,17
32,23,30,73
33,18,31,92
34,49,33,14
35,21,33,81
36,42,34,17
37,30,34,73
38,36,37,26
39,20,37,75
40,65,38,35
41,24,38,92
42,48,39,36
43,31,39,61
44,49,40,29
45,24,40,98
46,50,41,15
47,27,42,65
48,29,43,88
49,31,43,19
50,49,44,75
Ejemplo
df = pd.read_csv('customer_data.csv')
print("Forma de los datos (filas, columnas):", df.shape)
print("\n"Primeras 5 filas de datos:")
print(df.head())
print("\n"Información básica de datos:")
print(df.info())
print("\n"Estadísticas descriptivas:")
print(df.describe())
Salida:
数据形状(行数,列数): (50, 4)

数据前5行:
   CustomerID  Age  Annual_Income_(k$)  Spending_Score
0           1   19                  15              39
1           2   21                  15              81
2           3   20                  16               6
3           4   23                  16              77
4           5   31                  17              40

数据基本信息:
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 50 entries, 0 to 49
Data columns (total 4 columns):
 #   Column              Non-Null Count  Dtype
---  ------              --------------  -----
 0   CustomerID          50 non-null     int64
 1   Age                 50 non-null     int64
 2   Annual_Income_(k$)  50 non-null     int64
 3   Spending_Score      50 non-null     int64
dtypes: int64(4)
memory usage: 1.7 KB
None

描述性统计:
       CustomerID        Age  Annual_Income_(k$)  Spending_Score
count    50.00000  50.000000           50.000000       50.000000
mean     25.50000  35.560000           28.160000       51.680000
std      14.57738  14.283085            8.739682       31.506682
min       1.00000  18.000000           15.000000        3.000000
25%      13.25000  23.000000           21.000000       20.750000
50%      25.50000  31.000000           27.500000       61.000000
75%      37.75000  47.500000           36.250000       77.000000
max      50.00000  67.000000           44.000000       99.000000
Paso 2: Exploración y preprocesamiento de datos
Antes de aplicar el algoritmo, debemos comprender los datos y realizar el trabajo de "limpieza".
1. Análisis exploratorio de datosA través de la visualización y la estadística, descubrir patrones preliminares.
Ejemplo
fig, axes = plt.subplots(1, 3, figsize=(15, 4))
sns.histplot(df['Age'], bins=30, kde=True, ax=axes[0])
axes[0].set_title('distribución de edades')
sns.histplot(df['Annual_Income_(k$)'], bins=30, kde=True, ax=axes[1])
axes[1].set_title('distribución de ingresos anuales')
sns.histplot(df['Spending_Score'], bins=30, kde=True, ax=axes[2])
axes[2].set_title(Distribución de la puntuación de consumo)
plt.tight_layout()
plt.show()
# Ver las relaciones entre características
sns.pairplot(df[['Age', 'Annual_Income_(k$)', 'Spending_Score']])
plt.suptitle('Matriz de dispersión de relaciones de características', y=1.02)
plt.show()
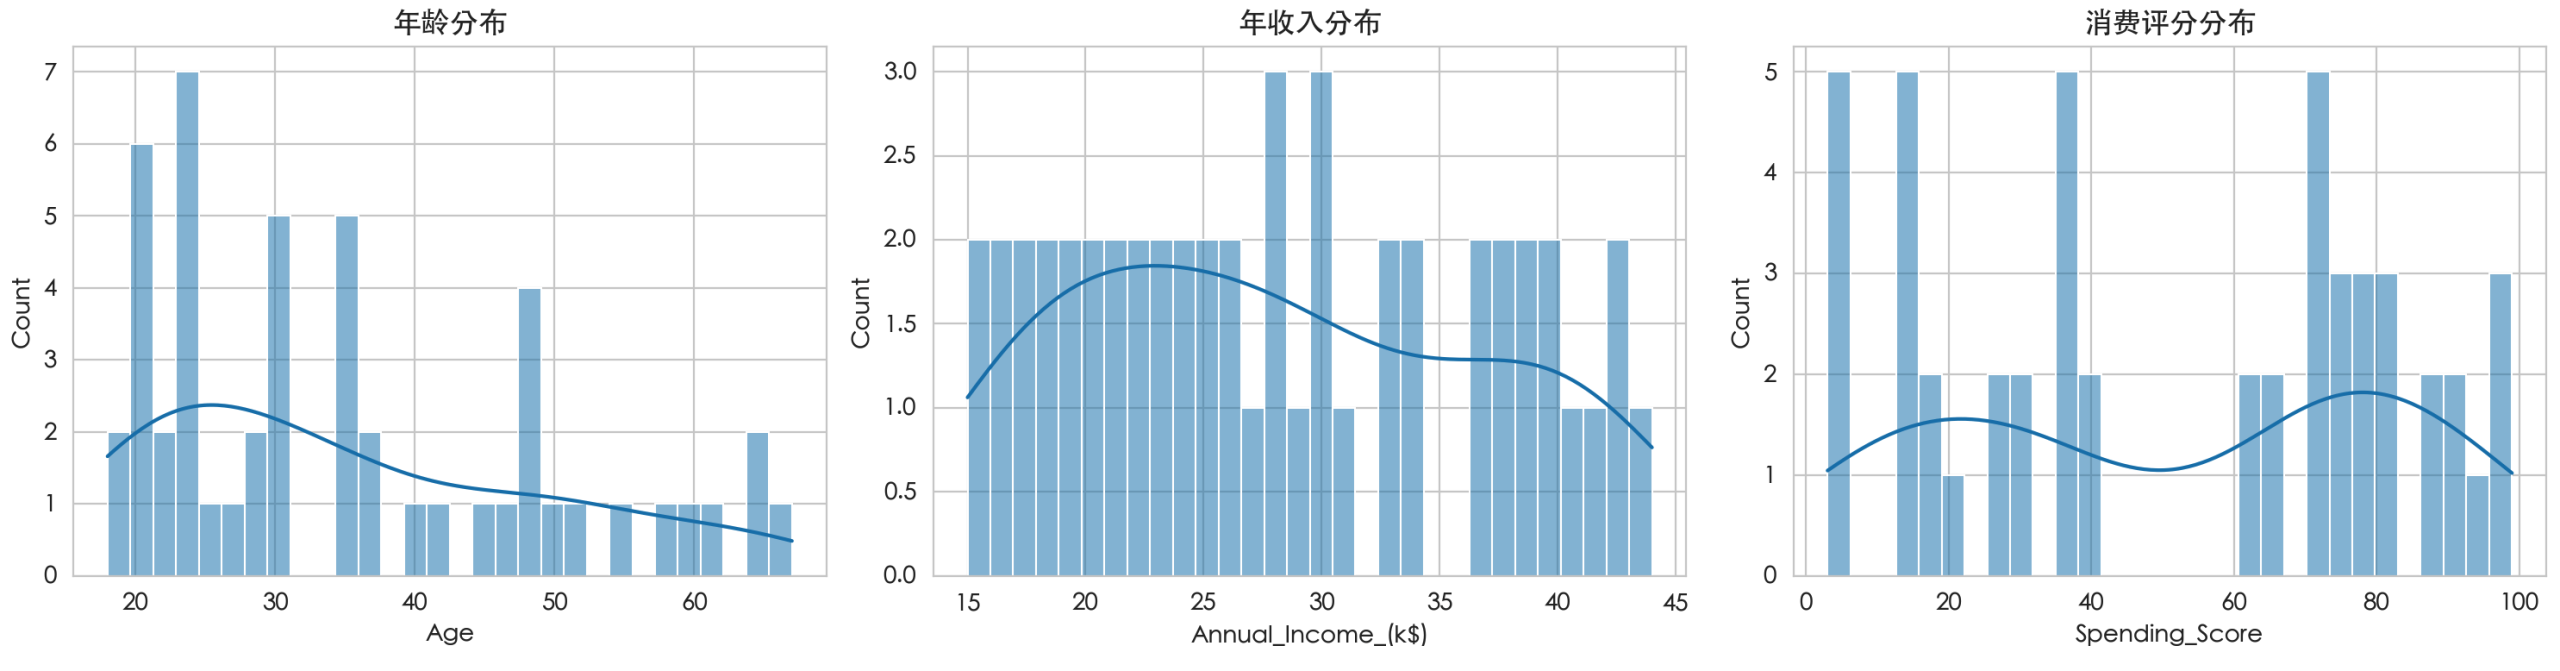
2. Preprocesamiento de datosLos algoritmos de agrupamiento son muy sensibles a las escalas (unidades) de las características. El ingreso anual (decenas de miles) y la edad (decenas) tienen rangos de valores muy diferentes, lo que afecta gravemente el cálculo de distancias y hace que la característica de ingreso domine el resultado del agrupamiento. Por lo tanto, necesitamos realizarestandarización de características, es decir, escalar cada característica a una distribución normal estándar con media 0 y varianza 1.
Ejemplo
features = ['Age', 'Annual_Income_(k$)', 'Spending_Score']
X = df[features].copy()
# estandarización de características
scaler = StandardScaler()
X_scaled = scaler.fit_transform(X) # fit calcula la media y la varianza, transform aplica la transformación
X_scaled_df = pd.DataFrame(X_scaled, columns=features)
print("Primeras 5 filas de los datos estandarizados:")
print(X_scaled_df.head())
Paso 3: Determinar el número óptimo de clústeres (valor K)
K-Means requiere que especifiquemos de antemano el valor de K. ¿Cómo elegir una K razonable? Usamos dos métodos clásicos:
1. Método del codoSe dibuja la suma de cuadrados intra-clúster (Inertia) correspondiente a diferentes valores de K. La Inertia disminuye a medida que K aumenta. Buscamos el punto de inflexión de la curva (como un codo), después del cual el beneficio de incrementar K (la caída de Inertia) se vuelve pequeño.
Ejemplo
K_range = range(1, 11) # Probar K de 1 a 10
for k in K_range:
kmeans = KMeans(n_clusters=k, random_state=42, n_init='auto') # n_init='auto' es el uso de versiones más recientes
kmeans.fit(X_scaled)
inertia.append(kmeans.inertia_) # Obtener la Inertia para ese valor de K
# Trazar el gráfico del método del codo
plt.figure(figsize=(8,5))
plt.plot(K_range, inertia, 'bo-')
plt.xlabel('Número de clústeres (K)')
plt.ylabel('Suma de cuadrados dentro del clúster (Inertia)')
plt.title('Regla del codo: elegir el mejor valor de K')
plt.xticks(K_range)
plt.show()
2. Método del coeficiente de siluetaEl coeficiente de silueta mide la similitud de un punto de datos con su propio clúster (cohesión) y la separación de otros clústeres. Su valor está entre -1 y 1,cuanto más alto, mejor, lo que indica un mejor rendimiento del agrupamiento.
Ejemplo
K_range = range(2, 11) # El coeficiente de silueta requiere al menos 2 clústeres
for k in K_range:
kmeans = KMeans(n_clusters=k, random_state=42, n_init='auto')
cluster_labels = kmeans.fit_predict(X_scaled)
score = silhouette_score(X_scaled, cluster_labels)
silhouette_scores.append(score)
# Trazar el gráfico del coeficiente de silueta
plt.figure(figsize=(8,5))
plt.plot(K_range, silhouette_scores, 'go-')
plt.xlabel('Número de clústeres (K)')
plt.ylabel('coeficiente de silueta')
plt.title('Método del coeficiente de silueta: elegir el mejor valor de K')
plt.xticks(K_range)
plt.show()
Combinando el gráfico del método del codo (punto de inflexión) y el gráfico del coeficiente de silueta (pico), asumimos que determinarK=5es una buena elección.
Paso 4: Aplicar K-Means para el agrupamiento
Entrenar el modelo con el valor de K seleccionado y asignar una etiqueta de clúster a cada cliente.
Ejemplo
final_k = 5
kmeans_final = KMeans(n_clusters=final_k, random_state=42, n_init='auto')
df['Cluster'] = kmeans_final.fit_predict(X_scaled) # Agregar las etiquetas de clúster al DataFrame original
# Ver el número de clientes en cada clúster
cluster_counts = df['Cluster'].value_counts().sort_index()
print("Distribución del número de clientes de cada clúster:")
print(cluster_counts)
# Ver la media de características de cada clúster (escala original)
cluster_profile = df.groupby('Cluster')[features].mean().round(2)
print("\nPromedio de características de cada clúster:")
print(cluster_profile)
Paso 5: Análisis de resultados y visualización
Convertir las etiquetas abstractas de los clústeres en información intuitiva.
1. Visualizar los resultados de la agrupaciónDado que tenemos tres características, podemos seleccionar dos de las más importantes para visualizar en un plano bidimensional (por ejemplo, ingresos y puntuación de consumo).
Ejemplo
plt.figure(figsize=(10, 6))
scatter = plt.scatter(df['Annual_Income_(k$)'], df['Spending_Score'],
c=df['Cluster'], cmap='viridis', s=50, alpha=0.7)
plt.colorbar(scatter, label='Etiqueta de clúster')
plt.xlabel('Ingreso anual (k$)')
plt.ylabel('Puntuación de consumo')
plt.title('Resultado de la segmentación de clientes (basado en ingreso anual y puntuación de consumo)')
plt.show()
2. Definir el perfil de los grupos de clientesSegúncluster_profilela tabla, podemos asignar un significado comercial a cada clúster:
| Etiqueta de clúster | Edad | Ingreso anual | Puntuación de consumo | Posible perfil del cliente |
|---|---|---|---|---|
| 0 | Medio | Alto | bajo | Conservador de altos ingresos: Ingresos altos pero consumo conservador, pueden ser ahorradores o personas de alto patrimonio sensibles al precio. |
| 1 | Medio | bajo | bajo | Bajos ingresos y bajo consumo: Tanto los ingresos como la capacidad de consumo son limitados, necesitan productos de alta relación calidad-precio. |
| 2 | Medio | bajo | Alto | Buscadores de valor: Ingresos no muy altos pero les encanta consumir, valoran las tendencias y las experiencias, son el objetivo de las actividades promocionales. |
| 3 | Medio | Alto | Alto | VIP ideal: Altos ingresos y alto consumo, son la principal fuente de beneficios de la empresa, se les debe ofrecer servicios de primer nivel y derechos exclusivos. |
| 4 | Joven | Medio | Medio | Joven con potencial: Clientes jóvenes, cuyos ingresos y consumo están en crecimiento, son clave para cultivar la lealtad a la marca. |
Paso 6: Evaluación del modelo y recomendaciones de aplicación
Evaluación: Además del coeficiente de silueta, se puede verificar si la distribución de muestras dentro de cada clúster es equilibrada, y combinar la lógica empresarial para juzgar si la segmentación es razonable.
Recomendaciones de aplicación:
- Marketing de precisión: Enviar nuevos productos de alta gama y eventos exclusivos al "VIP ideal" (clúster 3); enviar cupones de descuento e información de compras grupales a los "Buscadores de valor" (clúster 2).
- Desarrollo de productos: Diseñar productos modernos y con fuertes atributos sociales para el "Joven con potencial" (clúster 4).
- Servicio al cliente: Proporcionar datos detallados del producto y garantías de seguridad al "Conservador de altos ingresos" (clúster 0) para disipar sus dudas.
- Asignación de recursos: Inclinar más recursos de servicio al cliente y marketing hacia los grupos de clientes de alto valor.
Resumen y ampliación
A través de este caso práctico, has experimentado completamente el flujo de segmentación de clientes utilizando el algoritmo K-Means:Preparación de datos -> Análisis exploratorio -> Preprocesamiento -> Determinar el valor de K -> Entrenar el modelo -> Analizar resultados。
Repaso de puntos clave:
- La agrupación (clustering) es aprendizaje no supervisado, que se utiliza para descubrir agrupaciones internas en los datos.
- Estandarización de característicasEs un paso clave antes de utilizar algoritmos de agrupación basados en distancia.
- Método del codoyCoeficiente de siluetaSon herramientas prácticas para determinar el número óptimo de clústeres.
- La interpretación de los resultados de la agrupación debecombinarse con el conocimiento empresarial, para poder generar valor real.