Validation croisée
Dans la pratique de l'apprentissage automatique, nous sommes souvent confrontés à un problème central : comment évaluer la qualité d'un modèle ? Vous pourriez penser à utiliser une partie des données pour entraîner le modèle, puis une autre partie de données non vues pour tester ses performances. Cette idée est tout à fait correcte, mais comment pouvons-nous évaluer le modèle de manière plus fiable et plus stable ? C'estValidation croiséele problème central à résoudre.
En termes simples, la validation croisée est une méthode statistique qui évalue la capacité de généralisation d'un modèle (c'est-à-dire sa capacité à traiter de nouvelles données) en divisant de façon répétée l'ensemble de données. C'est comme organiser un examen blanc pour le modèle, en utilisant plusieurs sujets d'examen blanc différents (sous-ensembles de données) pour vérifier son véritable niveau, en évitant un jugement erroné dû au caractère aléatoire d'un seul examen.
Cet article vous guidera pour comprendre en profondeur les principes, les méthodes courantes et le rôle clé de la validation croisée dans l'optimisation des modèles et l'ingénierie.
Pourquoi avons-nous besoin de la validation croisée ?
Avant de plonger dans les détails techniques, comprenons d'abord sa nécessité à travers une analogie.
Imaginez que vous êtes un étudiant sur le point de passer un examen important de mathématiques. Il existe deux méthodes pour évaluer votre niveau :
- Méthode A (division simple): L'enseignant choisit au hasard 10 questions dans la banque de questions pour vous faire passer un examen blanc, puis utilise cette note pour prédire votre note à l'examen final.
- Méthode B (validation croisée): L'enseignant divise la banque de questions en 5 parties. La première fois, utilisez les parties 2, 3, 4, 5 pour vous entraîner, et utilisez la partie 1 pour tester ; la deuxième fois, utilisez les parties 1, 3, 4, 5 pour l'entraînement, et utilisez la partie 2 pour tester... Répétez cela 5 fois. Enfin, prenez la moyenne des 5 notes de test pour vous évaluer.
Which method is more reliable? ObviouslyMéthode B。
- Méthode ALe risque de la méthode A est le suivant : si les 10 questions choisies correspondent justement aux types que vous maîtrisez, votre score à l'examen blanc sera gonflé, ce qui conduit à un excès d'optimisme quant à votre véritable niveau ; inversement, si les questions choisies correspondent toutes à vos angles morts, le score sera trop bas, ce qui conduit à un excès de pessimisme. Les résultats de l'évaluation fluctuent fortement et sont instables.
- Méthode BGrâce à de multiples combinaisons différentes d'entraînement/de test, elle vous permet de rencontrer divers types de questions de la banque de questions, et le score moyen obtenu est plus représentatif de votre niveau global et stable, et prédit plus précisément le résultat de l'examen final.
En apprentissage automatique :
- la banque de questionsest notrejeu de données entier。
- l'étudiantest le modèle que nous voulons entraînermodèle d'apprentissage automatique。
- le score à l'examen blancest lamétrique d'évaluation du modèle(comme la précision, l'erreur quadratique moyenne, etc.).
- l'examen finalest la future performance du modèle sur desdonnées réelles et inédites.
L'objectif central de la validation croisée est de fournir, pour la capacité de généralisation du modèle, uneestimation plus robuste et moins biaisée, nous aidant ainsi à effectuer une sélection de modèle, un réglage des paramètres et une évaluation des performances plus fiables.
Méthodes courantes de validation croisée
La validation croisée comporte plusieurs méthodes de mise en œuvre, adaptées à différentes données et situations. Les plus courantes sont présentées ci-dessous.
1. Validation hold-out
C'est la méthode la plus simple et la plus intuitive.
Exemple
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score
# Construire des données exécutables
# 200 échantillons, 4 caractéristiques, classification binaire
np.random.seed(42)
X = np.random.randn(200, 4)
y = (X[:, 0] + X[:, 1] * 0.7 - X[:, 2] * 0.4 > 0).astype(int)
# 1. Diviser l'ensemble d'entraînement et l'ensemble de test (7:3)
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.3, random_state=42
)
# 2. Entraîner le modèle
model = RandomForestClassifier(random_state=42)
model.fit(X_train, y_train)
# 3. Évaluer sur l'ensemble de test
y_pred = model.predict(X_test)
accuracy = accuracy_score(y_test, y_pred)
print(f"Précision du modèle : {accuracy:.4f}")
Résultat de sortie :
模型准确率: 0.8833
Description du processus :

-
Avantages :Simple et rapide, faible coût de calcul.
- Inconvénients :Le résultat de l'évaluation dépend fortement d'une seule division aléatoire. Si la division est malchanceuse, le résultat de l'évaluation peut ne pas être représentatif. Par ailleurs, comme l'ensemble de test n'est utilisé qu'une seule fois, l'utilisation des données est insuffisante.
2. Validation croisée K-Fold
C'est actuellement la méthode de validation croisée la plus couramment utilisée et la plus standard.
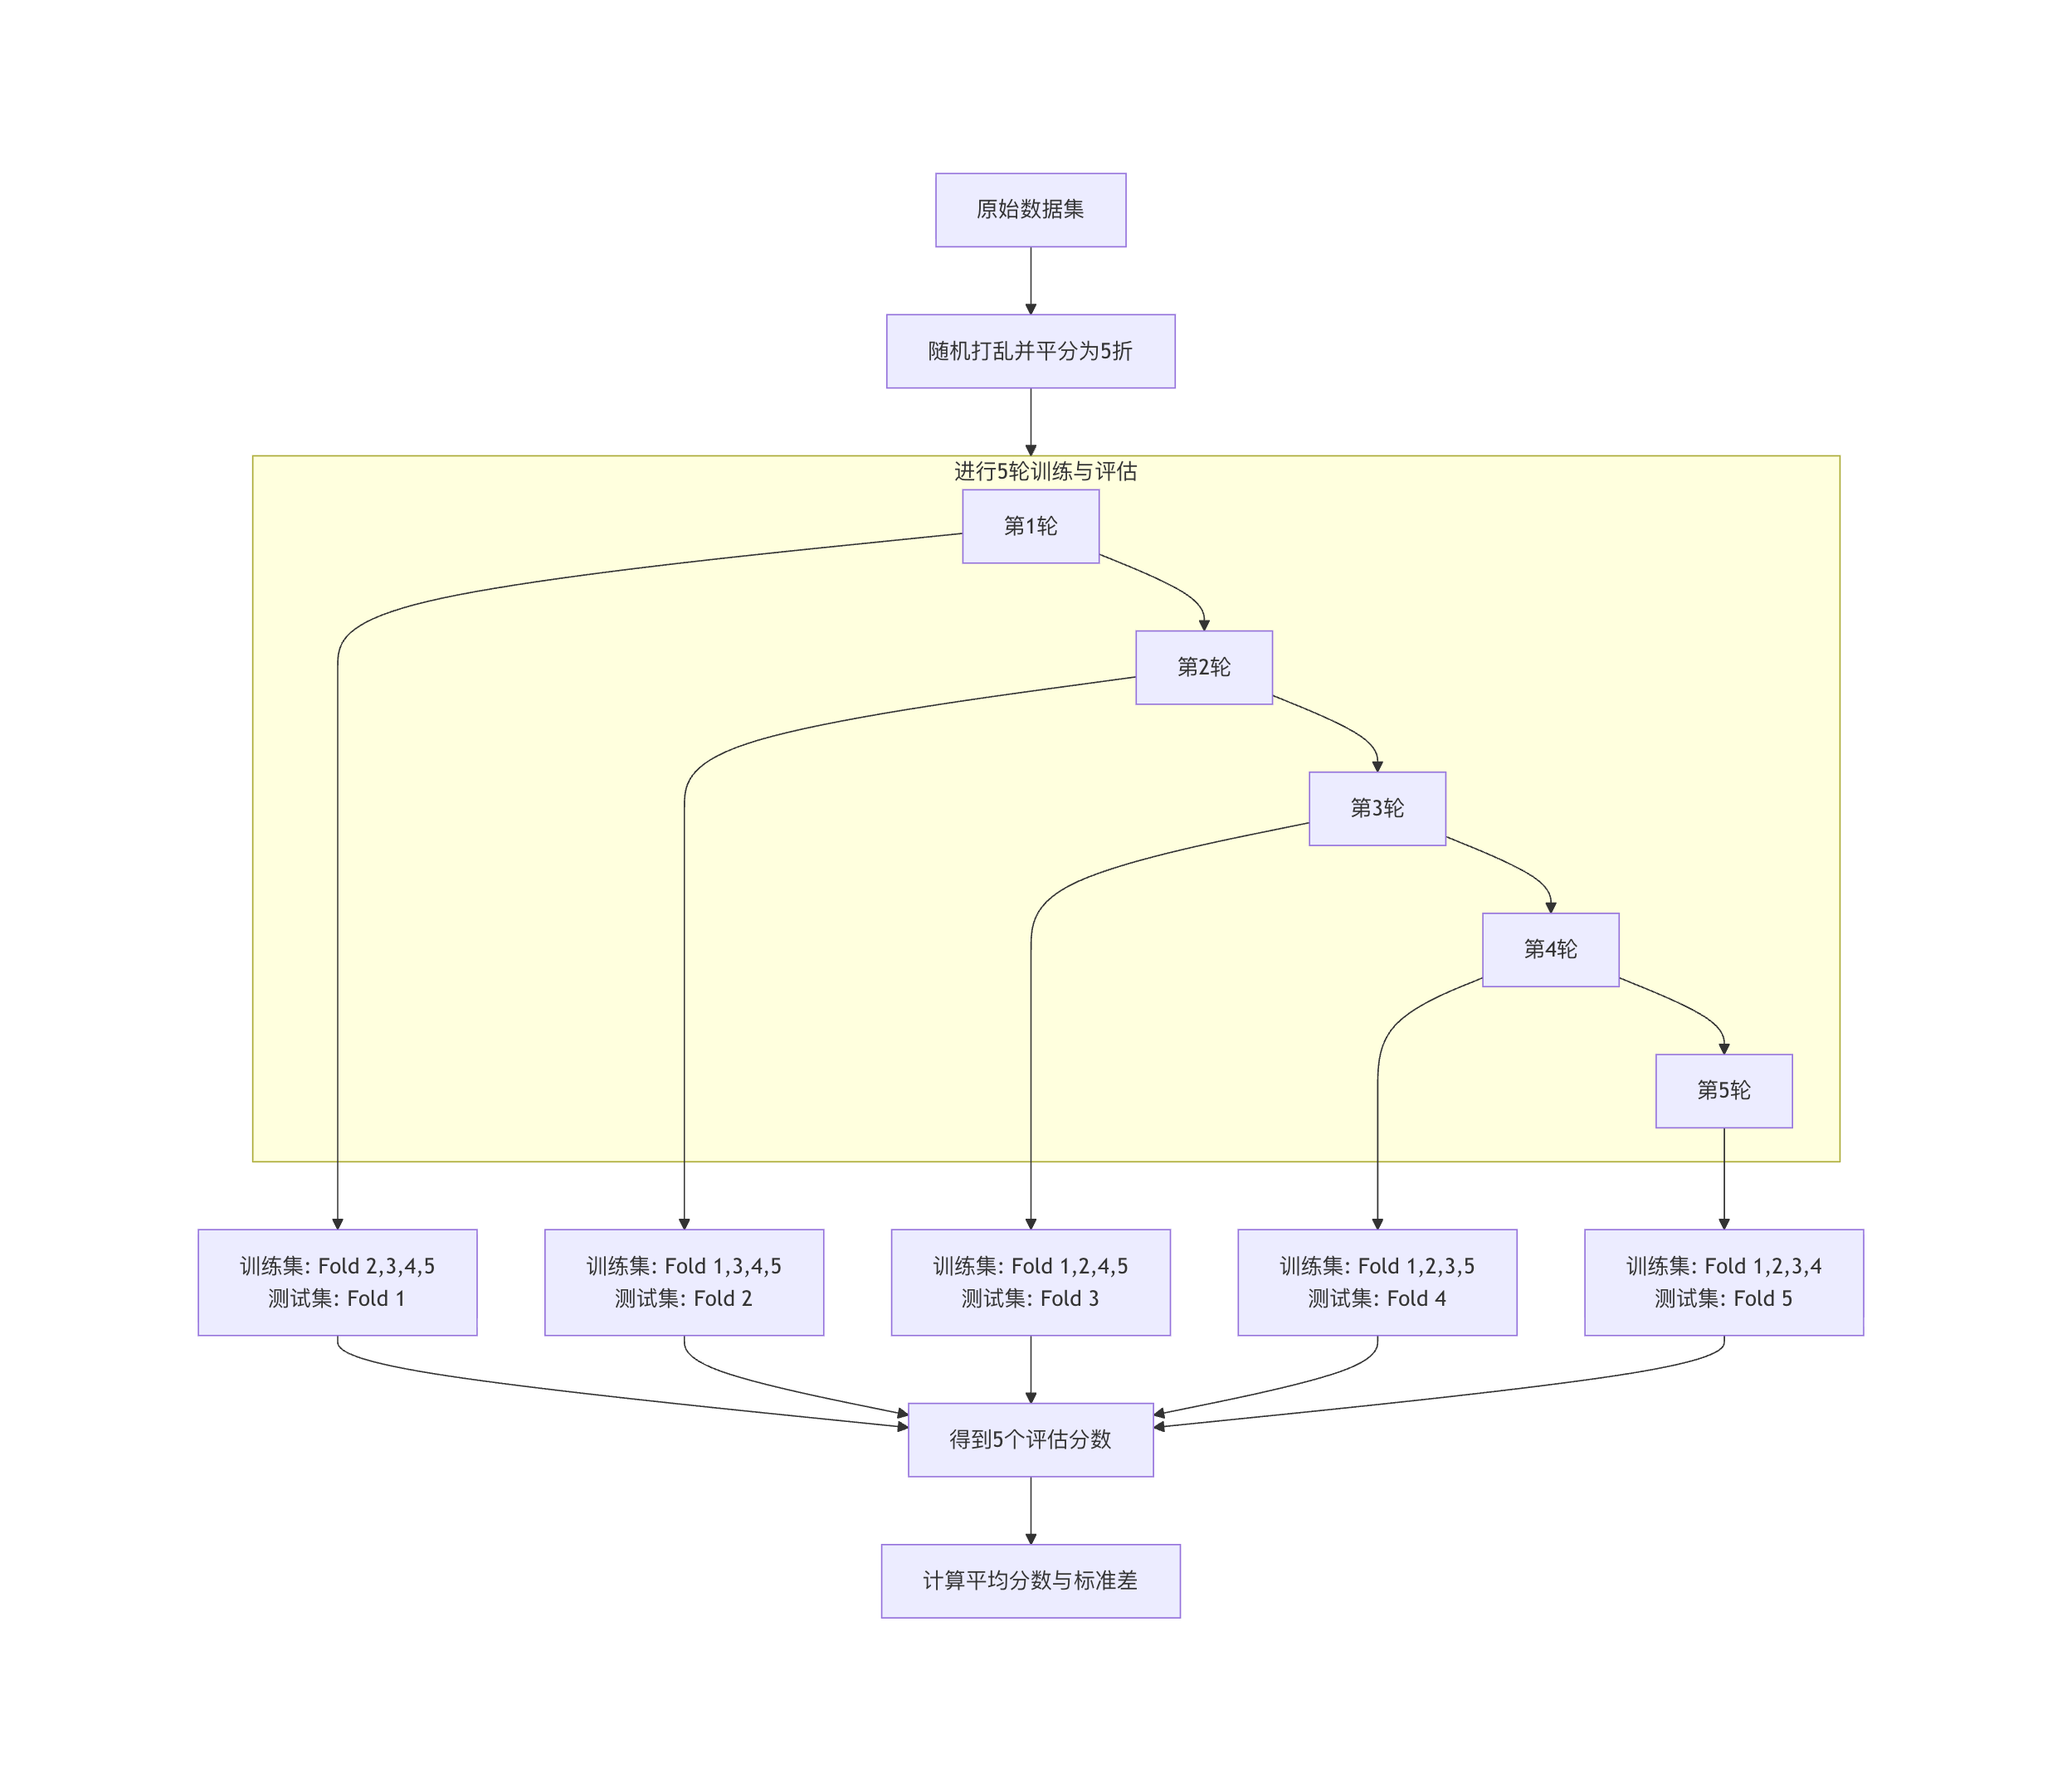
Principe :Diviser le jeu de donnéesuniformémentaléatoirement en K sous-ensembles mutuellement exclusifs (appelés plis).
Dans chaque expérience, on utilise à tour de rôle un sous-ensemble comme ensemble de test et les K-1 sous-ensembles restants comme ensemble d'entraînement. Ce processus est répété K fois, garantissant que chaque sous-ensemble est utilisé une fois comme ensemble de test. Enfin, nous obtenons K scores d'évaluation et prenons leur moyenne comme estimation finale de la performance du modèle.
Exemple
from sklearn.model_selection import cross_val_score, KFold
from sklearn.linear_model import LogisticRegression
# Construire des données d'exemple exécutables
# 100 échantillons, 4 caractéristiques, étiquettes de classification binaire
np.random.seed(42)
X = np.random.randn(100, 4)
y = (X[:, 0] + X[:, 1] * 0.5 > 0).astype(int)
# 1. Initialiser le modèle
model = LogisticRegression(max_iter=1000)
# 2. Définir le séparateur de validation croisée K-fold (K=5)
kfold = KFold(n_splits=5, shuffle=True, random_state=42)
# 3. Effectuer la validation croisée
scores = cross_val_score(model, X, y, cv=kfold, scoring='accuracy')
print(f"Exactitude par pli : {scores}")
print(f"Exactitude moyenne : {scores.mean():.4f} (+/- {scores.std() * 2:.4f})")
每次折叠的准确率: [0.9  0.95 1.   0.95 1.  ]
平均准确率: 0.9600 (+/- 0.0748)
Schéma du processus lorsque K=5 :
Comment choisir la valeur de K ?
- Valeurs courantes: 5 ou 10. Il s'agit d'un compromis empirique.
- Valeur de K plus petite (par ex., 3): l'ensemble d'entraînement est plus grand, mais le nombre d'évaluations est faible, et la variance de l'estimation peut être grande.
- Valeur de K plus grande (par ex., 10 ou 20): l'évaluation est plus stable (faible variance), mais l'ensemble d'entraînement est plus proche du jeu de données d'origine à chaque fois, ce qui peut introduire un biais d'estimation plus optimiste, et le coût de calcul augmente considérablement.
- Cas extrême K = N (nombre d'échantillons): il s'agit de la validation croisée leave-one-out, avec un seul échantillon de test à chaque fois. L'évaluation est la moins biaisée, mais le coût de calcul est extrêmement élevé, généralement utilisé uniquement pour de très petits jeux de données.
Avantages :Les données sont pleinement utilisées, et les résultats d'évaluation sont stables et fiables.
Inconvénients :Le coût de calcul est K fois celui de la méthode hold-out.
3. Validation croisée K-fold stratifiée
Ceci est une variante importante de la validation croisée K-fold, particulièrement adaptée auxproblèmes de classificationMoyenavec une distribution de classes déséquilibréejeux de données.
Problème résolu :Dans la validation croisée K-fold ordinaire, une division aléatoire peut faire que la proportion d'une certaine classe dans certains plis diffère grandement de l'ensemble de données d'origine. Par exemple, si un ensemble de données a 90% de classe positive et 10% de classe négative, une division aléatoire en 5 plis peut produire un pli entièrement positif sans classe négative, ce qui rend l'évaluation sur ce pli dénuée de sens.
La validation croisée K-fold stratifiée garantit que, lors de la division, la proportion d'échantillons de chaque classe dans chaque pli reste cohérente avec la proportion globale dans l'ensemble de données d'origine.
Exemple
# L'utilisation est presque la même que KFold, remplacez simplement le séparateur
stratified_kfold = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
scores = cross_val_score(model, X, y, cv=stratified_kfold, scoring='accuracy')
Pour les tâches de classification, en particulier lorsque les classes sont déséquilibrées,privilégiez l'utilisation deStratifiedKFold。
4. Découpage de séries temporelles
Pour lesdonnées de séries temporelles, l'ordre des données est crucial (les données de demain dépendent d'aujourd'hui et d'hier). Nous ne pouvons pas mélanger les données de manière aléatoire ; nous devons conserver l'ordre temporel.
Le principe est le suivant : l'ensemble d'entraînement est toujours constitué des données les plus anciennes dans le temps, et l'ensemble de test est constitué des données qui suivent immédiatement. Au fur et à mesure que le nombre de plis augmente, la fenêtre de l'ensemble d'entraînement ne cesse de s'étendre.
Exemple
from sklearn.model_selection import TimeSeriesSplit
# Construire des données de séries temporelles exécutables
# 100 points temporels, 2 caractéristiques
np.random.seed(42)
X = np.random.randn(100, 2)
# Exemple de TimeSeriesSplit
tscv = TimeSeriesSplit(n_splits=5)
for train_index, test_index in tscv.split(X):
print(f"Plage d'indices de l'ensemble d'entraînement : {train_index)
print(f"Plage d'indices de l'ensemble de test : {test_index)
print("---")
Sortie :
训练集索引范围: 0 到 19
测试集索引范围: 20 到 35
---
训练集索引范围: 0 到 35
测试集索引范围: 36 到 51
---
训练集索引范围: 0 到 51
测试集索引范围: 52 到 67
---
训练集索引范围: 0 到 67
测试集索引范围: 68 到 83
---
训练集索引范围: 0 到 83
测试集索引范围: 84 到 99
---
Applications de la validation croisée dans l'ingénierie des modèles
La validation croisée n'est pas seulement un outil d'évaluation, mais aussi une partie essentielle du processus d'optimisation et d'ingénierie des modèles.
Application 1 : Sélection et comparaison de modèles
Lorsque nous devons choisir parmi plusieurs modèles candidats (tels que la régression linéaire, l'arbre de décision, la machine à vecteurs de support), nous ne pouvons pas utiliser l'ensemble de test pour sélectionner (sinon l'ensemble de test fait partie du processus d'entraînement et « laisse fuiter » des informations). L'approche correcte est :
- Pour chaque modèle candidat, sur l'ensemble d'entraînement, utilisez la validation croisée pour obtenir son estimation de performance.
- Comparez les scores moyens de ces résultats de validation croisée et sélectionnez le modèle avec le score le plus élevé.
- Enfin, réentraînez le modèle sélectionné sur l'ensemble d'entraînement complet, et utilisezl'ensemble de test indépendantpour effectuer une évaluation finale unique, en rapportant ce score comme performance finale du modèle.
Exemple
from sklearn.model_selection import cross_val_score, StratifiedKFold, train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.svm import SVC
from sklearn.tree import DecisionTreeClassifier
# Construire des données de classification exécutables
# 200 échantillons, 4 caractéristiques, classification binaire
np.random.seed(42)
X = np.random.randn(200, 4)
y = (X[:, 0] + X[:, 1] * 0.8 - X[:, 2] * 0.3 > 0).astype(int)
# Diviser l'ensemble d'entraînement / l'ensemble de test
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.25, random_state=42, stratify=y
)
# Définir les modèles
models = {
'Régression logistique': LogisticRegression(max_iter=1000),
'SVM': SVC(),
'Arbre de décision': DecisionTreeClassifier()
}
# Validation croisée K-fold stratifiée
cv = StratifiedKFold(n_splits=5, shuffle=True, random_state=42)
results = {}
# Évaluation par validation croisée
for name, model in models.items():
scores = cross_val_score(model, X_train, y_train, cv=cv, scoring='accuracy')
results[name] = scores.mean()
print(f"{name} exactitude moyenne : {scores.mean():.4f}")
# Sélectionner le meilleur modèle
best_model_name = max(results, key=results.get)
print(f"\nD'après la validation croisée, le meilleur modèle est : {best_model_name}")
# Évaluation finale sur les ensembles d'entraînement et de test
best_model = models[best_model_name]
best_model.fit(X_train, y_train)
final_score = best_model.score(X_test, y_test)
print(f"Exactitude finale du meilleur modèle sur l'ensemble de test indépendant : {final_score:.4f}")
Sortie :
Logistic Regression 平均准确率: 0.9533
SVM 平均准确率: 0.9400
Decision Tree 平均准确率: 0.8467

根据交叉验证,最佳模型是: Logistic Regression
最佳模型在独立测试集上的最终准确率: 1.0000
Application 2 : Réglage des hyperparamètres
Les hyperparamètres sont des paramètres qui doivent être définis avant l'entraînement du modèle (comme le nombre d'arbres dans une forêt aléatoiren_estimators, le coefficient de pénalité du SVMC). Le processus de recherche de la meilleure combinaison d'hyperparamètres est appeléréglage des hyperparamètres, et la validation croisée est sa méthode d'évaluation standard.
La méthode la plus couramment utilisée estla validation croisée par recherche en grille。
Exemple
from sklearn.model_selection import GridSearchCV, train_test_split
from sklearn.ensemble import RandomForestClassifier
# Construire des données de classification exécutables
# 300 échantillons, 5 caractéristiques, classification binaire
np.random.seed(42)
X = np.random.randn(300, 5)
y = (X[:, 0] * 0.6 + X[:, 1] * 0.4 - X[:, 2] > 0).astype(int)
# Diviser l'ensemble d'entraînement / l'ensemble de test
X_train, X_test, y_train, y_test = train_test_split(
X, y, test_size=0.25, random_state=42, stratify=y
)
# 1. Grille de paramètres
param_grid = {
'n_estimators': [50, 100, 200],
'max_depth': [None, 10, 20],
'min_samples_split': [2, 5, 10]
}
# 2. Modèle de base
rf = RandomForestClassifier(random_state=42)
# 3. GridSearchCV
grid_search = GridSearchCV(
estimator=rf,
param_grid=param_grid,
cv=5,
scoring='accuracy',
n_jobs=-1
)
# 4. Recherche sur grille (ensemble d'entraînement uniquement)
grid_search.fit(X_train, y_train)
# 5. Paramètres optimaux et score
print(f"Meilleurs paramètres : {grid_search.best_params_}")
print(f"Meilleur score de validation croisée : {grid_search.best_score_:.4f}")
# 6. Évaluation sur l'ensemble de test
best_rf_model = grid_search.best_estimator_
test_accuracy = best_rf_model.score(X_test, y_test)
print(f"Précision du modèle ajusté sur l'ensemble de test : {test_accuracy:.4f}")
Sortie :
最佳参数: {'max_depth': None, 'min_samples_split': 2, 'n_estimators': 100}
最佳交叉验证分数: 0.9067
调优后模型在测试集上的准确率: 0.9467
Points clés : GridSearchCVEn interne, la validation croisée a déjà été effectuée. Elle divise ensuite l'ensemble d'entraînementX_trainen plus petits « sous-ensembles d'entraînement » et « sous-ensembles de validation » pour évaluer les paramètres, donc ce que nous transmettonsX_trainéquivaut à toute la « banque de questions », tandis queX_testest la « question d'examen ultime » qui n'a jamais participé au processus de réglage et est utilisée pour la vérification finale.
Exercices pratiques et résumé
Exercice pratique
- Implémentation de base: Utilisez
sklearnle jeu de données Iris intégré, en utilisant respectivementtrain_test_splitetcross_val_score(K=5) pour entraîner et évaluer unKNeighborsClassifier, et comparer les scores obtenus par les deux méthodes d'évaluation. - Comparaison de modèles: Sur le même jeu de données, utilisez la validation croisée pour comparer
SVC、RandomForestClassifieretGradientBoostingClassifierles performances des modèles. - Réglage des paramètres: Pour
SVCle modèle, concevez une grille de paramètres (incluantCetgamma), utilisezGridSearchCVpour trouver les paramètres optimaux.
Résumé des points clés
- Objectif de la validation croisée: Obtenir une estimation plus robuste et plus fiable de la capacité de généralisation du modèle.
- Méthode fondamentale:La validation croisée K-foldest la référence absolue ; pour les problèmes de classification, privilégiez l'utilisation dela validation croisée K-fold stratifiée。
- Différence clé:
- Ensemble d'entraînement/ensemble de validation: Utilisé pour l'entraînement du modèle etl'évaluation pendant le processus de développement(comme la sélection de modèles, le réglage des paramètres). La validation croisée intervient à cette étape.
- Ensemble de test: Uniquement après la fin de tout le développement, utilisé pourle rapport de performance final en une seule fois. Il doit être strictement isolé et ne doit jamais être utilisé pour quelque prise de décision que ce soit.
- Rôle en ingénierie: La validation croisée est le pont reliant le développement du modèle (entraînement, réglage) et l'évaluation du modèle (test), et constitue la pierre angulaire pour garantir la qualité du modèle, prévenir le surapprentissage et parvenir à une sélection et une optimisation fiables du modèle.