Apprentissage non supervisé - Clustering
Imaginez que vous entrez dans une immense bibliothèque où tous les livres sont éparpillés en désordre sur le sol. Votre tâche n'est pas de lire chaque livre (cela prendrait trop de temps), mais de les regrouper en piles en fonction de leurs sujets, comme la science-fiction, les biographies historiques et les recettes de cuisine. Dans ce processus, vous n'avez pas de liste de classification toute faite vous indiquant à quelle catégorie appartient chaque livre ; vous vous fiez entièrement à des caractéristiques telles que le contenu du livre, la couverture, l'épaisseur, etc.,spontaneouslyces groupes.
In machine learning,le clusteringconsiste exactement à faire cela. C'est un type deméthode d'apprentissage non supervisédont l'objectif est de découvrir la structure interne et le regroupement dans des données qui n'ont pas de réponses pré-étiquetées (c'est-à-dire sans « étiquettes »).
Qu'est-ce que l'apprentissage non supervisé et le clustering ?
Avant de commencer, distinguons rapidement les deux principaux paradigmes de l'apprentissage automatique :
- Supervised learning: C'est comme apprendre avec un professeur. Nous fournissons à l'algorithme un grand nombre de questions (données caractéristiques) et les réponses correctes correspondantes (étiquettes), en le laissant apprendre la correspondance entre les questions et les réponses. Par exemple, nous montrons à l'algorithme de nombreuses images de chats et de chiens (caractéristiques) et lui indiquons si chaque image est un chat ou un chien (étiquettes). Après l'entraînement, il peut reconnaître de nouvelles images.
- Unsupervised learning: C'est comme laisser la machine explorer et découvrir par elle-même. Nous fournissons uniquement des questions (données caractéristiques),sans fournir de réponses (étiquettes). La tâche de l'algorithme est de trouver par lui-même des motifs, des structures ou des relations dans les données. Le clustering est l'une de ses techniques fondamentales.
The core idea of clustering: Diviser les échantillons de l'ensemble de données en plusieurssous-ensembles disjoints(appelés clusters ou classes), de sorte que les échantillons d'un même cluster soient mutuellementsimilaires, tandis que les échantillons de clusters différents sont mutuellementdissemblables。
La similarité ici est généralement mesurée par ladistancemathématique (par exemple, la distance euclidienne).
Plus la distance est faible, plus la similarité est élevée.

Algorithme de clustering classique : K-Means
K-MeansC'est l'un des algorithmes de clustering les plus célèbres et les plus couramment utilisés, avec une idée intuitive et une mise en œuvre relativement simple.
Principe et étapes de l'algorithme
Nous pouvons considérer le processus K-Means comme l'élection de représentants et le redécoupage de circonscriptions :
- Déterminer le nombre de clusters K: Tout d'abord, vous devez décider en combien de classes vous souhaitez diviser les données. Cette valeur K doit être spécifiée à l'avance ; c'est un paramètre clé de K-Means.
- Initialiser les représentants (centroïdes): Sélectionnez aléatoirement K points dans l'espace de données comme « point central » initial de chaque cluster, que nous appelonscentroïdes。
- Affecter les résidents (échantillons): Calculez la distance entre chaque point d'échantillon du jeu de données et les K centroïdes. En suivant le principe « ceux qui sont proches appartiennent à la même classe », affectez chaque échantillon au cluster du centroïde qui estle plus prochede lui. De cette façon, tous les échantillons sont divisés en K clusters.
- Réélire de nouveaux représentants (mettre à jour les centroïdes): Maintenant, chaque cluster a un lot d'échantillons. Recalculez le centroïde de chaque cluster ; le nouveau centroïde est lamoyenne(point moyen) de tous les points d'échantillon de ce cluster.
- Répéter et converger: Répétez l'étape 3 (affectation) et l'étape 4 (mise à jour) jusqu'à ce que les positions des centroïdes ne changent plus de manière significative (c'est-à-dire que l'algorithme converge). À ce stade, le cluster auquel appartient chaque échantillon ne change plus non plus.
Exemple de code et exercice pratique
Utilisons la bibliothèque de Pythonscikit-learnet un jeu de données simple pour démontrer K-Means.
Exemple
import numpy as np
import matplotlib.pyplot as plt
from sklearn.datasets import make_blobs
from sklearn.cluster import KMeans
# -------------------------- Début de configuration de la police chinoise --------------------------
plt.rcParams['font.sans-serif'] = [
# Windows préféré
'SimHei', 'Microsoft YaHei',
# macOS préféré
'PingFang SC', 'Heiti TC',
# Linux préféré
'WenQuanYi Micro Hei', 'DejaVu Sans'
]
# Corriger le problème où les signes négatifs sont affichés sous forme de carrés
plt.rcParams['axes.unicode_minus'] = False
# -------------------------- Fin de la configuration de la police chinoise --------------------------
# 1. Créer un jeu de données artificiel
# Nous générons 300 points d'échantillon qui se regroupent naturellement autour de 4 centres (pour faciliter l'observation)
X, y_true = make_blobs(n_samples=300, centers=4, cluster_std=0.60, random_state=0)
# X représente les données de caractéristiques, y_true représente les vraies étiquettes de classe (utilisées uniquement pour la comparaison finale ; l'algorithme de clustering ne les utilisera pas)
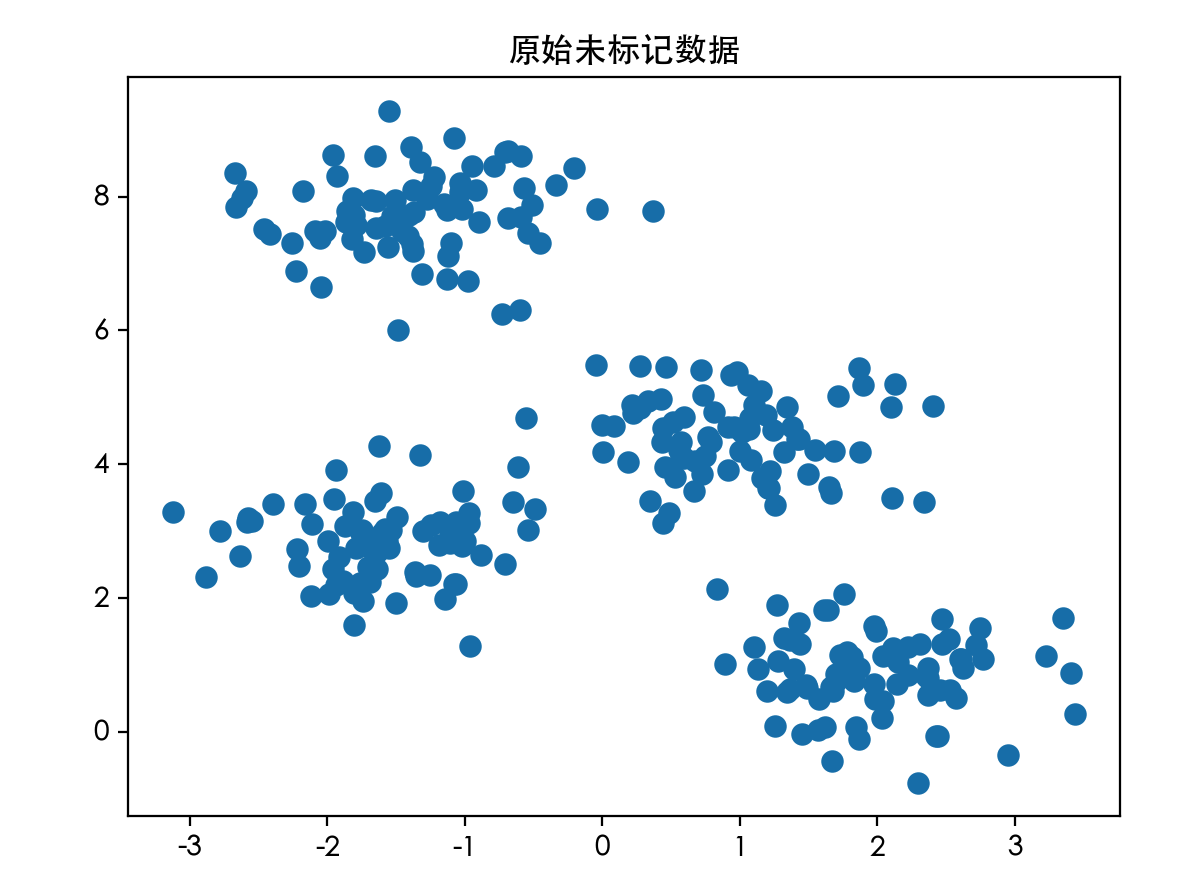
# 2. Visualiser les données d'origine
plt.scatter(X[:, 0], X[:, 1], s=50) # s est la taille des points
plt.title("Données d'origine non étiquetées")
plt.show()
# 3. Appliquer le clustering K-Means
# Spécifier le regroupement en 4 classes
kmeans = KMeans(n_clusters=4, random_state=0, n_init='auto')
# Ajuster le modèle et prédire l'étiquette de cluster de chaque échantillon
y_kmeans = kmeans.fit_predict(X)
# 4. Obtenir les coordonnées des centroïdes
centroids = kmeans.cluster_centers_
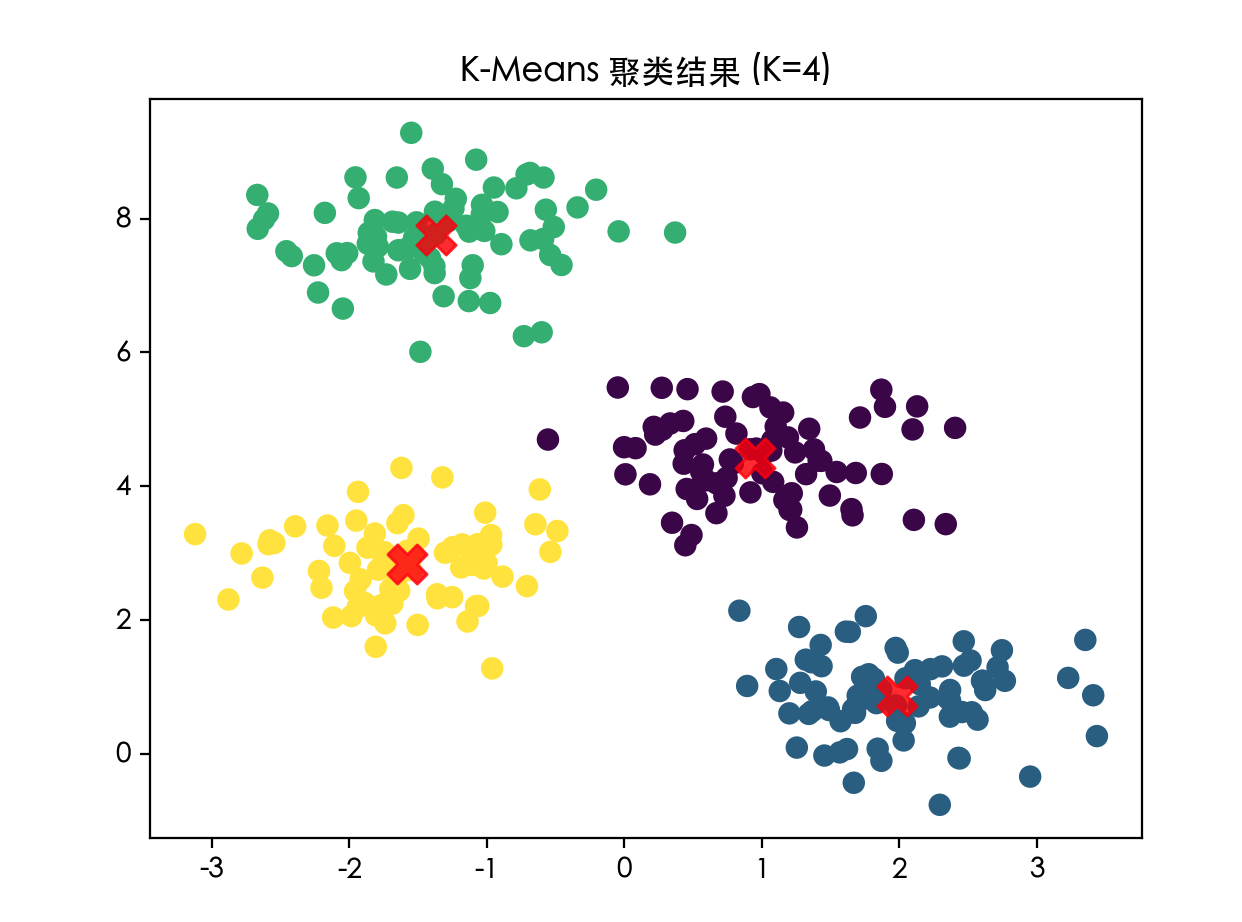
# 5. Visualiser les résultats du clustering
plt.scatter(X[:, 0], X[:, 1], c=y_kmeans, s=50, cmap='viridis')
# Marquer les points d'échantillon des différents clusters avec différentes couleurs
plt.scatter(centroids[:, 0], centroids[:, 1], c='red', s=200, alpha=0.8, marker='X')
# Marquer les positions des centroïdes avec des croix rouges, alpha est la transparence
plt.title("Résultat du clustering K-Means (K=4)")
plt.show()
# Afficher les étiquettes de cluster prédites des 10 premiers échantillons
print("Étiquettes de cluster des 10 premiers échantillons :", y_kmeans[:10])
# Afficher les coordonnées des centroïdes
print("Coordonnées des centroïdes des quatre clusters :"\n", centroids)
Explication du code:
make_blobs: Génère un jeu de données simulé pour le clustering,centers=4indique que les données sont générées autour de 4 points centraux.KMeans(n_clusters=4): Crée une instance de modèle K-Means, en spécifiant le nombre de clusters K à 4.n_init='auto'est le nombre de fois où l'algorithme est exécuté, en conservant le meilleur résultat.fit_predict(X): La méthode principale, sur les donnéesXajuste le modèle et renvoie l'indice de cluster (0, 1, 2, 3) pour chaque échantillon.cluster_centers_: Un attribut qui stocke les coordonnées des K centroïdes obtenus après l'entraînement.
En exécutant ce code, vous verrez deux graphiques. Le premier est un ensemble de points en désordre, tandis que le second est clairement divisé en quatre groupes colorés, avec des marqueurs rougesXaux centres. C'est la magie du K-Means !
前10个样本的簇标签: [1 2 0 2 1 1 3 0 2 2]
四个簇的质心坐标:
 [[ 0.94973532  4.41906906]
 [ 1.98258281  0.86771314]
 [-1.37324398  7.75368871]
 [-1.58438467  2.83081263]]
Données originales non étiquetées :
Résultat du clustering K-Means :
Comment choisir la meilleure valeur de K ?
Dans l'exemple ci-dessus, comme nous savons que les données sont générées autour de 4 centres, nous avons facilement définiK=4. Mais dans le monde réel, nous ne savons souvent pas en combien de classes les données doivent être divisées. Comment choisir K ?
Une méthode couramment utilisée est la"méthode du coude". L'idée est : à mesure que le nombre de clusters K augmente, la distance moyenne entre les points d'échantillon et le centroïde de leur cluster (appeléedistorsionouinertia) diminuera. Lorsque K est inférieur au véritable nombre de clusters, augmenter K réduira fortement cette distance ; lorsque K atteint le véritable nombre de clusters, augmenter encore K fait chuter brusquement la réduction de la distance. Ce point d'inflexion est comme l'articulation du coude, et la valeur de K correspondante est un meilleur choix.
Exemple
inertias = []
K_range = range(1, 11) # Tester K de 1 à 10
for k in K_range:
kmeans = KMeans(n_clusters=k, random_state=0, n_init='auto')
kmeans.fit(X)
inertias.append(kmeans.inertia_) # L'attribut inertia_ est le SSE
# Tracer la courbe du coude
plt.plot(K_range, inertias, 'bo-')
plt.xlabel('Nombre de clusters K')
plt.ylabel('Inertie (SSE)')
plt.title('Méthode du coude pour trouver la meilleure valeur de K')
plt.axvline(x=4, color='r', linestyle='--', alpha=0.5) # Marquer le K=4 connu
plt.show()
En observant la courbe générée, vous verrez qu'autour de K=4, la vitesse de descente de la courbe ralentit nettement, formant un « coude », ce qui suggère que K=4 est un choix raisonnable.
Scénarios d'application du clustering
Le partitionnement est un puissant outil d'analyse exploratoire de données avec des applications extrêmement larges :
- Segmentation client: Dans le e-commerce ou le marketing, partitionnez en fonction du comportement d'achat et des données démographiques des clients (caractéristiques démographiques) afin de les répartir en groupes tels que « clients à forte valeur » et « clients sensibles au prix » pour un marketing ciblé.
- Segmentation d'image: Regroupez les pixels d'une image en fonction de la couleur et de la texture, ce qui peut être utilisé pour simplifier les images et identifier le premier plan et l'arrière-plan.
- Détection d'anomalies: Les points de données normaux forment généralement des groupes denses, tandis que les valeurs aberrantes sont éloignées du centre de tout groupe. Le partitionnement peut être utilisé pour découvrir ces points aberrants.
- Classification de documents: Regroupez des articles de presse ou des articles de recherche pour découvrir automatiquement des sujets tendance ou des domaines de recherche.
- Analyse de réseaux sociaux: Dans les réseaux sociaux, en regroupant les relations et les interactions des utilisateurs, on peut découvrir des communautés ou des cercles.
Exercices pratiques et résumé
Exercice 1 : Essayez différentes valeurs de KModifiez ce qui suit dans l'exemple de code K-Means ci-dessus :n_clustersParamètres : définissez-les respectivement sur 2, 3, 5, 8. Observez les graphiques des résultats de partitionnement et ressentez l'impact du choix de la valeur de K sur les résultats.
Exercice 2 : Utiliser un jeu de données réelEssayez d'utiliserscikit-learnintégréirisJeu de données (Iris) pour le partitionnement. Bien que ce jeu de données soit généralement utilisé pour la classification, vous pouvez ignorer ses étiquettes et utiliser uniquement les données de caractéristiques (longueur et largeur des sépales et des pétales) pour le partitionnement K-Means, puis comparer les résultats du partitionnement avec les vraies étiquettes pour voir à quel point cela fonctionne.
Exemple
iris = datasets.load_iris()
X_iris = iris.data # N'utiliser que les données de caractéristiques