Métricas de clasificación
En el mundo del aprendizaje automático, construir un modelo de clasificación es solo el primer paso. Así como un médico no puede diagnosticar una enfermedad solo por intuición, nosotros también necesitamos un conjunto científico deindicadores de chequeo médicopara evaluar la salud del modelo. Estas métricas son lasmétricas de clasificación, que nos dicen qué tan preciso es el modelo, qué hace bien y en qué aspectos aún tiene deficiencias.
Hoy aprenderemos juntos estas herramientas de evaluación tan importantes.
¿Por qué se necesitan métricas de clasificación?
Imagina que entrenas un modelo para identificar si un correo electrónico es spam. El modelo hace predicciones sobre 100 correos. Podrías preguntarte:
- "¿Cuántos acertó?" -> esto da lugar ala exactitud (accuracy)。
- "De los correos que realmente son spam, ¿cuántos encontró?" -> esto da lugar ala sensibilidad (recall)。
- "De los que dijo que son spam, ¿cuántos realmente lo son?" -> esto da lugar ala precisión。
Si solo se juzgara por cuántos aciertos, sería como evaluar a un estudiante únicamente por la calificación total del examen, ignorando mucha información importante. Diferentes escenarios de negocio tienen diferentes prioridades:
- Diagnóstico de enfermedades: nos importa más no dejar pasar a ningún paciente (alta sensibilidad), aunque eso signifique examinar también a algunas personas sanas (sacrificando algo de precisión).
- Filtrado de spam: nos importa más no enviar correos importantes a la papelera (alta precisión), aunque eso signifique dejar pasar algunos correos spam (sacrificando algo de sensibilidad).
Por lo tanto, necesitamos un conjunto de métricas que evalúen el rendimiento del modelo de manera integral desde diferentes ángulos.
Concepto clave: matriz de confusión
Casi todas las métricas de clasificación se derivan de una herramienta poderosa:la matriz de confusión. Es el «mapa panorámico» para entender los resultados de las predicciones del modelo.
¿Qué es una matriz de confusión?
Es una tabla que muestra las cuatro situaciones posibles entre las predicciones del modelo y las etiquetas reales.
Ejemplo
from sklearn.metrics import confusion_matrix
import seaborn as sns
import matplotlib.pyplot as plt
# Supongamos que tenemos las etiquetas reales y las predicciones
y_true = [1, 0, 1, 1, 0, 0, 1, 0, 0, 1] # 1 representa spam, 0 representa correo normal
y_pred = [1, 0, 0, 1, 0, 0, 1, 1, 0, 1] # Resultados de las predicciones del modelo
# Calcular la matriz de confusión
cm = confusion_matrix(y_true, y_pred)
print("Matriz de confusión:")
print(cm)
# La salida podría ser:
# [[4 1] # reales 0 (normales), 4 predichos como 0 (TN), 1 predicho como 1 (FP)
# [1 4]] # reales 1 (spam), 1 predicho como 0 (FN), 4 predichos como 1 (TP)
Para entenderlo mejor, lo visualizamos:
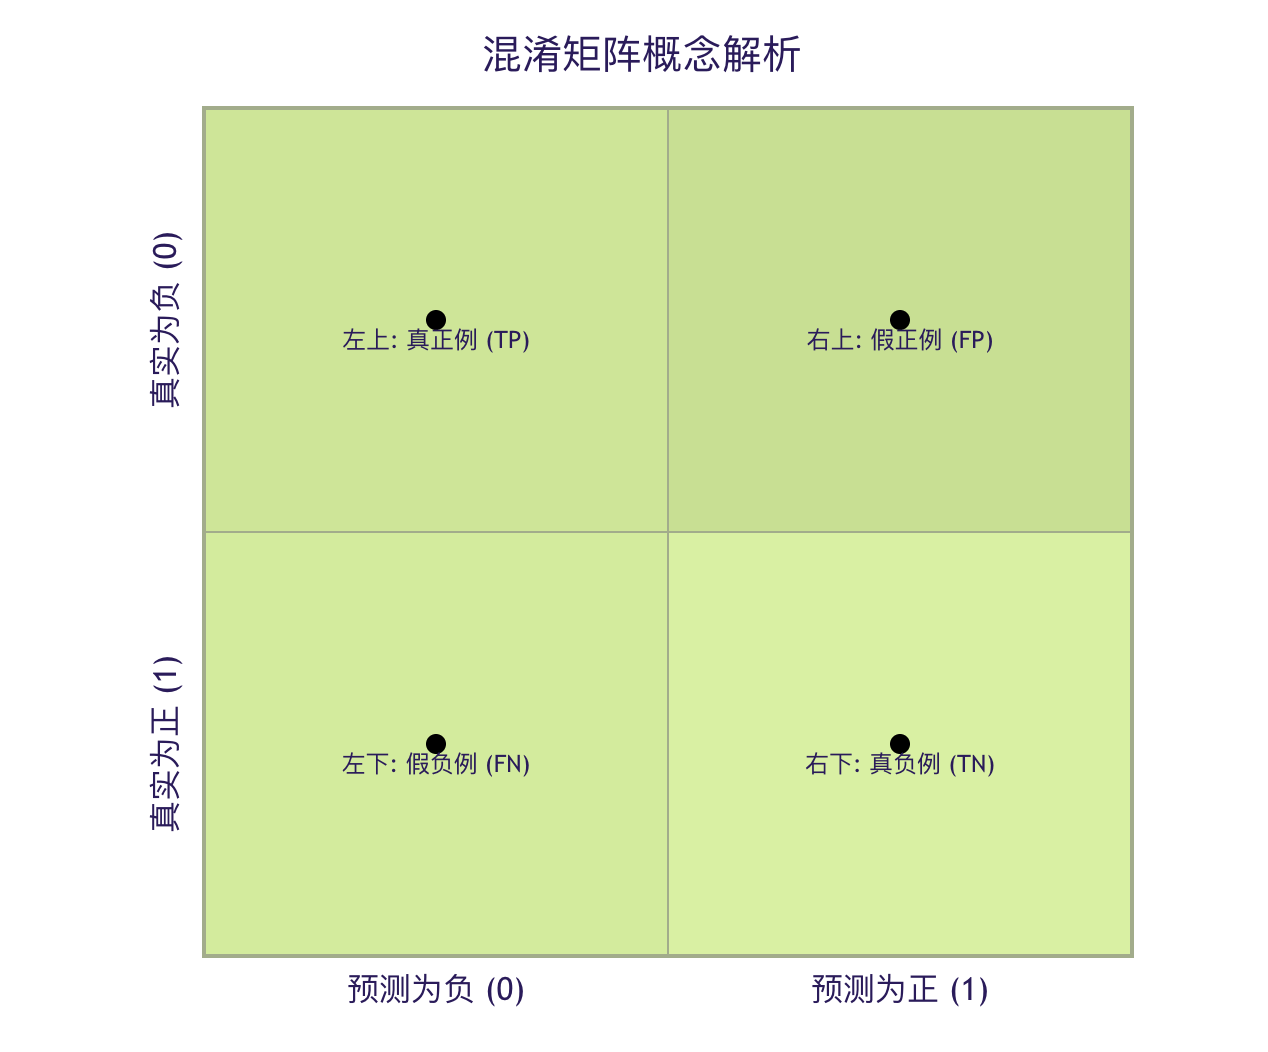
Desglosemos estos cuatro términos clave:
| Término | Abreviatura | Significado | Explicación en el ejemplo del spam |
|---|---|---|---|
| Verdadero positivo | TP | El modelo predice comocorrecto, y lo real también escorrecto。 | que el modelo identifica correctamente comospam。 |
| Falso positivo | FP | El modelo predice comocorrecto, pero lo real escarga。 | el modeloclasifica erróneamentecomo spamcorreo normal。 (Type I Error) |
| Verdadero negativo | TN | El modelo predice comocarga, y lo real también escarga。 | que el modelo identifica correctamente comocorreo normal。 |
| Falso negativo | FN | El modelo predice comocarga, pero lo real escorrecto。 | el modeloomitedespam。 (Type II Error) |
Truco para recordar:
- Verdadero/Falsose refiere asi la predicción es correcta。
- Positivo/Negativose refiere aal resultado de la predicción del modelo。
3. Explicación detallada de las métricas de clasificación principales
Con la matriz de confusión, podemos calcular varias métricas de evaluación, como si usáramos una fórmula.
1. Exactitud: la métrica más intuitiva
La exactitudmide la proporción de muestras que el modelo predice correctamente respecto al total de muestras.
\[ \text{Exactitud} = \frac{TP + TN}{TP + TN + FP + FN} \]
Ejemplo
accuracy = accuracy_score(y_true, y_pred)
print(f"Exactitud: {accuracy:.2f}") # Salida: 0.80 (8/10)
Características y limitaciones:
- Ventaja: es muy intuitiva y fácil de entender.
- Desventaja: endatos desequilibradospuede ser engañosa. Por ejemplo, si el 99% de los correos son normales, un 'modelo tonto' que prediga todos los correos como normales también puede alcanzar una exactitud del 99%, pero no detectará ni un solo spam.
2. Precisión: la métrica de "calidad sobre cantidad"
La precisiónse centra en cuántos de lospositivospredichos por el modelo son realmente positivos. Mide lafiabilidadoy la precisión de los resultados de la predicción.。
\[ \text{Precisión} = \frac{TP}{TP + FP} \]
Pregunta: de los correos que predecimos como spam, ¿cuántos son realmente spam?Una alta precisión significa: cuando el modelo dice 'esto es spam', es muy confiable.
Ejemplo
precision = precision_score(y_true, y_pred)
print(f"Precisión: {precision:.2f}") # Salida: 0.80 (TP=4, TP+FP=5)
3. Sensibilidad (recall): la métrica de "más vale pasarse que quedarse corto"
La sensibilidad (recall)se centra en cuántos de todos lospositivos realesson encontrados por el modelo. Mide lacapacidad del modelo para descubrir positivos.。
\[ \text{Sensibilidad} = \frac{TP}{TP + FN} \]
Pregunta: de todos los correos que realmente son spam, ¿cuántos encontramos?Una alta sensibilidad significa: el modelo rara vez deja pasar un spam real.
Ejemplo
recall = recall_score(y_true, y_pred)
print(f"Sensibilidad: {recall:.2f}") # Salida: 0.80 (TP=4, TP+FN=5)
4. Puntuación F1: la media armónica de la precisión y la sensibilidad (recall)
La precisión y la sensibilidad suelen estar en conflicto (al mejorar una, la otra tiende a disminuir).La puntuación F1es la media armónica de ambas, y busca encontrar un punto de equilibrio.
\[ \text{Puntuación F1} = 2 \times \frac{\text{Precisión} \times \text{Sensibilidad}}{\text{Precisión} + \text{Sensibilidad}} \]
Característica de la media armónica: tiende a penalizar los valores extremos. Solo cuando tanto la precisión como la sensibilidad son altas, la puntuación F1 será alta.
Ejemplo
f1 = f1_score(y_true, y_pred)
print(f"Puntuación F1: {f1:.2f}") # Salida: 0.80
Comparación de métricas y guía de selección
| Métrica | Fórmula | Enfoque | Ejemplo de caso de uso |
|---|---|---|---|
| Exactitud | (TP+TN)/Total | Tasa de predicciones correctas en general | Escenarios con clases equilibradas y donde FP y FN tienen costos similares. |
| Precisión | TP/(TP+FP) | Predichos como positivosexactitud de las muestras | Costo alto de FP: como el filtrado de spam (miedo a eliminar correos importantes) y los sistemas de recomendación (miedo a recomendar productos de baja calidad). |
| Recall | TP/(TP+FN) | muestras verdaderamente positivasproporción de muestras que se encuentran | El costo de los FN es alto: como la detección de enfermedades (miedo a no diagnosticar) y la detección de fraudes (miedo a omitir transacciones fraudulentas). |
| Puntuación F1 | 2PR/(P+R) | Equilibrio entre precisión y recall | Se utiliza en escenarios que requieren una consideración integral y no tienen una preferencia clara; es mejor que la exactitud cuando las clases están desequilibradas. |
4. Métricas avanzadas: curva ROC y AUC
Cuando la predicción del modelo es un valor de probabilidad (por ejemplo, la probabilidad de que un correo sea spam es 0.8), necesitamos establecer unumbral(como 0.5) para decidir la clasificación final. La curva ROC nos ayuda a evaluar el rendimiento general del modelo bajo diferentes umbrales.
1. Tasa de verdaderos positivos (TPR) y tasa de falsos positivos (FPR)
- Tasa de verdaderos positivos (TPR): en realidad esel recall。TPR = TP / (TP + FN)
- Tasa de falsos positivos (FPR): la proporción de todos los negativos reales que se predicen incorrectamente como positivos. FPR = FP / (FP + TN)
2. Curva ROC
La curva ROC utilizaFPR como eje horizontal,TPR como eje vertical. Cada punto de la curva corresponde a un umbral de clasificación específico.
- Punto ideal: la esquina superior izquierda (0, 1), es decir, FPR=0 (sin falsos positivos) y TPR=1 (recuperación completa).
- Línea aleatoria: la diagonal que va de (0,0) a (1,1), que representa el rendimiento de un modelo que adivina al azar.
3. Valor del AUC
El AUC es el área bajo la curva ROC.
- AUC = 1: modelo perfecto.
- AUC = 0.5: el modelo no tiene capacidad de discriminación; equivale a adivinar al azar.
- 0.5 < AUC < 1: el modelo tiene cierta capacidad predictiva; cuanto mayor sea el valor, mejor.
- AUC < 0.5: el modelo es incluso peor que adivinar al azar; normalmente significa que la dirección de la predicción está invertida.
La ventaja del AUC es quees insensible al desequilibrio de clases, y evalúa la capacidad de ordenación general del modelo (la capacidad de clasificar las muestras positivas antes que las negativas).
Ejemplo
import numpy as np
import matplotlib.pyplot as plt
# Supongamos que tenemos algunas probabilidades predichas (simuladas aquí con números aleatorios)
y_true = [1, 0, 1, 0, 1]
y_scores = [0.9, 0.4, 0.6, 0.3, 0.8] # Probabilidad de que el modelo prediga como positivo
fpr, tpr, thresholds = roc_curve(y_true, y_scores)
roc_auc = auc(fpr, tpr)
print(f"Valor AUC: {roc_auc:.2f}")
# Dibujar la curva ROC (opcional, requiere matplotlib)
plt.figure()
plt.plot(fpr, tpr, color='darkorange', lw=2, label=f'ROC curve (area = {roc_auc:.2f})')
plt.plot([0, 1], [0, 1], color='navy', lw=2, linestyle='--', label='Random Guess')
plt.xlim([0.0, 1.0])
plt.ylim([0.0, 1.05])
plt.xlabel('False Positive Rate')
plt.ylabel('True Positive Rate')
plt.title('Receiver Operating Characteristic (ROC) Curve')
plt.legend(loc="lower right")
plt.show()
Salida:
AUC 值: 1.00

Métricas para problemas de clasificación multiclase
Cuando hay más de dos clases (por ejemplo, reconocer gatos, perros y conejos), las métricas anteriores se pueden ampliar de las siguientes maneras:
- Promedio macro: primero se calcula la métrica de cada clase (como la precisión) y luego se toma la media aritmética de las métricas de todas las clases.Trata cada clase por igual。
- Promedio micro: primero se agregan los TP, FP, etc. de todas las clases y luego se calcula una métrica global con los valores agregados.Trata cada muestra por igual, y se ve más afectado por las clases grandes.
En Scikit-learn, se puede especificar mediante elaverageparámetro:
Ejemplo
# y_true y y_pred ahora son etiquetas multiclase, por ejemplo [0, 1, 2, 0, 1]
precision_macro = precision_score(y_true, y_pred, average='macro') # Promedio macro
precision_micro = precision_score(y_true, y_pred, average='micro') # Promedio micro
6. Ejercicio práctico: evaluación integral de un modelo de clasificación
Ahora, practiquemos con un conjunto de datos real. Usaremos el famoso conjunto de datos de Iris.
Ejemplo
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, confusion_matrix, accuracy_score
# 1. Cargar los datos
iris = load_iris()
X = iris.data
y = iris.target
target_names = iris.target_names
# 2. Dividir el conjunto de entrenamiento y el de prueba
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.3, random_state=42)
# 3. Entrenar un modelo simple de regresión logística
model = LogisticRegression(max_iter=200)
model.fit(X_train, y_train)
# 4. Hacer predicciones en el conjunto de prueba
y_pred = model.predict(X_test)
y_pred_proba = model.predict_proba(X_test) # Obtener las probabilidades predichas para el AUC
# 5. Calcular e imprimir varias métricas
print("=== Matriz de confusión ===")
print(confusion_matrix(y_test, y_test))
# Nota: la matriz de confusión multiclase es de N x N
print("\n=== Informe de clasificación (incluye precisión, recall, F1) ===)
print(classification_report(y_test, y_pred, target_names=target_names))
# classification_report es una función muy conveniente que genera varias métricas de una sola vez.
print(f"\n=== Exactitud ===)
print(f"{accuracy_score(y_test, y_pred):.4f}")
# 6. Para el AUC multiclase, normalmente se calcula el AUC "uno contra todos" (one-vs-rest) de cada clase con respecto a las demás y luego se promedia.
from sklearn.metrics import roc_auc_score
# Nota: roc_auc_score en clasificación multiclase requiere especificar multi_class='ovr' (One-vs-Rest) y average
try:
auc_ovr = roc_auc_score(y_test, y_pred_proba, multi_class='ovr', average='macro')
print(f"\n=== AUC promedio macro (OvR) ===)
print(f"{auc_ovr:.4f}")
except Exception as e:
print(f"\nError al calcular el AUC (posiblemente algunas clases no aparecen en el conjunto de prueba): {e}")
Al ejecutar este código, verás un informe completo de evaluación del modelo. Intenta modificar los parámetros del modelo o usar un modelo diferente (comosklearn.tree.DecisionTreeClassifier), y observa cómo cambian estas métricas.
=== 混淆矩阵 ===
[[19  0  0]
 [ 0 13  0]
 [ 0  0 13]]

=== 分类报告(包含精确率、召回率、F1)===
              precision    recall  f1-score   support

      setosa       1.00      1.00      1.00        19
  versicolor       1.00      1.00      1.00        13
   virginica       1.00      1.00      1.00        13

    accuracy                           1.00        45
   macro avg       1.00      1.00      1.00        45
weighted avg       1.00      1.00      1.00        45


=== 准确率 ===
1.0000

=== 宏平均 AUC (OvR) ===
1.0000
Otras extensiones