Términos básicos del aprendizaje automático
Aprender aprendizaje automático es como aprender un nuevo idioma: primero hay que dominar el vocabulario básico. Estos términos forman el "sistema de lenguaje" del aprendizaje automático; comprenderlos es el primer paso para un aprendizaje profundo.
Imagina que le enseñas a un robot a reconocer frutas:
- Datos: imágenes e información de varias frutas
- Características: color, forma, tamaño, sabor de la fruta
- Etiqueta: el nombre de la fruta (manzana, plátano, naranja)
- Modelo: el "método para reconocer frutas" que el robot aprendió
- Entrenamiento: el proceso de enseñar al robot a reconocer frutas
- Inferencia: la capacidad del robot para reconocer frutas nuevas
Datos (Data)
¿Qué son los datos?
Datosson la "materia prima" del aprendizaje automático, igual que los ingredientes que un cocinero necesita para preparar un plato. Sin datos, el aprendizaje automático no puede funcionar.
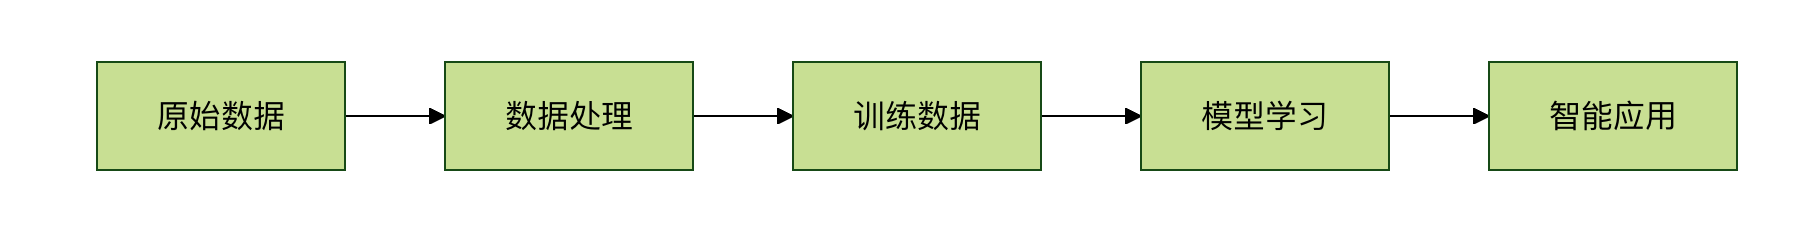
Tipos de datos
1. Datos estructurados
Características: tienen un formato y organización claros, ordenados como una tabla
# Ejemplo de datos estructurados: tabla de información de estudiantesEjemplo
students_data = {
'Nombre': ['Zhang San', 'Li Si', 'Wang Wu'],
'Edad': [18, 19, 20],
'Calificación': [85, 92, 78],
'Clase': ['Clase 1', 'Clase 2', 'Clase 1']
}
df = pd.DataFrame(students_data)
print(df)
Salida:
   姓名  年龄  成绩  班级
0  张三  18  85  一班
1  李四  19  92  二班
2  王五  20  78  一班
2. Datos no estructurados
Características: no tienen un formato fijo y requieren un procesamiento especial
Ejemplos:
- Texto: comentarios, artículos, correos electrónicos
- Imágenes: fotografías, imágenes médicas
- Audio: voz, música
- Video: grabaciones de vigilancia, películas
# 非结构化数据示例:文本和图像
text_data = "这个产品质量很好,我很满意!"
# image_data = 一张产品的照片
# audio_data = 顾客的语音评价
Importancia de la calidad de los datos
Basura entra, basura sale(Garbage In, Garbage Out) es un principio importante del aprendizaje automático. La calidad de los datos determina directamente el rendimiento del modelo.
Ejemplo
import numpy as np
import pandas as pd
# Crear datos con varios problemas
problematic_data = {
'Precio': [100, 200, None, 300, -50], # Valores faltantes y valores atípicos
'Puntuación': [4.5, 'Bueno', 3.8, 4.2, 5.0], # Tipos de datos inconsistentes
'Ventas': [1000, 1200, 800, 1500, 'Muchos'] # Texto y números mezclados
}
df = pd.DataFrame(problematic_data)
print("Datos problemáticos:")
print(df)
print("\nAnálisis de problemas de datos:")
print(f"Número de valores faltantes: {df.isnull().sum().sum()}")
print(f"Tipos de datos:\n{df.dtypes}")
Característica (Feature)
¿Qué es una característica?
Característicaes el "atributo observable" de los datos, como describir las características de una persona: altura, peso, color de cabello, personalidad, etc. En el aprendizaje automático, las características son la base para hacer predicciones.
Importancia de la selección de características:
- Las buenas características hacen que el modelo logre el doble con la mitad de esfuerzo.
- Las malas características hacen que el modelo logre la mitad con el doble de esfuerzo.
- La ingeniería de características suele ser la clave para determinar el rendimiento del modelo.
Tipos de características
x1. Características numéricas
Características: se pueden representar con números y se pueden realizar operaciones matemáticas
# 数值特征示例
numerical_features = {
    '年龄': [25, 30, 35, 40],
    '收入': [5000, 8000, 12000, 15000],
    '身高': [165, 170, 175, 180]
}
2. Características categóricas
Características: representan diferentes categorías, no se pueden realizar operaciones matemáticas
# 类别特征示例
categorical_features = {
    '性别': ['男', '女', '男', '女'],
    '学历': ['本科', '硕士', '博士', '本科'],
    '城市': ['北京', '上海', '广州', '深圳']
}
3. Características de texto
Características: requieren un procesamiento especial para ser utilizadas por el modelo
# 文本特征示例
text_features = {
    '评论': [
        '这个产品很好用,推荐购买!',
        '质量一般,不太满意。',
        '性价比高,值得入手。'
    ]
}
Ejemplo de ingeniería de características
Ejemplo
import pandas as pd
import numpy as np
# Datos brutos: información de la casa
house_data = {
'Área': [80, 120, 60, 150, 90],
'Dormitorios': [2, 3, 1, 4, 2],
'Año de construcción': [2000, 2010, 1995, 2015, 2005],
'Precio': [200, 350, 150, 500, 280]
}
df = pd.DataFrame(house_data)
# Crear nuevas características
df['Antigüedad'] = 2023 - df['Año de construcción'] # Edad de la casa
df['Precio por metro cuadrado'] = df['Precio'] / df['Área'] # Precio unitario
df['Proporción de dormitorios'] = df['Dormitorios'] / df['Área'] * 100 # Proporción de dormitorios
print("Datos brutos + nuevas características:")
print(df)
# Análisis de importancia de características
correlation = df.corr()['Precio'].sort_values(ascending=False)
print("\nCorrelación entre características y precio:")
print(correlation)
Etiqueta (Label)
¿Qué es una etiqueta?
Etiquetaes la "respuesta" que queremos predecir, como la respuesta correcta de una pregunta de examen. En el aprendizaje supervisado, cada muestra de datos tiene una etiqueta correspondiente.
Función de la etiqueta:
- Guiar la dirección de aprendizaje del modelo
- Evaluar el efecto de aprendizaje del modelo
- Definir el tipo de problema
Tipos de etiquetas
1. Etiquetas de clasificación
Características: valores de categoría discretos
# 分类标签示例
classification_labels = {
    '邮件类型': ['垃圾邮件', '正常邮件', '垃圾邮件', '正常邮件'],
    '情感倾向': ['正面', '负面', '中性', '正面'],
    '疾病诊断': ['患病', '健康', '健康', '患病']
}
2. Etiquetas de regresión
Características: valores numéricos continuos
# 回归标签示例
regression_labels = {
    '房价': [250000, 320000, 180000, 450000],
    '温度': [25.5, 28.3, 22.1, 30.0],
    '股票价格': [100.5, 105.2, 98.7, 110.3]
}
Importancia de la calidad de las etiquetas
# 标签质量问题示例
import numpy as np
# 模拟图像分类任务中的标签问题
image_data = ['cat1.jpg', 'dog1.jpg', 'cat2.jpg', 'dog2.jpg']
problematic_labels = ['猫', '犬', '猫咪', '狗']  # 标签不一致
# 标签标准化
label_mapping = {
    '猫': 'cat', '猫咪': 'cat',
    '犬': 'dog', '狗': 'dog'
}
standardized_labels = [label_mapping[label] for label in problematic_labels]
print("原始标签:", problematic_labels)
print("标准化标签:", standardized_labels)
Modelo (Model)
¿Qué es un modelo?
Modeloes la "regla" o "patrón" que el algoritmo de aprendizaje automático aprende de los datos, como el conocimiento que un estudiante aprende de los libros de texto.
Naturaleza del modelo:
- Función matemática: entran características, sale una predicción
- Conjunto de parámetros: la representación concreta de las reglas aprendidas
- Reglas de decisión: cómo obtener la salida a partir de la entrada
Representación del modelo
Ejemplo
import numpy as np
import matplotlib.pyplot as plt
# Simular datos
X = np.array([1, 2, 3, 4, 5])
y = np.array([2, 4, 6, 8, 10])
# Modelo lineal: y = w * x + b
# Parámetros aprendidos: w = 2, b = 0
w, b = 2, 0
def linear_model(x):
"""Función del modelo lineal"""
return w * x + b
# Predicción
predictions = linear_model(X)
# Visualización
plt.scatter(X, y, color='blue', label='Datos reales')
plt.plot(X, predictions, color='red', label='Predicción del modelo')
plt.xlabel('Entrada X')
plt.ylabel('Salida y')
plt.title('Ejemplo de modelo lineal')
plt.legend()
plt.grid(True)
plt.show()
print(f"Parámetros del modelo: w = {w}, b = {b}")
print(f"Resultados de la predicción: {predictions}")
Complejidad del modelo
Ejemplo
from sklearn.preprocessing import PolynomialFeatures
from sklearn.linear_model import LinearRegression
import numpy as np
# Generar datos no lineales
np.random.seed(42)
X = np.random.rand(20, 1) * 10
y = np.sin(X) + np.random.randn(20, 1) * 0.1
# Modelo simple (lineal)
simple_model = LinearRegression()
simple_model.fit(X, y)
# Modelo complejo (polinomio de alto grado)
poly_features = PolynomialFeatures(degree=10)
X_poly = poly_features.fit_transform(X)
complex_model = LinearRegression()
complex_model.fit(X_poly, y)
# Visualización
X_test = np.linspace(0, 10, 100).reshape(-1, 1)
X_test_poly = poly_features.transform(X_test)
plt.scatter(X, y, color='blue', label='Datos de entrenamiento')
plt.plot(X_test, simple_model.predict(X_test), color='green', label='Modelo simple')
plt.plot(X_test, complex_model.predict(X_test_poly), color='red', label='Modelo complejo')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Comparación de complejidad del modelo')
plt.legend()
plt.grid(True)
plt.show()
Entrenamiento (Training)
¿Qué es el entrenamiento?
Entrenamientoes el proceso de aprendizaje del modelo, como los estudiantes que aprenden conocimientos en clase. Durante el entrenamiento, el modelo ajusta continuamente sus parámetros para que las predicciones se acerquen cada vez más a las etiquetas reales.
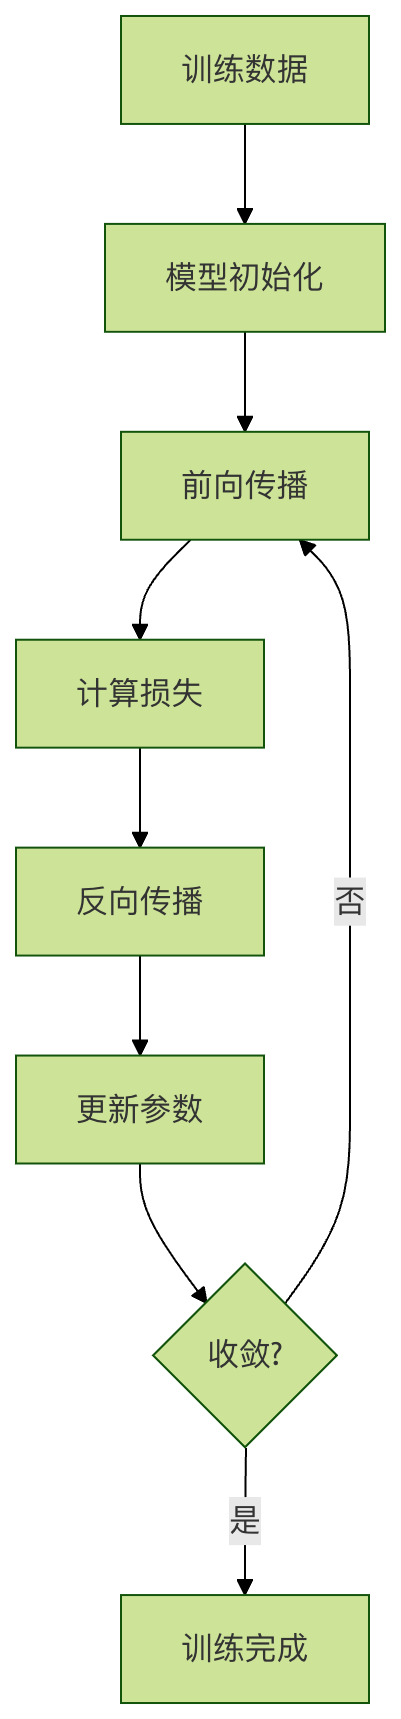
Ejemplo del proceso de entrenamiento
Ejemplo
import numpy as np
import matplotlib.pyplot as plt
# Generar datos de entrenamiento
np.random.seed(42)
X = np.random.rand(50, 1) * 10
y = 3 * X + 2 + np.random.randn(50, 1) * 2
# Inicializar los parámetros del modelo
w, b = 0.0, 0.0
learning_rate = 0.01
epochs = 100
# Registrar el proceso de entrenamiento
loss_history = []
# Bucle de entrenamiento
for epoch in range(epochs):
# Propagación hacia adelante
y_pred = w * X + b
# Calcular la pérdida (error cuadrático medio)
loss = np.mean((y_pred - y) ** 2)
loss_history.append(loss)
# Calcular el gradiente
dw = np.mean(2 * X * (y_pred - y))
db = np.mean(2 * (y_pred - y))
# Actualizar los parámetros
w -= learning_rate * dw
b -= learning_rate * db
if epoch % 10 == 0:
print(f"Epoch {epoch}: Loss = {loss:.4f}, w = {w:.4f}, b = {b:.4f}")
# Visualizar el proceso de entrenamiento
plt.figure(figsize=(12, 4))
plt.subplot(1, 2, 1)
plt.plot(loss_history)
plt.xlabel('Epoch')
plt.ylabel('Loss')
plt.title('Cambio de la pérdida de entrenamiento')
plt.grid(True)
plt.subplot(1, 2, 2)
plt.scatter(X, y, color='blue', label='Datos de entrenamiento')
plt.plot(X, w * X + b, color='red', label='Modelo entrenado')
plt.xlabel('X')
plt.ylabel('y')
plt.title('Resultado del entrenamiento')
plt.legend()
plt.grid(True)
plt.tight_layout()
plt.show()
print(f"Parámetros finales del modelo: w = {w:.4f}, b = {b:.4f}")
Inferencia (Inference)
¿Qué es la inferencia?
InferenciaEs el proceso de usar un modelo entrenado para hacer predicciones, igual que un estudiante usa el conocimiento aprendido para resolver preguntas de examen.
Ejemplo del proceso de inferencia
Ejemplo
import numpy as np
# Supongamos que ya hemos entrenado un modelo de predicción de precios de vivienda
class HousePriceModel:
def __init__(self):
# Simular los parámetros entrenados
self.feature_weights = {
'Área': 2.5,
'Número de dormitorios': 10.0,
'Antigüedad de la vivienda': -1.0,
'Puntuación de ubicación': 50.0
}
self.bias = 50.0
def predict(self, features):
"""
Predicción de precios de vivienda con el modelo entrenado
"""
price = self.bias
for feature_name, feature_value in features.items():
if feature_name in self.feature_weights:
price += self.feature_weights[feature_name] * feature_value
return price
# Crear el modelo entrenado
model = HousePriceModel()
# Inferencia: predecir el nuevo precio de la vivienda
new_houses = [
{'Área': 80, 'Número de dormitorios': 2, 'Antigüedad de la vivienda': 5, 'Puntuación de ubicación': 8},
{'Área': 120, 'Número de dormitorios': 3, 'Antigüedad de la vivienda': 2, 'Puntuación de ubicación': 9},
{'Área': 60, 'Número de dormitorios': 1, 'Antigüedad de la vivienda': 10, 'Puntuación de ubicación': 6}
]
print("Resultado de la predicción del precio de la vivienda:")
for i, house in enumerate(new_houses, 1):
predicted_price = model.predict(house)
print(f"Casa {i}: precio predicho {predicted_price:.2f} diez mil yuanes")
# Inferencia por lotes
def batch_predict(model, house_list):
"""Predicción por lotes"""
return [model.predict(house) for house in house_list]
batch_prices = batch_predict(model, new_houses)
print(f"\nPredicción por lotes: {batch_prices}")
Ejemplo completo: de los datos a la inferencia
Ejemplo
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_squared_error, r2_score
# 1. Preparación de datos
np.random.seed(42)
n_samples = 200
# Generar datos de características
area = np.random.normal(100, 30, n_samples) # Área
bedrooms = np.random.randint(1, 5, n_samples) # Número de dormitorios
age = np.random.randint(0, 20, n_samples) # Antigüedad de la vivienda
location_score = np.random.randint(1, 10, n_samples) # Puntuación de ubicación
# Generar etiquetas (precio de la vivienda) - combinación lineal de características con ruido
price = (area * 2.5 + bedrooms * 20 + age * -2 + location_score * 15 +
np.random.normal(0, 50, n_samples))
# Crear el DataFrame (marco de datos)
data = pd.DataFrame({
'Área': area,
'Número de dormitorios': bedrooms,
'Antigüedad de la vivienda': age,
'Puntuación de ubicación': location_score,
'Precio': price
})
print("Ejemplo de datos:")
print(data.head())
# 2. Dividir en conjunto de entrenamiento y conjunto de prueba
features = ['Área', 'Número de dormitorios', 'Antigüedad de la vivienda', 'Puntuación de ubicación']
X = data[features]
y = data['Precio']
X_train, X_test, y_train, y_test = train_test_split(X, y, test_size=0.2, random_state=42)
print(f"\nTamaño del conjunto de entrenamiento: {X_train.shape)
print(f"Tamaño del conjunto de prueba: {X_test.shape)
# 3. Entrenar el modelo
model = LinearRegression()
model.fit(X_train, y_train)
print(f"\nParámetros del modelo:")
for feature, coef in zip(features, model.coef_):
print(f"{feature}: {coef:.2f}")
print(f"Intercepto: {model.intercept_:.2f}")
# 4. Evaluar el modelo
y_train_pred = model.predict(X_train)
y_test_pred = model.predict(X_test)
train_mse = mean_squared_error(y_train, y_train_pred)
test_mse = mean_squared_error(y_test, y_test_pred)
train_r2 = r2_score(y_train, y_train_pred)
test_r2 = r2_score(y_test, y_test_pred)
print(f"\nEvaluación del modelo:")
print(f"MSE del conjunto de entrenamiento: {train_mse:.2f}, R²: {train_r2:.2f}")
print(f"MSE del conjunto de prueba: {test_mse:.2f}, R²: {test_r2:.2f}")
# 5. Inferencia (predicción de nuevos datos)
new_houses = pd.DataFrame({
'Área': [85, 120, 65],
'Número de dormitorios': [2, 3, 1],
'Antigüedad de la vivienda': [3, 1, 8],
'Puntuación de ubicación': [7, 9, 5]
})
predictions = model.predict(new_houses)
print(f"\nPredicción del nuevo precio de la vivienda:")
for i, price in enumerate(predictions, 1):
print(f"Casa {i}: {price:.2f} diez mil yuanes")
Tipos comunes de redes de aprendizaje automático
| Tipo de modelo | Nombre completo en chino | Abreviatura en inglés | Escenarios de aplicación principales | Ventajas | Desventajas |
|---|---|---|---|---|---|
| Machine learning tradicional | Árbol de decisión | DT | Clasificación, regresión, análisis de importancia de características | Alta interpretabilidad, no requiere normalización de datos | Propenso a sobreajuste, sensible al ruido |
| Bosque aleatorio (Random Forest) | RF | Clasificación, regresión, detección de anomalías | Resistente al sobreajuste, alta estabilidad | Alto costo computacional con datos de alta dimensión | |
| Regresión logística | LR | Clasificación binaria, predicción de probabilidades | Entrenamiento rápido, alta interpretabilidad | Difícil ajustar relaciones no lineales | |
| Máquina de vectores de soporte (SVM) | SVM | Clasificación, datos de alta dimensión y muestra pequeña | Fuerte capacidad de generalización, adecuado para escenarios de alta dimensionalidad de características | Entrenamiento lento en datos a gran escala, ajuste de hiperparámetros complejo | |
| Naive Bayes | NB | Clasificación de texto, detección de spam | Velocidad de entrenamiento muy rápida, insensible a datos faltantes | Asume independencia de características, que puede no cumplirse en escenarios reales | |
| XGBoost | XGBoost | Clasificación, regresión, tareas de nivel competitivo | Alta precisión, soporta cómputo paralelo, incluye regularización | Propenso a sobreajuste, sensible a hiperparámetros | |
| LightGBM | LightGBM | Clasificación y regresión de datos a gran escala | Entrenamiento rápido, bajo uso de memoria | Puede ser menos estable que XGBoost en conjuntos de datos pequeños | |
| Aprendizaje profundo | Red neuronal artificial | ANN | Tareas simples de clasificación y regresión | Estructura simple, fácil de entender | Difícil manejar datos complejos y de alta dimensión |
| Red neuronal convolucional | CNN | Reconocimiento de imágenes, detección de objetos, análisis de video | Extracción automática de características espaciales, parámetros compartidos | El entrenamiento requiere grandes cantidades de datos y recursos computacionales | |
| Red neuronal recurrente | RNN | Procesamiento de datos secuenciales, generación de texto | Maneja secuencias de longitud variable | Presenta problemas de desvanecimiento/explosión del gradiente, difícil capturar dependencias a largo plazo | |
| Red de memoria a largo y corto plazo (LSTM) | LSTM | Traducción de textos de secuencias largas, reconocimiento de voz | Resuelve el problema de dependencias largas de RNN | Estructura compleja, velocidad de entrenamiento más lenta | |
| Unidad recurrente cerrada (GRU) | GRU | Procesamiento de secuencias, análisis de sentimiento | Estructura más simple que LSTM, entrenamiento más rápido | Rendimiento ligeramente inferior a LSTM en escenarios de secuencias largas | |
| Red generativa adversarial (GAN) | GAN | Generación de imágenes, transferencia de estilo, aumento de datos | Alta calidad de datos generados, gran diversidad | Entrenamiento inestable, propenso a colapso de modo | |
| Transformer | Transformer | Procesamiento de lenguaje natural, tareas multimodales | Alta eficiencia de cómputo paralelo, fuerte capacidad para capturar dependencias largas | Alto costo computacional, propenso a sobreajuste en conjuntos de datos pequeños | |
| Autoencoder | AE | Compresión de datos, detección de anomalías, extracción de características | Aprendizaje no supervisado, estructura simple | La calidad de los datos generados suele ser inferior a GAN | |
| Red neuronal de grafos | GNN | Análisis de redes sociales, predicción de estructuras moleculares | Procesa datos de estructura de grafos, extrae relaciones entre nodos | Entrenamiento difícil, altos requisitos de preprocesamiento de la estructura de grafos |