Прогнозирование выживания на Титанике
Если вы только начинаете изучать машинное обучение, вам может казаться, что те сложные алгоритмы и математические формулы далеки от реальности. Но сегодня на классическом примере — прогнозировании выживания на «Титанике» — мы на собственном опыте пройдём весь рабочий процесс проекта машинного обучения.
Набор данных «Титаник» — один из самых известных вводных проектов в машинном обучении. Он основан на реальной информации о пассажирах во время крушения «Титаника» в 1912 году. Наша цель:Построить модель, которая предсказывает, выжили ли они в катастрофе, на основе возраста пассажиров, пола, класса билета и другой информации.。
Этот проект классический, потому что он идеально охватывает основные этапы проекта машинного обучения:
- Понимание и исследование данных
- Очистка и предобработка данных
- Инженерия признаков
- Выбор и обучение модели
- Оценка и оптимизация модели
Благодаря этому практическому примеру вы не просто прочитаете теорию, а по-настоящему поймёте, как применять машинное обучение для решения реальных задач.
Шаг 1: Понимание наших данных
Прежде чем писать код, мы должны сначала понять имеющиеся данные. Набор данных Titanic обычно содержит следующие поля (признаки):
| Название поля | Описание | Тип данных | Примечания |
|---|---|---|---|
PassengerId |
Passenger ID | Integer | Уникальный идентификатор, бесполезен для предсказания |
Survived |
Survived | Целое число (0/1) | Целевая переменная, 0=погиб, 1=выжил |
Pclass |
Класс билета (Pclass) | Целое число (1,2,3) | 1=первый класс, 2=второй класс, 3=третий класс |
Name |
Имя пассажира | String | Содержит обращения (например, Mr., Miss.), можно извлечь новые признаки |
Sex |
Пол | String | maleилиfemale |
Age |
Age | Float | Имеет некоторые пропущенные значения |
SibSp |
Количество братьев и сестер/супругов на борту | Integer | |
Parch |
Количество родителей/детей на борту | Integer | |
Ticket |
Номер билета | String | Сложная структура, может содержать ограниченную информацию |
Fare |
Стоимость проезда | Float | |
Cabin |
Cabin | String | Много пропущенных значений, но первая буква может обозначать зону каюты |
Embarked |
Embarked (порт посадки) | String | C=Шербур, Q=Куинстаун, S=Саутгемптон |
Ключевое наблюдение: Из исторических знаний мы знаем, что соблюдался принцип «сначала женщины и дети», и пассажиры первого класса имели приоритетный доступ к спасательным шлюпкам. Поэтому мы ожидаем, чтоSex, Age, Pclassтакие признаки окажут значительное влияние на результаты прогнозирования.
Шаг 2: Очистка и предобработка данных
Исходные данные почти никогда не бывают идеальными.
Очистка данных похожа на подготовку высококачественных ингредиентов для модели; этот шаг крайне важен.
Сохраните следующие данные в файл train.csv:
PassengerId,Survived,Pclass,Name,Sex,Age,SibSp,Parch,Ticket,Fare,Cabin,Embarked
1,0,3,"Braund, Mr. Owen Harris",male,22,1,0,A/5 21171,7.25,,S
2,1,1,"Cumings, Mrs. John Bradley",female,38,1,0,PC 17599,71.2833,C85,C
3,1,3,"Heikkinen, Miss. Laina",female,26,0,0,STON/O2. 3101282,7.925,,S
4,1,1,"Futrelle, Mrs. Jacques Heath",female,35,1,0,113803,53.1,C123,S
5,0,3,"Allen, Mr. William Henry",male,35,0,0,373450,8.05,,S
6,0,3,"Moran, Mr. James",male,,0,0,330877,8.4583,,Q
7,0,1,"McCarthy, Mr. Timothy J",male,54,0,0,17463,51.8625,E46,S
8,0,3,"Palsson, Master. Gosta Leonard",male,2,3,1,349909,21.075,,S
9,1,3,"Johnson, Mrs. Oscar W",female,27,0,2,347742,11.1333,,S
10,1,2,"Nasser, Mrs. Nicholas",female,14,1,0,237736,30.0708,,C
Сохраните следующие данные в файл test.csv:
PassengerId,Pclass,Name,Sex,Age,SibSp,Parch,Ticket,Fare,Cabin,Embarked
11,3,"Kelly, Mr. James",male,34.5,0,0,330911,7.8292,,Q
12,3,"Wilkes, Mrs. James",female,47,1,0,363272,7,,S
13,2,"Myles, Mr. Thomas Francis",male,62,0,0,240276,9.6875,,Q
14,3,"Dwyer, Miss. Ellen",female,18,0,0,330959,7.75,,Q
15,1,"Jones, Mr. Charles",male,,1,0,PC 17603,82.1708,B28,C
Мы будем использоватьpandasиnumpyбиблиотека для выполнения этой задачи.
Пример
import pandas as pd
import numpy as np
# Загрузить данные
train_data = pd.read_csv('train.csv') # Обучающий набор, содержит целевую переменную Survived
test_data = pd.read_csv('test.csv') # Тестовый набор, не содержит Survived, используется для финальной оценки
# 1. Первоначальный взгляд на данные
print("Размер обучающего набора: ", train_data.shape)
print(train_data.info()) # Проверить типы данных и пропущенные значения
print(train_data.head()) # Просмотреть первые несколько строк данных
Вывод:
训练集形状: (10, 12)
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 10 entries, 0 to 9
Data columns (total 12 columns):
 #   Column       Non-Null Count  Dtype
---  ------       --------------  -----
 0   PassengerId  10 non-null     int64
 1   Survived     10 non-null     int64
 2   Pclass       10 non-null     int64
 3   Name         10 non-null     object
 4   Sex          10 non-null     object
 5   Age          9 non-null      float64
 6   SibSp        10 non-null     int64
 7   Parch        10 non-null     int64
 8   Ticket       10 non-null     object
 9   Fare         10 non-null     float64
 10  Cabin        3 non-null      object
 11  Embarked     10 non-null     object
dtypes: float64(2), int64(5), object(5)
memory usage: 1.1+ KB
None
   PassengerId  Survived  Pclass                          Name     Sex  ...  Parch            Ticket     Fare Cabin  Embarked
0            1         0       3       Braund, Mr. Owen Harris    male  ...      0         A/5 21171   7.2500   NaN         S
1            2         1       1    Cumings, Mrs. John Bradley  female  ...      0          PC 17599  71.2833   C85         C
2            3         1       3        Heikkinen, Miss. Laina  female  ...      0  STON/O2. 3101282   7.9250   NaN         S
3            4         1       1  Futrelle, Mrs. Jacques Heath  female  ...      0            113803  53.1000  C123         S
4            5         0       3      Allen, Mr. William Henry    male  ...      0            373450   8.0500   NaN         S

[5 rows x 12 columns]
После выполнения приведённого выше кода вы можете обнаружить две основные проблемы:Пропущенные значенияиНечисловые данные。
Обработка пропущенных значений
Пример
print(train_data.isnull().sum())
# Обработать Age: заполнить медианой
train_data['Age'] = train_data['Age'].fillna(train_data['Age'].median())
test_data['Age'] = test_data['Age'].fillna(test_data['Age'].median())
# Обработка Embarked: заполнить модой
most_common_port = train_data['Embarked'].mode()[0]
train_data['Embarked'] = train_data['Embarked'].fillna(most_common_port)
test_data['Embarked'] = test_data['Embarked'].fillna(most_common_port)
# Обработка Fare (цена билета): тестовый набор
test_data['Fare'] = test_data['Fare'].fillna(test_data['Fare'].median())
# Обработка Cabin: удалить напрямую
train_data.drop(columns=['Cabin'], inplace=True)
test_data.drop(columns=['Cabin'], inplace=True)
Преобразование нечисловых данных
Модели машинного обучения обычно могут обрабатывать только числовые значения. Нам нужно преобразоватьSexиEmbarkedтакие текстовые столбцы в числа.
Пример
train_data['Sex'] = train_data['Sex'].map({'female': 0, 'male': 1})
test_data['Sex'] = test_data['Sex'].map({'female': 0, 'male': 1})
# Преобразовать столбец Embarked в числовой (One-Hot Encoding)
# Поскольку порты не имеют порядка, простое сопоставление с 0,1,2 не подходит
train_data = pd.get_dummies(train_data, columns=['Embarked'])
test_data = pd.get_dummies(test_data, columns=['Embarked'])
Шаг 3: Инженерия признаков
Инженерия признаков — это "магия" в машинном обучении; она помогает модели учиться лучше, создавая или преобразуя признаки. МыNameизвлечение "титулов" из столбца — классический пример.
Пример
# Титулы часто отражают возраст, социальный статус и пол и могут влиять на приоритет при спасении
train_data['Title'] = train_data['Name'].str.extract(' ([A-Za-z]+)\.', expand=False)
test_data['Title'] = test_data['Name'].str.extract(' ([A-Za-z]+)\.', expand=False)
# Просмотр доступных титулов
print(pd.crosstab(train_data['Title'], train_data['Sex']))
# Сгруппировать необычные титулы в 'Rare'
title_mapping = {
'Mr': 'Mr', 'Miss': 'Miss', 'Mrs': 'Mrs',
'Master': 'Master', 'Dr': 'Rare', 'Rev': 'Rare',
'Col': 'Rare', 'Major': 'Rare', 'Mlle': 'Miss',
'Countess': 'Rare', 'Ms': 'Miss', 'Lady': 'Rare',
'Jonkheer': 'Rare', 'Don': 'Rare', 'Dona': 'Rare',
'Mme': 'Mrs', 'Capt': 'Rare', 'Sir': 'Rare'
}
train_data['Title'] = train_data['Title'].map(title_mapping)
test_data['Title'] = test_data['Title'].map(title_mapping)
# Также выполнить one-hot кодирование обработанного столбца Title
train_data = pd.get_dummies(train_data, columns=['Title'])
test_data = pd.get_dummies(test_data, columns=['Title'])
# Создать новый признак: размер семьи
train_data['FamilySize'] = train_data['SibSp'] + train_data['Parch'] + 1
test_data['FamilySize'] = test_data['SibSp'] + test_data['Parch'] + 1
# Создать новый признак: путешествует один
train_data['IsAlone'] = (train_data['FamilySize'] == 1).astype(int)
test_data['IsAlone'] = (test_data['FamilySize'] == 1).astype(int)
# Удалить исходные столбцы, которые больше не нужны
columns_to_drop = ['PassengerId', 'Name', 'Ticket', 'SibSp', 'Parch']
train_data.drop(columns_to_drop, axis=1, inplace=True)
test_passenger_ids = test_data['PassengerId'] # Сохранить ID тестового набора для дальнейшей отправки
test_data.drop(columns_to_drop, axis=1, inplace=True)
print("Названия столбцов обучающего набора после конструирования признаков: ", train_data.columns.tolist())
Шаг 4: Выбор и обучение модели
Теперь у нас есть чистые и информативные числовые данные. Далее мы разделим их напризнаки (X)ицелевую переменную (y), а затем выберем модель для обучения.
Мы начнём с простой и эффективноймодели Random Forest.
Пример
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score
# Подготовка данных
# X — матрица признаков, y — целевой вектор, который мы хотим предсказать
X = train_data.drop('Survived', axis=1)
y = train_data['Survived']
# Чтобы оценить качество модели во время обучения, мы разделяем данные на обучающую и валидационную выборки
# test_size=0.2 означает, что 20% данных используется для валидации, 80% — для обучения
# random_state — это случайное зерно, обеспечивающее одинаковые результаты разбиения каждый раз
X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.2, random_state=42)
# Инициализируем классификатор Random Forest
# n_estimators: количество деревьев в лесу
# max_depth: максимальная глубина деревьев, управляет сложностью модели, предотвращает переобучение
# random_state: обеспечивает воспроизводимые результаты
model = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# Обучите модель (пусть модель выучит закономерности из данных)
model.fit(X_train, y_train)
# Сделайте прогнозы на валидационном наборе
y_pred = model.predict(X_val)
# Оцените точность модели
accuracy = accuracy_score(y_val, y_pred)
print(f"Точность модели на валидационном наборе: {accuracy:.4f} (т. е. {accuracy*100:.2f}%)")
Шаг 5: Оценка модели, оптимизация и отправка
Оценка и оптимизация
Результат одного запуска обучения может быть неоптимальным. Мы можем улучшить его следующими способами:
- Настройте параметры модели: например, попробуйте разные
n_estimatorsилиmax_depth。 - Попробуйте другие модели: например, логистическую регрессию, машины опорных векторов, деревья градиентного бустинга и т. д.
- Дальнейшее конструирование признаков: например, для
AgeилиFareвыполнить биннинг.
Пример
for depth in [3, 5, 10, None]: # None означает отсутствие ограничения глубины
model_temp = RandomForestClassifier(n_estimators=100, max_depth=depth, random_state=42)
model_temp.fit(X_train, y_train)
y_pred_temp = model_temp.predict(X_val)
acc = accuracy_score(y_val, y_pred_temp)
print(f"Когда max_depth={depth}, точность на валидационном наборе: {acc:.4f}")
Анализ важности признаков
Случайный лес может подсказать, какие признаки вносят наибольший вклад в прогнозы.
Пример
feature_importances = pd.DataFrame({
'feature': X_train.columns,
'importance': model.feature_importances_
}).sort_values('importance', ascending=False)
print("Рейтинг важности признаков:")
print(feature_importances)
Вы можете обнаружитьSex, Fare(связанныеPclass), Age, Titleявляется наиболее важным признаком, что согласуется с нашей исторической интуицией.
Генерация итоговых предсказаний на тестовом наборе
Как только нас устраивает производительность модели, мы переобучаем её на полных обучающих данных и делаем предсказания на реальном тестовом наборе.
Пример
final_model = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
final_model.fit(X, y) # На этот раз используйте все обучающие данные X, y
# Убедитесь, что столбцы признаков тестового набора точно совпадают со столбцами обучающего набора (порядок и количество столбцов)
# pd.get_dummies может приводить к разному количеству столбцов в обучающем и тестовом наборах (если категория встречается только в одном из них)
# Здесь нам нужно выровнять столбцы. Простой способ — объединить, а затем разделить, но более надёжный подход — обеспечить согласованность кодирования.
# Для простоты предположим, что столбцы обработанного тестового набора выровнены.
final_predictions = final_model.predict(test_data)
# Создать файл для отправки
submission = pd.DataFrame({
'PassengerId': test_passenger_ids,
'Survived': final_predictions
})
submission.to_csv('my_titanic_submission.csv', index=False)
print(Результаты предсказания сохранены в 'my_titanic_submission.csv'. Вы можете отправить их на платформу Kaggle, чтобы посмотреть рейтинг!)
Итоги и блок-схема проекта
Мы завершили полный конвейер машинного обучения. Давайте рассмотрим весь процесс с помощью блок-схемы:
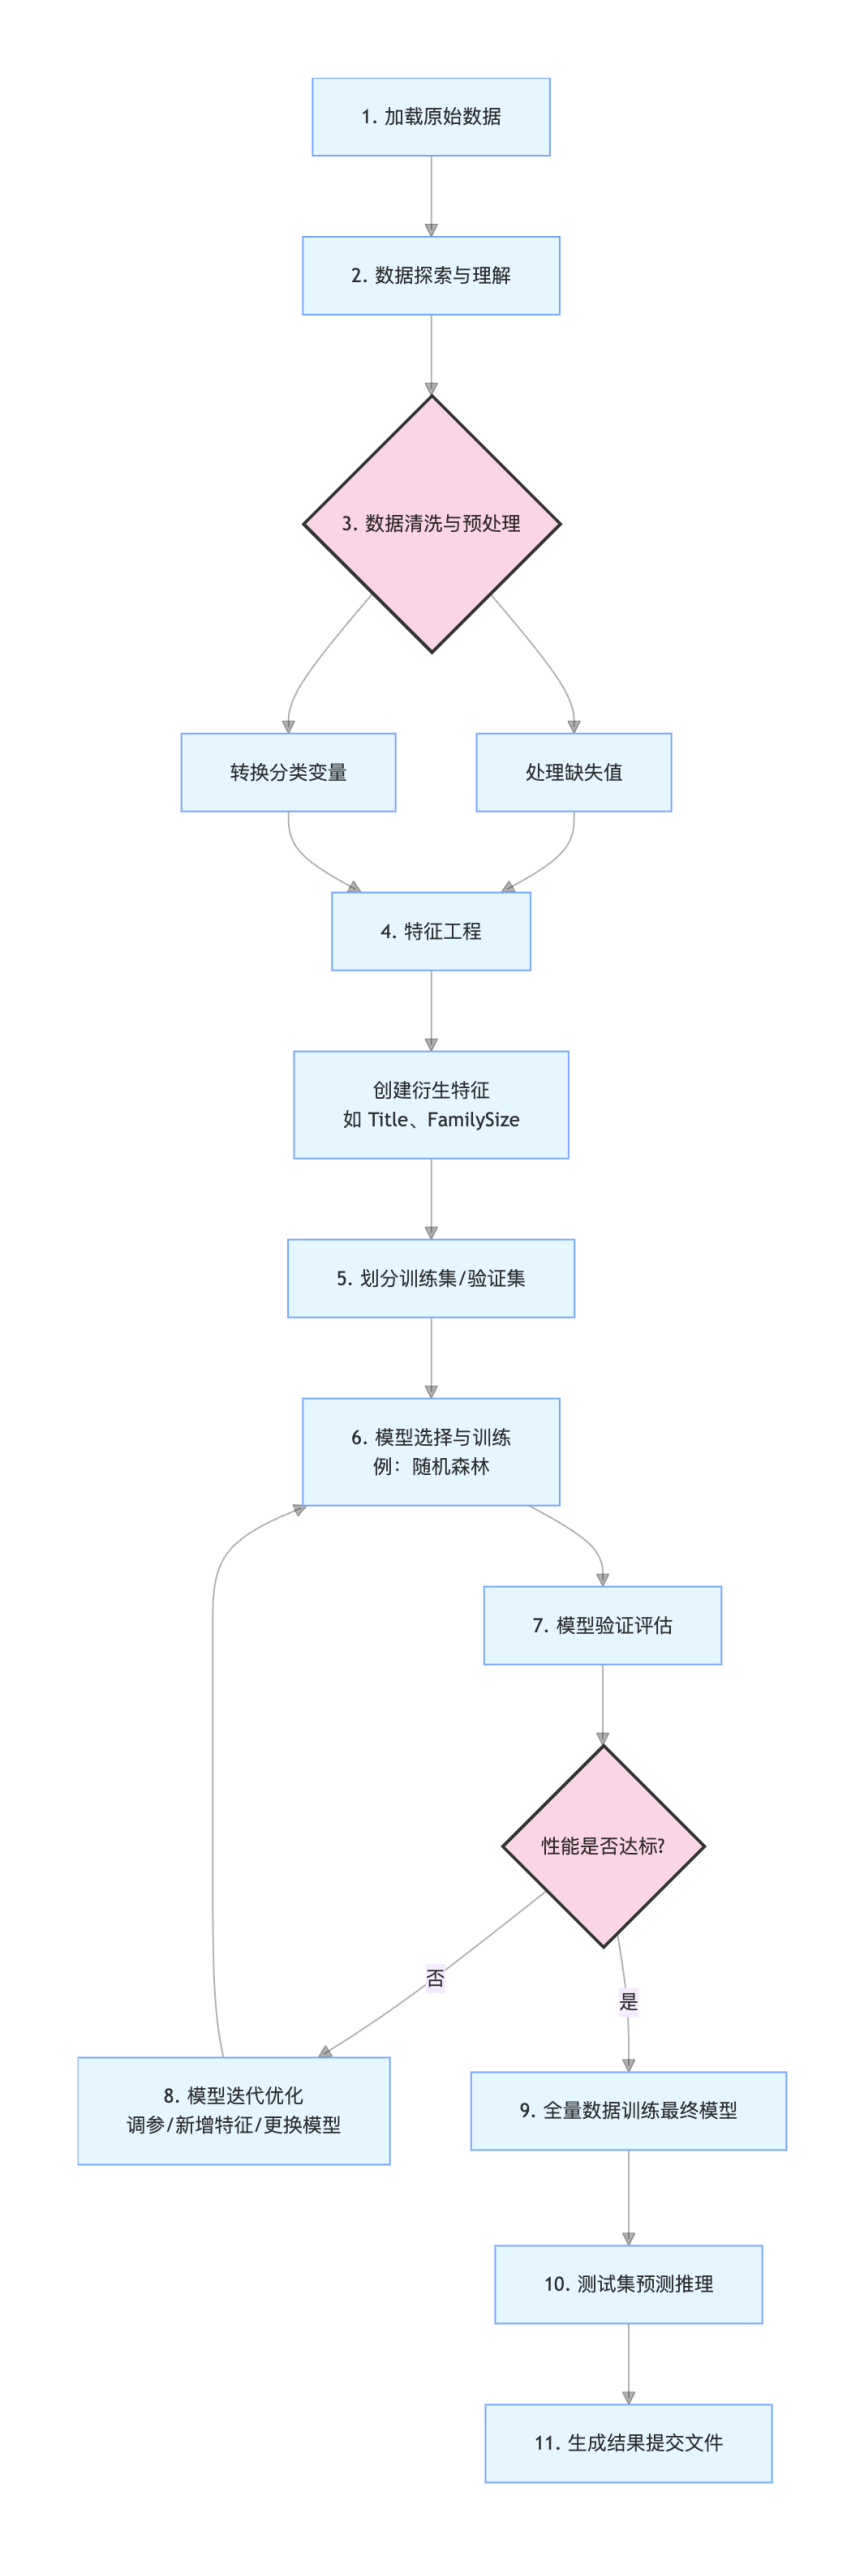
Благодаря этому практическому проекту вы не только научилисьpandasвыполнять обработку данных,sklearnтехникам построения моделей, но, что важнее, вы освоилистандартный подход к решению задачи машинного обучения.。
Этот рабочий процесс — от понимания данных до развёртывания модели — составляет ядро подавляющего большинства проектов в области науки о данных.
Другие расширения