Prédiction de survie sur le Titanic
Si vous commencez tout juste à apprendre l'apprentissage automatique, vous pourriez avoir l'impression que ces algorithmes complexes et ces formules mathématiques sont très éloignés du monde réel. Mais aujourd'hui, à travers un cas classique — la prédiction de survie du Titanic — nous allons découvrir de première main le déroulement complet d'un projet d'apprentissage automatique.
Le jeu de données Titanic est l'un des projets d'introduction les plus célèbres en apprentissage automatique. Il est basé sur des informations réelles concernant les passagers lors du naufrage du Titanic en 1912. Notre objectif est :Construire un modèle pour prédire s'ils ont survécu au désastre, à partir de l'âge, du sexe, de la classe de billet et d'autres informations sur les passagers.。
Ce projet est classique parce qu'il couvre parfaitement les étapes clés d'un projet d'apprentissage automatique :
- Compréhension et exploration des données
- Nettoyage et prétraitement des données
- Ingénierie des fonctionnalités
- Sélection et entraînement du modèle
- Évaluation et optimisation du modèle
Grâce à ce cas pratique, vous ne vous contenterez plus de lire la théorie, mais comprendrez vraiment comment appliquer l'apprentissage automatique pour résoudre des problèmes du monde réel.
Étape 1 : Comprendre nos données
Avant d'écrire du code, nous devons d'abord comprendre les données à notre disposition. Le jeu de données Titanic contient généralement les champs (caractéristiques) suivants :
| Nom du champ | Description | Type de données | Remarques |
|---|---|---|---|
PassengerId |
ID du passager | Integer | Identifiant unique, peu utile pour la prédiction |
Survived |
Survived | Entier (0/1) | Variable cible, 0=décédé, 1=survécu |
Pclass |
Classe du billet (Pclass) | Entier (1,2,3) | 1=première classe, 2=deuxième classe, 3=troisième classe |
Name |
Nom du passager | String | Contient des titres (par ex., Mr., Miss.), peut permettre d'extraire de nouvelles variables |
Sex |
Sexe | String | maleoufemale |
Age |
Âge | Float | Comporte des valeurs manquantes |
SibSp |
Nombre de frères et sœurs/conjoints à bord | Integer | |
Parch |
Nombre de parents/enfants à bord | Integer | |
Ticket |
Numéro de billet | String | Structure complexe, peut contenir des informations limitées |
Fare |
Tarif | Float | |
Cabin |
Cabin | String | De nombreuses valeurs manquantes, mais la première lettre peut représenter la zone de la cabine |
Embarked |
Embarked (port d'embarquement) | String | C=Cherbourg, Q=Queenstown, S=Southampton |
Point clé: D'après les connaissances historiques, nous savons que le principe « les femmes et les enfants d'abord » a été suivi, et que les passagers de première classe avaient un accès prioritaire aux canots de sauvetage. Par conséquent, nous nous attendons à ce queSex, Age, Pclassde telles caractéristiques aient un impact significatif sur les résultats de prédiction.
Étape 2 : Nettoyage et prétraitement des données
Les données brutes ne sont presque jamais parfaites.
Le nettoyage des données, c'est comme préparer des ingrédients de haute qualité pour le modèle ; cette étape est cruciale.
Enregistrez les données suivantes dans le fichier train.csv :
PassengerId,Survived,Pclass,Name,Sex,Age,SibSp,Parch,Ticket,Fare,Cabin,Embarked
1,0,3,"Braund, Mr. Owen Harris",male,22,1,0,A/5 21171,7.25,,S
2,1,1,"Cumings, Mrs. John Bradley",female,38,1,0,PC 17599,71.2833,C85,C
3,1,3,"Heikkinen, Miss. Laina",female,26,0,0,STON/O2. 3101282,7.925,,S
4,1,1,"Futrelle, Mrs. Jacques Heath",female,35,1,0,113803,53.1,C123,S
5,0,3,"Allen, Mr. William Henry",male,35,0,0,373450,8.05,,S
6,0,3,"Moran, Mr. James",male,,0,0,330877,8.4583,,Q
7,0,1,"McCarthy, Mr. Timothy J",male,54,0,0,17463,51.8625,E46,S
8,0,3,"Palsson, Master. Gosta Leonard",male,2,3,1,349909,21.075,,S
9,1,3,"Johnson, Mrs. Oscar W",female,27,0,2,347742,11.1333,,S
10,1,2,"Nasser, Mrs. Nicholas",female,14,1,0,237736,30.0708,,C
Enregistrez les données suivantes dans le fichier test.csv :
PassengerId,Pclass,Name,Sex,Age,SibSp,Parch,Ticket,Fare,Cabin,Embarked
11,3,"Kelly, Mr. James",male,34.5,0,0,330911,7.8292,,Q
12,3,"Wilkes, Mrs. James",female,47,1,0,363272,7,,S
13,2,"Myles, Mr. Thomas Francis",male,62,0,0,240276,9.6875,,Q
14,3,"Dwyer, Miss. Ellen",female,18,0,0,330959,7.75,,Q
15,1,"Jones, Mr. Charles",male,,1,0,PC 17603,82.1708,B28,C
Nous utiliserons Pythonpandasetnumpybibliothèque pour accomplir cette tâche.
Exemple
import pandas as pd
import numpy as np
# Charger les données
train_data = pd.read_csv('train.csv') # Ensemble d'entraînement, contient la variable cible Survived
test_data = pd.read_csv('test.csv') # Ensemble de test, ne contient pas Survived, utilisé pour l'évaluation finale
# 1. Aperçu initial des données
print("Dimensions de l'ensemble d'entraînement : ", train_data.shape)
print(train_data.info()) # Vérifier les types de données et les valeurs manquantes
print(train_data.head()) # Afficher les premières lignes des données
Sortie :
训练集形状: (10, 12)
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 10 entries, 0 to 9
Data columns (total 12 columns):
 #   Column       Non-Null Count  Dtype
---  ------       --------------  -----
 0   PassengerId  10 non-null     int64
 1   Survived     10 non-null     int64
 2   Pclass       10 non-null     int64
 3   Name         10 non-null     object
 4   Sex          10 non-null     object
 5   Age          9 non-null      float64
 6   SibSp        10 non-null     int64
 7   Parch        10 non-null     int64
 8   Ticket       10 non-null     object
 9   Fare         10 non-null     float64
 10  Cabin        3 non-null      object
 11  Embarked     10 non-null     object
dtypes: float64(2), int64(5), object(5)
memory usage: 1.1+ KB
None
   PassengerId  Survived  Pclass                          Name     Sex  ...  Parch            Ticket     Fare Cabin  Embarked
0            1         0       3       Braund, Mr. Owen Harris    male  ...      0         A/5 21171   7.2500   NaN         S
1            2         1       1    Cumings, Mrs. John Bradley  female  ...      0          PC 17599  71.2833   C85         C
2            3         1       3        Heikkinen, Miss. Laina  female  ...      0  STON/O2. 3101282   7.9250   NaN         S
3            4         1       1  Futrelle, Mrs. Jacques Heath  female  ...      0            113803  53.1000  C123         S
4            5         0       3      Allen, Mr. William Henry    male  ...      0            373450   8.0500   NaN         S

[5 rows x 12 columns]
Après avoir exécuté le code ci-dessus, vous pouvez constater deux problèmes principaux :Valeurs manquantesetDonnées non numériques。
Traitement des valeurs manquantes
Exemple
print(train_data.isnull().sum())
# Traiter Age : remplir avec la médiane
train_data['Age'] = train_data['Age'].fillna(train_data['Age'].median())
test_data['Age'] = test_data['Age'].fillna(test_data['Age'].median())
# Traiter Embarked : remplir avec le mode
most_common_port = train_data['Embarked'].mode()[0]
train_data['Embarked'] = train_data['Embarked'].fillna(most_common_port)
test_data['Embarked'] = test_data['Embarked'].fillna(most_common_port)
# Traiter Fare (prix du billet) : ensemble de test
test_data['Fare'] = test_data['Fare'].fillna(test_data['Fare'].median())
# Gérer Cabin : supprimer directement
train_data.drop(columns=['Cabin'], inplace=True)
test_data.drop(columns=['Cabin'], inplace=True)
Conversion des données non numériques
Les modèles d'apprentissage automatique ne peuvent généralement traiter que des valeurs numériques. Nous devons convertirSexetEmbarkedles colonnes de texte comme celle-ci en nombres.
Exemple
train_data['Sex'] = train_data['Sex'].map({'female': 0, 'male': 1})
test_data['Sex'] = test_data['Sex'].map({'female': 0, 'male': 1})
# Convertir la colonne Embarked en numérique (encodage one-hot)
# Comme les ports n'ont pas d'ordre, un simple mappage avec 0,1,2 ne convient pas
train_data = pd.get_dummies(train_data, columns=['Embarked'])
test_data = pd.get_dummies(test_data, columns=['Embarked'])
Étape 3 : Ingénierie des caractéristiques
L'ingénierie des caractéristiques est la "magie" de l'apprentissage automatique ; elle aide le modèle à mieux apprendre en créant ou en transformant des caractéristiques. NousNameextraire les "titres" de la colonne est un exemple classique.
Exemple
# Les titres reflètent souvent l'âge, le statut social et le sexe, et peuvent affecter la priorité de sauvetage
train_data['Title'] = train_data['Name'].str.extract(' ([A-Za-z]+)\.', expand=False)
test_data['Title'] = test_data['Name'].str.extract(' ([A-Za-z]+)\.', expand=False)
# Afficher les titres disponibles
print(pd.crosstab(train_data['Title'], train_data['Sex']))
# Regrouper les titres peu courants dans 'Rare'
title_mapping = {
'Mr': 'Mr', 'Miss': 'Miss', 'Mrs': 'Mrs',
'Master': 'Master', 'Dr': 'Rare', 'Rev': 'Rare',
'Col': 'Rare', 'Major': 'Rare', 'Mlle': 'Miss',
'Countess': 'Rare', 'Ms': 'Miss', 'Lady': 'Rare',
'Jonkheer': 'Rare', 'Don': 'Rare', 'Dona': 'Rare',
'Mme': 'Mrs', 'Capt': 'Rare', 'Sir': 'Rare'
}
train_data['Title'] = train_data['Title'].map(title_mapping)
test_data['Title'] = test_data['Title'].map(title_mapping)
# Encoder en one-hot la colonne Title traitée également
train_data = pd.get_dummies(train_data, columns=['Title'])
test_data = pd.get_dummies(test_data, columns=['Title'])
# Créer une nouvelle caractéristique : taille de la famille
train_data['FamilySize'] = train_data['SibSp'] + train_data['Parch'] + 1
test_data['FamilySize'] = test_data['SibSp'] + test_data['Parch'] + 1
# Créer une nouvelle caractéristique : est seul
train_data['IsAlone'] = (train_data['FamilySize'] == 1).astype(int)
test_data['IsAlone'] = (test_data['FamilySize'] == 1).astype(int)
# Supprimer les colonnes d'origine qui ne sont plus nécessaires
columns_to_drop = ['PassengerId', 'Name', 'Ticket', 'SibSp', 'Parch']
train_data.drop(columns_to_drop, axis=1, inplace=True)
test_passenger_ids = test_data['PassengerId'] # Enregistrer les identifiants de l'ensemble de test pour la soumission ultérieure
test_data.drop(columns_to_drop, axis=1, inplace=True)
print("Noms des colonnes de l'ensemble d'entraînement après l'ingénierie des caractéristiques : ", train_data.columns.tolist())
Étape 4 : Sélection et entraînement du modèle
Nous avons maintenant des données numériques propres et informatives. Ensuite, nous les divisons encaractéristiques (X)etvariable cible (y), puis sélectionnons un modèle à entraîner.
Nous allons commencer par un modèlede forêt aléatoiresimple et efficace.
Exemple
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score
# Préparer les données
# X est la matrice de caractéristiques, y est le vecteur cible que nous voulons prédire
X = train_data.drop('Survived', axis=1)
y = train_data['Survived']
# Pour évaluer la performance du modèle pendant l'entraînement, nous divisons les données en ensembles d'entraînement et de validation
# test_size=0.2 signifie que 20% des données sont utilisées pour la validation, 80% pour l'entraînement
# random_state est une graine aléatoire pour garantir des résultats de division cohérents à chaque fois
X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.2, random_state=42)
# Initialiser le classificateur Random Forest
# n_estimators: nombre d'arbres dans la forêt
# max_depth: profondeur maximale des arbres, contrôle la complexité du modèle, évite le surapprentissage
# random_state: garantit des résultats reproductibles
model = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# Entraîner le modèle (laisser le modèle apprendre les motifs à partir des données)
model.fit(X_train, y_train)
# Faire des prédictions sur l'ensemble de validation
y_pred = model.predict(X_val)
# Évaluer la précision du modèle
accuracy = accuracy_score(y_val, y_pred)
print(f"La précision du modèle sur l'ensemble de validation est : {accuracy:.4f} (soit {accuracy*100:.2f}%)")
Étape 5 : Évaluation du modèle, optimisation et soumission
Évaluation et optimisation
Le résultat d'une seule exécution d'entraînement peut ne pas être optimal. Nous pouvons l'améliorer des manières suivantes :
- Ajuster les paramètres du modèle: par exemple, essayez différents
n_estimatorsoumax_depth。 - Essayez d'autres modèles: tels que la régression logistique, les machines à vecteurs de support, les arbres de boosting de gradient, etc.
- Ingénierie de fonctionnalités supplémentaire: par exemple, pour
AgeouFareeffectuer le binning.
Exemple
for depth in [3, 5, 10, None]: # None signifie aucune limite de profondeur
model_temp = RandomForestClassifier(n_estimators=100, max_depth=depth, random_state=42)
model_temp.fit(X_train, y_train)
y_pred_temp = model_temp.predict(X_val)
acc = accuracy_score(y_val, y_pred_temp)
print(f"Lorsque max_depth={depth}, précision sur l'ensemble de validation : {acc:.4f}")
Analyse de l'importance des caractéristiques
Random Forest peut nous indiquer quelles caractéristiques contribuent le plus aux prédictions.
Exemple
feature_importances = pd.DataFrame({
'feature': X_train.columns,
'importance': model.feature_importances_
}).sort_values('importance', ascending=False)
print("Classement de l'importance des caractéristiques :")
print(feature_importances)
Vous pouvez trouverSex, Fare(liéPclass), Age, Titleest la caractéristique la plus importante, ce qui correspond à notre intuition historique.
Génération des prédictions finales sur l'ensemble de test
Une fois que nous sommes satisfaits des performances du modèle, nous réentraînons sur l'ensemble complet des données d'entraînement et effectuons des prédictions sur l'ensemble de test réel.
Exemple
final_model = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
final_model.fit(X, y) # Cette fois, utiliser toutes les données d'entraînement X, y
# Assurez-vous que les colonnes de caractéristiques de l'ensemble de test sont exactement les mêmes que celles de l'ensemble d'entraînement (ordre et nombre de colonnes)
# pd.get_dummies peut conduire à un nombre différent de colonnes dans les ensembles d'entraînement et de test (si une catégorie n'apparaît que d'un seul côté)
# Ici, nous devons aligner les colonnes. Une méthode simple consiste à fusionner puis à scinder, mais une approche plus robuste consiste à garantir la cohérence de l'encodage.
# Par souci de simplicité, supposons que les colonnes de l'ensemble de test traité sont alignées.
final_predictions = final_model.predict(test_data)
# Créer le fichier de soumission
submission = pd.DataFrame({
'PassengerId': test_passenger_ids,
'Survived': final_predictions
})
submission.to_csv('my_titanic_submission.csv', index=False)
print(Les résultats de prédiction ont été enregistrés dans 'my_titanic_submission.csv'. Vous pouvez les soumettre à la plateforme Kaggle pour consulter le classement !)
Résumé et organigramme du projet
Nous avons terminé un pipeline complet d'apprentissage automatique. Passons en revue l'ensemble du processus à l'aide d'un diagramme de flux :
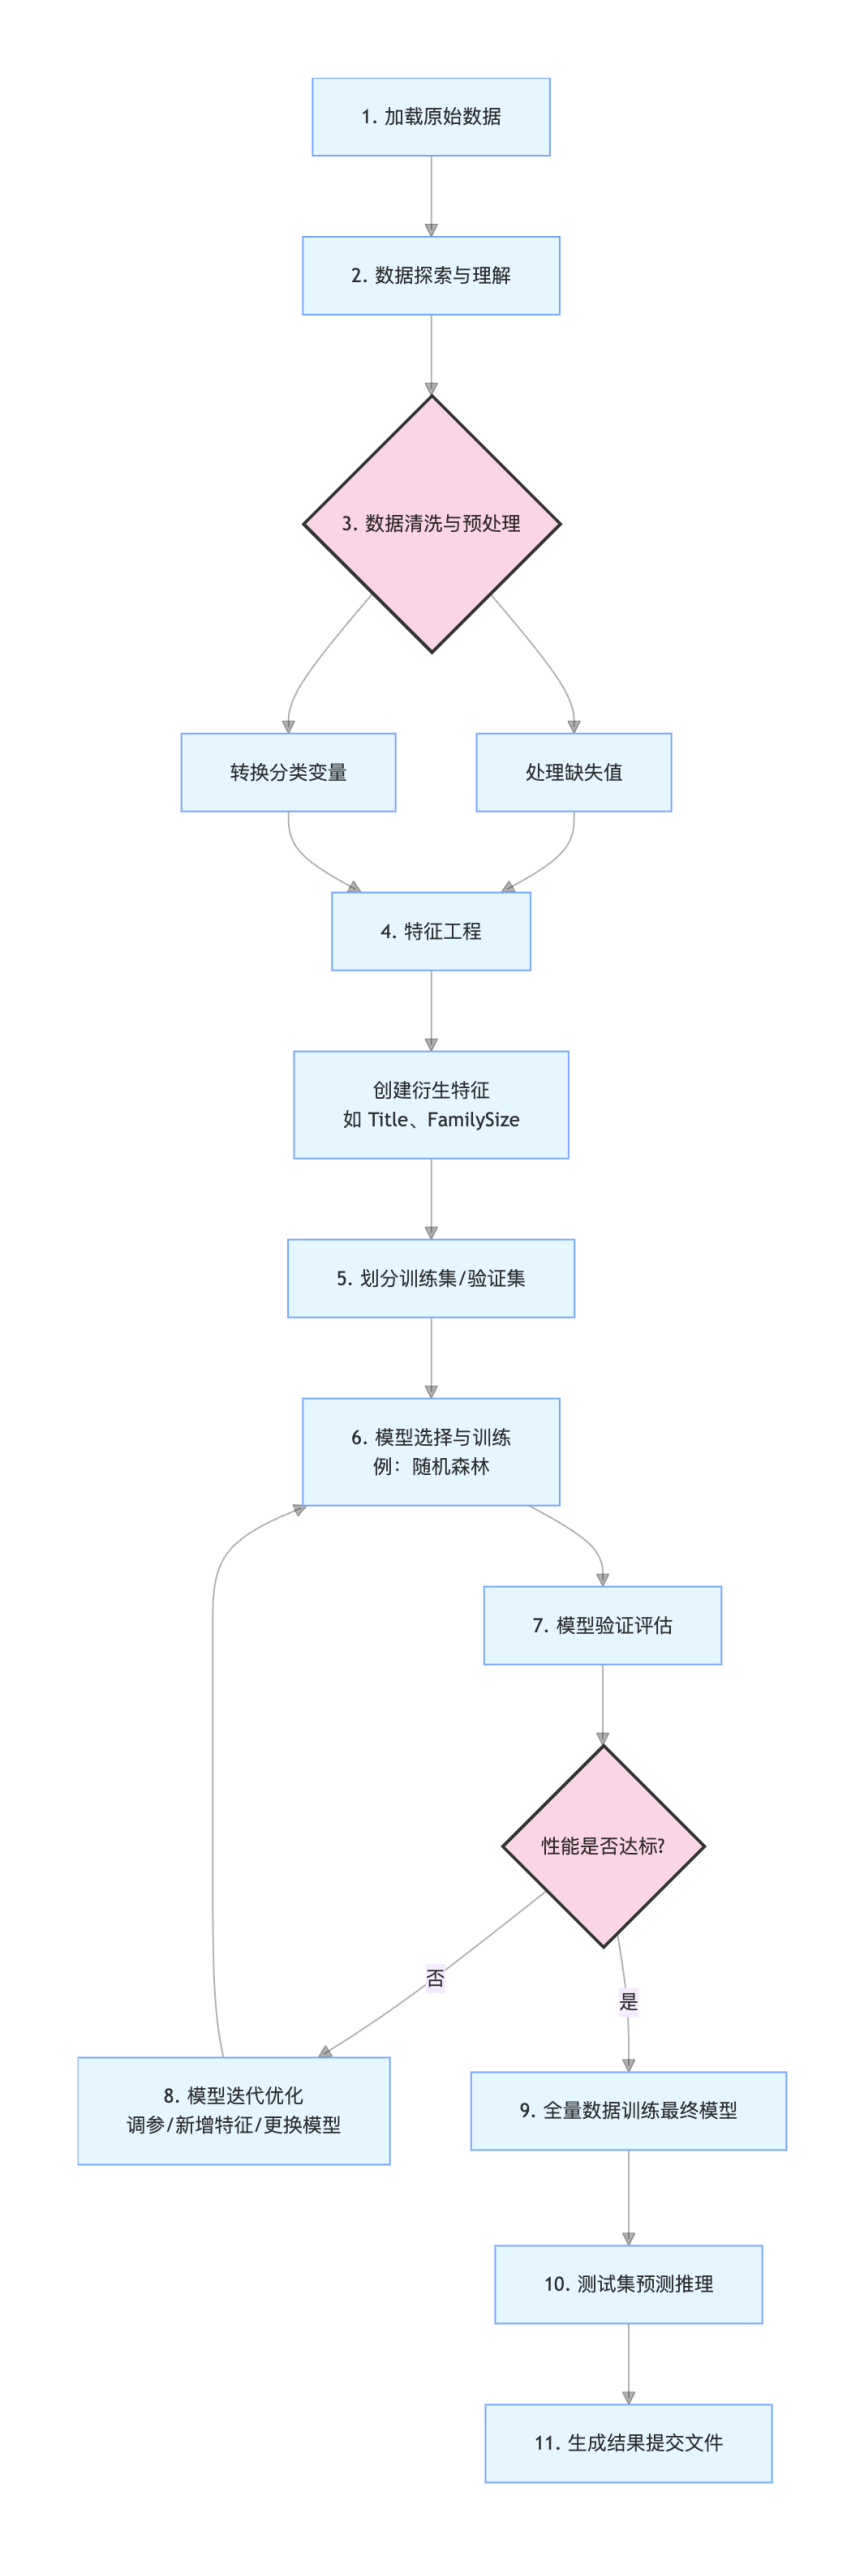
Grâce à ce projet pratique, vous avez non seulement apprispandasà effectuer le traitement des données,sklearnles techniques de construction de modèles, mais plus important encore, vous avez maîtrisél'approche standard pour résoudre un problème d'apprentissage automatique.。
Ce flux de travail — de la compréhension des données au déploiement du modèle — est au cœur de la grande majorité des projets de science des données.
autres extensions