タイタニック号生存予測
機械学習を学び始めたばかりの皆さんは、複雑なアルゴリズムや数式が現実世界とはかけ離れていると感じるかもしれません。しかし今日は、タイタニック号生存予測という古典的なケースを通して、機械学習プロジェクトの一連の流れを実際に体験してみましょう。
タイタニック号データセットは、機械学習分野で最も有名な入門プロジェクトの1つです。1912年のタイタニック号沈没事故における乗客の実際の情報に基づいています。私たちの目標は次のとおりです。乗客の年齢、性別、客室等級などの情報に基づき、災難を生き延びられるかどうかを予測するモデルを構築すること。。
このプロジェクトが古典的とされるのは、機械学習プロジェクトの主要なステップを完璧に網羅しているからです。
- データの理解と探索
- データクリーニングと前処理
- 特徴量エンジニアリング
- モデルの選択とトレーニング
- モデルの評価と最適化
この実践的なケースを通して、理論を読むだけでなく、機械学習を実際の問題解決にどのように応用するのかを真に理解できるようになります。
ステップ1:データを理解する
コードを書き始める前に、まず手元のデータを把握する必要があります。タイタニック号データセットには通常、以下のフィールド(特徴量)が含まれています。
| フィールド名 | 説明 | データ型 | 備考 |
|---|---|---|---|
PassengerId |
乗客ID | 整数 | 一意の識別子であり、予測には役立たない |
Survived |
生存の有無 | 整数 (0/1) | 目的変数、0=死亡、1=生存 |
Pclass |
客室等級 | 整数 (1,2,3) | 1=一等客室、2=二等客室、3=三等客室 |
Name |
乗客氏名 | 文字列 | 敬称(Mr.、Miss.など)を含み、新しい特徴量を抽出可能 |
Sex |
性別 | 文字列 | male 或 female |
Age |
年齢 | 浮動小数点数 | 一部に欠損値あり |
SibSp |
同乗している兄弟姉妹/配偶者の数 | 整数 | |
Parch |
同乗している両親/子供の数 | 整数 | |
Ticket |
チケット番号 | 文字列 | 構造が複雑で、情報量が限られている可能性があります |
Fare |
運賃 | 浮動小数点数 | |
Cabin |
客室番号 | 文字列 | 欠損値が多いが、最初の文字が客室の区域を表す可能性があります |
Embarked |
乗船港 | 文字列 | C=Cherbourg, Q=Queenstown, S=Southampton |
核となる洞察:歴史的な知識から、当時は「女性と子ども優先」の原則が採られており、一等客室の乗客には救命ボートを優先的に使用する権利があったことがわかっています。したがって、私たちはSex, Age, Pclassなどの特徴量が予測結果に大きな影響を与えると予想されます。
ステップ2:データクリーニングと前処理
生データはほぼ常に不完全です。
データクリーニングは、モデルに高品質な食材を準備するようなものです。このステップは非常に重要です。
以下のデータを train.csv ファイルに保存します。
PassengerId,Survived,Pclass,Name,Sex,Age,SibSp,Parch,Ticket,Fare,Cabin,Embarked
1,0,3,"Braund, Mr. Owen Harris",male,22,1,0,A/5 21171,7.25,,S
2,1,1,"Cumings, Mrs. John Bradley",female,38,1,0,PC 17599,71.2833,C85,C
3,1,3,"Heikkinen, Miss. Laina",female,26,0,0,STON/O2. 3101282,7.925,,S
4,1,1,"Futrelle, Mrs. Jacques Heath",female,35,1,0,113803,53.1,C123,S
5,0,3,"Allen, Mr. William Henry",male,35,0,0,373450,8.05,,S
6,0,3,"Moran, Mr. James",male,,0,0,330877,8.4583,,Q
7,0,1,"McCarthy, Mr. Timothy J",male,54,0,0,17463,51.8625,E46,S
8,0,3,"Palsson, Master. Gosta Leonard",male,2,3,1,349909,21.075,,S
9,1,3,"Johnson, Mrs. Oscar W",female,27,0,2,347742,11.1333,,S
10,1,2,"Nasser, Mrs. Nicholas",female,14,1,0,237736,30.0708,,C
以下のデータを test.csv ファイルに保存します。
PassengerId,Pclass,Name,Sex,Age,SibSp,Parch,Ticket,Fare,Cabin,Embarked
11,3,"Kelly, Mr. James",male,34.5,0,0,330911,7.8292,,Q
12,3,"Wilkes, Mrs. James",female,47,1,0,363272,7,,S
13,2,"Myles, Mr. Thomas Francis",male,62,0,0,240276,9.6875,,Q
14,3,"Dwyer, Miss. Ellen",female,18,0,0,330959,7.75,,Q
15,1,"Jones, Mr. Charles",male,,1,0,PC 17603,82.1708,B28,C
私たちは Python のpandasとnumpyライブラリを使用してこの作業を行います。
実例
import pandas as pd
import numpy as np
# データを読み込む
train_data = pd.read_csv('train.csv') # トレーニングセット、目的変数 Survived を含む
test_data = pd.read_csv('test.csv') # テストセット、Survived を含まない、最終評価用
# 1. データの概要を確認
print("トレーニングセットの形状:", train_data.shape)
print(train_data.info()) # データ型と欠損状況を確認
print(train_data.head()) # 先頭の数行を表示
出力:
训练集形状: (10, 12)
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 10 entries, 0 to 9
Data columns (total 12 columns):
 #   Column       Non-Null Count  Dtype
---  ------       --------------  -----
 0   PassengerId  10 non-null     int64
 1   Survived     10 non-null     int64
 2   Pclass       10 non-null     int64
 3   Name         10 non-null     object
 4   Sex          10 non-null     object
 5   Age          9 non-null      float64
 6   SibSp        10 non-null     int64
 7   Parch        10 non-null     int64
 8   Ticket       10 non-null     object
 9   Fare         10 non-null     float64
 10  Cabin        3 non-null      object
 11  Embarked     10 non-null     object
dtypes: float64(2), int64(5), object(5)
memory usage: 1.1+ KB
None
   PassengerId  Survived  Pclass                          Name     Sex  ...  Parch            Ticket     Fare Cabin  Embarked
0            1         0       3       Braund, Mr. Owen Harris    male  ...      0         A/5 21171   7.2500   NaN         S
1            2         1       1    Cumings, Mrs. John Bradley  female  ...      0          PC 17599  71.2833   C85         C
2            3         1       3        Heikkinen, Miss. Laina  female  ...      0  STON/O2. 3101282   7.9250   NaN         S
3            4         1       1  Futrelle, Mrs. Jacques Heath  female  ...      0            113803  53.1000  C123         S
4            5         0       3      Allen, Mr. William Henry    male  ...      0            373450   8.0500   NaN         S

[5 rows x 12 columns]
上記のコードを実行すると、主に2つの問題に気づくかもしれません。欠損値と非数値データ。
欠損値の処理
実例
print(train_data.isnull().sum())
# Age(年齢)の処理:中央値で補完
train_data['Age'] = train_data['Age'].fillna(train_data['Age'].median())
test_data['Age'] = test_data['Age'].fillna(test_data['Age'].median())
# Embarked(乗船港)の処理:最頻値で補完
most_common_port = train_data['Embarked'].mode()[0]
train_data['Embarked'] = train_data['Embarked'].fillna(most_common_port)
test_data['Embarked'] = test_data['Embarked'].fillna(most_common_port)
# Fare(運賃)の処理:テストセット
test_data['Fare'] = test_data['Fare'].fillna(test_data['Fare'].median())
# Cabin(客室番号)の処理:削除
train_data.drop(columns=['Cabin'], inplace=True)
test_data.drop(columns=['Cabin'], inplace=True)
非数値データの変換
機械学習モデルは通常、数値のみを処理できます。私たちはSexとEmbarkedこのようなテキスト列を数値に変換する必要があります。
実例
train_data['Sex'] = train_data['Sex'].map({'female': 0, 'male': 1})
test_data['Sex'] = test_data['Sex'].map({'female': 0, 'male': 1})
# Embarked 列を数値に変換(ワンホットエンコーディング One-Hot Encoding)
# 港の間には大小の順序がないため、0,1,2 の単純なマッピングは適さない
train_data = pd.get_dummies(train_data, columns=['Embarked'])
test_data = pd.get_dummies(test_data, columns=['Embarked'])
ステップ3:特徴量エンジニアリング
特徴量エンジニアリングは機械学習における「魔法」です。特徴量を新しく作ったり変換したりすることで、モデルがより良く学習するのを助けます。私たちはName列から「敬称」を抽出するのが典型的な例です。
実例
# 敬称は年齢、社会的地位、性別を反映することが多く、救助の優先順位に影響する可能性がある
train_data['Title'] = train_data['Name'].str.extract(' ([A-Za-z]+)\.', expand=False)
test_data['Title'] = test_data['Name'].str.extract(' ([A-Za-z]+)\.', expand=False)
# どのような敬称があるかを確認
print(pd.crosstab(train_data['Title'], train_data['Sex']))
# 一般的でない敬称を'Rare'に分類
title_mapping = {
'Mr': 'Mr', 'Miss': 'Miss', 'Mrs': 'Mrs',
'Master': 'Master', 'Dr': 'Rare', 'Rev': 'Rare',
'Col': 'Rare', 'Major': 'Rare', 'Mlle': 'Miss',
'Countess': 'Rare', 'Ms': 'Miss', 'Lady': 'Rare',
'Jonkheer': 'Rare', 'Don': 'Rare', 'Dona': 'Rare',
'Mme': 'Mrs', 'Capt': 'Rare', 'Sir': 'Rare'
}
train_data['Title'] = train_data['Title'].map(title_mapping)
test_data['Title'] = test_data['Title'].map(title_mapping)
# 処理後の Title 列もワンホットエンコーディングする
train_data = pd.get_dummies(train_data, columns=['Title'])
test_data = pd.get_dummies(test_data, columns=['Title'])
# 新特徴量の作成:家族の人数
train_data['FamilySize'] = train_data['SibSp'] + train_data['Parch'] + 1
test_data['FamilySize'] = test_data['SibSp'] + test_data['Parch'] + 1
# 新特徴量の作成:一人かどうか
train_data['IsAlone'] = (train_data['FamilySize'] == 1).astype(int)
test_data['IsAlone'] = (test_data['FamilySize'] == 1).astype(int)
# 不要になった元の列を削除
columns_to_drop = ['PassengerId', 'Name', 'Ticket', 'SibSp', 'Parch']
train_data.drop(columns_to_drop, axis=1, inplace=True)
test_passenger_ids = test_data['PassengerId'] # 後で提出するためにテストセットのIDを保存
test_data.drop(columns_to_drop, axis=1, inplace=True)
print("特徴量エンジニアリング後のトレーニングセットの列名:", train_data.columns.tolist())
ステップ4:モデルの選択とトレーニング
これで、クリーンで情報量の多い数値データが揃いました。次に、これを分割します。特徴量 (X)と目的変数 (y)、そしてモデルを選択してトレーニングを行います。
私たちは、シンプルで効率的なランダムフォレスト (Random Forest)モデルから始めます。
実例
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import accuracy_score
# データを準備
# X は特徴量行列、y は予測したい目的変数ベクトル
X = train_data.drop('Survived', axis=1)
y = train_data['Survived']
# トレーニング中にモデルの性能を評価するため、データをトレーニングセットと検証セットに分割します
# test_size=0.2 はデータの20%を検証用、80%をトレーニング用に使用することを意味します
# random_state は乱数シードで、毎回の分割結果を同じにします
X_train, X_val, y_train, y_val = train_test_split(X, y, test_size=0.2, random_state=42)
# ランダムフォレスト分類器を初期化
# n_estimators: フォレスト内の木の数
# max_depth: 木の最大深さ。モデルの複雑さを制御し、過学習を防ぎます
# random_state: 結果を再現可能にする
model = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
# モデルをトレーニング(モデルにデータから規則を学習させる)
model.fit(X_train, y_train)
# 検証セットで予測を実行
y_pred = model.predict(X_val)
# モデルの正解率を評価
accuracy = accuracy_score(y_val, y_pred)
print(f"検証セットにおけるモデルの正解率:{accuracy:.4f}(すなわち {accuracy*100:.2f}%)")
ステップ5:モデルの評価、最適化と提出
評価と最適化
1回のトレーニング結果は最適とは限りません。以下の方法で改善できます。
- モデルのパラメータを調整:例えば、異なる
n_estimators或max_depth。 - 他のモデルを試す:例えば、ロジスティック回帰、サポートベクターマシン、勾配ブースティング木など。
- さらなる特徴量エンジニアリング:例えば、
Age或Fareビニング処理を実行します。
実例
for depth in [3, 5, 10, None]: # None は深さを制限しないことを意味します
model_temp = RandomForestClassifier(n_estimators=100, max_depth=depth, random_state=42)
model_temp.fit(X_train, y_train)
y_pred_temp = model_temp.predict(X_val)
acc = accuracy_score(y_val, y_pred_temp)
print(f"max_depth={depth} のとき、検証セットの正解率:{acc:.4f}")
特徴量の重要度分析
ランダムフォレストは、どの特徴量が予測に最も貢献しているかを教えてくれます。
実例
feature_importances = pd.DataFrame({
'feature': X_train.columns,
'importance': model.feature_importances_
}).sort_values('importance', ascending=False)
print("特徴重要度ランキング:")
print(feature_importances)
あなたは気づくかもしれませんSex, Fare(関連Pclass), Age, Titleが最も重要な特徴であり、これは私たちの歴史的直感と一致しています。
テストセットで最終予測を生成
モデルの性能に満足したら、全トレーニングデータで再トレーニングし、実際のテストセットに対して予測を行います。
実例
final_model = RandomForestClassifier(n_estimators=100, max_depth=5, random_state=42)
final_model.fit(X, y) # 今回は全トレーニングデータ X, y を使用
# テストセットの特徴列がトレーニングセットと完全に一致することを確認(順序と列数)
# pd.get_dummies は、トレーニングセットとテストセットで列数が異なる可能性があります(あるカテゴリが一方にしか出現しない場合)
# ここでは列を揃える必要があります。簡単な方法は、まず結合してから分割することですが、より堅牢な方法はエンコーディングの一貫性を確保することです。
# 簡略化のため、処理後のテストセットの列が揃っていると仮定します。
final_predictions = final_model.predict(test_data)
# 提出ファイルを作成
submission = pd.DataFrame({
'PassengerId': test_passenger_ids,
'Survived': final_predictions
})
submission.to_csv('my_titanic_submission.csv', index=False)
print("予測結果は 'my_titanic_submission.csv' に保存されました。Kaggleプラットフォームに提出してランキングを確認できます!")
まとめとプロジェクトフローチャート
私たちは完全な機械学習パイプラインを完成させました。フローチャートで全体のプロセスを振り返りましょう:
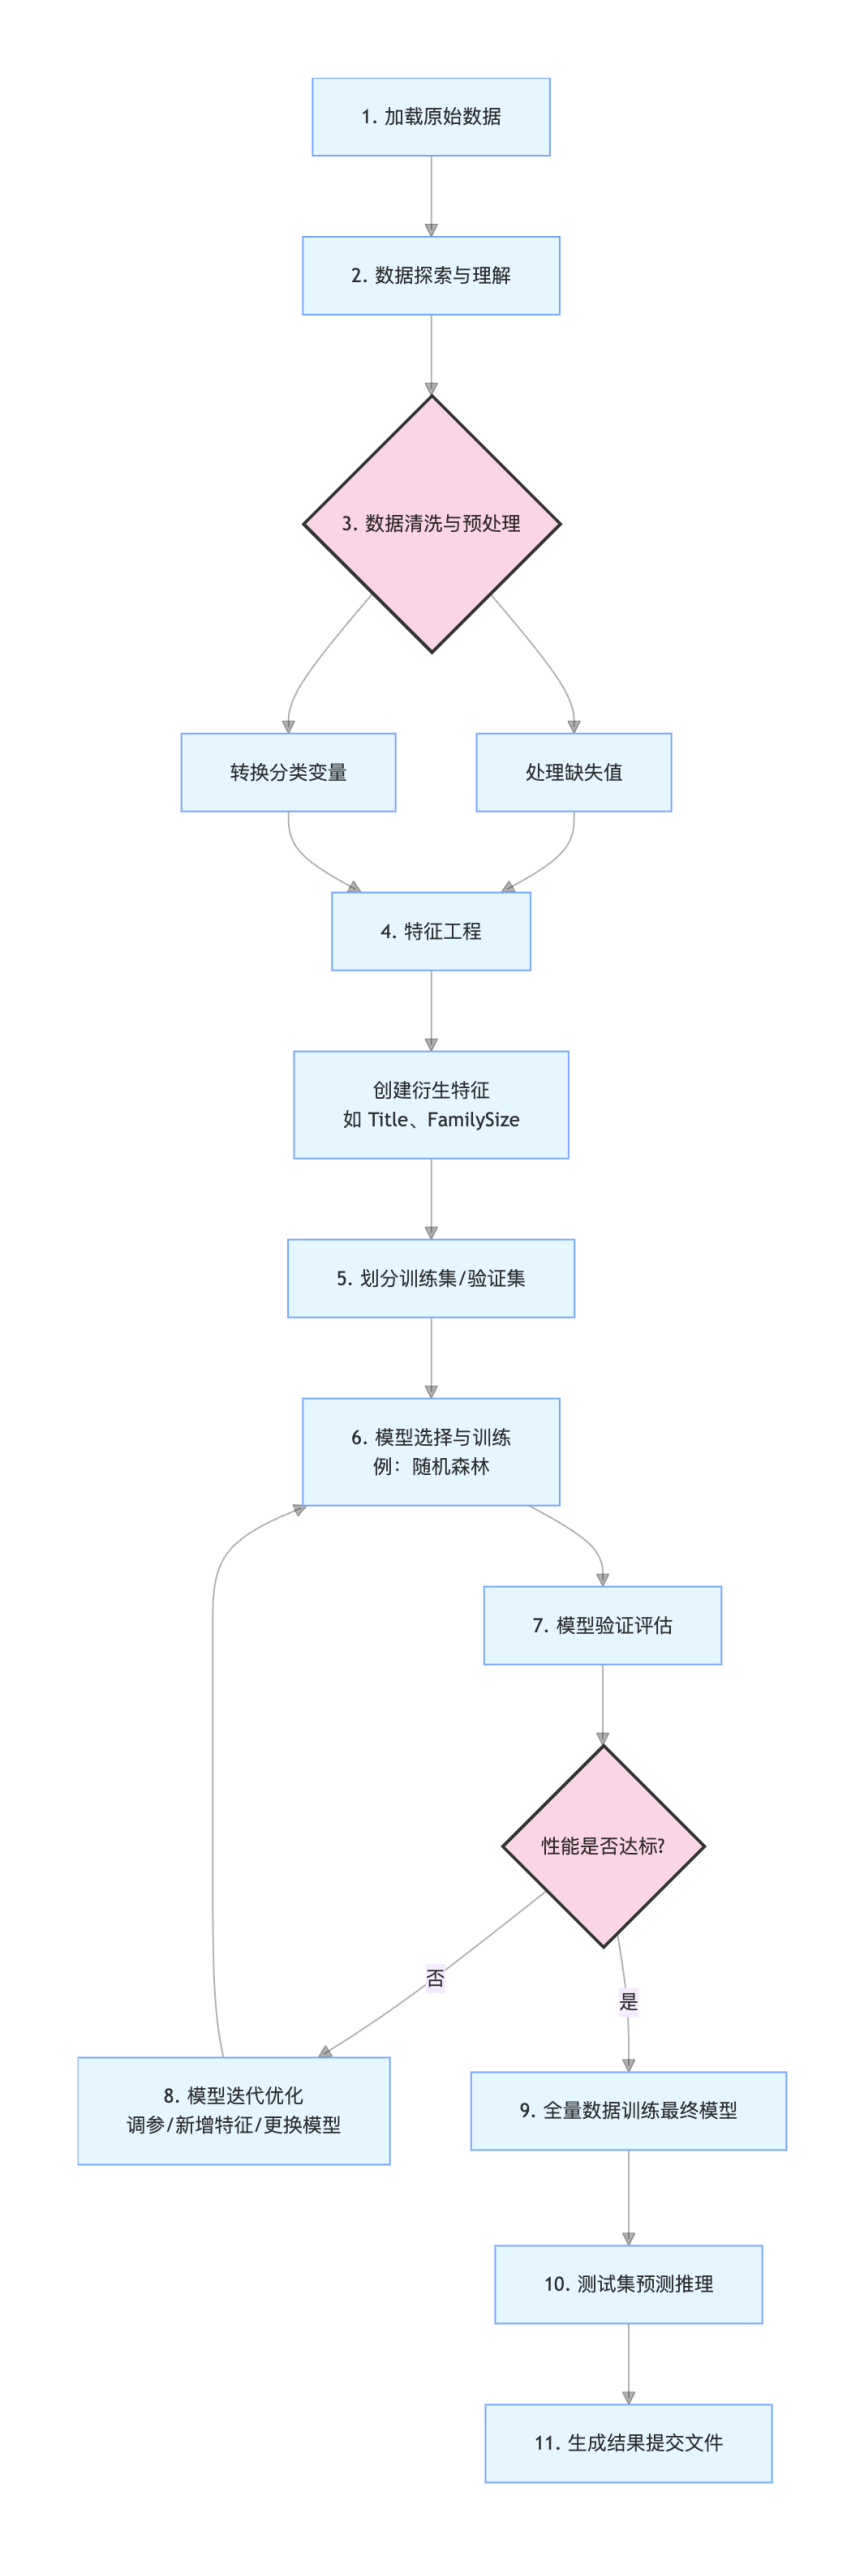
この実践プロジェクトを通じて、あなたは学んだだけでなくpandasデータ処理を行い、sklearnモデルを構築するテクニック、さらに重要なのは、あなたは習得しました機械学習の問題を解決するための標準的な考え方。
このプロセス——データの理解からモデルのデプロイまで——は、大多数のデータサイエンスプロジェクトの核心です。
その他の拡張