Estructura básica de las redes neuronales
En la ola de la inteligencia artificial, el aprendizaje profundo es sin duda la estrella más brillante, y lo que constituye el núcleo del aprendizaje profundo es precisamentela red neuronal. Esta imita el funcionamiento de las neuronas del cerebro humano y, a través de conexiones y cálculos capa por capa, otorga a las máquinas la capacidad de aprender y reconocer.
Para los principiantes, comprender la estructura básica de las redes neuronales es la primera llave para abrir la puerta del aprendizaje profundo.
Este artículo te llevará desde cero a desglosar paso a paso la composición de las redes neuronales y, con analogías vívidas y código claro, te permitirá dominar por completo su principio de funcionamiento.
¿Qué es una red neuronal? Una analogía vívida
Imagina que estás enseñando a un niño que nunca ha visto un gato ni un perro a distinguirlos. ¿Qué harías?
- Probablemente primero le mostrarías muchas imágenes de gatos y perros.
- Le señalarías las características: mira, las orejas de los gatos suelen ser puntiagudas y su cara es más redonda; las orejas de los perros pueden estar caídas y su cara es más alargada.
- El cerebro del niño (la red neuronal) recibe estas imágenes (datos de entrada) y tus instrucciones (etiquetas).
- Las neuronas de su cerebro comienzan a trabajar, intentando encontrar los patrones clave para distinguir gatos y perros (como la forma de las orejas o el contorno de la cara).
- Después de múltiples correcciones y aprendizaje, se forma un modelo de decisión en su cerebro. La próxima vez que vea una imagen de un animal nuevo, podrá decir con confianza si es un gato o un perro.
La red neuronal es un modelo matemático simplificado del cerebro de ese niño,es un sistema de red compuesto por una gran cantidad deneuronas artificialesinterconectadas, que puede aprender automáticamente características y patrones de los datos de entrada y utilizarlos para predicciones o decisiones.

Unidad básica de una red neuronal: la neurona
La neurona es la unidad de cálculo más básica de una red neuronal; simula el proceso de la neurona biológica derecibir señales - procesar señales - transmitir señales.
Flujo de trabajo de una neurona
Una neurona artificial típica hace principalmente tres cosas:
Ejemplo
def artificial_neuron(inputs, weights, bias):
"""
Simula el proceso de cálculo de una neurona artificial.
Parámetros:
inputs: lista de señales de entrada, por ejemplo [x1, x2, x3]
weights: lista de pesos correspondiente a cada entrada, por ejemplo [w1, w2, w3]
bias: término de sesgo, una constante
Devuelve:
output: salida de la neurona
"""
# 1. Suma ponderada: multiplica cada entrada por su peso correspondiente y luego suma el sesgo
weighted_sum = 0
for i in range(len(inputs)):
weighted_sum += inputs[i] * weights[i]
weighted_sum += bias
# 2. Procesamiento con función de activación: a través de una función no lineal, decide si se 'activa' y emite la señal
output = activation_function(weighted_sum)
return output
Usemos un diagrama y una tabla para entenderlo de forma más intuitiva:
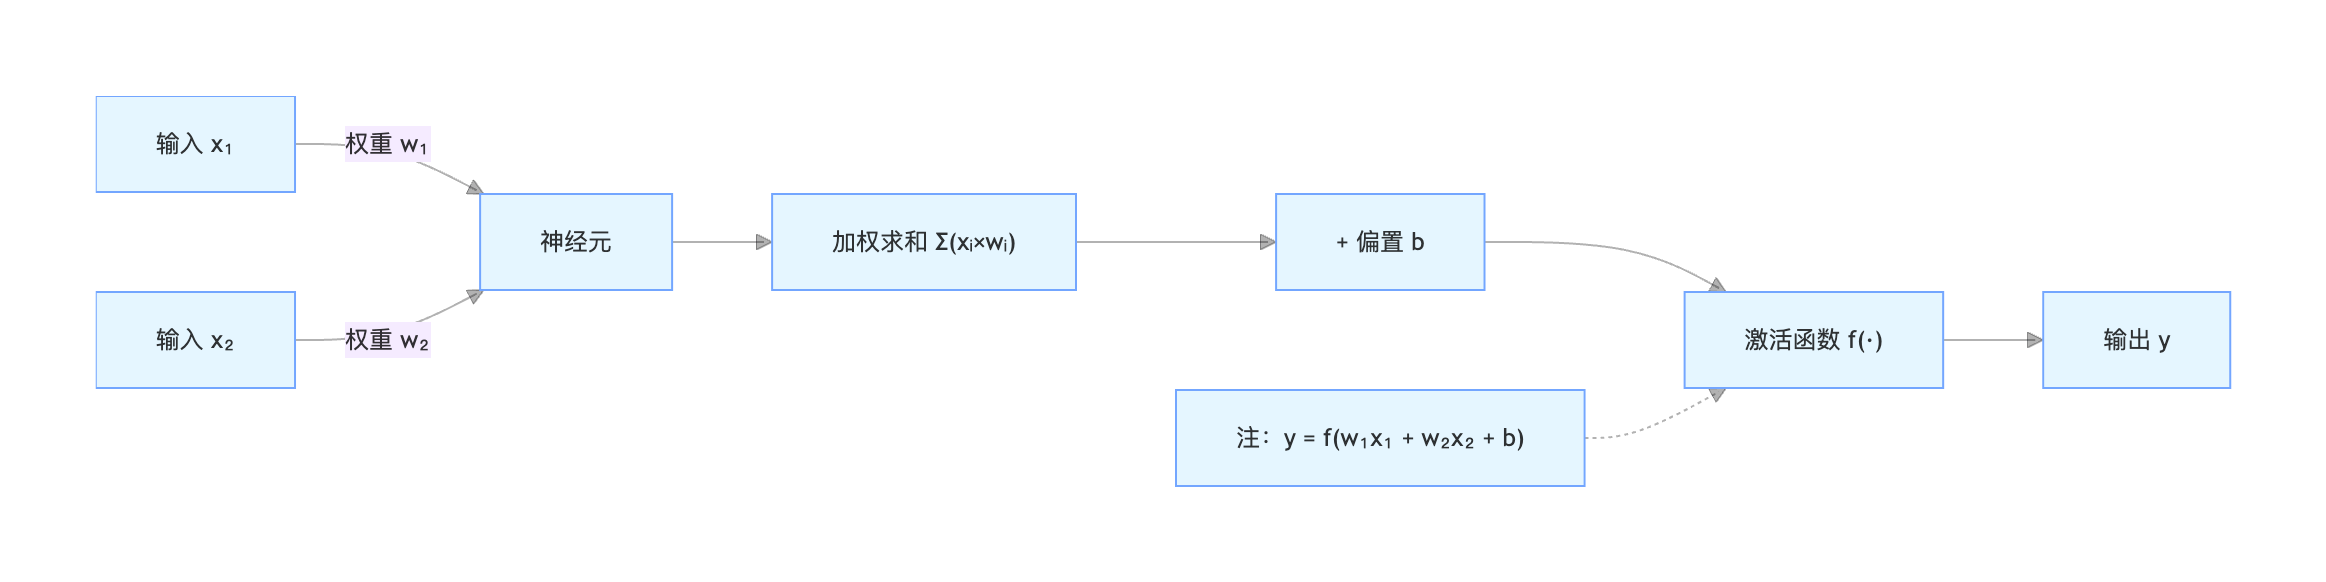
Explicación detallada de las funciones de cada componente de la neurona:
| Componente | Analogía | Expresión matemática | Función |
|---|---|---|---|
| Entrada \(x\) | Señal de otras neuronas | \( x_1, x_2, ..., x_n \) | Recibe información externa o la salida de las neuronas de la capa anterior. |
| Peso \(w\) | Importancia de la señal | \(w_1, w_2, ..., w_n\) | Determina el grado de influencia de cada entrada en la salida de la neurona.El proceso de aprendizaje consiste en ajustar continuamente estos pesos. |
| Sesgo \(b\) | Umbral de activación de la neurona | \(b\) | Una constante que ajusta la facilidad de activación de la neurona. Puede entenderse como un desplazamiento vertical del total de la suma ponderada. |
| Suma ponderada \(z\) | Intensidad total de la señal | \(z = (x_1w_1 + x_2w_2 + ... + x_nw_n) + b\) | Integra todas las señales de entrada. |
| Función de activación \(f\) | Interruptor y procesador | \(a = f(z)\) | Introduceno linealidad. Sin ella, una red multicapa degeneraría en una red de una sola capa y no podría aprender patrones complejos. |
Funciones de activación comunes
Las funciones de activación aportan la capacidad no lineal a las redes neuronales. Estas son las tres más utilizadas:
Sigmoid
- Fórmula:\(f(z) = \frac{1}{1 + e^{-z}}\)
- Características: Comprime la entrada al intervalo (0, 1). Se usa comúnmente en la capa de salida de problemas de clasificación binaria. Puede provocar fácilmente el problema del desvanecimiento del gradiente.
- Imagen: Una curva suave en forma de S.
ReLU (Unidad Lineal Rectificada)
- Fórmula:\(f(z) = max(0, z)\)
- Características: Cálculo simple, puede aliviar eficazmente el problema del desvanecimiento del gradiente y es actualmente la función de activación más utilizada en las capas ocultas.
- Imagen: Línea quebrada que gira en el origen; para valores negativos la salida es 0 y para valores positivos emite el valor original.
Softmax
- Fórmula:\(f(z_i) = \frac{e^{z_i}}{\sum_{j=1}^{K} e^{z_j}}\)
- Características: Convierte las salidas de varias neuronas en una distribución de probabilidad (la suma de todas las salidas es 1).Específica para la capa de salida de problemas de clasificación multiclase.。
Estructura de capas de una red neuronal
Una sola neurona tiene capacidad limitada, igual que una sola célula cerebral no puede pensar. Cuando organizamos una gran cantidad de neuronas en capas, formamos una potente red neuronal. Una red neuronal típica incluye las siguientes tres capas:
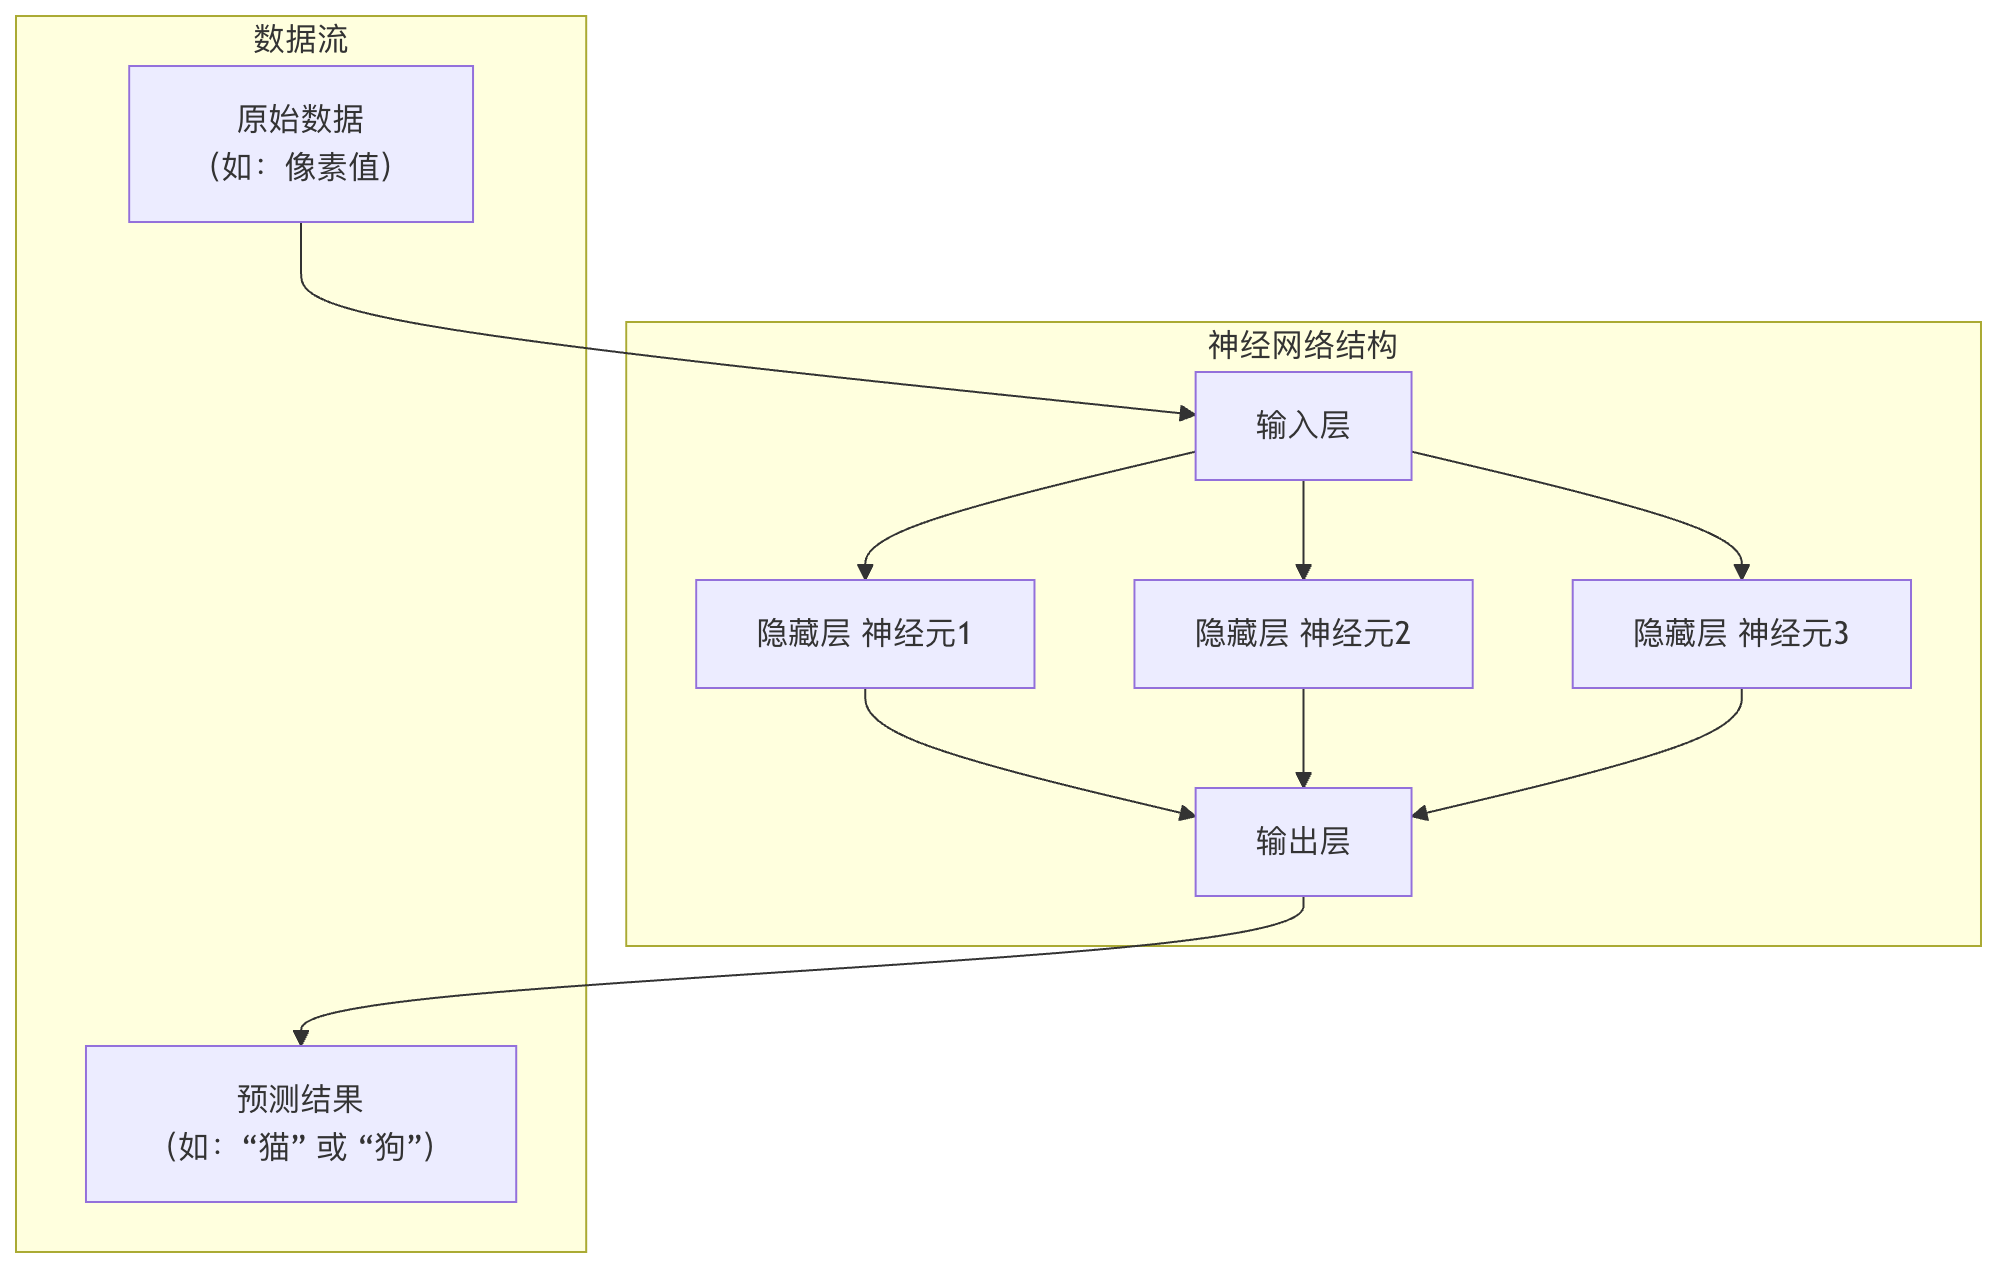
1. Capa de entrada
- Rol: Los sentidos de la red, encargados de recibir los datos brutos.
- Características: El número de neuronas en esta capa suele ser igual al número de características de los datos de entrada. Por ejemplo, una imagen en escala de grises de 28x28 píxeles, una vez aplanada, tiene 784 características, que corresponden a 784 neuronas de entrada.La capa de entrada no realiza ningún cálculo, solo transmite datos.
2. Capa oculta
Rol: El cerebro de la red, encargado de realizar la extracción y transformación de características complejas.
Características:
- : Se encuentra entre la capa de entrada y la capa de salida, y puede tener una o más capas (de ahí proviene el aprendizaje profundo).
- Las neuronas de cada capa reciben como entrada las salidas de todas las neuronas de la capa anterior y calculan su propia salida para transmitirla a la siguiente capa (esto se llama conexión completa).
- Las neuronas de las capas ocultas utilizan funciones de activación como ReLU para introducir no linealidad.
3. Capa de salida
Rol: El decisor de la red, que emite el resultado final de la predicción.
Características: El número de neuronas está determinado por la tarea.
- Clasificación binaria: 1 neurona (con Sigmoid) o 2 neuronas (con Softmax).
- Clasificación multiclase (K clases): K neuronas (con Softmax).
- Regresión(predicción de un valor continuo): 1 neurona (normalmente sin función de activación).
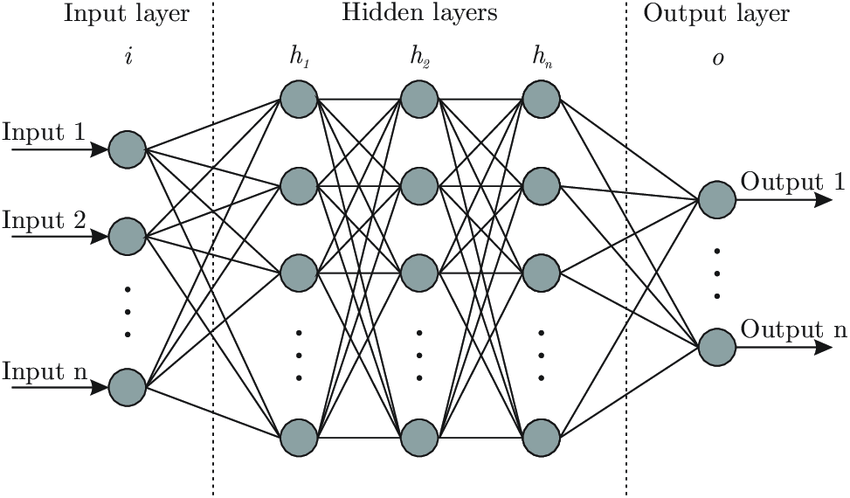
Diagrama de demostración:
Práctica: construir una red neuronal con Python
Por mucha teoría que se explique, es mejor ponerla en práctica. A continuación usaremosNumPyuna librería para construir desde cero la red neuronal de tres capas más simple (1 capa oculta) y realizaremos un cálculo de propagación hacia adelante.
Ejemplo
# Definir funciones de activación
def sigmoid(x):
"""Función de activación Sigmoid"""
return 1 / (1 + np.exp(-x))
def relu(x):
"""Función de activación ReLU"""
return np.maximum(0, x)
# Inicializar una red neuronal simple
def initialize_network(input_size, hidden_size, output_size):
"""
Inicializa los pesos y sesgos de la red.
Parámetros:
input_size: número de neuronas en la capa de entrada
hidden_size: número de neuronas en la capa oculta
output_size: número de neuronas en la capa de salida
Devuelve:
network: diccionario que contiene los parámetros de cada capa
"""
np.random.seed(42) # Establecer la semilla aleatoria para asegurar que cada ejecución produzca el mismo resultado
network = {}
# Inicializar los parámetros de la capa de entrada -> capa oculta
# Forma de la matriz de pesos: (número de neuronas de la siguiente capa, número de neuronas de la capa anterior)
network['W1'] = np.random.randn(hidden_size, input_size) * 0.01
network['b1'] = np.zeros((hidden_size, 1)) # El sesgo es un vector columna
# Inicializar los parámetros de la capa oculta -> capa de salida
network['W2'] = np.random.randn(output_size, hidden_size) * 0.01
network['b2'] = np.zeros((output_size, 1))
return network
# Función de propagación hacia adelante
def forward_propagation(network, X):
"""
Ejecuta la propagación hacia adelante y calcula la salida de la red.
Parámetros:
network: diccionario que contiene los pesos y los sesgos
X: datos de entrada, con forma (número de características, número de muestras)
Devuelve:
y_pred: salida de predicción de la red
cache: almacena los resultados intermedios (para la posterior propagación hacia atrás)
"""
# Obtener parámetros
W1, b1, W2, b2 = network['W1'], network['b1'], network['W2'], network['b2']
# Cálculo de la capa 1: capa de entrada -> capa oculta
Z1 = np.dot(W1, X) + b1 # Suma ponderada
A1 = relu(Z1) # A través de la función de activación ReLU
# Cálculo de la capa 2: capa oculta -> capa de salida
Z2 = np.dot(W2, A1) + b2 # Suma ponderada
A2 = sigmoid(Z2) # A través de la función de activación Sigmoid (asumiendo clasificación binaria)
# Cachear resultados intermedios, se usarán en la retropropagación
cache = {'Z1': Z1, 'A1': A1, 'Z2': Z2, 'A2': A2}
return A2, cache
# --- ¡Vamos a ejecutarlo! ---
# 1. Definir la estructura de la red: 2 características de entrada, 3 neuronas ocultas, 1 salida (clasificación binaria)
input_size = 2
hidden_size = 3
output_size = 1
# 2. Inicializar la red
my_network = initialize_network(input_size, hidden_size, output_size)
print("Forma del peso W1 (capa oculta x capa de entrada):", my_network['W1'].shape)
print("Forma del sesgo b1:", my_network['b1'].shape)
print("Forma del peso W2 (capa de salida x capa oculta):", my_network['W2'].shape)
# 3. Crear un dato de entrada de muestra (2 características, 1 muestra)
# Las columnas de X representan muestras, las filas representan características
X_sample = np.array([[1.5], [-0.5]]) # Forma (2, 1)
print("\n"Datos de entrada X:", X_sample.T) # .T es para transponer la impresión, para facilitar la visualización
# 4. Ejecutar la propagación hacia adelante
y_pred, cache = forward_propagation(my_network, X_sample)
print("\n"Salida de predicción de la red neuronal (A2):", y_pred)
# Si la salida > 0.5, podemos considerar que es la clase 1; de lo contrario, es la clase 0
predicted_class = 1 if y_pred > 0.5 else 0
print(f"Clase predicha: {predicted_class}")
Interpretación del código y análisis de la salida:
Inicialización: creamos una red con estructura 2-3-1.W1es una matriz de 3x2, que representa los pesos de conexión desde las 2 entradas a las 3 neuronas ocultas.
Propagación hacia adelante:
- Entrada
[1.5, -0.5]Primero conW1se multiplica y se sumab1, obteniendo la suma ponderada de la capa ocultaZ1。 Z1Después de la función ReLU, se obtiene el valor de activación de la capa ocultaA1。A1Luego conW2se multiplica y se sumab2, obteniendo la suma ponderada de la capa de salidaZ2。Z2Finalmente, a través de la función Sigmoid, se comprime entre (0,1), como probabilidad de predicción final.A2。
Salida: dado que los pesos se inicializan aleatoriamente, la salida de predicción de esta red no entrenadaA2también es un valor aleatorio (cercano a 0.5).El propósito de entrenar una red neuronal es, mediante una gran cantidad de datos, ajustar repetidamenteW1, b1, W2, b2, de modo queA2pueda producir predicciones significativas para diferentes entradas.
Resumen de conceptos clave y ruta de aprendizaje
A través de este artículo, ya has dominado los pilares de las redes neuronales:
| Concepto | Puntos clave |
|---|---|
| Neurona | Unidad de cálculo, realizasuma ponderada -> añadir sesgo -> función de activación。 |
| Pesos y sesgos | Parámetros clave que el modelo necesita aprender, determinan el comportamiento de la red. |
| Función de activación | Introduce no linealidad (como ReLU, Sigmoid), permitiendo que la red aprenda relaciones complejas. |
| Capas de la red | Capa de entrada(recibe datos),capa oculta(extracción de características),capa de salida(produce la predicción). |
| Propagación hacia adelante | Proceso en el que los datos fluyen desde la capa de entrada a la capa de salida, calculando el valor de predicción. |
Tu siguiente paso de aprendizaje:
- Función de pérdida: ¿Cómo cuantificar qué tan buena o mala es la predicción de la red (como error cuadrático medio, pérdida de entropía cruzada)?
- Retropropagación y descenso de gradiente: ¿Cómo ajusta la red neuronal automáticamente los pesos y sesgos según el grado de "malo" (esta es la esencia del aprendizaje)?
- Práctica con frameworks: Usando
TensorFlowoPyTorchframeworks modernos, etc., se pueden construir y entrenar redes más complejas fácilmente, sin necesidad de escribir desde ceroNumPycódigo.
Después de comprender la estructura básica, descubrirás que todos los modelos complejos de aprendizaje profundo (como CNN para imágenes, RNN para voz) han evolucionado a partir de esta estructura básica, cambiando la forma de conexión de las neuronas y las funciones de las capas. Ahora, ya tienes el mapa para seguir explorando el amplio mundo del aprendizaje profundo.
Otras extensiones