Базовая структура нейронных сетей
В волне искусственного интеллекта глубокое обучение, несомненно, является самой ослепительной звездой, а ядро глубокого обучения составляет именнонейронные сети. Они имитируют работу нейронов человеческого мозга и благодаря послойным связям и вычислениям наделяют машины способностью учиться и воспринимать.
Для начинающих понимание базовой структуры нейронных сетей — это первый ключ, открывающий дверь в глубокое обучение.
Эта статья проведёт вас с нуля, шаг за шагом разберёт компоненты нейронных сетей и с помощью ярких аналогий и понятного кода поможет вам досконально освоить, как они работают.
Что такое нейронная сеть? Наглядная аналогия
Представьте, что вы учите ребёнка, который никогда не видел кошек и собак, различать их. Что бы вы сделали?
- Вы могли бы сначала показать ему много картинок с кошками и собаками.
- Вы бы указали на признаки: смотрите, у кошек уши обычно заострённые, а мордочки относительно круглые; у собак уши могут свисать, а мордочки длиннее.
- Мозг ребёнка (нейронная сеть) получит эти изображения (входные данные) и ваши указания (метки).
- Нейроны в его мозге начнут работать, пытаясь найти ключевые закономерности, отличающие кошек от собак (например, форму ушей и форму морды).
- После множества исправлений и обучения в его мозге формируется модель суждения. В следующий раз, увидев новую картинку животного, он сможет уверенно сказать, кошка это или собака.
Нейронная сеть — это упрощённая математическая модель мозга этого ребёнка,Это сетевая система, состоящая из большого количестваискусственных нейронов, взаимосвязанных друг с другом, которая может автоматически изучать признаки и закономерности из входных данных и использоваться для прогнозирования или принятия решений.

Базовые строительные блоки нейронных сетей: нейроны
Нейрон — это самая базовая вычислительная единица нейронной сети. Он имитирует процесс биологического нейрона:приём сигнала → обработка сигнала → передача сигнала.
Рабочий процесс нейрона
Типичный искусственный нейрон в основном делает три вещи:
Пример
def artificial_neuron(inputs, weights, bias):
"""
Смоделировать процесс вычисления искусственного нейрона.
Параметры:
inputs: список входных сигналов, например, [x1, x2, x3]
weights: список весов, соответствующих каждому входу, например, [w1, w2, w3]
bias: член смещения, константа
Возвращает:
output: выход нейрона
"""
# 1. Взвешенная сумма: умножьте каждый вход на соответствующий ему вес, затем прибавьте bias
weighted_sum = 0
for i in range(len(inputs)):
weighted_sum += inputs[i] * weights[i]
weighted_sum += bias
# 2. Обработка функцией активации: с помощью нелинейной функции решить, следует ли "активировать" и выдать сигнал
output = activation_function(weighted_sum)
return output
Давайте воспользуемся диаграммой и таблицей, чтобы понять это более наглядно:
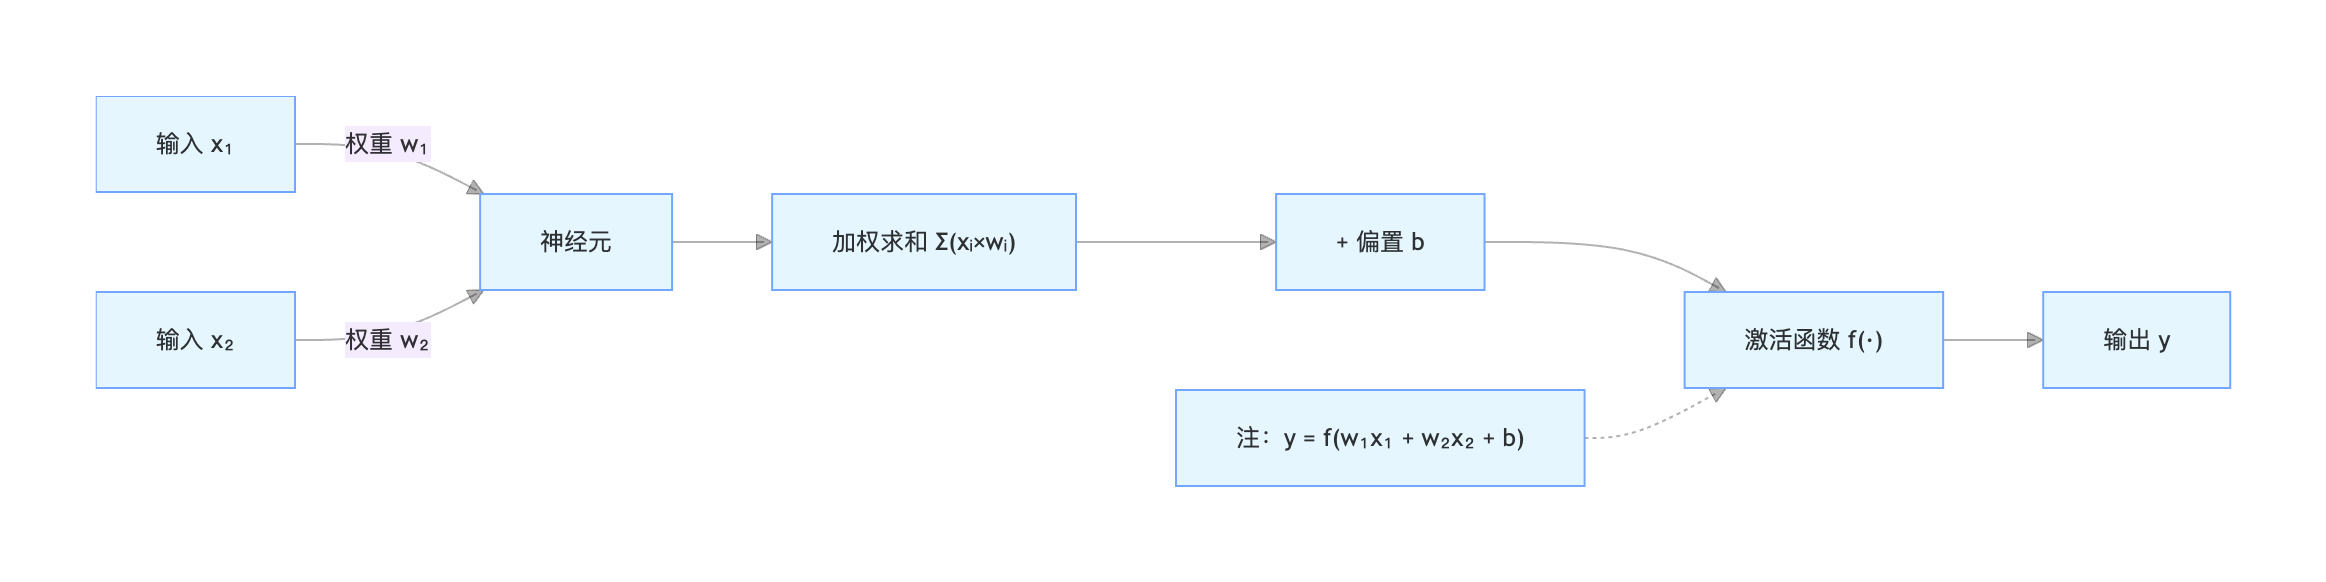
Подробное объяснение функций каждого компонента нейрона:
| Компонент | Аналогия | Математическое выражение | Функция |
|---|---|---|---|
| Вход \(x\) | Сигнал от других нейронов | \( x_1, x_2, ..., x_n \) | Получает внешнюю информацию или выход нейронов предыдущего слоя. |
| Вес \(w\) | Важность сигнала | \(w_1, w_2, ..., w_n\) | Определяет степень, в которой каждый вход влияет на выход нейрона.Процесс обучения — это процесс непрерывной корректировки этих весов. |
| Смещение \(b\) | Порог активации нейрона | \(b\) | Константа, используемая для настройки того, насколько легко нейрон активируется. Её можно понимать как сдвиг взвешенной суммы вверх или вниз как единого целого. |
| Взвешенная сумма \(z\) | Общая сила сигнала | \(z = (x_1w_1 + x_2w_2 + ... + x_nw_n) + b\) | Синтезирует все входные сигналы. |
| Функция активации \(f\) | Переключатель и обработчик | \(a = f(z)\) | Вноситнелинейность. Без неё многослойная сеть выродилась бы в однослойную сеть и не смогла бы изучать сложные закономерности. |
Распространённые функции активации
Функции активации придают нейронным сетям нелинейные возможности. Вот три наиболее часто используемых:
Сигмоида
- Формула:\(f(z) = \frac{1}{1 + e^{-z}}\)
- Характеристики: Сжимает входное значение до интервала (0, 1). Обычно используется в выходном слое задач бинарной классификации. Склонна вызывать проблему исчезающего градиента.
- Изображение: Гладкая S-образная кривая.
ReLU (выпрямленная линейная функция)
- Формула:\(f(z) = max(0, z)\)
- Характеристики: Проста в вычислении, эффективно смягчает проблему исчезающего градиента и в настоящее время является наиболее часто используемой функцией активации для скрытых слоёв.
- Изображение: Ломаная линия с изломом в начале координат; выдаёт 0 для отрицательных чисел и возвращает исходное значение для положительных чисел.
Softmax
- Формула:\(f(z_i) = \frac{e^{z_i}}{\sum_{j=1}^{K} e^{z_j}}\)
- Характеристики: Преобразует выходы нескольких нейронов в распределение вероятностей (сумма всех выходов равна 1).Обычно используется для выходного слоя задач многоклассовой классификации.。
Иерархическая структура нейронных сетей
Один нейрон обладает ограниченными возможностями, так же как одна клетка мозга не может думать. Когда мы организуем большое количество нейронов в слои, формируется мощная нейронная сеть. Типичная нейронная сеть содержит следующие три слоя:
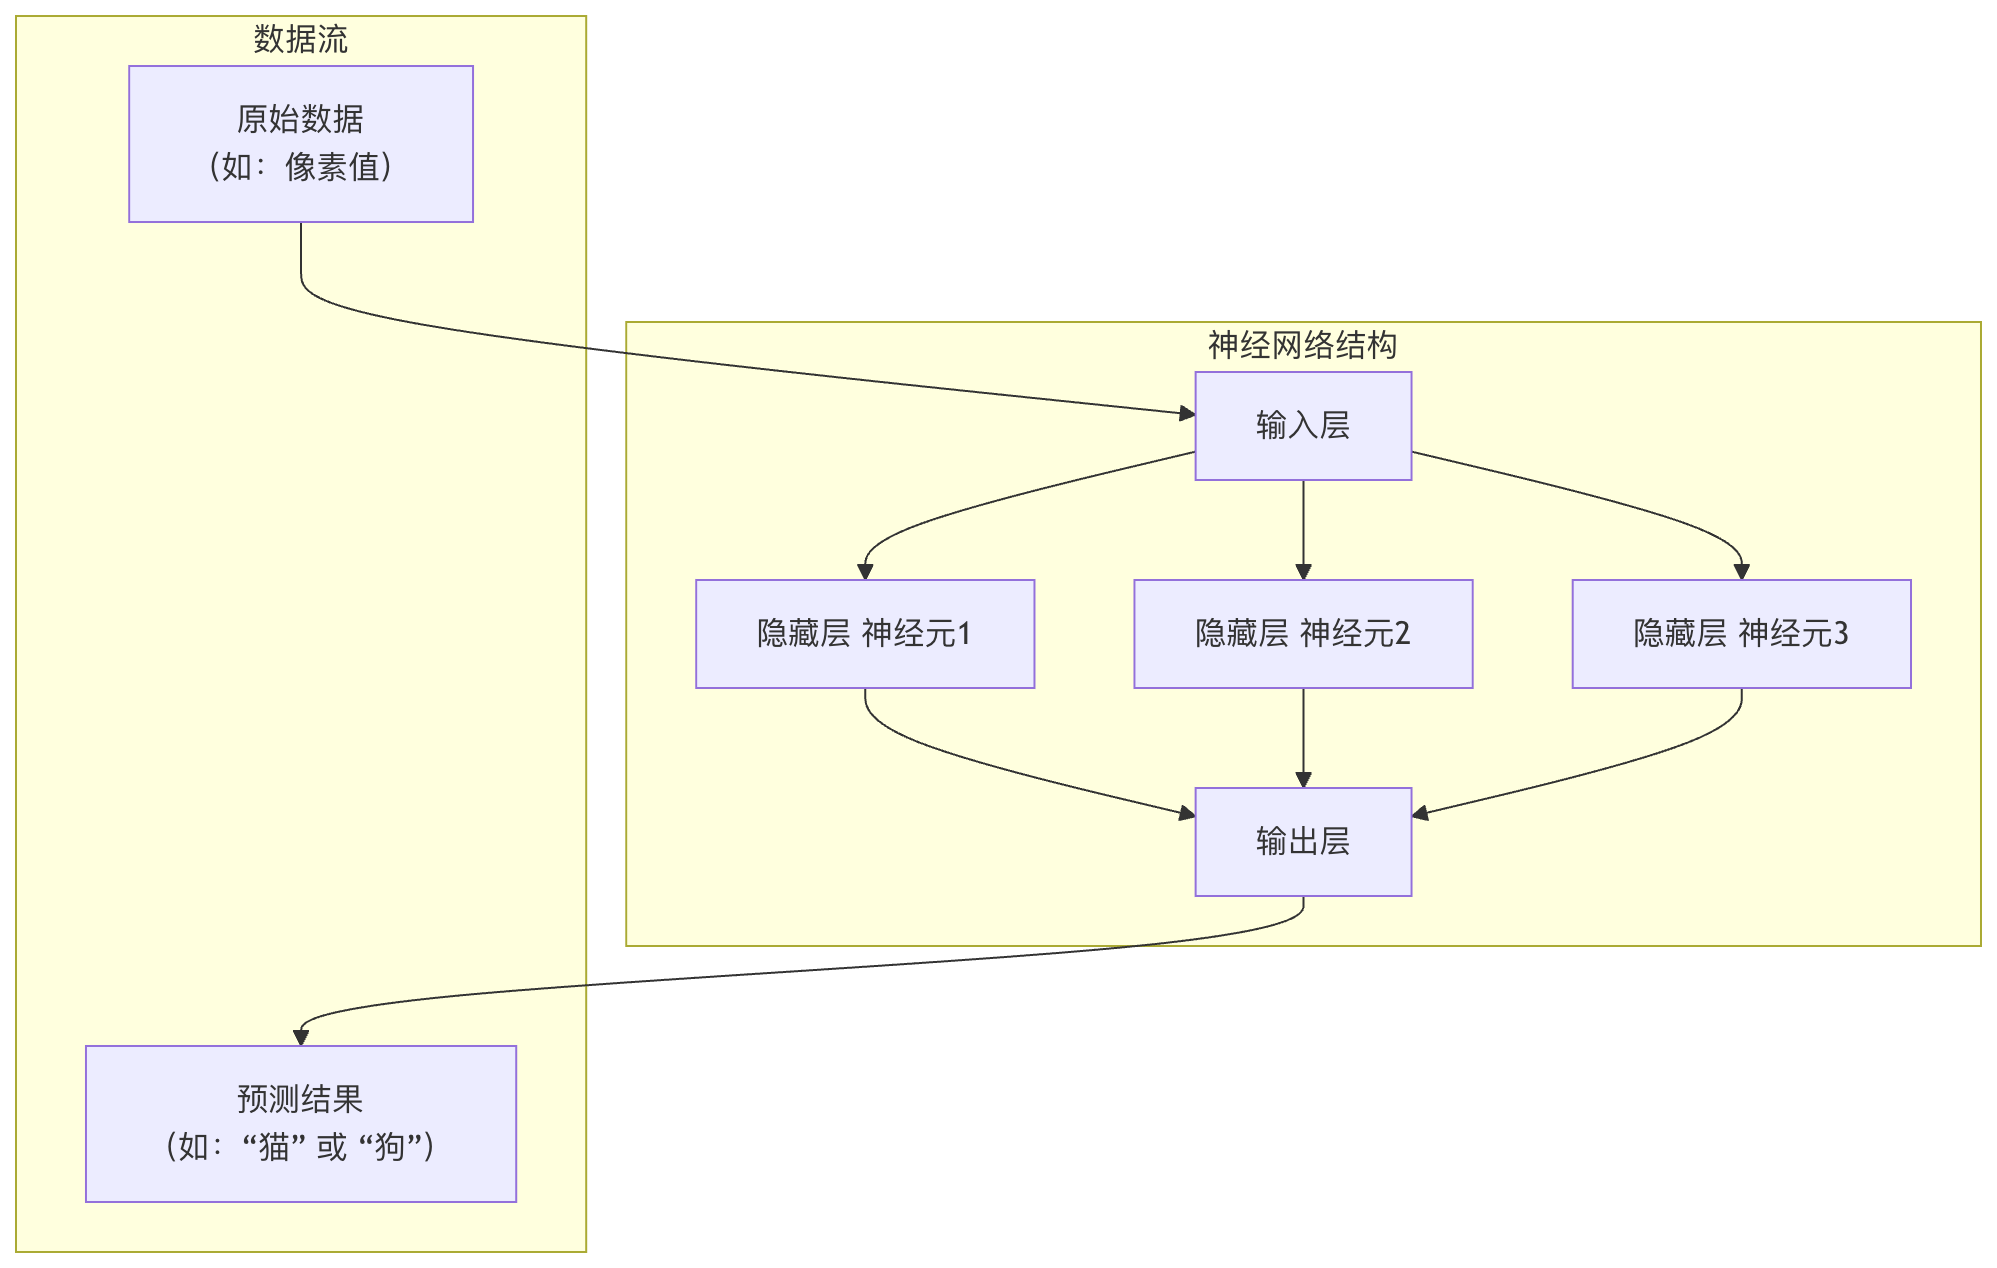
1. Входной слой
- Роль: Органы чувств сети, отвечающие за получение необработанных данных.
- Характеристики: Количество нейронов в этом слое обычно равно количеству признаков во входных данных. Например, изображение в оттенках серого размером 28x28 пикселей разворачивается в 784 признака, что соответствует 784 входным нейронам.Входной слой не выполняет никаких вычислений, он только пропускает данные через себя.
2. Скрытый слой
Роль: Мозг сети, отвечающий за сложное извлечение и преобразование признаков.
Характеристики:
- Расположен между входным и выходным слоями и может содержать один или несколько слоёв (именно отсюда происходит название «глубокое обучение»).
- Нейроны каждого слоя получают выходы всех нейронов предыдущего слоя в качестве входных данных, вычисляют собственные выходы и передают их следующему слою (это называется полным соединением).
- Нейроны скрытого слоя используют функции активации, такие как ReLU, для внесения нелинейности.
3. Выходной слой
Роль: принимающий решения в сети, выводит итоговый результат предсказания.
Характеристики: количество нейронов определяется задачей.
- Бинарная классификация: 1 нейрон (с использованием Sigmoid) или 2 нейрона (с использованием Softmax).
- Многоклассовая классификация (K классов): K нейронов (с использованием Softmax).
- Регрессия(предсказание непрерывного значения): 1 нейрон (обычно без функции активации).
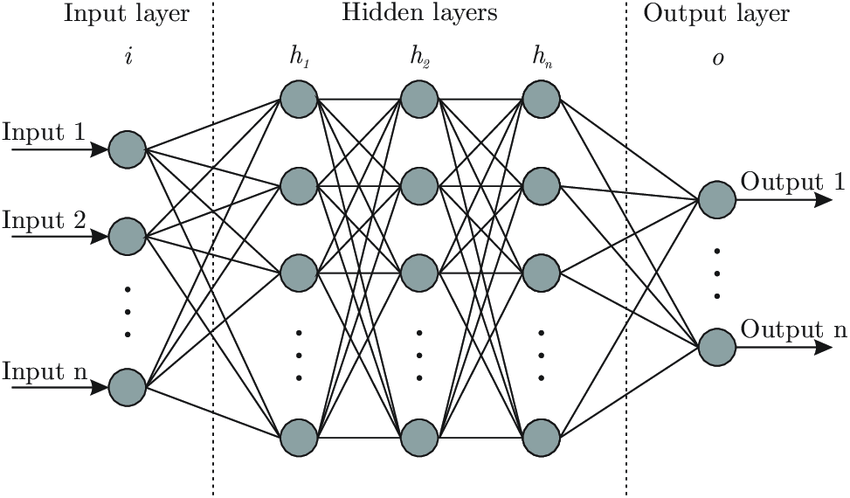
Демонстрационная схема:
Практика: построим нейронную сеть на Python
Сколько бы теории ни говорили, лучше практиковаться. Ниже мы используемNumPyбиблиотеку, чтобы с нуля построить простейшую трёхслойную нейронную сеть (1 скрытый слой) и выполнить расчёт прямого распространения.
Пример
"""Функция активации Sigmoid"""
def sigmoid(x):
"""Функция активации ReLU"""
return 1 / (1 + np.exp(-x))
def relu(x):
# Инициализировать простую нейронную сеть
return np.maximum(0, x)
Инициализировать веса и смещения сети.
def initialize_network(input_size, hidden_size, output_size):
"""
Параметры:
input_size: количество нейронов во входном слое
hidden_size: количество нейронов в скрытом слое
output_size: количество нейронов в выходном слое
Возвращает:
network: словарь, содержащий параметры для каждого слоя
# Установить начальное значение генератора случайных чисел, чтобы обеспечить одинаковые результаты при каждом запуске
"""
np.random.seed(42) # Инициализировать параметры для входного слоя -> скрытого слоя
network = {}
# Форма матрицы весов: (количество нейронов в следующем слое, количество нейронов в предыдущем слое)
# Смещение — это вектор-столбец
network['W1'] = np.random.randn(hidden_size, input_size) * 0.01
network['b1'] = np.zeros((hidden_size, 1)) # Инициализация параметров для скрытого слоя -> выходного слоя
# Функция прямого распространения
network['W2'] = np.random.randn(output_size, hidden_size) * 0.01
network['b2'] = np.zeros((output_size, 1))
return network
Выполнить прямое распространение для вычисления выхода сети.
def forward_propagation(network, X):
"""
Параметры:
network: словарь, содержащий веса и смещения
X: входные данные, форма (количество признаков, количество образцов)
Возвращает:
y_pred: выходной результат предсказания сети
cache: кэшированные промежуточные результаты (для последующего обратного распространения)
# Получить параметры
"""
# Получить параметры
W1, b1, W2, b2 = network['W1'], network['b1'], network['W2'], network['b2']
# Вычисление слоя 1: входной слой -> скрытый слой
Z1 = np.dot(W1, X) + b1 # Взвешенная сумма
A1 = relu(Z1) # Через функцию активации ReLU
# Вычисление слоя 2: скрытый слой -> выходной слой
Z2 = np.dot(W2, A1) + b2 # Взвешенная сумма
A2 = sigmoid(Z2) # Через функцию активации Sigmoid (предполагая бинарную классификацию)
# Кэшировать промежуточные результаты для использования при обратном распространении
cache = {'Z1': Z1, 'A1': A1, 'Z2': Z2, 'A2': A2}
return A2, cache
# --- Давайте запустим! ---
# 1. Определите структуру сети: 2 входных признака, 3 скрытых нейрона, 1 выход (бинарная классификация)
input_size = 2
hidden_size = 3
output_size = 1
# 2. Инициализируйте сеть
my_network = initialize_network(input_size, hidden_size, output_size)
print("Размерность весов W1 (скрытый слой x входной слой):", my_network['W1'].shape)
print("Размерность смещения b1:", my_network['b1'].shape)
print("Размерность весов W2 (выходной слой x скрытый слой):", my_network['W2'].shape)
# 3. Создайте пример входных данных (2 признака, 1 пример)
# В X столбцы соответствуют примерам, строки — признакам
X_sample = np.array([[1.5], [-0.5]]) # Форма (2, 1)
print("\nВходные данные X:", X_sample.T) # .T используется для транспонирования для облегчения вывода
# 4. Выполните прямое распространение
y_pred, cache = forward_propagation(my_network, X_sample)
print("\nПредсказанный выход нейронной сети (A2):", y_pred)
# Если output > 0.5, считаем это классом 1, иначе классом 0
predicted_class = 1 if y_pred > 0.5 else 0
print(f"Предсказанный класс: {predicted_class}")
Пояснение к коду и анализ вывода:
Инициализация: Мы создали структуру сети 2-3-1.W1Это матрица 3x2, представляющая веса связей от 2 входов к 3 скрытым нейронам.
Прямое распространение:
- Ввод
[1.5, -0.5]сначала сW1умножается и прибавляется кb1, что даёт взвешенную сумму скрытого слояZ1。 Z1После функции ReLU получаем значения активации скрытого слояA1。A1Затем сW2умножается и прибавляется кb2, что даёт взвешенную сумму выходного слояZ2。Z2Наконец, с помощью функции Sigmoid оно сжимается до (0,1) как итоговая предсказанная вероятностьA2。
Выход: поскольку веса инициализированы случайным образом, предсказанный выход этой необученной сетиA2также является случайным значением (близким к 0.5).Цель обучения нейронной сети — многократно настраивать с помощью больших объёмов данных,W1, b1, W2, b2, чтобыA2она могла выдавать осмысленные предсказания для разных входных данных.
Краткое изложение ключевых концепций и пути обучения
В этой статье вы освоили краеугольные камни нейронных сетей:
| Концепция | Ключевые моменты |
|---|---|
| Нейрон | Вычислительная единица, которая выполняетWeighted sum -> Add bias -> Activation function。 |
| Веса и смещения | Основные параметры, которые модель должна изучить; они определяют поведение сети. |
| Функция активации | Вносит нелинейность (например, ReLU, Sigmoid), позволяя сети изучать сложные взаимосвязи. |
| Слои сети | Входной слой(получает данные),скрытый слой(извлечение признаков),выходной слой(выдаёт предсказания). |
| Прямое распространение | Процесс прохождения данных от входного слоя к выходному для вычисления предсказанных значений. |
Ваши следующие шаги обучения:
- Функция потерь: Как количественно оценить, насколько хорошо сеть предсказывает (например, среднеквадратичная ошибка, кросс-энтропийная потеря)?
- Обратное распространение и градиентный спуск: Как нейронная сеть автоматически корректирует веса и смещения в зависимости от степени «плохости» (в этом суть обучения)?
- Практическая работа с фреймворками: Используйте
TensorFlowилиPyTorchи другие современные фреймворки, вы можете легко создавать и обучать более сложные сети, без необходимости писать с нуляNumPyкод.
Как только вы поймёте базовую структуру, вы обнаружите, что все сложные модели глубокого обучения (такие как CNN для изображений, RNN для речи) произошли от этой базовой структуры путём изменения схем соединений нейронов и функций слоёв. Теперь у вас есть карта, чтобы продолжить исследование огромного мира глубокого обучения.
Другие расширения