Structure de base des réseaux de neurones
Dans la vague de l'intelligence artificielle, l'apprentissage profond est sans aucun doute l'étoile la plus éblouissante, et ce qui constitue le cœur de l'apprentissage profond est précisémentles réseaux de neurones. Il imite le fonctionnement des neurones du cerveau humain et, par des connexions et des calculs couche par couche, il dote les machines de la capacité d'apprendre et de percevoir.
Pour les débutants, comprendre la structure de base des réseaux de neurones est la première clé pour ouvrir la porte de l'apprentissage profond.
Cet article vous fera partir de zéro, décomposera les composants des réseaux de neurones étape par étape, et utilisera des analogies vivantes et un code clair pour vous aider à maîtriser parfaitement leur fonctionnement.
Qu'est-ce qu'un réseau de neurones ? Une analogie vivante
Imaginez que vous apprenez à un enfant qui n'a jamais vu de chats et de chiens à les distinguer. Que feriez-vous ?
- Vous pourriez d'abord lui montrer de nombreuses images de chats et de chiens.
- Vous montreriez des caractéristiques : Regardez, les oreilles des chats sont généralement pointues et leur visage est relativement rond ; les oreilles des chiens peuvent être tombantes et leur visage est plus long.
- Le cerveau de l'enfant (le réseau de neurones) recevra ces images (données d'entrée) et vos indications (étiquettes).
- Les neurones de son cerveau commenceront à fonctionner, en essayant de trouver des motifs clés qui distinguent les chats des chiens (comme la forme des oreilles et la forme du visage).
- Après de multiples corrections et apprentissages, un modèle de jugement se forme dans son cerveau. La prochaine fois qu'il verra l'image d'un nouvel animal, il pourra dire avec assurance s'il s'agit d'un chat ou d'un chien.
Un réseau de neurones est un modèle mathématique simplifié du cerveau de cet enfant,c'est un système en réseau composé d'un grand nombre deneurones artificielsinterconnectés les uns aux autres, qui peuvent automatiquement apprendre des caractéristiques et des motifs à partir des données d'entrée et être utilisés pour la prédiction ou la prise de décision.

Briques de base des réseaux de neurones : les neurones
Un neurone est l'unité de calcul la plus fondamentale d'un réseau de neurones. Il simule le processusréception d'un signal → traitement d'un signal → transmission d'un signald'un neurone biologique.
Le flux de travail d'un neurone
Un neurone artificiel typique fait principalement trois choses :
Exemple
def artificial_neuron(inputs, weights, bias):
"""
Simuler le processus de calcul d'un neurone artificiel.
Paramètres :
inputs : liste de signaux d'entrée, par exemple, [x1, x2, x3]
weights : liste des poids correspondant à chaque entrée, par exemple [w1, w2, w3]
bias : terme de biais, une constante
Retourne :
output : la sortie du neurone
"""
# 1. Somme pondérée : multiplier chaque entrée par son poids correspondant, puis ajouter le biais
weighted_sum = 0
for i in range(len(inputs)):
weighted_sum += inputs[i] * weights[i]
weighted_sum += bias
# 2. Traitement par fonction d'activation : via une fonction non linéaire, décider s'il faut « activer » et émettre le signal
output = activation_function(weighted_sum)
return output
Utilisons un schéma et un tableau pour le comprendre plus intuitivement :
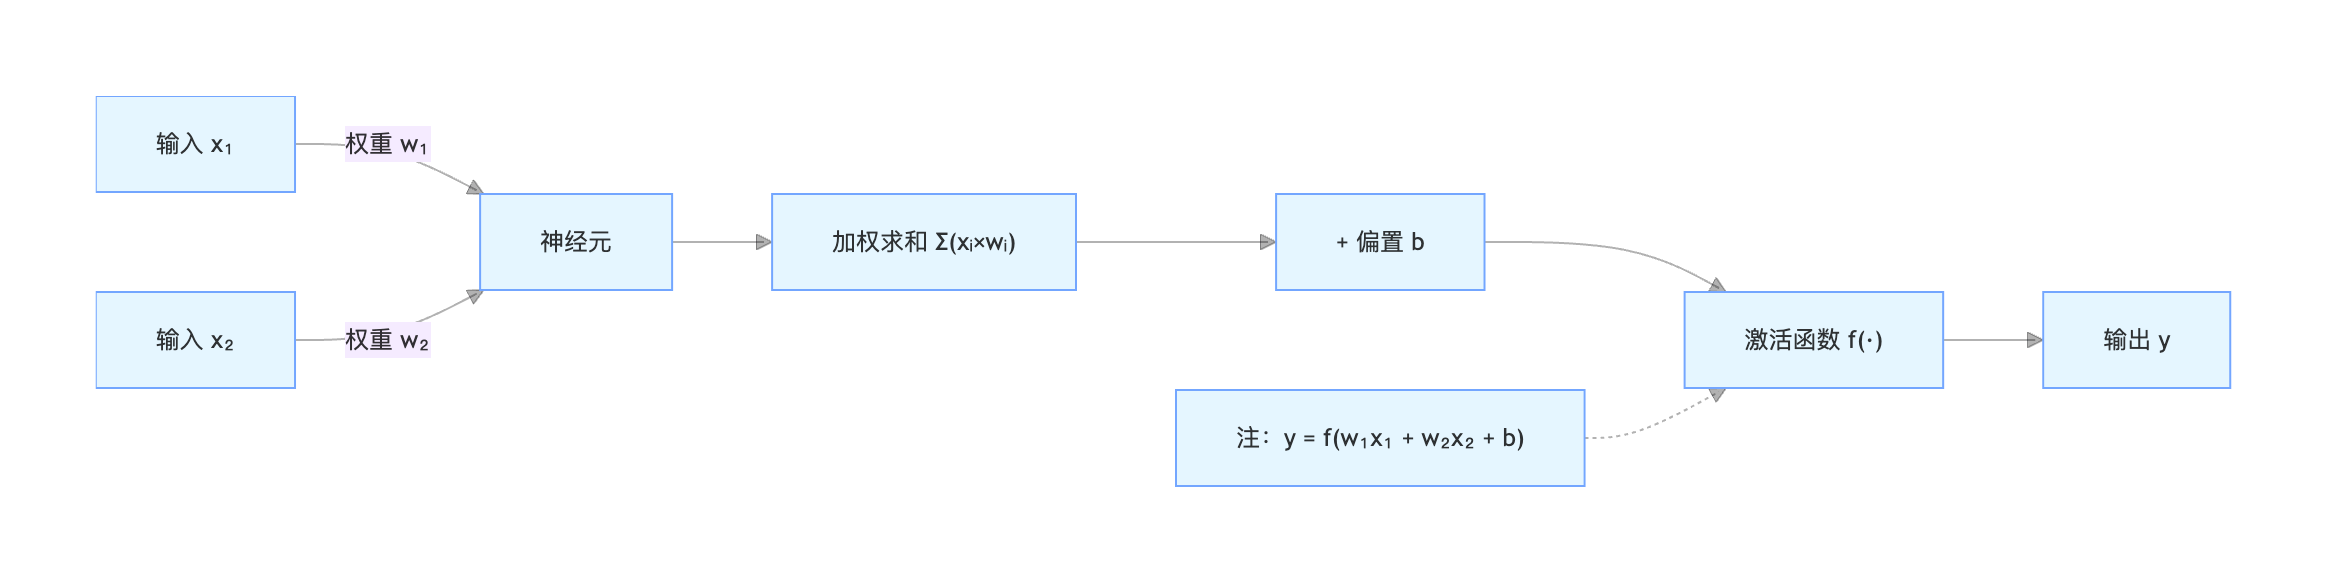
Explication détaillée des fonctions de chaque composant du neurone :
| Composant | Analogie | Expression mathématique | Fonction |
|---|---|---|---|
| Entrée \(x\) | Signal provenant d'autres neurones | \( x_1, x_2, ..., x_n \) | Reçoit des informations externes ou la sortie des neurones de la couche précédente. |
| Poids \(w\) | Importance du signal | \(w_1, w_2, ..., w_n\) | Détermine la mesure dans laquelle chaque entrée affecte la sortie du neurone.Le processus d'apprentissage est le processus d'ajustement continu de ces poids. |
| Biais \(b\) | Seuil d'activation d'un neurone | \(b\) | Une constante utilisée pour ajuster la facilité avec laquelle le neurone s'active. Elle peut être comprise comme un décalage global de la somme pondérée vers le haut ou vers le bas. |
| Somme pondérée \(z\) | Intensité totale du signal | \(z = (x_1w_1 + x_2w_2 + ... + x_nw_n) + b\) | Synthétise tous les signaux d'entrée. |
| Fonction d'activation \(f\) | Commutateur et processeur | \(a = f(z)\) | Introduitla non-linéarité. Sans cela, un réseau multicouche dégénérerait en un réseau monocouche et serait incapable d’apprendre des motifs complexes. |
Fonctions d’activation courantes
Les fonctions d’activation apportent une capacité non linéaire aux réseaux de neurones. Voici les trois les plus couramment utilisées :
Sigmoïde
- Formule:\(f(z) = \frac{1}{1 + e^{-z}}\)
- Caractéristiques: Compresse l’entrée entre (0, 1). Couramment utilisée dans la couche de sortie des problèmes de classification binaire. Sujette à provoquer le problème du gradient évanescent.
- Image: Une courbe lisse en forme de S.
ReLU (unité linéaire rectifiée)
- Formule:\(f(z) = max(0, z)\)
- Caractéristiques: Simple à calculer, atténue efficacement le problème du gradient évanescent et est actuellement la fonction d’activation la plus couramment utilisée pour les couches cachées.
- Image: Une ligne brisée qui change de direction à l’origine ; renvoie 0 pour les nombres négatifs et renvoie la valeur d’origine pour les nombres positifs.
Softmax
- Formule:\(f(z_i) = \frac{e^{z_i}}{\sum_{j=1}^{K} e^{z_j}}\)
- Caractéristiques: Convertit les sorties de plusieurs neurones en une distribution de probabilité (la somme de toutes les sorties vaut 1).Spécifiquement utilisé pour la couche de sortie des problèmes de classification multiclasse.。
La structure hiérarchique des réseaux de neurones
Un neurone unique a une capacité limitée, tout comme une seule cellule cérébrale ne peut pas penser. Lorsque nous organisons un grand nombre de neurones en couches, un puissant réseau de neurones se forme. Un réseau de neurones typique contient les trois couches suivantes :
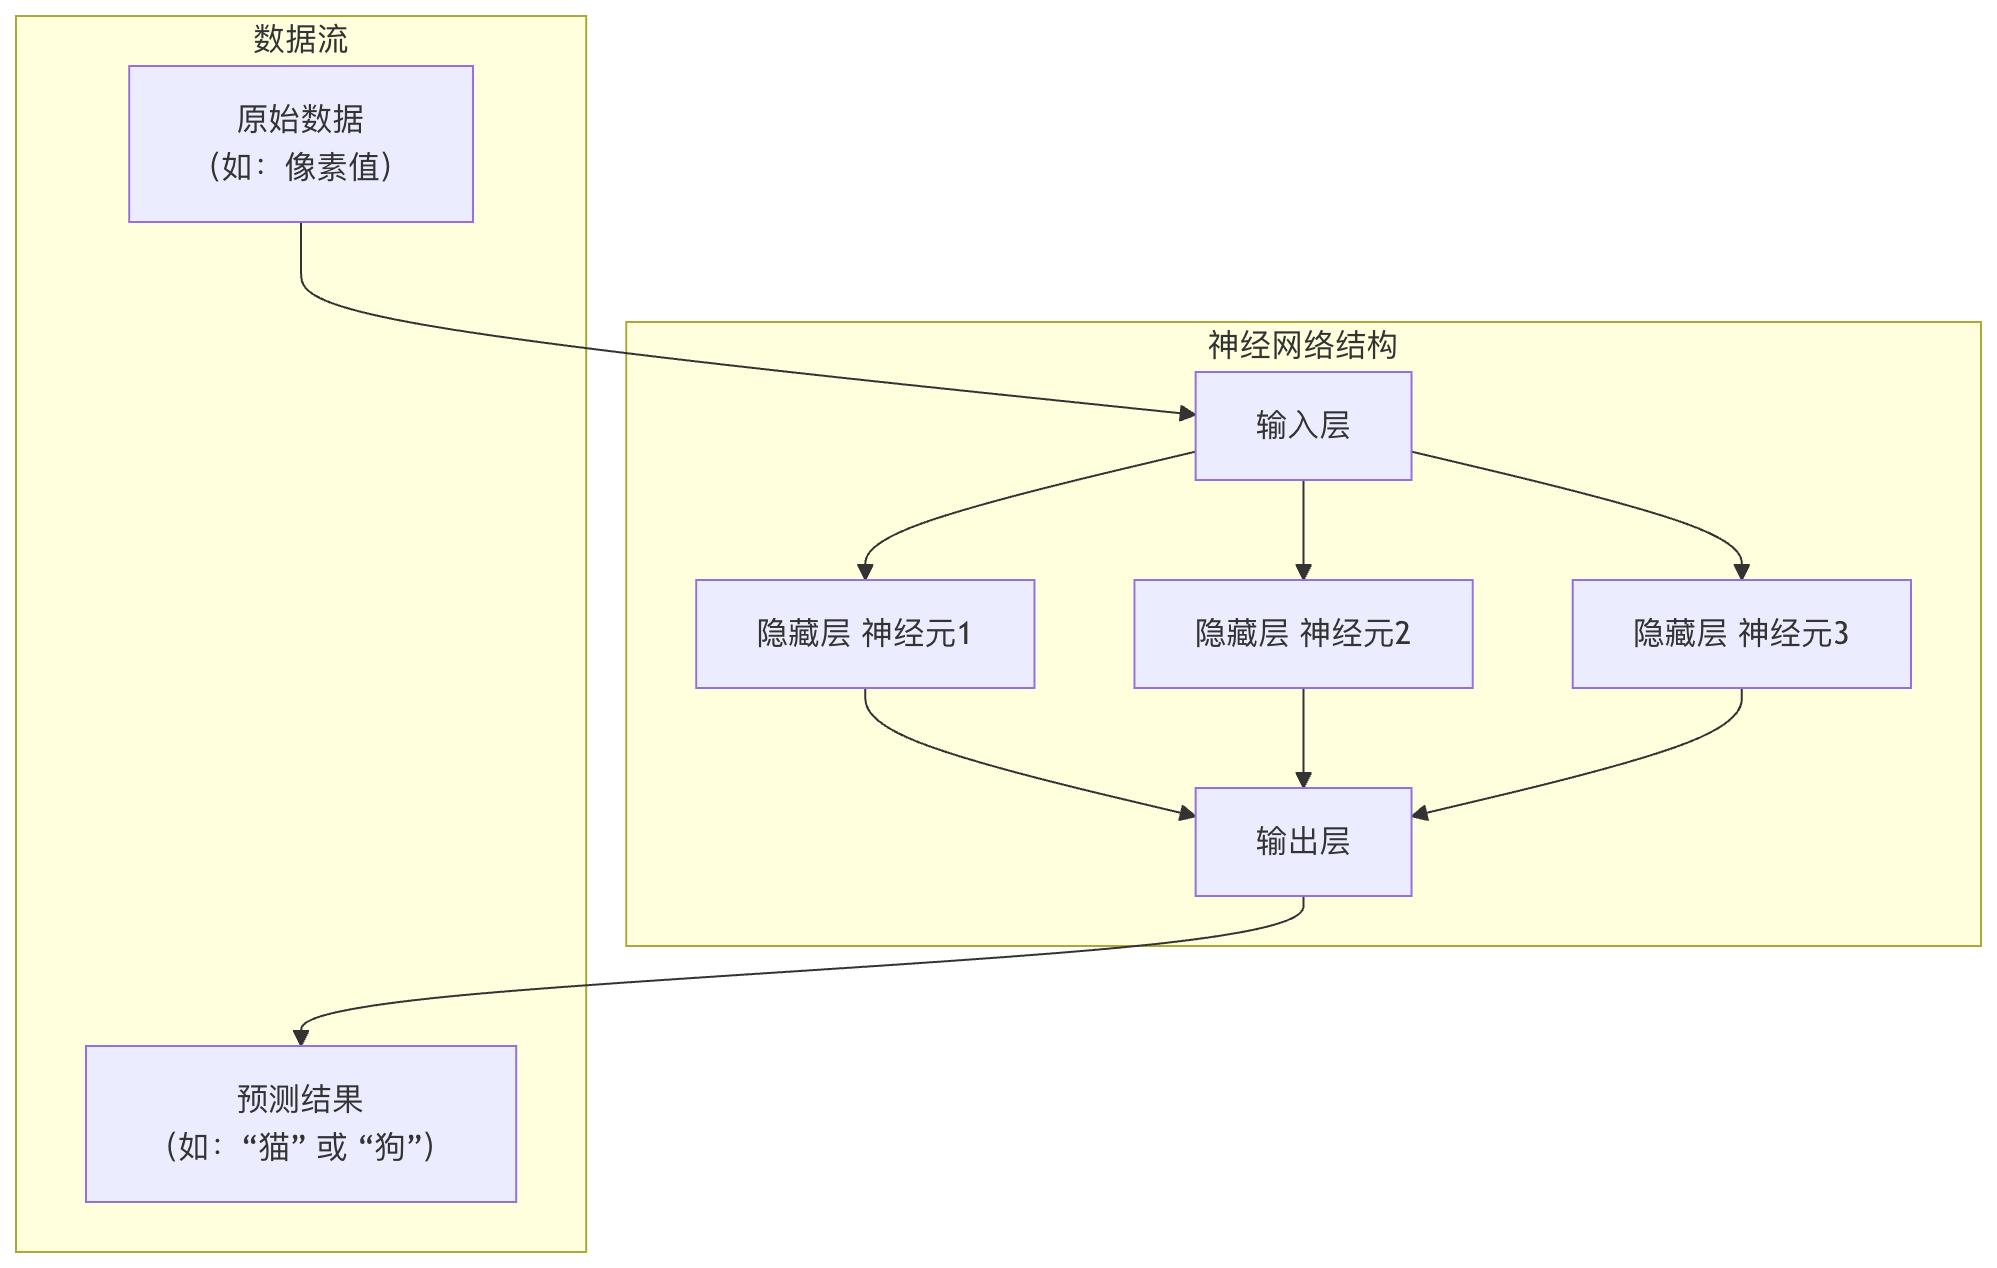
1. Couche d'entrée
- Rôle: Les sens du réseau, chargés de recevoir les données brutes.
- Caractéristiques: Le nombre de neurones dans cette couche est généralement égal au nombre de caractéristiques des données d'entrée. Par exemple, une image en niveaux de gris de 28x28 pixels est aplatie en 784 caractéristiques, correspondant à 784 neurones d'entrée.La couche d'entrée n'effectue aucun calcul, elle ne fait que transmettre les données.
2. Couche cachée
Rôle: Le cerveau du réseau, chargé de l'extraction et de la transformation complexes des caractéristiques.
Caractéristiques:
- Située entre la couche d'entrée et la couche de sortie, et peut comporter une ou plusieurs couches (c'est de là que l'apprentissage profond tire son nom).
- Les neurones de chaque couche reçoivent en entrée les sorties de tous les neurones de la couche précédente, calculent leurs propres sorties et les transmettent à la couche suivante (c'est ce qu'on appelle la connexion complète).
- Les neurones de la couche cachée utilisent des fonctions d'activation telles que ReLU pour introduire de la non-linéarité.
3. Couche de sortie
Rôle: Le décideur du réseau, produit le résultat de prédiction final.
Caractéristiques: Le nombre de neurones est déterminé par la tâche.
- Classification binaire: 1 neurone (avec Sigmoid) ou 2 neurones (avec Softmax).
- Classification multi-classes (K classes): K neurones (avec Softmax).
- Régression(prédiction d'une valeur continue) : 1 neurone (généralement sans fonction d'activation).
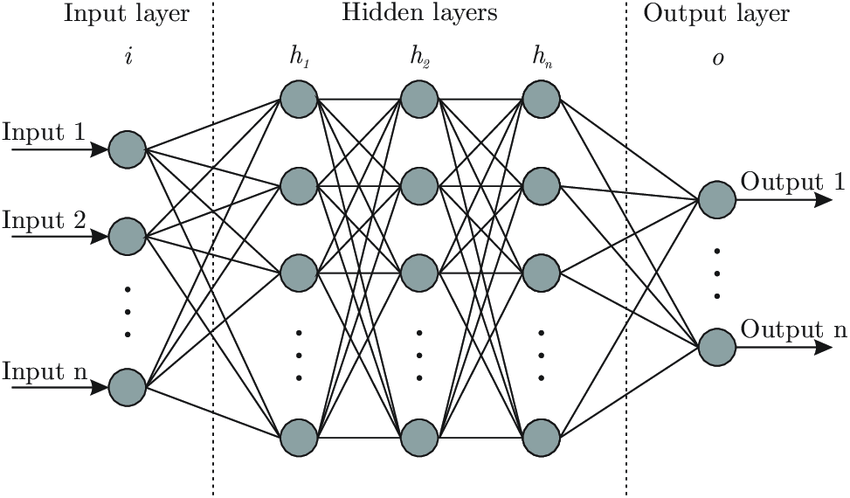
Schéma de démonstration :
Mise en pratique : Construire un réseau de neurones avec Python
Peu importe la quantité de théorie que vous évoquez, il vaut mieux pratiquer. Ci-dessous, nous utilisonsNumPyune bibliothèque pour construire à partir de zéro le réseau de neurones à trois couches le plus simple (1 couche cachée), et effectuer un calcul de propagation avant.
Exemple
"""Fonction d'activation sigmoïde"""
def sigmoid(x):
"""Fonction d'activation ReLU"""
return 1 / (1 + np.exp(-x))
def relu(x):
# Initialiser un réseau de neurones simple
return np.maximum(0, x)
Initialiser les poids et biais du réseau.
def initialize_network(input_size, hidden_size, output_size):
"""
Paramètres :
input_size : nombre de neurones dans la couche d'entrée
hidden_size : nombre de neurones dans la couche cachée
output_size : nombre de neurones dans la couche de sortie
Retourne :
network : dictionnaire contenant les paramètres de chaque couche
# Définir la graine aléatoire pour garantir des résultats cohérents à chaque exécution
"""
np.random.seed(42) # Initialiser les paramètres pour la couche d'entrée -> couche cachée
network = {}
# Dimensions de la matrice de poids : (nombre de neurones dans la couche suivante, nombre de neurones dans la couche précédente)
# Le biais est un vecteur colonne
network['W1'] = np.random.randn(hidden_size, input_size) * 0.01
network['b1'] = np.zeros((hidden_size, 1)) # Initialiser les paramètres de la couche cachée -> couche de sortie
# Fonction de propagation avant
network['W2'] = np.random.randn(output_size, hidden_size) * 0.01
network['b2'] = np.zeros((output_size, 1))
return network
Effectuer une propagation avant pour calculer la sortie du réseau.
def forward_propagation(network, X):
"""
Paramètres :
network : dictionnaire contenant les poids et les biais
X : données d'entrée, forme (nombre de caractéristiques, nombre d'échantillons)
Retourne :
y_pred: sortie de prédiction du réseau
cache: résultats intermédiaires mis en cache (pour la rétropropagation ultérieure)
# Obtenir les paramètres
"""
# Obtenir les Paramètres
W1, b1, W2, b2 = network['W1'], network['b1'], network['W2'], network['b2']
# Calcul de la couche 1: couche d'entrée -> couche cachée
Z1 = np.dot(W1, X) + b1 # Somme pondérée
A1 = relu(Z1) # Via la fonction d'activation ReLU
# Calcul de la couche 2: couche cachée -> couche de sortie
Z2 = np.dot(W2, A1) + b2 # Somme pondérée
A2 = sigmoid(Z2) # Via la fonction d'activation Sigmoïde (en supposant une classification binaire)
# Mettre en cache les résultats intermédiaires pour une utilisation dans la rétropropagation
cache = {'Z1': Z1, 'A1': A1, 'Z2': Z2, 'A2': A2}
return A2, cache
# --- Exécutons-le! ---
# 1. Définir la structure du réseau : 2 caractéristiques d'entrée, 3 neurones cachés, 1 sortie (classification binaire)
input_size = 2
hidden_size = 3
output_size = 1
# 2. Initialiser le réseau
my_network = initialize_network(input_size, hidden_size, output_size)
print("Forme des poids W1 (couche cachée x couche d'entrée) :", my_network['W1'].shape)
print("Forme du biais b1 :", my_network['b1'].shape)
print("Forme des poids W2 (couche de sortie x couche cachée) :", my_network['W2'].shape)
# 3. Créer des données d'entrée d'exemple (2 caractéristiques, 1 échantillon)
# Dans X, les colonnes représentent les échantillons, les lignes représentent les caractéristiques
X_sample = np.array([[1.5], [-0.5]]) # Forme (2, 1)
print("\nDonnées d'entrée X :", X_sample.T) # .T est utilisé pour transposer afin de faciliter l'affichage
# 4. Effectuer la propagation avant
y_pred, cache = forward_propagation(my_network, X_sample)
print("\nSortie prédite du réseau de neurones (A2) :", y_pred)
# Si la sortie > 0.5, on la considère comme classe 1, sinon classe 0
predicted_class = 1 if y_pred > 0.5 else 0
print(f"Classe prédite : {predicted_class}")
Explication du code et analyse de la sortie :
Initialisation: Nous avons créé une structure de réseau 2-3-1.W1C'est une matrice 3x2, représentant les poids de connexion de 2 entrées vers 3 neurones cachés.
Propagation avant:
- Entrée
[1.5, -0.5]d'abord avecW1multiplié et ajouté àb1, ce qui donne la somme pondérée de la couche cachéeZ1。 Z1Après la fonction ReLU, on obtient les valeurs d'activation de la couche cachéeA1。A1Puis avecW2multiplié et ajouté àb2, produisant la somme pondérée de la couche de sortieZ2。Z2Enfin, grâce à la fonction sigmoïde, elle est compressée en (0,1) comme probabilité prédite finaleA2。
Sortie: Comme les poids sont initialisés de manière aléatoire, la sortie prédite de ce réseau non entraînéA2est également une valeur aléatoire (proche de 0.5).L'objectif de l'entraînement d'un réseau de neurones est d'ajuster de manière répétée, au moyen de grandes quantités de données,W1, b1, W2, b2, de sorte queA2il puisse produire des prédictions pertinentes pour différentes entrées.
Résumé des concepts clés et du parcours d'apprentissage
Grâce à cet article, vous avez maîtrisé les fondements des réseaux de neurones :
| Concept | Points clés |
|---|---|
| Neurone | Une unité de calcul qui effectueWeighted sum -> Add bias -> Activation function。 |
| Poids et biais | Paramètres essentiels que le modèle doit apprendre ; ils déterminent le comportement du réseau. |
| Fonction d'activation | Introduit une non-linéarité (par exemple, ReLU, Sigmoid), ce qui permet au réseau d'apprendre des relations complexes. |
| Couches du réseau | Couche d'entrée(reçoit les données),couche cachée(extraction de caractéristiques),couche de sortie(produit des prédictions). |
| Propagation avant | Le processus de circulation des données depuis la couche d'entrée vers la couche de sortie pour calculer les valeurs prédites. |
Vos prochaines étapes d'apprentissage :
- Fonction de perte: Comment quantifier la qualité des prédictions du réseau (par exemple, erreur quadratique moyenne, perte d'entropie croisée) ?
- Rétropropagation et descente de gradient: Comment un réseau de neurones ajuste-t-il automatiquement les poids et les biais en fonction du degré de « mauvaiseté » (c'est l'essence de l'apprentissage) ?
- Mise en pratique avec les frameworks: Utilisez
TensorFlowouPyTorchet d'autres frameworks modernes, vous pouvez facilement construire et entraîner des réseaux plus complexes, sans écrire à partir de zéroNumPycode.
Une fois que vous comprenez la structure de base, vous constaterez que tous les modèles complexes d'apprentissage profond (comme les CNN pour les images, les RNN pour la parole) évoluent à partir de cette structure de base en modifiant les schémas de connexion des neurones et les fonctions des couches. Maintenant, vous avez une carte pour continuer à explorer le vaste monde de l'apprentissage profond.
Autres extensions