Estadísticas básicas
Antes de aprender varios algoritmos llamativos, necesitamos sentar una base crucial:la estadística。
Podemos imaginar la estadística como ellenguajeyy caja de herramientas; sin él, los modelos de aprendizaje automático son como exploradores sin mapa, incapaces de entender los datos, hacer predicciones o evaluar su propio desempeño.
Este artículo te presentará sistemáticamente los conceptos estadísticos esenciales para el aprendizaje automático, con un lenguaje sencillo y ejemplos vívidos, para ayudarte a construir una base teórica sólida.
¿Por qué el aprendizaje automático necesita estadísticas?
Razón fundamental: el aprendizaje automático consiste esencialmente enaprender patrones de los datosy usar esos patrones para hacerprediccionesodecisiones. Y la estadística es precisamente la ciencia que estudia cómo recopilar, analizar, interpretar y presentar datos.
- Comprensión de los datos: la estadística nos ayuda a describir las características básicas de los datos (por ejemplo, la altura promedio, la distribución de ingresos), y este es el primer paso en la limpieza y exploración de datos.
- Descubrimiento de patrones: proporciona métodos para inferir patrones generales (modelos) a partir de los datos, y nos dice qué tan confiable es ese patrón.
- Predicción y evaluación: la teoría estadística sustenta cómo usamos los modelos para hacer predicciones y cómo evaluar objetivamente si un modelo es bueno (¿está adivinando o realmente entiende?).
- Cuantificación de la incertidumbre: el mundo real está lleno de ruido; la estadística nos permite medir la incertidumbre en las predicciones (por ejemplo, "tengo un 95% de confianza en que mañana lloverá").
En resumen,la estadística es el fundamento teórico del aprendizaje automático, que convierte la inteligencia de algo místico en algo científico.
Concepto clave 1: Estadística descriptiva
La estadística descriptiva es como tomar una foto y un informe de chequeo médico de los datos: usa varios indicadores clave para resumir el panorama completo del conjunto de datos. Es el punto de partida de cualquier proyecto de análisis de datos.
1. Tendencia central: ¿dónde se agrupan los datos?
Estos indicadores nos dicen dónde está el valor central o típico de los datos.
| Indicador | Explicación (metáfora) | Fórmula de cálculo (resumida) | Características y usos |
|---|---|---|---|
| Media | El promedio aritmético de todos los datos. Como el "salario promedio". |
Suma / Número de datos |
La más utilizada, pero muy sensible a los valores extremos (como los multimillonarios), es fácil "verse afectado por el promedio". |
| Mediana | Después de ordenar los datos de menor a mayor, el valor que estáexactamente en el medio. Como la "mediana salarial". |
Ordenar y tomar el valor de la posición central | Robusta, no se ve afectada por valores extremos y refleja mejor la situación típica. |
| Moda | El valor que aparece conmayor frecuenciaen los datos. Como la talla de zapato más vendida en la tienda. |
El valor con mayor frecuencia de aparición | Adecuada para datos categóricos o para encontrar la categoría más común. |
Ejemplo: los salarios mensuales de 5 empleados de un departamento (en miles de yuanes) son:[30, 35, 40, 45, 200](el jefe también está incluido).
- Media = (30+35+40+45+200)/5 = 70. Este valor está artificialmente inflado por los 200 del jefe y no representa el ingreso de los empleados.
- Mediana= el tercer valor después de ordenar40. Este valor representa mejor el ingreso del empleado "típico" del departamento.
- Moda= todos los valores aparecen solo una vez, por lo tantono hay moda。
2. Dispersión: ¿qué tan dispersos están los datos?
Conocer solo el centro no es suficiente; también necesitamos saber si los datos están estrechamente agrupados alrededor del centro o dispersos por todas partes. La dispersión mide la variabilidad o diversidad de los datos.
| Indicador | Explicación (metáfora) | Fórmula de cálculo (resumida) | Características y usos |
|---|---|---|---|
| Varianza | El promedio de loscuadradosde las distancias entre cada punto de datos y la media. | Σ(每个值 - 均值)² / (n-1) |
Mide la dispersión total; la unidad es el cuadrado de la unidad original. |
| Desviación estándar | La raíz cuadrada positiva de la varianza。 Como la "magnitud promedio de fluctuación". |
√Varianza |
La más utilizada, su unidad coincide con la de los datos originales e indica intuitivamente la magnitud de la variabilidad. Cuanto mayor es el valor, más dispersos están los datos. |
| Rango | La diferencia entre el valor máximo y el mínimo. "Amplitud salarial". |
Máximo - Mínimo |
Cálculo simple, pero determinado solo por los dos valores extremos, es susceptible a valores atípicos. |
Continuando con el ejemplo anterior: calcular la desviación estándar de los salarios de los empleados (usar la media de 40 es más razonable para estimar).
- Calcular la varianza:
[(30-40)² + (35-40)² + (40-40)² + (45-40)² + (200-40)²] / 4 ≈ 5875 - Desviación estándar =
√5875 ≈ 76.65. Esta desviación estándar enorme (76.65) es mucho mayor que la media (40),lo que sugiere fuertemente la presencia de un valor atípico extremo (los 200 del jefe), que requiere un análisis adicional.
3. Distribución de datos y visualización
Los indicadores numéricos son abstractos; los gráficos nos permiten "ver" los datos de forma intuitiva.
- Histograma: muestra la frecuencia de los datos en diferentes intervalos (bins). Se puede ver si los datos son unimodales o multimodales, y si son simétricos.
- Diagrama de caja (boxplot): usa una "caja" y "bigotes" para mostrar elmínimo, primer cuartil (Q1), mediana (Q2), tercer cuartil (Q3) y máximode los datos. Es una herramienta poderosa para identificarvalores atípicos.
Ejemplo
import matplotlib.pyplot as plt
import seaborn as sns
import numpy as np
# Datos de salarios de empleados, incluye un valor atípico
salaries = np.array([30, 35, 40, 45, 200])
employee_names = ['Alice', 'Bob', 'Charlie', 'Diana', 'Boss']
plt.figure(figsize=(8, 5))
# Crear el diagrama de caja
sns.boxplot(y=salaries)
plt.title('Department Salary Distribution (Boxplot)')
plt.ylabel('Salary (k)')
plt.grid(axis='y', linestyle='--', alpha=0.7)
# Marcar el punto correspondiente al valor atípico
for i, (name, salary) in enumerate(zip(employee_names, salaries)):
if salary > 45 + 1.5 * (45-35): # Regla simple para detectar valores atípicos
plt.annotate(f'{name}: {salary}', xy=(0, salary), xytext=(0.2, salary),
arrowprops=dict(facecolor='red', shrink=0.05))
plt.show()
Explicación del código:
sns.boxplot()Dibuja un diagrama de caja. La caja va de Q1 a Q3, y la línea del medio es la mediana.- Los "bigotes" del diagrama de caja generalmente se extienden hasta el punto de datos más lejano dentro de 1.5 veces el rango intercuartílico (IQR = Q3 - Q1); los puntos más allá se consideranvalores atípicosy se marcan por separado con puntos. En la figura,
200este punto se identifica claramente como un valor atípico.
Concepto clave 2: Probabilidad y distribuciones
Si la estadística descriptiva es mirar la historia, la probabilidad es predecir el futuro. Cuantificala posibilidad de que ocurra un evento。
1. Probabilidad básica
- Probabilidad P(A): la probabilidad de que ocurra el evento A, con valores entre 0 (imposible) y 1 (seguro).
- Probabilidad condicional P(A|B): la probabilidad de que ocurra el evento A, dado que el evento Bya ha ocurrido. Es clave para entender muchos algoritmos de aprendizaje automático (como el Naive Bayes).
- Fórmula:
P(A|B) = P(A 且 B) / P(B)
- Fórmula:
2. Distribuciones de probabilidad
Describe la regularidad de probabilidad de los distintos valores posibles de una variable aleatoria. En el aprendizaje automático, las más importantes son:
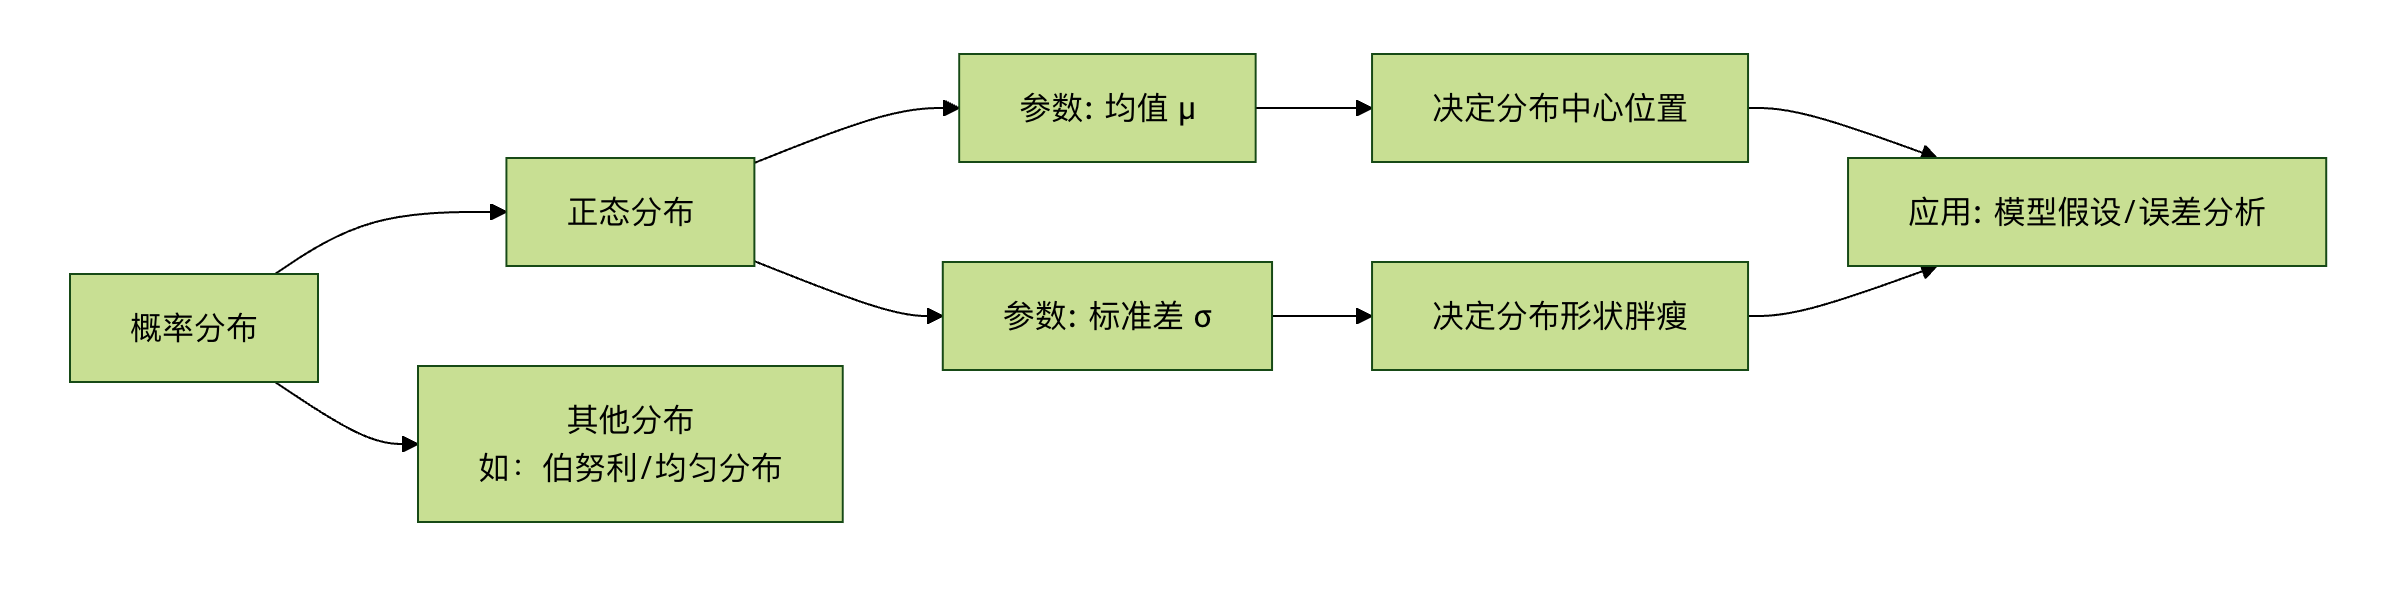
- Distribución normal (distribución gaussiana):
- Forma: la famosa "curva de campana", simétrica de izquierda a derecha.
- Parámetros: la **media (μ)** determina la posición central, y la **desviación estándar (σ)** determina la "gordura" de la curva (grado de dispersión).
- Importancia: muchos fenómenos en la naturaleza y las ciencias sociales se aproximan a una distribución normal (como la altura o los errores de medición). El teorema del límite central señala que la suma de muchas variables aleatorias independientes tiende a una distribución normal, lo que la convierte en la piedra angular de la inferencia estadística.
- Regla 68-95-99.7: la probabilidad de que los datos caigan dentro de la media ±1σ, ±2σ y ±3σ es aproximadamente 68%, 95% y 99.7%, respectivamente.
Concepto clave 3: Estadística inferencial
Esta es la versión "mejorada" de la estadística; su objetivo es, a partir de los datos de lamuestra, inferir las propiedades de lapoblación. En el aprendizaje automático, siempre usamos datos limitados (muestra) para entrenar modelos, esperando que se desempeñen bien en el mundo real infinito (población).
1. Teorema del límite central
Idea central: Sin importar cuál sea la distribución de la población, cuando extraemos una gran cantidadindependientesmuestras aleatorias de la población y calculamos lamedia, la distribución de estas medias muestrales se aproximará a unadistribución normal。
Importancia para el aprendizaje automático: Esto nos proporciona la base teórica para utilizar las propiedades de la distribución normal y realizarpruebas de hipótesisy construirintervalos de confianzasobre los parámetros del modelo (como la media). Incluso si no conocemos la distribución real de la población, podemos analizar la fiabilidad de las estimaciones basadas en la muestra.
2. Prueba de hipótesis
Se utiliza para determinar si una hipótesis sobre la población (como "el nuevo fármaco no es eficaz") está respaldada por los datos de la muestra.
- Hipótesis nula (H0): Generalmente indica "sin efecto", "sin diferencia" (postura por defecto).
- Hipótesis alternativa (H1): La hipótesis que esperamos confirmar (como "el nuevo fármaco es eficaz").
- Valor P: La probabilidad de observar los datos de la muestra actual (o datos más extremos) bajo el supuesto de que la hipótesis nula es verdadera.
- Cómo decidir: Si el valor P es muy pequeño (generalmente < 0.05), significa que, bajo H0, la situación actual es muy difícil de ocurrir, por lo que tenemos evidencia suficiente pararechazar H0y aceptar H1.
- Nivel de significancia (α): El umbral para decidir si el valor P es "suficientemente pequeño", generalmente se establece en 0.05.
Aplicaciones en el aprendizaje automático: Se utiliza en la selección de características para determinar si existe una correlación estadísticamente significativa entre una característica y la variable objetivo, en lugar de una asociación casual.
3. Correlación y causalidad
Este es uno de los conceptos más importantes y más fáciles de confundir en el análisis de datos.
- Correlación: Mide la tendencia de dos variables acambiar simultáneamente. Se representa comúnmente con el **coeficiente de correlación (de -1 a 1)**.
- 1: Correlación positiva perfecta (ambas aumentan o disminuyen juntas).
- -1: Correlación negativa perfecta (una aumenta y la otra disminuye).
- 0: Sin correlación lineal.
- Causalidad: Se refiere a que elcambio de una variable (causa) conduce directamenteal cambio de otra variable (efecto).
Diferencia clave:¡La correlación no implica causalidad!
- Falacia clásica: En verano, las ventas de helados y el número de ahogamientos están altamente correlacionados positivamente. Pero esto no significa que comer helado cause ahogamientos. Sucausa común (variable de confusión)Síes el clima caluroso.。
- Lecciones para el aprendizaje automático: Los modelos de aprendizaje automático (especialmente los predictivos) son buenos para encontrarcorrelaciones, pero no pueden determinar por sí mismos lacausalidad. Confundir una fuerte correlación encontrada por el modelo con una relación causal es un error común en la práctica. Construir modelos causales requiere un diseño experimental más riguroso (como ensayos controlados aleatorizados) o métodos especiales de inferencia causal.
Práctica: Análisis estadístico básico con Python
Usemos Python y la famosapandas、seabornlibrería para realizar un análisis estadístico descriptivo y exploratorio simple sobre un conjunto de datos real.
Ejemplo
import seaborn as sns
import matplotlib.pyplot as plt
import numpy as np
# 1. Cargar el conjunto de datos (aquí se usa el conjunto de datos de propinas 'tips' incluido en seaborn)
df = sns.load_dataset('tips')
print("Primeras 5 filas del conjunto de datos:")
print(df.head())
print(f"\n"Forma del conjunto de datos: {df.shape}") # Ver el número de filas y columnas
print("\n"Información básica:")
print(df.info())
print("\n"Estadísticas descriptivas:")
print(df.describe())
# 2. Explorar variables numéricas: cuenta total (total_bill) y propina (tip)
print(f"\n"Media de la cuenta total: {df['total_bill'].mean():.2f}")
print(f"Mediana de la cuenta total: {df['total_bill'].median():.2f}")
print(f"Desviación estándar de la cuenta total: {df['total_bill'].std():.2f}")
print(f"Coeficiente de correlación entre propina y cuenta total: {df['tip'].corr(df['total_bill']):.3f}")
# 3. Visualización
fig, axes = plt.subplots(2, 2, figsize=(12, 10))
# 3.1 Histograma y estimación de densidad de la cuenta total
sns.histplot(df['total_bill'], kde=True, ax=axes[0, 0])
axes[0, 0].set_title('Distribution of Total Bill')
axes[0, 0].axvline(df['total_bill'].mean(), color='red', linestyle='--', label=f'Mean: {df["total_bill"].mean():.1f}')
axes[0, 0].axvline(df['total_bill'].median(), color='green', linestyle='--', label=f'Median: {df["total_bill"].median():.1f}')
axes[0, 0].legend()
# 3.2 Diagrama de dispersión de propina vs cuenta total (para ver la correlación)
sns.scatterplot(data=df, x='total_bill', y='tip', hue='time', ax=axes[0, 1])
axes[0, 1].set_title('Tip vs Total Bill (Colored by Meal Time)')
# 3.3 Diagrama de caja de propinas agrupado por sexo (comparar diferencias entre grupos)
sns.boxplot(data=df, x='sex', y='tip', ax=axes[1, 0])
axes[1, 0].set_title('Tip Amount by Gender')
# 3.4 Gráfico de barras de la media de la cuenta según si fuma o no
bill_by_smoker = df.groupby('smoker')['total_bill'].mean().reset_index()
sns.barplot(data=bill_by_smoker, x='smoker', y='total_bill', ax=axes[1, 1])
axes[1, 1].set_title('Average Total Bill by Smoking Status')
for index, row in bill_by_smoker.iterrows():
axes[1, 1].text(index, row['total_bill']+0.5, f"{row['total_bill']:.1f}", ha='center')
plt.tight_layout()
plt.show()
Tareas de práctica:
Ejecutar el código: Ejecuta el código anterior en tu entorno de Python y observa las salidas y los gráficos.
Interpretar los resultados:
- A partir de la tabla de estadísticas descriptivas, ¿puedes indicar el rango aproximado y la mediana de la cuenta total?
- ¿La propina y la cuenta total tienen una correlación positiva o negativa? ¿Puedes verlo en el diagrama de dispersión?
- Según el diagrama de caja, ¿hay una diferencia significativa en la mediana de las propinas entre hombres y mujeres?
Plantear una hipótesis: Basándote en el gráfico de barras de "media de la cuenta según si fuma o no", ¿puedes plantear una hipótesis nula que pueda usarse parapruebas de hipótesis? (Por ejemplo: H0: no hay diferencia en la cuenta promedio entre fumadores y no fumadores).
Otras extensiones