Основы статистики
Прежде чем изучать различные крутые алгоритмы, нам нужно сначала заложить важный фундамент —статистика。
Мы можем рассматривать статистику какязыкиинструментарий, без нее модели машинного обучения подобны исследователям без карты, неспособным понимать данные, делать прогнозы или оценивать свою собственную производительность.
В этой статье будут систематически представлены основные статистические концепции, необходимые для машинного обучения, с использованием простого языка и ярких примеров, чтобы помочь вам построить прочную теоретическую основу.
Почему машинному обучению нужна статистика?
Основная причина: Машинное обучение по сути — этоизучение закономерностей в данных, и использование этой закономерности дляпредсказанияилии принятия решений.А статистика, точнее говоря, — это наука о том, как собирать, анализировать, интерпретировать и представлять данные.
- Понимание данных: Статистика помогает нам описать основные характеристики данных (например, средний рост, распределение доходов). Это первый шаг в очистке и исследовании данных.
- Поиск закономерностей: Она предоставляет методы для вывода общих закономерностей (моделей) из данных и сообщает нам, насколько надёжны эти закономерности.
- Предсказание и оценка: Статистическая теория лежит в основе того, как мы используем модели для предсказаний, и того, как объективно оценить качество модели (это слепое угадывание или истинное понимание?).
- Количественная оценка неопределённости: Реальный мир полон шума; статистика позволяет нам количественно оценить неопределённость в предсказаниях (например, «Я на 95% уверен, что завтра пойдёт дождь»).
Проще говоря,статистика — это теоретический краеугольный камень машинного обучения, превращающий интеллект из мистики в науку.
Основное понятие 1: Описательная статистика
Описательная статистика — это как сделать снимок и медицинский отчёт о данных, используя несколько ключевых показателей, чтобы обобщить общую картину набора данных. Это отправная точка любого проекта по анализу данных.
1. Центральная тенденция: Где группируются данные?
Эти показатели говорят нам, где находится центр или типичное значение данных.
| Метрика | Объяснение (метафора) | Формула расчёта (кратко) | Особенности и применение |
|---|---|---|---|
| Среднее | Среднее арифметическое всех данных. Как «средняя зарплата». |
Sum / Number of data points |
Наиболее часто используется, но очень чувствительно к экстремальным значениям (например, к миллиардерам) и легко «завышается» при усреднении. |
| Медиана | После сортировки данных от наименьшего к наибольшему,точное центральноезначение. Как «медианная зарплата». |
Берётся значение на средней позиции после сортировки. | Устойчива, не подвержена влиянию экстремальных значений и лучше отражает типичные ситуации. |
| Mode | Значение, которое встречаетсячаще всегов данных. Как самый продаваемый размер обуви в магазине. |
Значение с наибольшей частотой | Подходит для категориальных данных или для поиска наиболее часто встречающейся категории. |
Пример: месячные зарплаты (в тысячах юаней) 5 сотрудников отдела:[30, 35, 40, 45, 200](Начальник среди них.)
- Среднее = (30+35+40+45+200)/5 = 70. Это значение искусственно завышено из-за 200 у начальника и не может представлять доход сотрудников.
- Медиана= третье число после сортировки40. Это значение лучше представляет доход "типичного" сотрудника отдела.
- Мода= все значения встречаются только один раз, поэтомумоды нет.。
2. Разброс: насколько сильно разбросаны данные?
Знать только центр недостаточно; также нужно знать, плотно ли данные сгруппированы вокруг центра или широко рассеяны. Разброс измеряет изменчивость или разнообразие данных.
| Метрика | Объяснение (метафора) | Формула расчёта (кратко) | Особенности и применение |
|---|---|---|---|
| Вариантность | Расстояние каждой точки данных от среднего,возведённое в квадрат,усредняется. | Σ(每个值 - 均值)² / (n-1) |
Измеряет общий разброс; единица измерения — квадрат исходной единицы. |
| Стандартное отклонение | Положительный квадратный корень из дисперсии.。 Как «средний размах колебаний». |
√Variance |
Наиболее часто используется, имеет ту же единицу измерения, что и исходные данные, интуитивно отражает величину колебания. Чем больше значение, тем более разбросаны данные. |
| Диапазон | Разница между максимальным и минимальным значениями. «Размах зарплат». |
Maximum value - Minimum value |
Прост в вычислении, но определяется только двумя крайними значениями и легко подвержен влиянию выбросов. |
Продолжая пример выше: вычислите стандартное отклонение зарплат сотрудников (использовать 40 в качестве предполагаемого среднего более разумно).
- Вычислите дисперсию:
[(30-40)² + (35-40)² + (40-40)² + (45-40)² + (200-40)²] / 4 ≈ 5875 - Стандартное отклонение =
√5875 ≈ 76.65. Это огромное стандартное отклонение (76.65) намного больше среднего (40),что убедительно указывает на наличие экстремального выброса в данных (200 у начальника), требуя дальнейшего анализа.
3. Распределение данных и визуализация
Числовые метрики абстрактны; диаграммы позволяют нам интуитивно «увидеть» данные.
- Гистограмма: показывает частотное распределение данных по различным интервалам (бинам). Она показывает, является ли распределение унимодальным или мультимодальным, а также симметрично ли оно.
- Коробчатая диаграмма: использует «ящик» и «усы», чтобы отобразить данные:минимум, первый квартиль (Q1), медиану (Q2), третий квартиль (Q3) и максимум, и является мощным инструментом для выявлениявыбросов.
Пример
import matplotlib.pyplot as plt
import seaborn as sns
import numpy as np
# Данные о зарплатах сотрудников, содержащие один выброс
salaries = np.array([30, 35, 40, 45, 200])
employee_names = ['Alice', 'Bob', 'Charlie', 'Diana', 'Boss']
plt.figure(figsize=(8, 5))
# Создать коробчатую диаграмму
sns.boxplot(y=salaries)
plt.title('Распределение зарплат по отделам (Коробчатая диаграмма)')
plt.ylabel('Зарплата (k)')
plt.grid(axis='y', linestyle='--', alpha=0.7)
# Отметьте точку, соответствующую выбросу
for i, (name, salary) in enumerate(zip(employee_names, salaries)):
if salary > 45 + 1.5 * (45-35): # Простое правило для обнаружения выбросов
plt.annotate(f'{name}: {salary}', xy=(0, salary), xytext=(0.2, salary),
arrowprops=dict(facecolor='red', shrink=0.05))
plt.show()
Пояснение кода:
sns.boxplot()Постройте ящичную диаграмму. Ящик охватывает диапазон от Q1 до Q3, а средняя линия — это медиана.- «Усы» ящичной диаграммы обычно простираются до самой удалённой точки данных в пределах 1.5 межквартильного размаха (IQR = Q3 - Q1); точки за этими пределами считаютсявыбросамии отдельно отмечаются точками. На рисунке,
200эта точка явно определяется как выброс.
Ключевая концепция 2: Вероятность и распределения
Если описательная статистика — это взгляд в историю, то вероятность — это предсказание будущего. Она количественно оцениваетвероятность наступления события.。
1. Основы теории вероятностей
- Вероятность P(A): Мера возможности наступления события A, принимающая значения от 0 (невозможное событие) до 1 (достоверное событие).
- Условная вероятность P(A|B): При условии, что событие Bпроизошло, вероятность наступления события A. Это ключ к пониманию многих алгоритмов машинного обучения (например, наивного байесовского классификатора).
- Формула:
P(A|B) = P(A 且 B) / P(B)
- Формула:
2. Распределения вероятностей
Описывает вероятностные закономерности того, как случайная величина принимает различные возможные значения. Наиболее важное в машинном обучении — это:
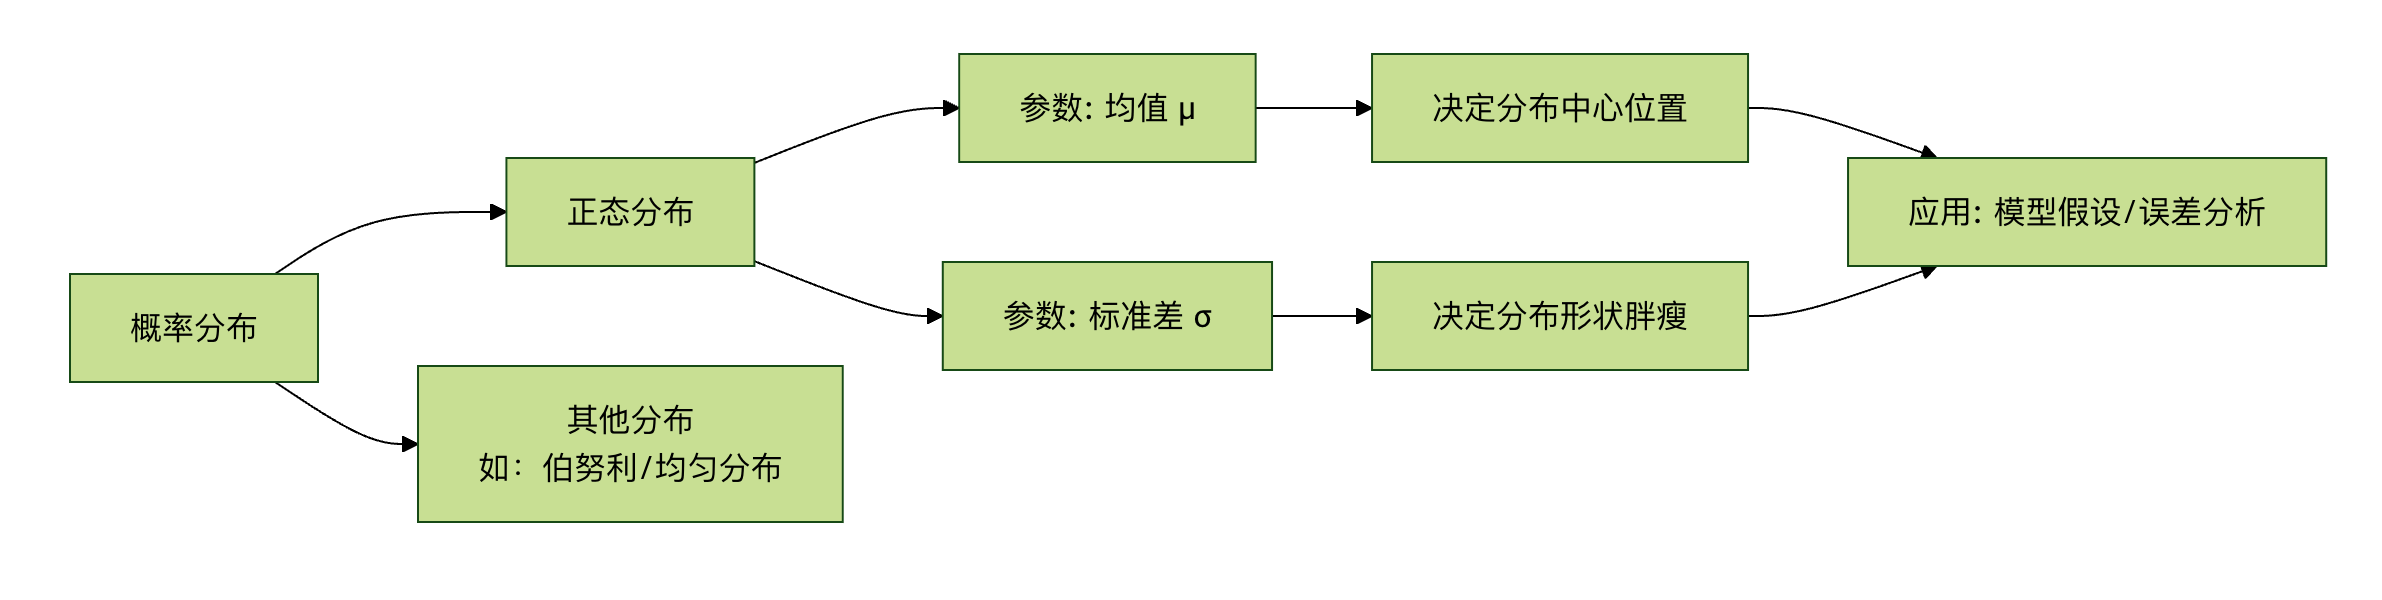
- Нормальное распределение (распределение Гаусса):
- Форма: Знаменитая «кривая колокола», симметричная слева и справа.
- Параметры: **Среднее (μ)** определяет положение центра, а **стандартное отклонение (σ)** определяет «толщину» (разброс) кривой.
- Важность: Многие явления в природе и социальных науках приблизительно подчиняются нормальному распределению (например, рост, ошибки измерений). Центральная предельная теорема утверждает, что сумма многих независимых случайных величин стремится к нормальному распределению, что делает его краеугольным камнем статистического вывода.
- Правило 68-95-99.7: Вероятности того, что данные попадают в пределы среднего ±1σ, ±2σ и ±3σ, составляют приблизительно 68%, 95% и 99.7% соответственно.
Ключевая концепция 3: Инференциальная статистика
Это «продвинутая версия» статистики; цель — повыборочнымданным делать выводы о свойствахгенеральной совокупности.
1. Центральная предельная теорема
Основная идея: Независимо от того, каково распределение генеральной совокупности, когда мы извлекаем большое количествонезависимыхслучайных выборок из генеральной совокупности и вычисляемсреднее значениекаждой выборки, распределение этих выборочных средних будет стремиться кнормальному распределению.。
Значение для машинного обучения: Это позволяет нам использовать свойства нормального распределения для выполненияпроверки гипотези построениядоверительных интерваловдля параметров модели (таких как среднее), обеспечивая теоретическую основу. Даже если мы не знаем истинное распределение генеральной совокупности, мы можем анализировать надёжность оценок на основе выборок.
2. Проверка гипотез
Она используется для определения того, поддерживается ли гипотеза о генеральной совокупности (например, «новый препарат неэффективен») выборочными данными.
- Нулевая гипотеза (H0): Обычно означает «нет эффекта» или «нет различия» (положение по умолчанию).
- Альтернативная гипотеза (H1): Гипотеза, которую мы хотим подтвердить (например, «новый препарат эффективен»).
- P-значение: Вероятность наблюдения текущих выборочных данных (или более экстремальных данных) при условии, что нулевая гипотеза верна.
- Как принять решение: Если P-значение очень мало (обычно < 0.05), это означает, что текущая ситуация крайне маловероятна при H0, поэтому у нас достаточно доказательств, чтобыотклонить H0и принять H1.
- Уровень значимости (α): Порог, используемый для определения того, является ли P-значение «достаточно малым», часто устанавливается равным 0.05.
Применения в машинном обучении: Используется для отбора признаков, чтобы определить, существует ли статистически значимая связь между признаком и целевой переменной, а не случайное совпадение.
3. Корреляция и причинно-следственная связь
Это одно из самых легко смешиваемых и самых важных понятий в анализе данных.
- Корреляция: измеряет тенденцию двух переменных ксовместному изменению. Часто она представляется **коэффициентом корреляции (в диапазоне от -1 до 1)**.
- 1: Идеальная положительная корреляция (увеличиваются и уменьшаются вместе).
- -1: Идеальная отрицательная корреляция (одна увеличивается, пока другая уменьшается).
- 0: Линейная корреляция отсутствует.
- Причинность: относится к переменной (причине), чьёизменение напрямую приводит кизменению другой переменной (следствия).
Ключевое различие:Корреляция не означает причинность!
- Классическая ошибка: Продажи мороженого и случаи утопления сильно положительно коррелируют летом. Но это не означает, что поедание мороженого вызывает утопление. Ихобщая причина (смешивающая переменная)Да— жаркая погода.。
- Последствия для машинного обучения: Модели машинного обучения (особенно прогностические модели) отлично обнаруживаюткорреляцию, но не могут самостоятельно определитьпричинность. Ошибочное принятие сильных корреляций, найденных моделями, за причинно-следственные связи — распространённая ошибка на практике. Построение причинных моделей требует более строгих экспериментальных планов (например, рандомизированных контролируемых испытаний) или специальных методов причинного вывода.
Практическое занятие: базовый статистический анализ с помощью Python
Давайте воспользуемся Python и известнымpandas、seabornбиблиотека для выполнения простого описательного и исследовательского статистического анализа реального набора данных.
Пример
import seaborn as sns
import matplotlib.pyplot as plt
import numpy as np
# 1. Загрузите набор данных (используя встроенный в seaborn набор данных 'tips' о чаевых)
df = sns.load_dataset('tips')
print("Первые 5 строк набора данных:")
print(df.head())
print(f"\n"Размер набора данных: {df.shape}") # Просмотр количества строк и столбцов
print("\n"Основная информация:")
print(df.info())
print("\n"Описательная статистика:")
print(df.describe())
# 2. Изучите числовые переменные: общая сумма счёта (total_bill) и чаевые (tip)
print(f"\n"Среднее значение общей суммы счёта: {df['total_bill'].mean():.2f}")
print(f"Медиана общей суммы счёта: {df['total_bill'].median():.2f}")
print(f"Стандартное отклонение общей суммы счёта: {df['total_bill'].std():.2f}")
print(f"Коэффициент корреляции между чаевыми и общей суммой счёта: {df['tip'].corr(df['total_bill']):.3f}")
# 3. Визуализация
fig, axes = plt.subplots(2, 2, figsize=(12, 10))
# 3.1 Гистограмма и оценка плотности общей суммы счёта
sns.histplot(df['total_bill'], kde=True, ax=axes[0, 0])
axes[0, 0].set_title('Распределение общей суммы счета')
axes[0, 0].axvline(df['total_bill'].mean(), color='red', linestyle='--', label=f'Среднее: {df["total_bill"].mean():.1f}')
axes[0, 0].axvline(df['total_bill'].median(), color='green', linestyle='--', label=f'Медиана: {df["total_bill"].median():.1f}')
axes[0, 0].legend()
# 3.2 Диаграмма рассеяния зависимости чаевых от общей суммы счета (для проверки корреляции)
sns.scatterplot(data=df, x='total_bill', y='tip', hue='time', ax=axes[0, 1])
axes[0, 1].set_title('Зависимость чаевых от общей суммы счета (с цветом по времени приема пищи)')
# 3.3 Коробчатая диаграмма чаевых с группировкой по полу (для сравнения различий между группами)
sns.boxplot(data=df, x='sex', y='tip', ax=axes[1, 0])
axes[1, 0].set_title('Размер чаевых по полу')
# 3.4 Столбчатая диаграмма среднего счёта по статусу курения
bill_by_smoker = df.groupby('smoker')['total_bill'].mean().reset_index()
sns.barplot(data=bill_by_smoker, x='smoker', y='total_bill', ax=axes[1, 1])
axes[1, 1].set_title('Средняя сумма счёта по статусу курения')
for index, row in bill_by_smoker.iterrows():
axes[1, 1].text(index, row['total_bill']+0.5, f"{row['total_bill']:.1f}", ha='center')
plt.tight_layout()
plt.show()
Практические задания:
Запустите код: Запустите приведённый выше код в вашей среде Python, наблюдайте за выводами и графиками.
Интерпретируйте результаты:
- По таблице описательных статистик можете ли вы определить приблизительный диапазон и медиану общего счёта?
- Чаевые и общий счёт положительно или отрицательно коррелированы? Можете ли вы определить это по диаграмме рассеяния?
- По ящичной диаграмме есть ли значительное различие в медианных чаевых, оставленных мужчинами и женщинами?
Сформулируйте гипотезу: Основываясь на столбчатой диаграмме среднего счёта по статусу курения, можете ли вы предложить нулевую гипотезу дляпроверки гипотез? (Например: H0: нет разницы в среднем счёте между курящими и некурящими).
Другие расширения